
Deskriptive Statistik (Tabellen)
Wählen Sie numerische Variablen und optional Gruppierungsvariablen für Zeilen und Spalten und dann aus neun Kennwerten: N, Mittelwert, Standardfehler des Mittelwerts, Standardabweichung, Minimum, erstes Quartil, Median, drittes Quartil und Maximum. Fehlende Werte werden ausgelassen. Verwenden Sie das Werkzeug, um Teilgruppen zu vergleichen, etwa Füllgewichte nach Füllmaschine und Schicht. Es beschreibt die Daten und testet nicht, ob Unterschiede echt sind.
Zuletzt geprüft
Kernaussage
Descriptive Statistics (Tables) fasst eine oder mehrere numerische Spalten in einer Tabelle zusammen, aufgeschlüsselt nach bis zu zwei Gruppierungsspalten, sodass sich viele Teilgruppen nebeneinander vergleichen lassen.
Auf dieser Seite
Zweck
Descriptive Statistics (Tables) fasst eine oder mehrere numerische Spalten in einer einzigen Tabelle zusammen, aufgeschlüsselt nach bis zu zwei Gruppierungsspalten: eine an der Seite der Tabelle und eine oben quer. Für jede Variable wählen Sie, welche Kennwerte angezeigt werden: Anzahl, Mittelwert, Standardfehler des Mittelwerts, Standardabweichung, Minimum, Quartile, Median und Maximum. Verwenden Sie das Werkzeug, um viele Teilgruppen nebeneinanderzustellen, bevor Sie entscheiden, wo Sie genauer hinsehen, zum Beispiel Füllgewichte nach Füllmaschine und Schicht, Zykluszeiten nach Linie und Produkt oder Prüfergebnisse nach Lieferant und Los. Es beschreibt die Daten; es testet nicht, ob die Unterschiede echt sind.
Wichtige Funktionen
- Mehrere numerische Variablen in einer Tabelle, jede mit einem eigenen Block von Kennwerten.
- Aufschlüsselung nach einer Zeilenvariablen, einer Spaltenvariablen oder beiden: Die Gruppen der Zeilenvariablen verlaufen in der Tabelle nach unten, die Gruppen der Spaltenvariablen quer, wie in Minitab.
- Neun Kennwerte zur Auswahl; N, Mean, Standard deviation, Minimum, Median und Maximum sind standardmäßig aktiviert.
- Fehlende Werte einer Variablen werden bei den Kennwerten dieser Variablen ausgelassen.
- PDF-Export über Download.
Statistische Methoden
Die Daten werden nach den Stufen der Zeilenvariablen und der Spaltenvariablen (sofern angegeben) aufgeteilt, und die Kennwerte werden innerhalb jeder Gruppe und für jede Variable getrennt berechnet, nachdem fehlende und nicht numerische Werte entfernt wurden. Die Gruppen erscheinen in sortierter Reihenfolge der Gruppierungswerte. Ohne Gruppierungsvariable hat die Tabelle eine Zeile für die gesamte Spalte.
N ist die Anzahl der nicht fehlenden Werte. Mittelwert x̄ = Σx / N. Die Standardabweichung s verwendet den Divisor N − 1: s = √(Σ(x − x̄)² / (N − 1)). SE of mean = s / √N, die Unsicherheit des Gruppenmittelwerts. Minimum, Median und Maximum sind der kleinste, der mittlere und der größte Wert. Das erste und das dritte Quartil sind das 25. und das 75. Perzentil, ermittelt durch lineare Interpolation zwischen den sortierten Werten an der Position 1 + (N − 1)·p; sie können daher geringfügig von Software abweichen, die die Regel (N + 1)·p verwendet. Bei kleinen Gruppen (weniger als etwa 10 Werte) sind Standardabweichung und Quartile nur grob, lesen Sie sie also mit Vorsicht.
Eingabefelder und Optionen
Feld | Beschreibung |
Variables | Pflichtfeld. Eine oder mehrere numerische Spalten, die zusammengefasst werden (halten Sie Strg bzw. Cmd gedrückt, um mehrere auszuwählen). |
For rows (optional) | Gruppierungsspalte. Jede ihrer Stufen erhält eigene Zeilen in der Tabelle. |
For columns (optional) | Zweite Gruppierungsspalte. Ihre Stufen werden zu den Spalten der Tabelle, eine je Stufe; jede Zeile enthält dann einen Kennwert einer Variablen (für jede Stufe der Zeilenvariablen, sofern gesetzt). |
N / Mean / SE of mean / Standard deviation / Minimum / First quartile / Median / Third quartile / Maximum | Kennwerte, die für jede Variable angezeigt werden. Standardmäßig aktiviert: N, Mean, Standard deviation, Minimum, Median und Maximum. Mindestens einer muss aktiviert sein. |
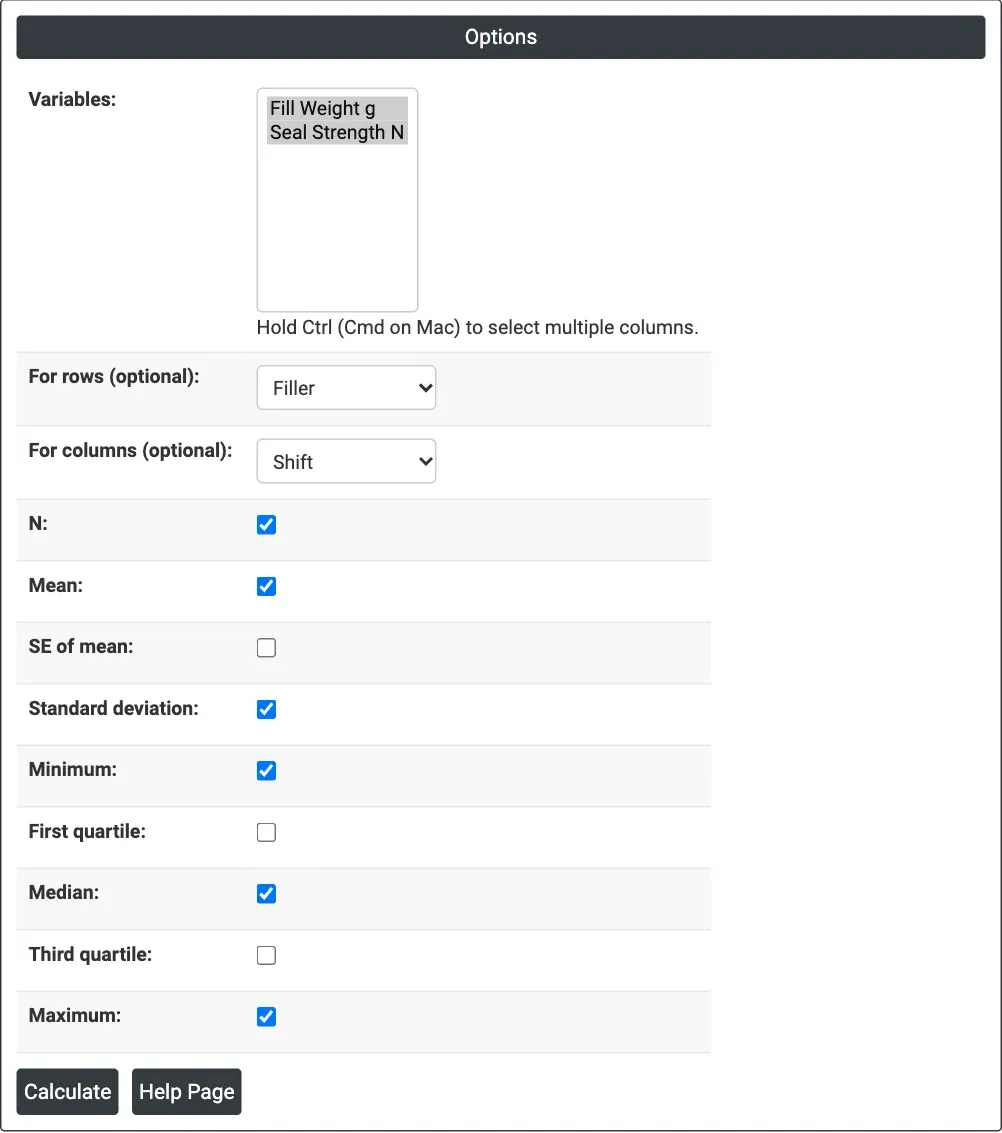
Abbildung 1 – Fill Weight g und Seal Strength N, zusammengefasst nach Filler (Zeilen) und Shift (Spalten) mit den Standardkennwerten.
Beschreibung der Ausgabe
- Kennwerttabelle – mit Spaltenvariable (überschrieben mit „Rows: <row variable>; Columns: <column variable>“): zuerst die Stufe der Zeilenvariablen, Variable und Statistic, dann eine Spalte je Stufe der Spaltenvariablen. Ohne Spaltenvariable: eine Zeile je Gruppe der Zeilenvariablen (bzw. insgesamt eine Zeile), dann eine Spalte je Variable und Kennwert, benannt als Variable_Statistic, z. B. Fill Weight g_Mean, Seal Strength N_StDev (Q1, Q3 und SE Mean für die optionalen Kennwerte).
- PDF-Export über Download.
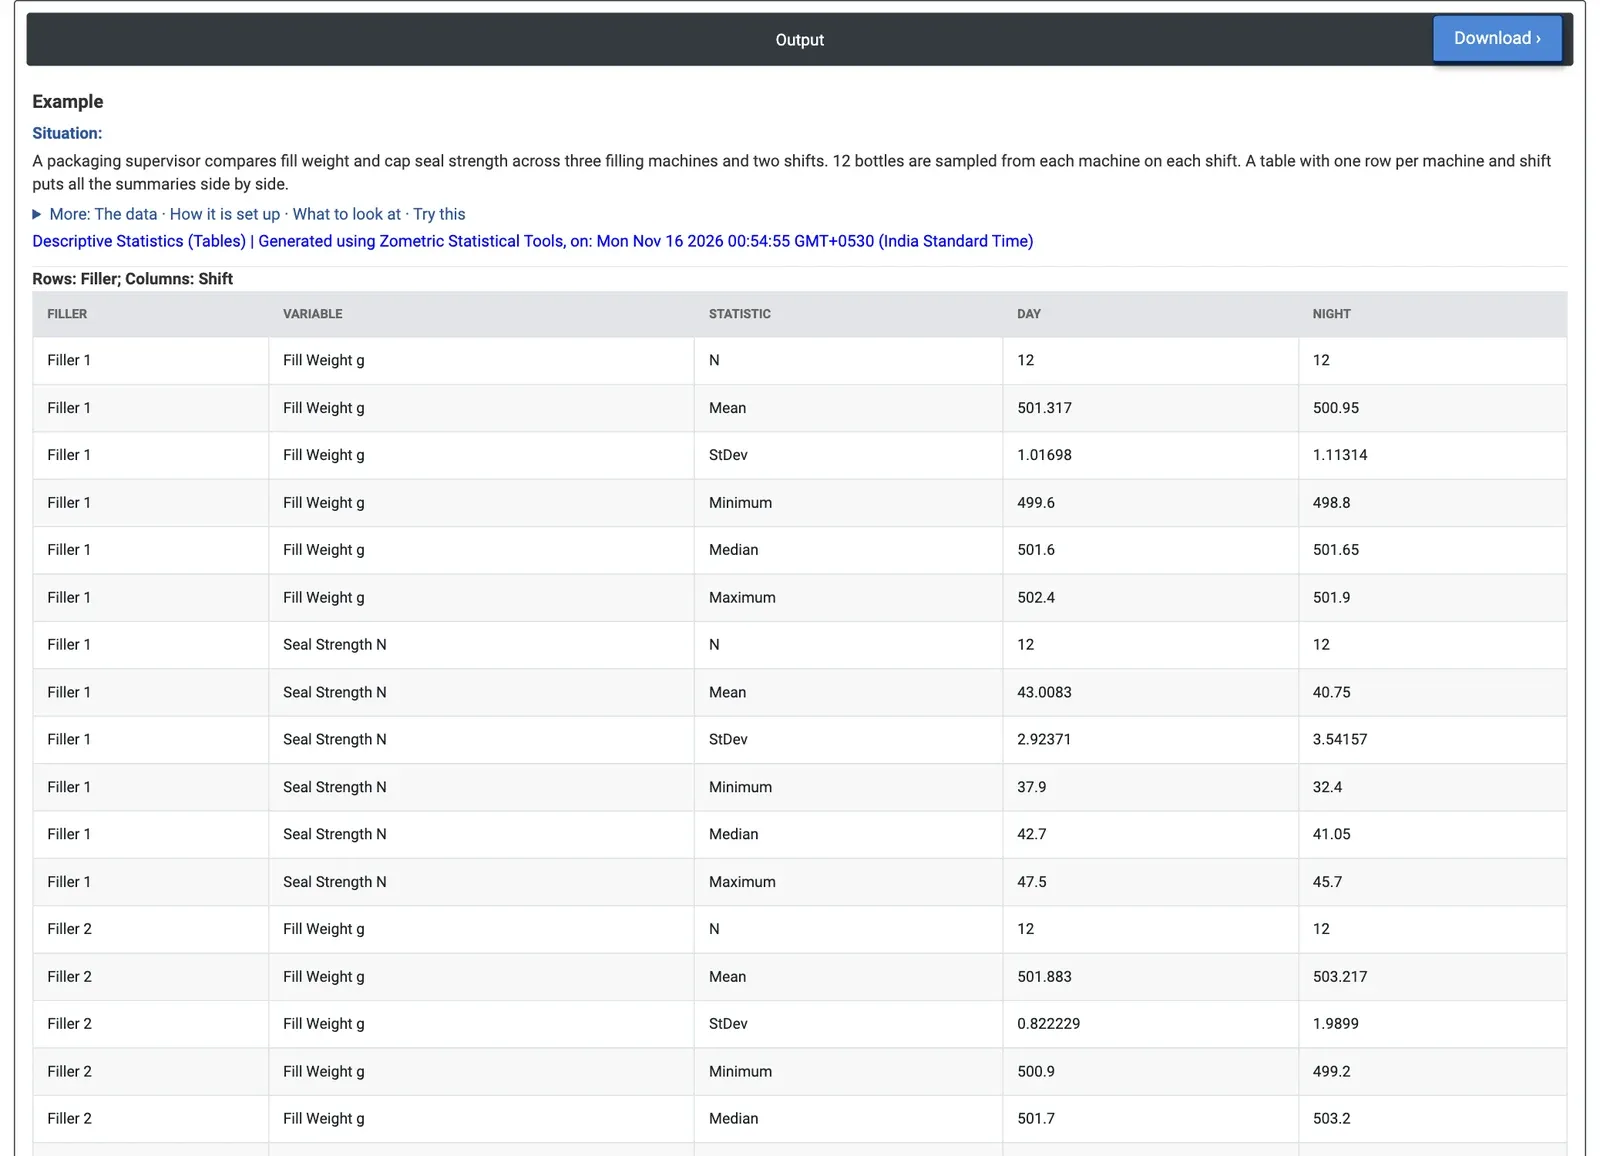
Abbildung 2 – Füllmaschinen an der Seite, Schichten oben quer: Die Siegelfestigkeit ist in der Night-Schicht bei allen drei Füllmaschinen niedriger, und Filler 2 füllt in der Night-Schicht am schwersten und mit der größten Streuung.
Beispiel
Ein Verpackungsleiter vergleicht drei Füllmaschinen über zwei Schichten. Je Füllmaschine und Schicht werden zwölf Flaschen entnommen (insgesamt 72), und an jeder Flasche werden Füllgewicht (g) und Siegelfestigkeit des Verschlusses (N) gemessen. Er wählt Variables = Fill Weight g und Seal Strength N, For rows = Filler und For columns = Shift und behält die Standardkennwerte bei.
Die Siegelfestigkeit ist in der Night-Schicht bei jeder Füllmaschine niedriger: Mittelwerte von 40.75, 38.93 und 38.66 N nachts gegenüber 43.01, 43.38 und 43.23 N tagsüber. Das Muster ist an allen drei Maschinen gleich, was auf eine Ursache in der Schicht hindeutet (Mannschaft, Verschlusscharge, Drehmomenteinstellung) statt auf eine einzelne Maschine. Das Füllgewicht zeigt ein anderes Bild: Filler 2 füllt in der Night-Schicht am schwersten (Mittelwert 503.22 g) und mit der größten Streuung (Standardabweichung 1.99 g, Spannweite 499.2 bis 506.2 g), während Filler 3 in beiden Schichten am leichtesten füllt (499.67 und 499.61 g).
Für eine Betrachtung auf Schichtebene ergibt die Einstellung For rows = Shift ohne Spaltenvariable und mit aktiviertem First quartile und Third quartile Mittelwerte der Siegelfestigkeit von 43.21 N tagsüber und 39.44 N nachts, wobei die mittlere Hälfte der Nachtflaschen zwischen 37.15 und 41.18 N liegt. Die Tabelle zeigt, wo man genauer hinsehen sollte; um zu prüfen, ob die Unterschiede zwischen Schichten und Füllmaschinen größer als zufällig sind, führt der Verpackungsleiter eine zweifaktorielle ANOVA für Seal Strength N mit Filler und Shift als Faktoren durch.
Häufig gestellte Fragen
Wann sollten Sie Tabellen mit deskriptiver Statistik verwenden?
Verwenden Sie sie, um viele Teilgruppen nebeneinanderzustellen, bevor Sie entscheiden, wo Sie genauer hinsehen, zum Beispiel Füllgewichte nach Füllmaschine und Schicht, Zykluszeiten nach Linie und Produkt oder Prüfergebnisse nach Lieferant und Los. Eine Gruppierungsvariable verläuft an der Seite der Tabelle nach unten, eine zweite kann oben quer verlaufen.
Wie werden die Quartile berechnet?
Das erste und das dritte Quartil sind das 25. und das 75. Perzentil, ermittelt durch lineare Interpolation zwischen den sortierten Werten an der Position 1 + (N − 1)·p; sie können daher geringfügig von Software abweichen, die die Regel (N + 1)·p verwendet. Bei kleinen Gruppen mit weniger als etwa 10 Werten sind Standardabweichung und Quartile nur grob, lesen Sie sie also mit Vorsicht.
Testet eine Tabelle mit deskriptiver Statistik, ob sich Gruppen unterscheiden?
Nein. Sie beschreibt die Daten, testet aber nicht, ob die Unterschiede echt sind. Im Beispiel zeigte die Tabelle für alle drei Füllmaschinen eine niedrigere Siegelfestigkeit in der Nachtschicht; um zu prüfen, ob die Unterschiede zwischen Schichten und Füllmaschinen größer als zufällig waren, führte der Verpackungsleiter eine zweifaktorielle ANOVA durch.
Wie richten Sie die Tabelle in Zometric Statistical Software ein?
Wählen Sie eine oder mehrere numerische Variables, optional eine Spalte For rows und eine Spalte For columns, und aktivieren Sie die anzuzeigenden Kennwerte. N, Mean, Standard deviation, Minimum, Median und Maximum sind standardmäßig aktiviert, und mindestens einer muss aktiviert sein. Die Standardabweichung verwendet den Divisor N − 1, und fehlende Werte werden ausgelassen.