
Diskriminanzanalyse
Geben Sie Objekte mit bekannter Gruppe und numerische Prädiktoren vor. Die lineare Diskriminanzanalyse setzt multivariat normalverteilte Prädiktoren mit gemeinsamer Kovarianzmatrix voraus; die quadratische erlaubt eine je Gruppe. A-priori-Wahrscheinlichkeiten können gleich, proportional oder benutzerdefiniert sein. Die Ausgabe enthält Konfusionsmatrizen, die Gesamt- und die per Leave-One-out kreuzvalidierte Trefferquote sowie lineare Klassifikationsfunktionen für neue Objekte. Prüfen Sie damit, ob sich eine Qualitätsstufe aus Prüfdaten erkennen lässt.
Zuletzt geprüft
Kernaussage
Die Diskriminanzanalyse bildet aus Messwerten eine Regel, die Objekte bekannten Gruppen zuordnet: Sie findet die Kombination von Messwerten, die die Gruppen am besten trennt, und zeigt, wie viele Objekte richtig klassiert werden.
Auf dieser Seite
Zweck
Die Discriminant Analysis (Diskriminanzanalyse) bildet aus Messwerten eine Regel, die Objekte bekannten Gruppen zuordnet. Sie geben Objekte vor, deren Gruppe bekannt ist (zum Beispiel Standard- und Premium-Chargen, gute und schlechte Teile oder Lieferanten), sowie die an ihnen erhobenen Messwerte; das Verfahren findet die Kombination von Messwerten, die die Gruppen am besten trennt, und zeigt, wie viele Objekte die Regel richtig klassiert. Verwenden Sie es, um zu prüfen, ob sich eine Qualitätsstufe oder ein Typ aus Prüfdaten erkennen lässt, oder um eine Regel zum Sortieren neuer Objekte zu erstellen.
Wichtige Funktionen
- Lineare oder quadratische Diskriminanzfunktionen für zwei oder mehr Gruppen.
- A-priori-Wahrscheinlichkeiten gleich für alle Gruppen, proportional zu den Gruppengrößen oder von Ihnen festgelegt.
- Konfusionsmatrix der tatsächlichen gegenüber der vorhergesagten Gruppe, mit dem Gesamtanteil richtig klassierter Objekte in Prozent.
- Leave-One-out-Kreuzvalidierung für eine fairere Schätzung, wie die Regel bei neuen Objekten funktioniert.
- Lineare Klassifikationsfunktionen (Konstante und ein Koeffizient je Prädiktor für jede Gruppe) zur Bewertung neuer Objekte.
Statistische Methoden
Zeilen mit fehlender Gruppe oder mit fehlendem oder nicht numerischem Prädiktor werden entfernt. Die Zielgröße wird als Textbezeichnung behandelt, und die Gruppen werden in alphabetischer oder numerischer Reihenfolge aufgeführt. Es müssen mindestens 2 Gruppen vorliegen und mehr Zeilen als die Anzahl der Prädiktoren plus die Anzahl der Gruppen.
Die lineare Diskriminanzanalyse setzt voraus, dass die Prädiktoren in jeder Gruppe einer multivariaten Normalverteilung mit derselben Kovarianzmatrix folgen. Sie schätzt jeden Gruppenmittelwert x̄g und eine gepoolte Kovarianzmatrix S innerhalb der Gruppen und gibt jeder Gruppe einen Wert Lg(x) = x̄gᵀ S⁻¹ x − ½ x̄gᵀ S⁻¹ x̄g + ln(pg), wobei pg die A-priori-Wahrscheinlichkeit der Gruppe ist. Ein Objekt wird der Gruppe mit dem höchsten Wert zugeordnet. Die Tabelle Linear Discriminant (Classification) Functions führt für jede Gruppe die Konstante (−½ x̄gᵀ S⁻¹ x̄g + ln pg) und die Koeffizienten S⁻¹ x̄g auf. Die quadratische Diskriminanzanalyse verzichtet auf die Annahme gleicher Kovarianzen und schätzt für jede Gruppe eine eigene Kovarianzmatrix, was gekrümmte Grenzen ergibt; sie benötigt mehr Daten je Gruppe und hat keine einfachen Klassifikationsfunktionen.
Die A-priori-Wahrscheinlichkeiten betragen standardmäßig 1/k bei k Gruppen. Proportionale A-priori-Wahrscheinlichkeiten verwenden den Anteil jeder Gruppe an den Daten, was größere Gruppen begünstigt. Die Trefferquote durch Resubstitution klassiert dieselben Objekte, aus denen die Regel gebildet wurde, und ist optimistisch. Die Leave-One-out-Kreuzvalidierung lässt nacheinander jedes Objekt weg, bildet die Regel aus den übrigen und klassiert das weggelassene Objekt; sie ist daher ein besserer Anhaltspunkt für die Trefferquote bei neuen Objekten.
Eingabefelder und Optionen
Feld | Beschreibung |
Response (grouping variable) | Pflichtfeld. Kategoriale Spalte mit der bekannten Gruppe jedes Objekts. |
Predictors | Eine oder mehrere numerische Spalten zur Trennung der Gruppen. |
Discriminant function | Linear (Standard; gemeinsame Kovarianzmatrix) oder Quadratic (eine Kovarianzmatrix je Gruppe). |
Prior probabilities | All groups equal (Standard), Proportional to group sizes in the data oder User-specified. |
Custom priors | Wird nur verwendet, wenn Prior probabilities auf User-specified steht. Ein Wert je Gruppe, durch Komma oder Leerzeichen getrennt, in alphabetischer oder numerischer Gruppenreihenfolge; alle positiv und mit Summe 1, z. B. 0.2, 0.5, 0.3. |
Cross-validate (leave-one-out) | Standardmäßig aktiviert. Ergänzt die kreuzvalidierte Trefferquote und Konfusionsmatrix. |
Title | Titel der Analyse. Standard: Discriminant Analysis. |
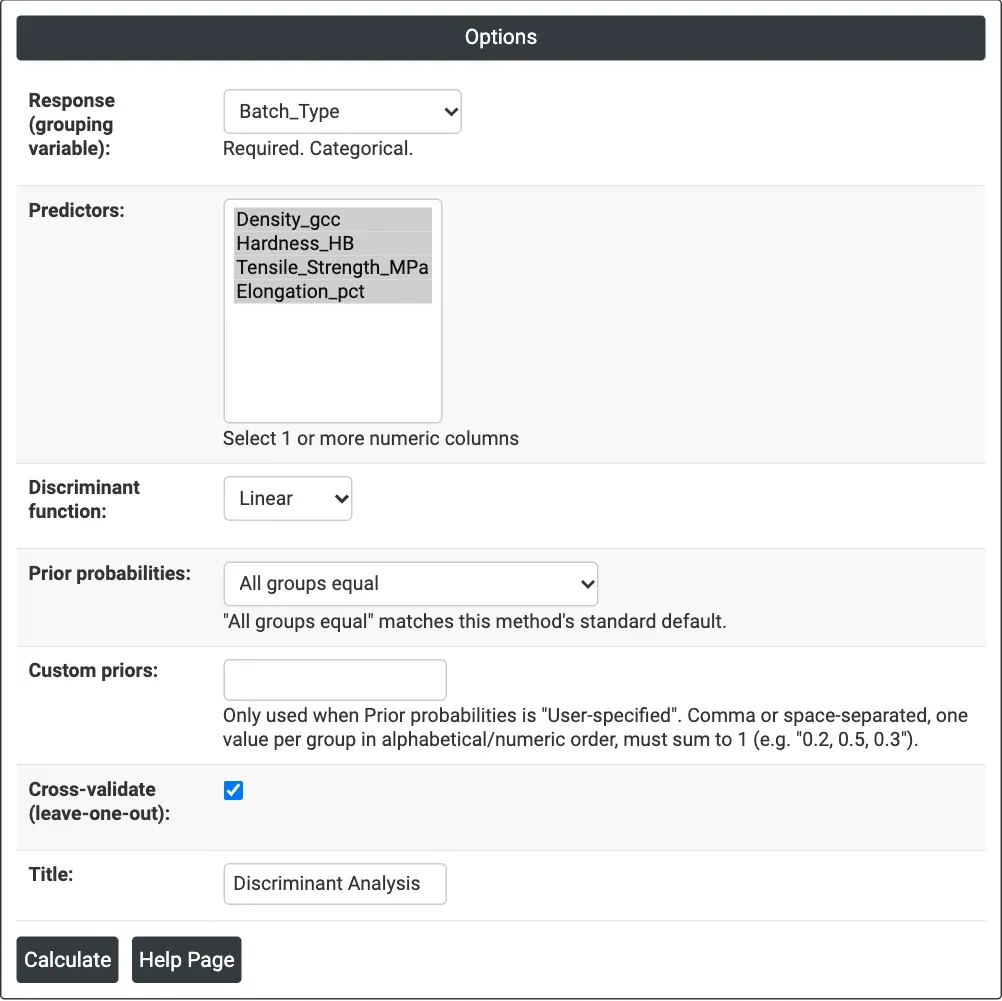
Abbildung 1 – Optionen für das Beispiel: Batch_Type als Zielgröße, vier Eigenschaftsspalten als Prädiktoren, lineare Funktion, gleiche A-priori-Wahrscheinlichkeiten, Leave-One-out-Kreuzvalidierung.
Beschreibung der Ausgabe
- Zusammenfassungszeile – verwendetes N, Trefferquote durch Resubstitution und, falls aktiviert, kreuzvalidierte (Leave-One-out-)Trefferquote.
- Prior Probabilities – die für jede Gruppe verwendete A-priori-Wahrscheinlichkeit.
- Confusion Matrix (Resubstitution) – tatsächliche Gruppe in den Zeilen, vorhergesagte Gruppe in den Spalten.
- Confusion Matrix (Cross-Validated) – dasselbe mit Leave-One-out-Vorhersagen.
- Linear Discriminant (Classification) Functions – nur bei linearer Funktion: die Konstante und der Koeffizient jedes Prädiktors für jede Gruppe. Ein neues Objekt wird der Gruppe zugeordnet, deren Funktion den höchsten Wert ergibt.
- PDF-Export über Download.
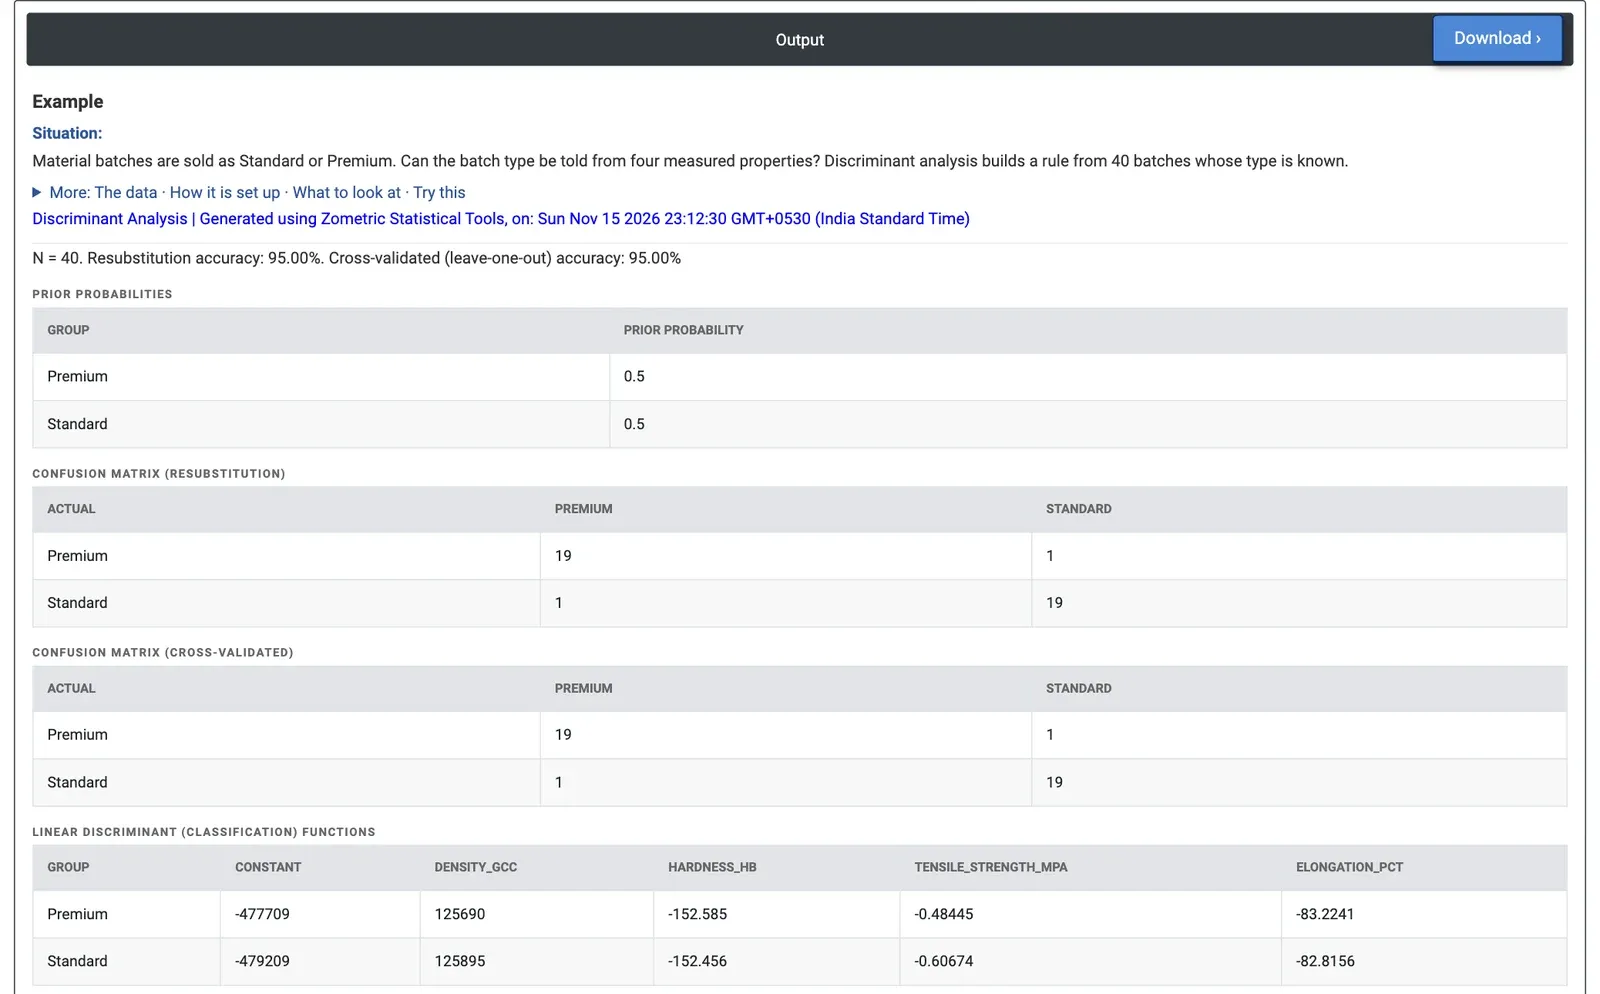
Abbildung 2 – Ergebnisse für 40 Chargen: 95% richtig klassiert, sowohl auf den Daten als auch mit Leave-One-out-Kreuzvalidierung; je eine Charge jedes Typs ist falsch klassiert.
Beispiel
Ein Werkstoffhersteller verkauft Chargen als Standard oder Premium. Der Qualitätsingenieur möchte wissen, ob sich der Chargentyp aus vier Routinemessungen erkennen lässt: Dichte (g/cc), Härte (HB), Zugfestigkeit (MPa) und Bruchdehnung (%). Er verwendet 40 Chargen mit bekanntem Typ, je 20, und setzt Response (grouping variable) = Batch_Type, die vier Eigenschaften als Predictors, Discriminant function = Linear, Prior probabilities = All groups equal und aktiviert Cross-validate.
Die Regel klassiert 38 von 40 Chargen richtig: 95.00% auf den Daten und 95.00% mit Leave-One-out-Kreuzvalidierung; sie passt sich also nicht nur an die 40 Chargen an, aus denen sie gebildet wurde. In jedem Typ sind 19 von 20 richtig. Die beiden falsch klassierten Chargen sind Zeile 3 (Standard, 197.4 HB, 1,210.8 MPa) und Zeile 27 (Premium, 202.3 HB, 1,209.7 MPa): Sie liegen zwischen den Gruppenmittelwerten (Premium 212.9 HB und 1,253.6 MPa, Standard 180.1 HB und 1,126.2 MPa) und sollten geprüft werden. Die Klassifikationsfunktionen geben jeder neuen Charge aus ihren vier Messwerten einen Premium- und einen Standard-Wert, und die Charge wird dem Typ mit dem höheren Wert zugeordnet.
Die Dichte ist wichtiger, als ihre geringe Streuung vermuten lässt: Der Premium-Mittelwert beträgt 7.878 g/cc gegenüber 7.850 bei Standard, und ohne die Dichte als Prädiktor sinkt die Trefferquote auf 82.5% (75.0% kreuzvalidiert). Eine quadratische Funktion schneidet hier schlechter ab, mit 92.5% auf den Daten und 85.0% kreuzvalidiert, da sie mehr Parameter aus nur 20 Chargen je Gruppe schätzt. Für den Ingenieur ist die lineare Regel mit allen vier Eigenschaften gut genug, um Chargen zu markieren, deren Kennzeichnung nicht zu ihren Messwerten passt. Verglichen mit einer Clusteranalyse derselben Daten ohne Kennzeichnung (Cluster K-Means trifft den Typ bei 28 von 40) ergibt die Kenntnis der Gruppen eine deutlich klarere Trennung.
Häufig gestellte Fragen
Was ist der Unterschied zwischen linearer und quadratischer Diskriminanzanalyse?
Die lineare Diskriminanzanalyse setzt voraus, dass die Prädiktoren in jeder Gruppe multivariat normalverteilt mit derselben Kovarianzmatrix sind, und liefert lineare Klassifikationsfunktionen. Die quadratische Diskriminanzanalyse schätzt für jede Gruppe eine eigene Kovarianzmatrix, was gekrümmte Grenzen ergibt, benötigt aber mehr Daten je Gruppe und hat keine einfachen Klassifikationsfunktionen. Im Beispiel schnitt die quadratische Variante mit nur 20 Chargen je Gruppe schlechter ab.
Warum sollten Sie eine Leave-One-out-Kreuzvalidierung verwenden?
Die Trefferquote durch Resubstitution klassiert dieselben Objekte, aus denen die Regel gebildet wurde, und ist daher optimistisch. Die Leave-One-out-Kreuzvalidierung lässt nacheinander jedes Objekt weg, bildet die Regel aus den übrigen und klassiert das weggelassene Objekt; das ist ein besserer Anhaltspunkt für die Trefferquote bei neuen Objekten. Im Beispiel lagen beide bei 95%, die Regel passte sich also nicht nur an ihre eigenen Daten an.
Wie beeinflussen A-priori-Wahrscheinlichkeiten die Diskriminanzanalyse?
Standardmäßig erhält jede von k Gruppen eine A-priori-Wahrscheinlichkeit von 1/k. Proportionale A-priori-Wahrscheinlichkeiten verwenden den Anteil jeder Gruppe an den Daten, was größere Gruppen begünstigt. Benutzerdefinierte A-priori-Wahrscheinlichkeiten müssen positiv sein, je Gruppe in alphabetischer oder numerischer Gruppenreihenfolge angegeben werden und die Summe 1 ergeben. Die A-priori-Wahrscheinlichkeit geht über ihren natürlichen Logarithmus in den Wert jeder Gruppe ein.
Wie klassieren Sie ein neues Objekt mit der Diskriminanzanalyse?
Bei einer linearen Diskriminanzfunktion führt Zometric Statistical Software in der Tabelle Linear Discriminant (Classification) Functions für jede Gruppe eine Konstante und einen Koeffizienten je Prädiktor auf. Berechnen Sie für das neue Objekt den Wert jeder Gruppenfunktion und ordnen Sie es der Gruppe zu, deren Funktion den höchsten Wert ergibt.