
Distribution ID Plot (beliebige Zensierung)
Geben Sie eine Start- und eine End-Spalte ein; leere und gefüllte Zellen kennzeichnen jede Zeile als exakt, rechts-, links- oder intervallzensiert. Das Werkzeug passt Weibull, Lognormal, Exponential, Normal, Logistic und Loglogistic per Maximum-Likelihood an, trägt Turnbull-Schätzungen mit Konfidenzgrenzen in jedes Wahrscheinlichkeitsnetz ein und ordnet die Verteilungen nach dem Korrelationskoeffizienten. Für Inspektionsdaten, bei denen Ausfälle erst bei der nächsten Prüfung entdeckt werden.
Zuletzt geprüft
Kernaussage
Der Distribution ID Plot (Arbitrary Censoring) hilft bei der Wahl einer Lebensdauerverteilung ohne stets exakte Ausfallzeiten: Er passt sechs Verteilungen an gemischte exakte und zensierte Daten an und ordnet ihre Wahrscheinlichkeitsnetze.
Auf dieser Seite
Zweck
Der Distribution ID Plot (Arbitrary Censoring) hilft Ihnen bei der Wahl einer Lebensdauerverteilung, wenn exakte Ausfallzeiten nicht immer bekannt sind. Er akzeptiert jede Mischung aus exakten Ausfällen, rechtszensierten Einheiten (beim letzten Kontakt noch funktionsfähig), linkszensierten Einheiten (bereits bei der ersten Prüfung ausgefallen) und intervallzensierten Einheiten (irgendwann zwischen zwei Inspektionen ausgefallen). Er passt sechs Verteilungen an und zeichnet für jede ein Wahrscheinlichkeitsnetz, geordnet danach, wie gerade die Darstellung verläuft. Verwenden Sie ihn für Inspektions- oder Auditdaten, bei denen ein Ausfall erst bei der nächsten Prüfung entdeckt wird.
Wichtige Funktionen
- Dateneingabe als Start-Spalte und End-Spalte; das Muster aus leeren und gefüllten Zellen legt die Art der Zensierung in jeder Zeile fest.
- Exakte, rechts-, links- und intervallzensierte Zeilen im selben Datensatz.
- Passt Weibull, Lognormal, Exponential, Normal, Logistic und Loglogistic in einem Durchlauf an.
- Ordnet die Verteilungen nach dem Korrelationskoeffizienten ihrer Wahrscheinlichkeitsnetze.
- Ein Wahrscheinlichkeitsnetz je Verteilung, mit der angepassten Geraden und ihren Konfidenzgrenzen.
Statistische Methoden
Jede Zeile wird anhand ihrer Start- und End-Werte gelesen: Start = End ist ein exakter Ausfall zu diesem Zeitpunkt; Start < End ist ein intervallzensierter Ausfall irgendwo zwischen beiden Werten; ein leeres End bedeutet rechtszensiert bei Start (die Einheit funktionierte zu diesem Zeitpunkt noch); ein leeres Start bedeutet linkszensiert bei End (die Einheit war zu diesem Zeitpunkt bereits ausgefallen). Jede Zeile benötigt mindestens einen Wert, und Start darf nicht größer als End sein.
Jede Verteilung wird per Maximum-Likelihood angepasst. Ein exakter Ausfall trägt die Dichte f(t) bei, eine rechtszensierte Einheit die Überlebenswahrscheinlichkeit 1 − F(Start), eine linkszensierte Einheit F(End) und eine intervallzensierte Einheit F(End) − F(Start), die Wahrscheinlichkeit, innerhalb des Intervalls auszufallen. Die nichtparametrische Schätzung der kumulierten Ausfallwahrscheinlichkeit für die Punkte im Diagramm ist die Turnbull-Schätzung, ein iteratives Verfahren, das jeden intervallzensierten Ausfall auf die Zeitpunkte verteilt, zu denen er eingetreten sein könnte.
Wie im Werkzeug für Rechtszensierung transformiert jedes Feld die Achsen so, dass seine Verteilung als Gerade erscheint (logarithmische Zeit für Weibull, Lognormal und Loglogistic), und der Korrelationskoeffizient ist die Pearson-Korrelation zwischen den dargestellten x-Werten und den transformierten Wahrscheinlichkeiten. Werte nahe 1 bedeuten einen geraderen Verlauf. Bei gruppierten Inspektionsdaten gibt es weniger unterschiedliche Diagrammpunkte als Einheiten, sodass die Korrelation auf weniger Punkten beruht; betrachten Sie neben der Rangfolge auch die einzelnen Felder und nutzen Sie technisches Wissen über den Ausfallmechanismus. Jedes Feld zeigt außerdem zweiseitige Konfidenzgrenzen (gepunktet) zum Confidence level, so wie Minitab sie zeichnet: Für jeden Prozentsatz p wird das Perzentil t_p der angepassten Verteilung mit seiner Varianz nach der Delta-Methode aus der inversen Hesse-Matrix der Log-Likelihood bestimmt; das Intervall wird für Weibull, Lognormal, Exponential und Loglogistic auf ln(t_p) und für Normal und Logistic auf t_p gebildet. Punkte deutlich außerhalb der Grenzen deuten auf eine schlechte Anpassung hin.
Eingabefelder und Optionen
Feld | Beschreibung |
Start column | Erforderlich. Letzter bekannter funktionsfähiger Zeitpunkt oder exakte Ausfallzeit. Lassen Sie Start in einer Zeile leer, um sie als linkszensiert zu kennzeichnen. |
End column | Erforderlich. Erster bekannter Ausfallzeitpunkt oder exakte Ausfallzeit. Lassen Sie End in einer Zeile leer, um sie als rechtszensiert zu kennzeichnen. Start = End bedeutet einen exakten Ausfall; Start < End bedeutet intervallzensiert. Muss eine andere Spalte als Start sein. |
Confidence level (%) | Standard 95; 50 bis 99.99. Legt die Konfidenzgrenzen fest, die um jede angepasste Gerade gezeichnet werden. |
Abbildung 1 — Optionen für das Beispiel: Inspektionsdaten in einer Start-Spalte und einer End-Spalte.
Beschreibung der Ausgaben
- Correlation ranking — jede Verteilung mit ihrem Korrelationskoeffizienten, von der besten zur schlechtesten.
- Messages — jede Verteilung, die nicht angepasst werden konnte, mit Angabe des Grundes.
- Distribution ID Plot for Start-End — ein Wahrscheinlichkeitsnetz je Verteilung in der Reihenfolge der Rangfolge, mit ihrer Korrelation (r) im Titel, mit den Diagrammpunkten, der angepassten Geraden und ihren Konfidenzgrenzen.
- PDF-Export über Download.
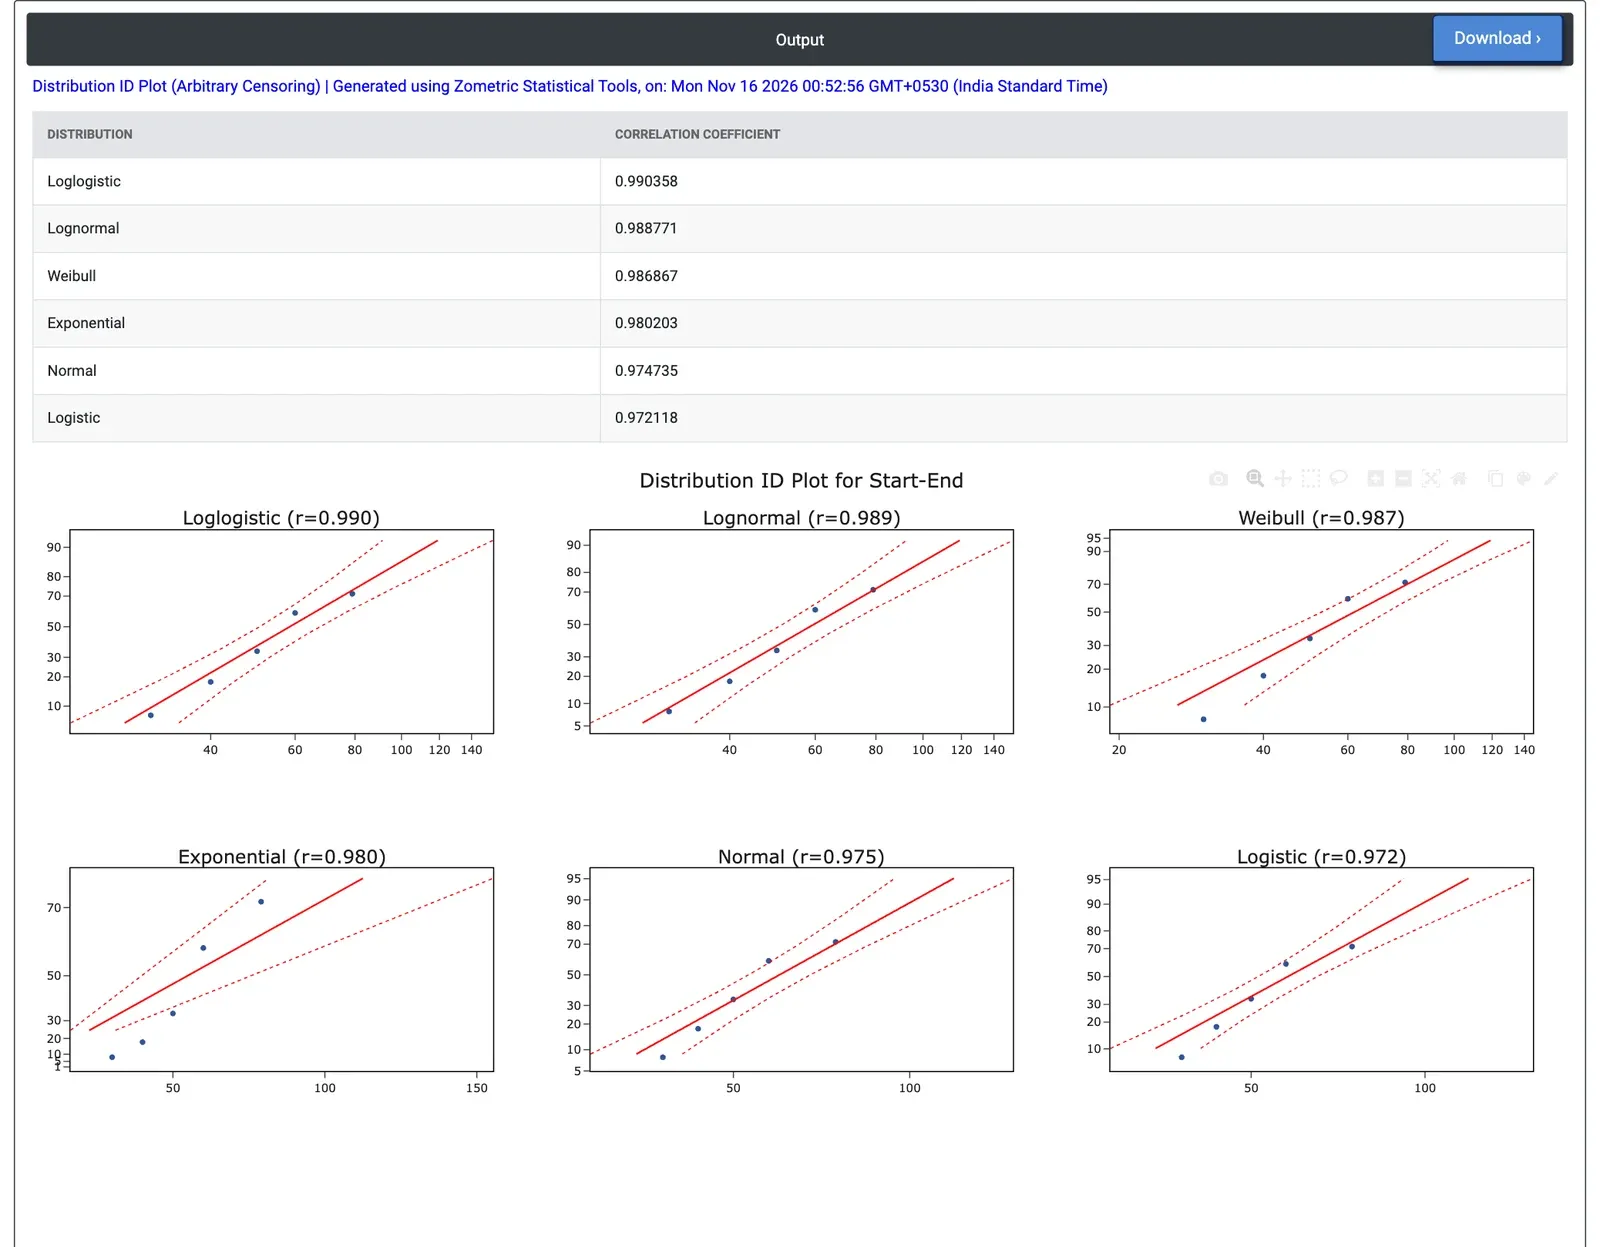
Abbildung 2 — Korrelationsrangfolge und Wahrscheinlichkeitsnetze für 50 Wicklungen, die alle 10 Stunden geprüft wurden: Loglogistic 0.990, Lognormal 0.989 und Weibull 0.987 liegen praktisch gleichauf.
Beispiel
Dieses Beispiel verwendet die 50 bei 80 °C geprüften Wicklungen von Turbinentriebwerken von der Seite Distribution ID Plot (Right Censoring), erfasst so, als wären die Wicklungen ab 30 Stunden nur bei Inspektionen alle 10 Stunden geprüft worden. Die 4 Wicklungen, die bei der ersten Inspektion als ausgefallen festgestellt wurden, sind linkszensiert (Start leer, End = 30). Die 33, die bei einer späteren Inspektion als ausgefallen festgestellt wurden, sind intervallzensiert, zum Beispiel Start = 50 und End = 60 für eine Wicklung, die bei 50 Stunden noch funktionierte und bei 60 ausgefallen war. Die 13 vor dem Ausfall entnommenen sind zu ihren Entnahmezeitpunkten rechtszensiert (End leer). Der Ingenieur wählt Start als Start column und End als End column.
Die Rangfolge lautet Loglogistic 0.990, Lognormal 0.989, Weibull 0.987, Exponential 0.980, Normal 0.975 und Logistic 0.972. Jedes Feld hat nur fünf Punkte, bei 30, 40, 50, 60 und 79 Stunden: die Zeitpunkte, an denen die Turnbull-Schätzung Ausfälle ansetzt (der eine zwischen 70 und 80 Stunden festgestellte Ausfall wird bei 79 Stunden angesetzt, nach der letzten rechtszensierten Wicklung innerhalb dieses Intervalls). Bei so wenigen Punkten sind alle Koeffizienten hoch und liegen eng beieinander, und die ersten drei lassen sich allein anhand der Daten nicht trennen. Die angepasste Weibull-Verteilung hat einen Skalenparameter von 73.3 Stunden und einen Formparameter von 2.17, nahe an den 73.3 Stunden und 2.32 aus den exakten Zeiten; die Gruppierung der Ausfälle in Inspektionsintervalle hat das angepasste Modell also nur wenig verändert.
Für den Ingenieur beschreiben Loglogistic, Lognormal und Weibull die Daten alle hinreichend gut; die Weibull-Verteilung bleibt eine sinnvolle Wahl für Verschleißausfälle, weil ihr Formparameter den Trend der Ausfallrate zeigt. Der nächste Schritt ist ein Distribution Overview Plot (Arbitrary Censoring) mit der gewählten Verteilung, um die angepassten Überlebens- und Ausfallratenkurven zu sehen.
Häufig gestellte Fragen
Wie gibt man intervallzensierte Daten ein?
Verwenden Sie eine Start-Spalte und eine End-Spalte. Start gleich End ist ein exakter Ausfall; Start kleiner als End ist ein intervallzensierter Ausfall zwischen beiden Zeitpunkten; ein leeres End bedeutet rechtszensiert bei Start (zu diesem Zeitpunkt noch funktionsfähig); ein leeres Start bedeutet linkszensiert bei End (zu diesem Zeitpunkt bereits ausgefallen). Start darf nicht größer als End sein.
Wie wählt man anhand des Diagramms die beste Verteilung?
Die Verteilungen werden nach dem Korrelationskoeffizienten ihrer Wahrscheinlichkeitsnetze geordnet; Werte nahe 1 bedeuten einen geraderen Verlauf. Bei gruppierten Inspektionsdaten gibt es weniger unterschiedliche Diagrammpunkte als Einheiten; betrachten Sie daher neben der Rangfolge auch die einzelnen Felder, prüfen Sie die Punkte gegen die Konfidenzgrenzen und nutzen Sie technisches Wissen über den Ausfallmechanismus.
Was ist die Turnbull-Schätzung?
Sie ist die nichtparametrische Schätzung der kumulierten Ausfallwahrscheinlichkeit, die für die Diagrammpunkte verwendet wird. Es handelt sich um ein iteratives Verfahren, das jeden intervallzensierten Ausfall auf die Zeitpunkte verteilt, zu denen er eingetreten sein könnte. Im Wicklungsbeispiel setzte sie Ausfälle nur zu fünf Zeitpunkten an, sodass alle Korrelationskoeffizienten hoch waren und eng beieinander lagen.
Was sollte man nach dem Distribution ID Plot tun?
Erstellen Sie einen Distribution Overview Plot (Arbitrary Censoring) mit der gewählten Verteilung, um die angepassten Überlebens- und Ausfallratenkurven zu sehen. Im Beispiel lagen Loglogistic, Lognormal und Weibull praktisch gleichauf, und die Weibull-Verteilung blieb eine sinnvolle Wahl für Verschleißausfälle, weil ihr Formparameter den Trend der Ausfallrate zeigt.