
Gemischtes Modell anpassen (Fit Mixed Effects Model)
Fit Mixed Effects Model testet feste kategoriale Faktoren und Kovariaten und schätzt Varianzkomponenten für Zufallsfaktoren wie Chargen, Bediener oder Tage. Nutzen Sie es, wenn das Ignorieren von Zufallsfaktoren die Tests der festen Faktoren zu optimistisch machen würde. Jeder Zufallsfaktor braucht mindestens 3 Stufen. Ausgabe: Varianzkomponenten, F-Tests mit Satterthwaite-Freiheitsgraden, Koeffizienten und eine Modellzusammenfassung mit AICc und BIC.
Zuletzt geprüft
Kernaussage
Ein gemischtes Modell analysiert eine Zielgröße, die von festen Faktoren, deren Stufen Sie vergleichen, und von Zufallsfaktoren aus einer Grundgesamtheit abhängt; es testet die festen Faktoren und schätzt die Zufallsvarianz.
Auf dieser Seite
Zweck
Fit Mixed Effects Model analysiert eine Zielgröße, die von zwei Arten von Faktoren abhängt: festen Faktoren, deren konkrete Stufen Sie vergleichen möchten (zwei Maschinen, drei Lieferanten, eine neue und eine alte Methode), und Zufallsfaktoren, deren Stufen eine Stichprobe aus einer größeren Grundgesamtheit sind (Chargen, Proben, Bediener, Tage). Es testet die festen Faktoren und schätzt, wie viel Varianz jeder Zufallsfaktor beiträgt. Verwenden Sie es, wenn das Ignorieren der Zufallsfaktoren die Tests der festen Faktoren zu optimistisch machen würde, zum Beispiel wenn dieselben Chargen oder Teile unter jeder Bedingung gemessen werden.
Wichtige Funktionen
- Ein oder mehrere feste kategoriale Faktoren und stetige Kovariaten, mit einem oder mehreren Zufallsfaktoren.
- Varianzkomponenten für jeden Zufallsfaktor und den Fehler, mit % vom Gesamtwert, Standardfehler, Z-Test und Konfidenzintervall.
- F-Tests der festen Effekte mit Nenner-Freiheitsgraden nach Satterthwaite.
- Koeffizienten mit Satterthwaite-Freiheitsgraden, t-Tests und Konfidenzintervallen.
- Modellzusammenfassung mit S, R-sq, R-sq(adj), AICc, BIC und −2 log likelihood.
- Schätzung mit Restricted Maximum Likelihood (REML) oder Maximum Likelihood (ML).
- Data Options: Auswahl einer Teilmenge der Zeilen vor der Analyse.
Statistische Methoden
Das Modell lautet y = Xβ + Σ Zᵢuᵢ + ε. Dabei enthält Xβ die festen Faktoren (Summe-null-Kodierung −1/0/+1) und Kovariaten, jeder Zufallsfaktor i fügt unabhängige Effekte uᵢ mit Varianz σᵢ² hinzu, und die Fehler ε haben die Varianz σ². Zufallsfaktoren sind unabhängige Varianzkomponenten (es werden keine Wechselwirkungen angepasst). Die Varianzen werden per REML (Standard) geschätzt, das die von den festen Effekten verbrauchten Freiheitsgrade berücksichtigt und nahezu erwartungstreue Varianzkomponenten liefert, oder per ML, das erforderlich ist, um Modelle mit unterschiedlichen festen Effekten anhand von AICc oder BIC zu vergleichen. Zeilen mit einem fehlenden Wert werden verworfen; jeder Zufallsfaktor benötigt mindestens 3 Stufen.
Auf Basis der Varianzschätzungen sind die festen Koeffizienten Schätzungen nach der verallgemeinerten Methode der kleinsten Quadrate. Jeder feste Term wird mit einer F-Statistik getestet, deren Nenner-Freiheitsgrade aus der Satterthwaite-Approximation stammen, und jeder Koeffizient mit einem t-Test auf Satterthwaite-Freiheitsgraden. Varianzkomponenten haben Standardfehler aus der Fisher-Information, einen einseitigen Test Z = Var / SE Var darauf, dass die Komponente null ist, und ein auf der logarithmischen Skala berechnetes Konfidenzintervall, das daher nie negativ ist. Bei wenigen Stufen eines Zufallsfaktors hat dieser Z-Test eine geringe Trennschärfe und das Intervall ist breit.
R-sq vergleicht die bedingten Anpassungswerte (feste Effekte plus vorhergesagte Zufallseffekte) mit der Gesamtstreuung. S ist die Quadratwurzel der Fehlervarianz. AICc und BIC sind bei besseren Modellen kleiner; mit REML vergleichen sie nur Modelle, die dieselben festen Effekte haben.
Eingabefelder und Optionen
Feld | Beschreibung |
Response (Y) | Numerische Spalte der Zielgröße. Erforderlich. |
Fixed factors (categorical) | Eine oder mehrere Spalten, deren konkrete Stufen von direktem Interesse sind. Erforderlich. |
Random factors (categorical) | Eine oder mehrere Spalten, deren Stufen eine Zufallsstichprobe aus einer größeren Grundgesamtheit sind (z. B. Field, Batch, Operator), modelliert als unabhängige Varianzkomponenten. Erforderlich. |
Covariates (continuous) | Optionale numerische Spalten, die nur als feste Haupteffekte aufgenommen werden. |
Confidence level | Standard 95. |
Estimation method | Restricted maximum likelihood (REML), der Standard, oder Maximum likelihood (ML). |
Data Options: Subset (optional) | Exclude matching rows (Standard) oder Include only matching rows, nach Zeilennummern und/oder einer Bedingung. |
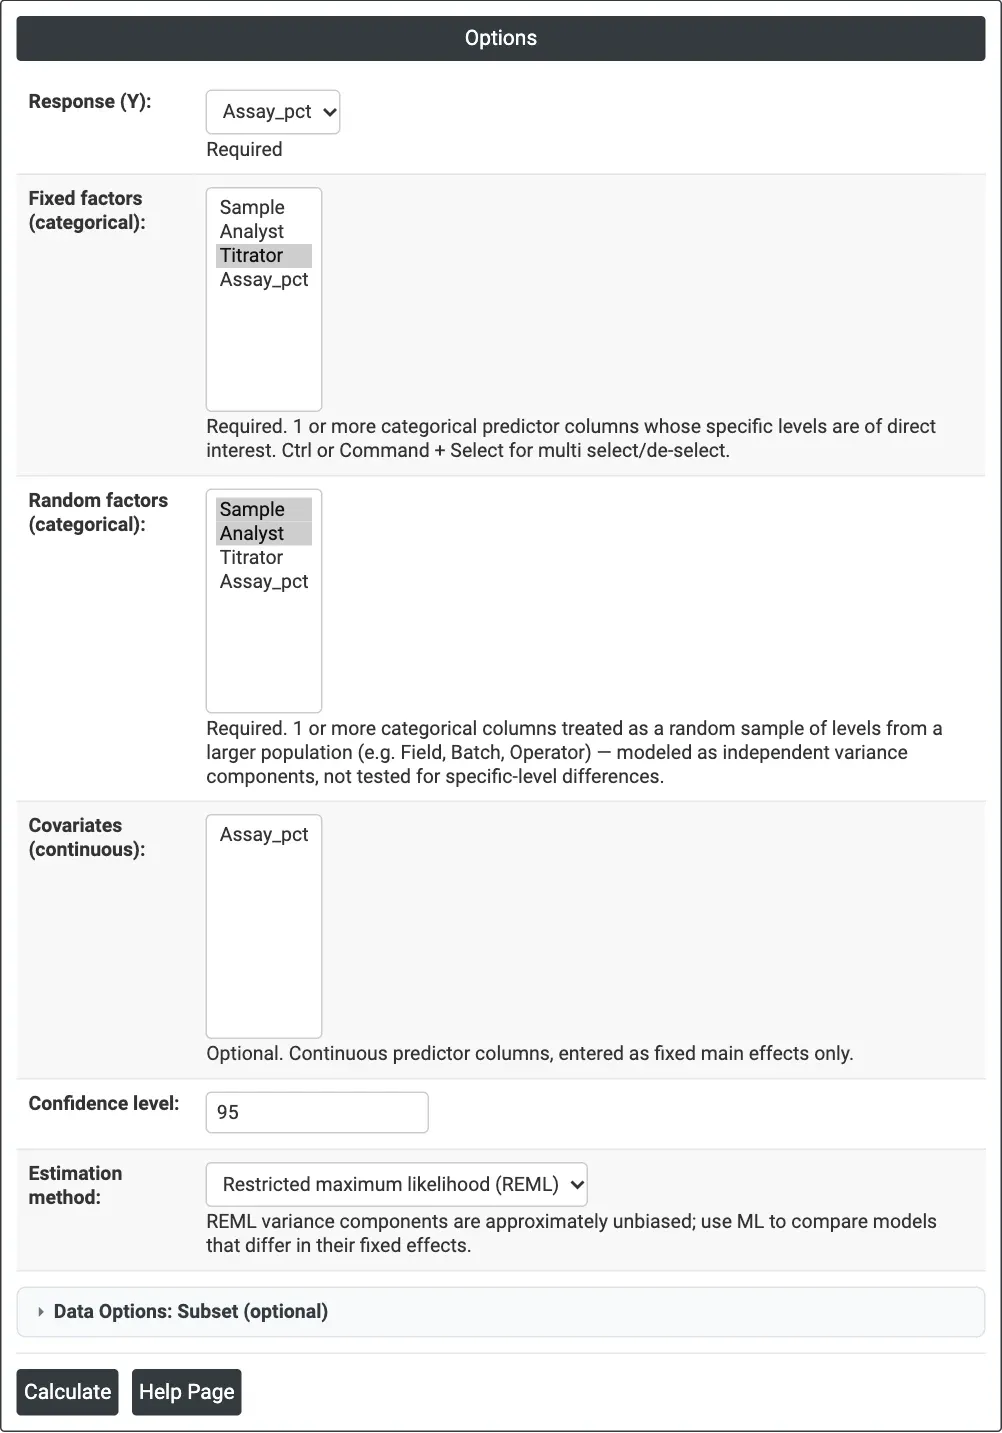
Abbildung 1 — Optionen für das Titratorbeispiel: Assay_pct als Zielgröße, Titrator als fester Faktor, Sample und Analyst als Zufallsfaktoren, REML.
Beschreibung der Ausgaben
- Method — Verfahren zur Varianzschätzung und Verfahren für die Freiheitsgrade der festen Effekte.
- Variance Components — Var, % of Total, SE Var, Z-Value, P-Value und Konfidenzintervall für jeden Zufallsfaktor, den Fehler und die Gesamtsumme.
- Tests of Fixed Effects — DF Num, DF Den, F-Value und P-Value für jeden festen Faktor und jede Kovariate.
- Model Summary — S, R-sq, R-sq(adj), AICc, BIC und −2 log likelihood.
- Coefficients — Coef, SE Coef, DF, T-Value, P-Value und Konfidenzintervall.
- Eine Warnung wird angezeigt, wenn der Optimierer nicht vollständig konvergiert ist.
- PDF-Export über Download.
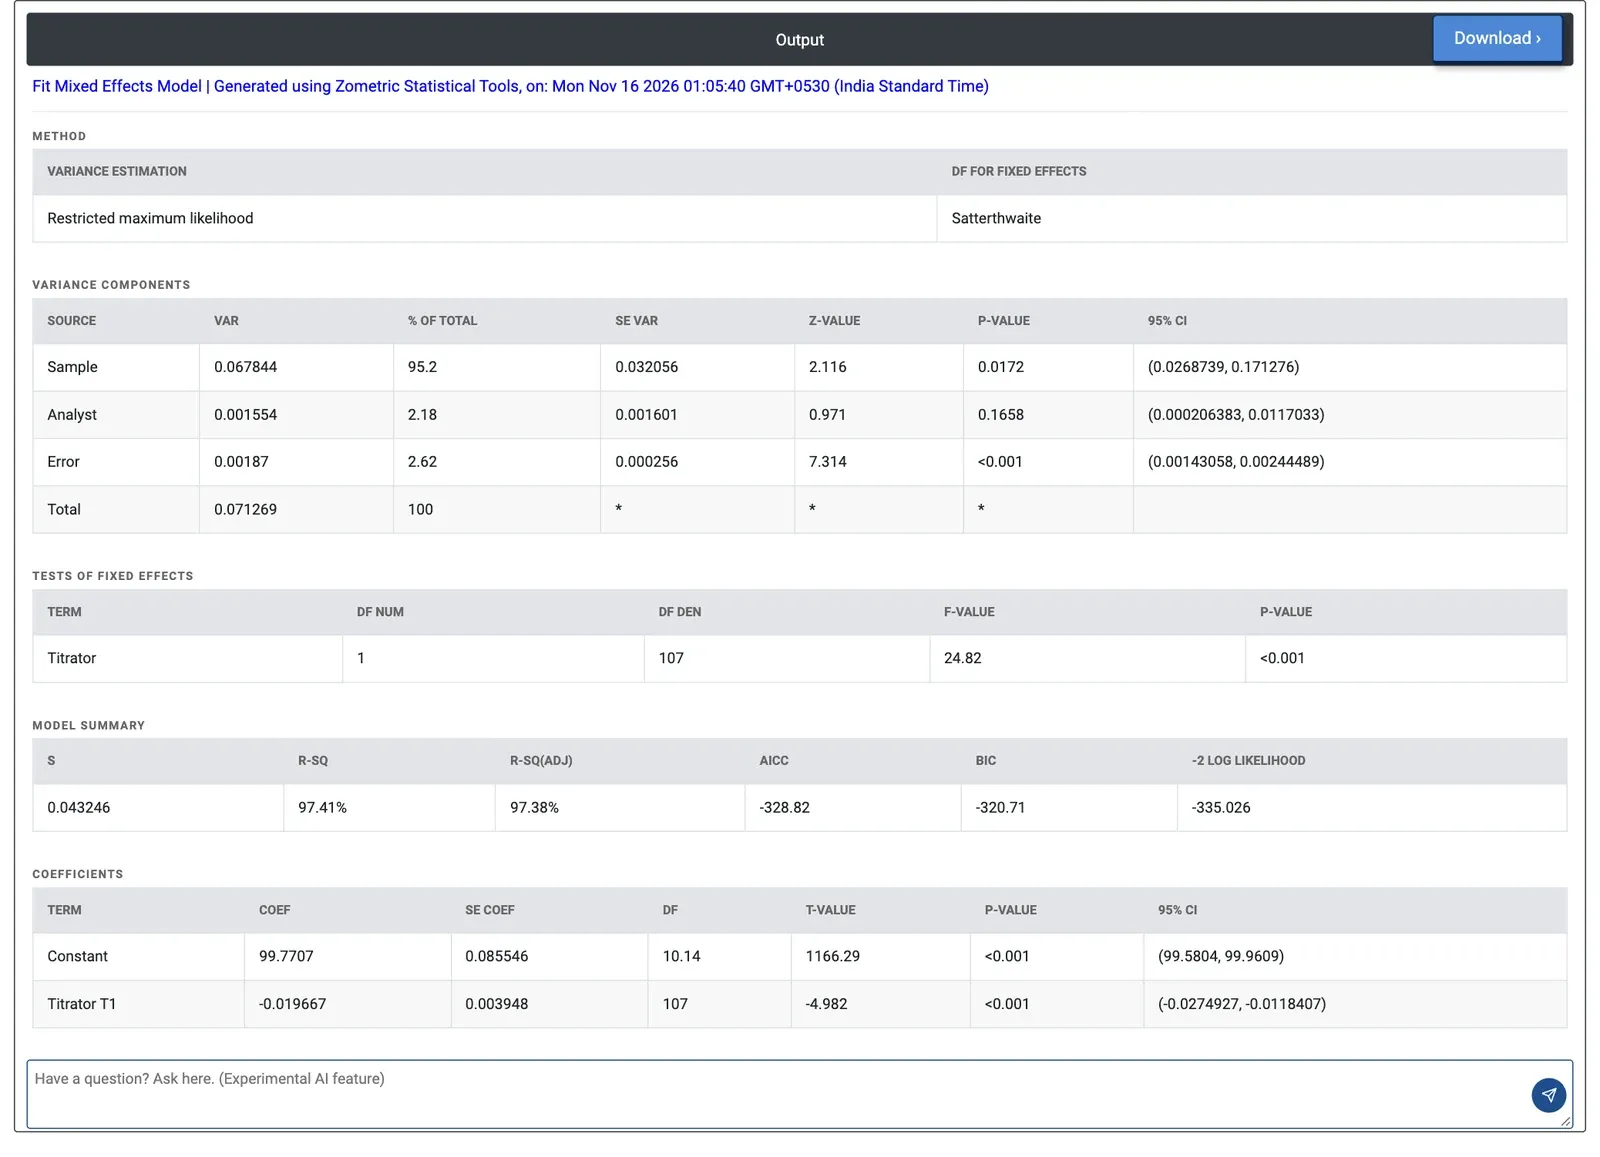
Abbildung 2 — Gemischtes Modell der Gehaltsbestimmungen: Die Proben machen 95.2 % der Varianz aus, und die beiden Titratoren unterscheiden sich (F = 24.82, p < 0.001).
Beispiel
Ein Sodalabor misst die Produktreinheit (Assay_pct) an zwei automatischen Titratoren, T1 und T2. Zehn Proben werden von drei Analytikern jeweils zweimal an beiden Titratoren gemessen: 120 Ergebnisse. Die Frage ist, ob die beiden Titratoren dasselbe Ergebnis liefern. Die Titratoren sind die beiden Geräte, die das Labor besitzt, daher ist Titrator ein fester Faktor; die Proben und Analytiker stehen für viele mögliche Proben und Analytiker und sind daher Zufallsfaktoren. Das Labor gibt Assay_pct als Zielgröße, Titrator als festen Faktor sowie Sample und Analyst als Zufallsfaktoren ein, mit REML. Load Example füllt diese Daten (soda-ash-assay-expanded-grr, dieselbe Studie wie im Beispiel zur Gage R&R Study (Expanded)) und diese Einstellungen aus.
Die Varianzkomponenten zeigen, dass sich die Proben selbst am stärksten unterscheiden: 0.0678 (95.2 % der Gesamtvarianz, Standardabweichung etwa 0.26 Prozentpunkte). Die Komponente der Analytiker ist klein, 0.00155 (2.18 %), und nicht signifikant von null verschieden (p = 0.1658); der Fehler, also die Wiederholbarkeit eines Einzelergebnisses, beträgt 0.00187 (Standardabweichung 0.043).
Titrator ist signifikant: F = 24.82 bei 1 und 107 Freiheitsgraden, p < 0.001. Der Koeffizient für T1 beträgt bei Summe-null-Kodierung −0.0197, T2 misst also etwa 0.039 Prozentpunkte höher als T1, nahe an einer Standardabweichung der Wiederholbarkeit. Da jede Probe an beiden Titratoren gemessen wurde, verdeckt die Streuung zwischen den Proben diesen Unterschied nicht. Das Labor beschließt, die Kalibrierung beider Titratoren anhand eines Referenzstandards zu überprüfen.
Häufig gestellte Fragen
Was ist der Unterschied zwischen einem festen und einem zufälligen Faktor?
Ein fester Faktor hat konkrete Stufen, die Sie vergleichen möchten, etwa zwei Maschinen, drei Lieferanten oder eine neue und eine alte Methode. Ein Zufallsfaktor hat Stufen, die eine Stichprobe aus einer größeren Grundgesamtheit sind, etwa Chargen, Proben, Bediener oder Tage. Ein gemischtes Modell testet die festen Faktoren und schätzt, wie viel Varianz jeder Zufallsfaktor beiträgt.
Wann sollte man ein gemischtes Modell verwenden?
Verwenden Sie ein gemischtes Modell, wenn das Ignorieren der Zufallsfaktoren die Tests der festen Faktoren zu optimistisch machen würde, zum Beispiel wenn dieselben Chargen oder Teile unter jeder Bedingung gemessen werden. Im Titratorbeispiel wurden zehn Proben an beiden Titratoren gemessen, sodass die Streuung zwischen den Proben den Unterschied zwischen den Titratoren nicht verdeckte.
Sollte man für ein gemischtes Modell REML oder ML verwenden?
REML, der Standard, berücksichtigt die von den festen Effekten verbrauchten Freiheitsgrade und liefert nahezu erwartungstreue Varianzkomponenten. ML ist erforderlich, um Modelle mit unterschiedlichen festen Effekten anhand von AICc oder BIC zu vergleichen. Mit REML vergleichen AICc und BIC nur Modelle, die dieselben festen Effekte haben.
Wie interpretiert man die Tabelle der Varianzkomponenten?
Jeder Zufallsfaktor und der Fehler haben eine Varianz, ihren prozentualen Anteil an der Gesamtvarianz, einen Standardfehler, einen einseitigen Z-Test darauf, dass die Komponente null ist, und ein auf der logarithmischen Skala berechnetes Konfidenzintervall, das daher nie negativ ist. Bei wenigen Stufen eines Zufallsfaktors hat der Z-Test eine geringe Trennschärfe und das Intervall ist breit.