
Regressionsmodell anpassen (Fit Regression Model)
Fit Regression Model passt eine Regressionsgleichung für eine stetige Zielgröße mit mehreren stetigen und kategorialen Prädiktoren an. Einsatz: Vorhersage, Zusammenhangsanalyse und Prognose; für kategoriale Zielgrößen ist stattdessen die logistische Regression nötig. Erheben Sie repräsentative, genaue Daten, prüfen Sie Multikollinearität mit dem VIF und validieren Sie mit Residuendiagrammen. Die Tests verwenden Adjusted (Type III, Standard) oder Sequential (Type I) Quadratsummen, Konfidenzintervalle standardmäßig mit 95%.
Zuletzt geprüft
Kernaussage
Fit Regression Model erstellt eine Gleichung, die quantifiziert, wie ein oder mehrere stetige oder kategoriale Prädiktoren eine stetige Zielgröße beeinflussen, sodass Sie signifikante Variablen erkennen und Ergebnisse vorhersagen können.
Auf dieser Seite
Was ist Fit Regression Model?
Fit Regression Model ist ein statistisches Werkzeug, mit dem der Zusammenhang zwischen einer oder mehreren Prädiktorvariablen und einer stetigen Zielgröße untersucht und quantifiziert wird. Anders als Fit Line Model, das nur einen einzigen Prädiktor verarbeitet, unterstützt Fit Regression Model mehrere Prädiktoren, sowohl stetige als auch kategoriale, und ist damit vielseitiger für die Analyse realer Daten.
Es legt eine mathematische Gleichung durch Ihre Daten, die am besten beschreibt, wie die Prädiktoren gemeinsam die Zielgröße beeinflussen. Mit dieser Gleichung lassen sich anschließend Muster verstehen, signifikante Variablen erkennen und künftige Ergebnisse vorhersagen.
Einfache Definition: Ein Werkzeug, das den besten mathematischen Zusammenhang zwischen mehreren Eingangsvariablen und einer Ausgangsvariablen findet, damit Sie Trends verstehen und genaue Vorhersagen treffen können.
Wann wird Fit Regression Model eingesetzt?
Ein angepasstes Regressionsmodell wird typischerweise eingesetzt, wenn der Zusammenhang zwischen einer oder mehreren unabhängigen Variablen und einer abhängigen Variablen analysiert werden soll. Es ist ein nützliches Werkzeug, um das Verhalten einer abhängigen Variablen anhand der Werte der unabhängigen Variablen vorherzusagen und zu verstehen.
Typische Situationen, in denen ein angepasstes Regressionsmodell nützlich sein kann:
- Vorhersagemodellierung: Wenn Sie den Wert einer abhängigen Variablen anhand der Werte einer oder mehrerer unabhängiger Variablen vorhersagen möchten, kann ein angepasstes Regressionsmodell hilfreich sein. Beispielsweise möchten Sie den Absatz eines Produkts anhand von Faktoren wie Preis, Werbung und Kundendemografie vorhersagen.
- Zusammenhangsanalyse: Wenn Sie den Zusammenhang zwischen einer abhängigen Variablen und einer oder mehreren unabhängigen Variablen verstehen möchten, kann ein angepasstes Regressionsmodell helfen. Beispielsweise möchten Sie den Zusammenhang zwischen Einkommen und Bildungsniveau oder zwischen Bewegungsgewohnheiten und Gesundheitsergebnissen verstehen.
- Prognose: Wenn Sie künftige Werte einer abhängigen Variablen auf Basis historischer Daten prognostizieren möchten, kann ein angepasstes Regressionsmodell nützlich sein. Beispielsweise möchten Sie künftige Umsätze auf Basis historischer Umsatzdaten und weiterer Variablen wie Wirtschaftsindikatoren und saisonaler Trends prognostizieren.
- Prädiktoren können stetig, kategorial oder eine Kombination aus beidem sein.
- Diskrete Variablen können je nach Anzahl der Stufen und Analysezweck als stetig oder kategorial behandelt werden.
- Die Zielgröße muss stetig sein.
- Eine kategoriale Zielgröße erfüllt die Modellannahmen voraussichtlich nicht und liefert keine genauen Vorhersagen.
Allgemein kann ein angepasstes Regressionsmodell immer dann nützlich sein, wenn das Verhalten einer abhängigen Variablen auf Basis einer oder mehrerer unabhängiger Variablen verstanden oder vorhergesagt werden soll.
Hinweise zur richtigen Anwendung von Fit Regression Model
- Verwenden Sie eine stetige Zielgröße mit einem oder mehreren stetigen oder kategorialen Prädiktoren; ist die Zielgröße kategorial oder eine Zählgröße, wenden Sie stattdessen das passende logistische oder Poisson-Modell an.
- Stellen Sie sicher, dass die Daten die Zielgrundgesamtheit zutreffend abbilden; verzerrte oder unvollständige Stichproben führen zu unzuverlässigen Ergebnissen.
- Erheben Sie ausreichend viele Datenpunkte , um die nötige statistische Präzision zu erreichen und ein stabiles Regressionsmodell sicherzustellen.
- Messen Sie alle Variablen so genau und präzise wie möglich; Messfehler wirken sich direkt auf die Qualität des angepassten Modells aus.
- Erfassen Sie die Daten in der Reihenfolge ihrer Erhebung , damit zeitabhängige Trends oder Muster in den Residuen erkannt werden können.
- Prüfen Sie die Prädiktoren auf Multikollinearität – ist sie stark ausgeprägt, lässt sich kaum erkennen, welche Prädiktoren tatsächlich signifikant sind. Verwenden Sie die Varianzinflationsfaktoren (VIF) in der Tabelle Coefficients, um das Ausmaß zu beurteilen.
- Validieren Sie das Modell nach der Anpassung mit Residuendiagrammen, Diagnosestatistiken und Kennzahlen der Modellzusammenfassung; ein schlecht angepasstes Modell kann zu irreführenden Schlussfolgerungen führen
Alternativen: Wann Sie Fit Regression Model nicht verwenden sollten
- Um den Zusammenhang zwischen einem stetigen Prädiktor und einer stetigen Zielgröße darzustellen, verwenden Sie ein Fitted Line Plot (Diagramm der Anpassungsgeraden).
- Für eine Zielgröße mit zwei Kategorien verwenden Sie Fit Binary Logistic Model (binäre logistische Regression).
- Für Zielgrößen mit drei oder mehr Kategorien mit natürlicher Rangfolge, etwa von „stimme überhaupt nicht zu“ bis „stimme voll zu“, verwenden Sie die ordinale logistische Regression (Ordinal Logistic Regression).
- Für Zielgrößen mit drei oder mehr Kategorien ohne natürliche Rangfolge, etwa Kratzer, Delle und Riss, verwenden Sie die nominale logistische Regression (Nominal Logistic Regression).
Beispiel für Fit Regression Model
Ein medizinischer Forscher möchte die Auswirkungen verschiedener Faktoren auf die Pulsfrequenz untersuchen. Er erfasst Körpergröße, Gewicht, Geschlecht, Rauchverhalten, Aktivitätsniveau und Ruhepuls von 91 Studierenden. Anschließend teilt er die Studierenden zufällig in zwei Gruppen ein. Die erste Gruppe läuft eine Minute auf der Stelle, während die andere Gruppe still steht. Danach erfasst der Forscher erneut die Pulsfrequenz der Studierenden. Die Schritte:
- Die erforderlichen Daten wurden erhoben.
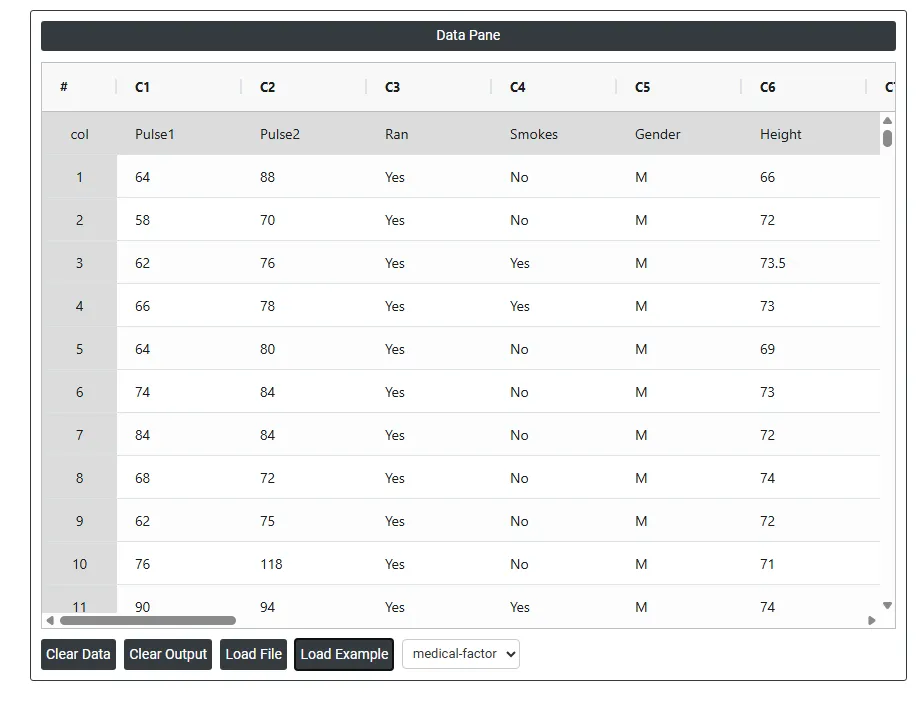
- Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
- Fit Regression Model finden Sie unter Statistical module> Regression>Fit Regression Model.
- Geben Sie im Werkzeug die Daten zusammen mit den weiteren Eingaben wie folgt ein:
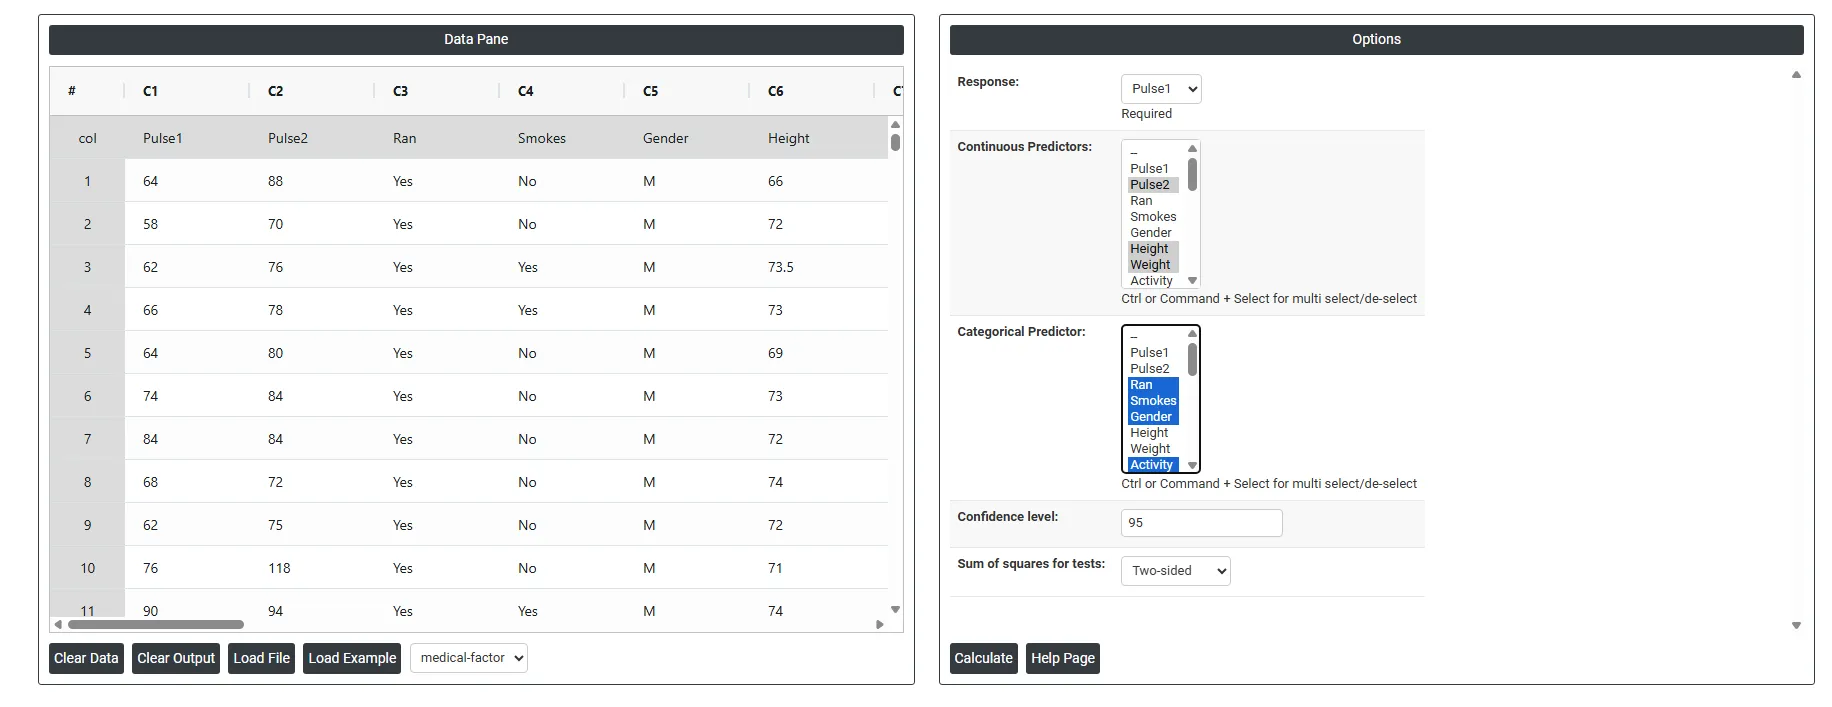
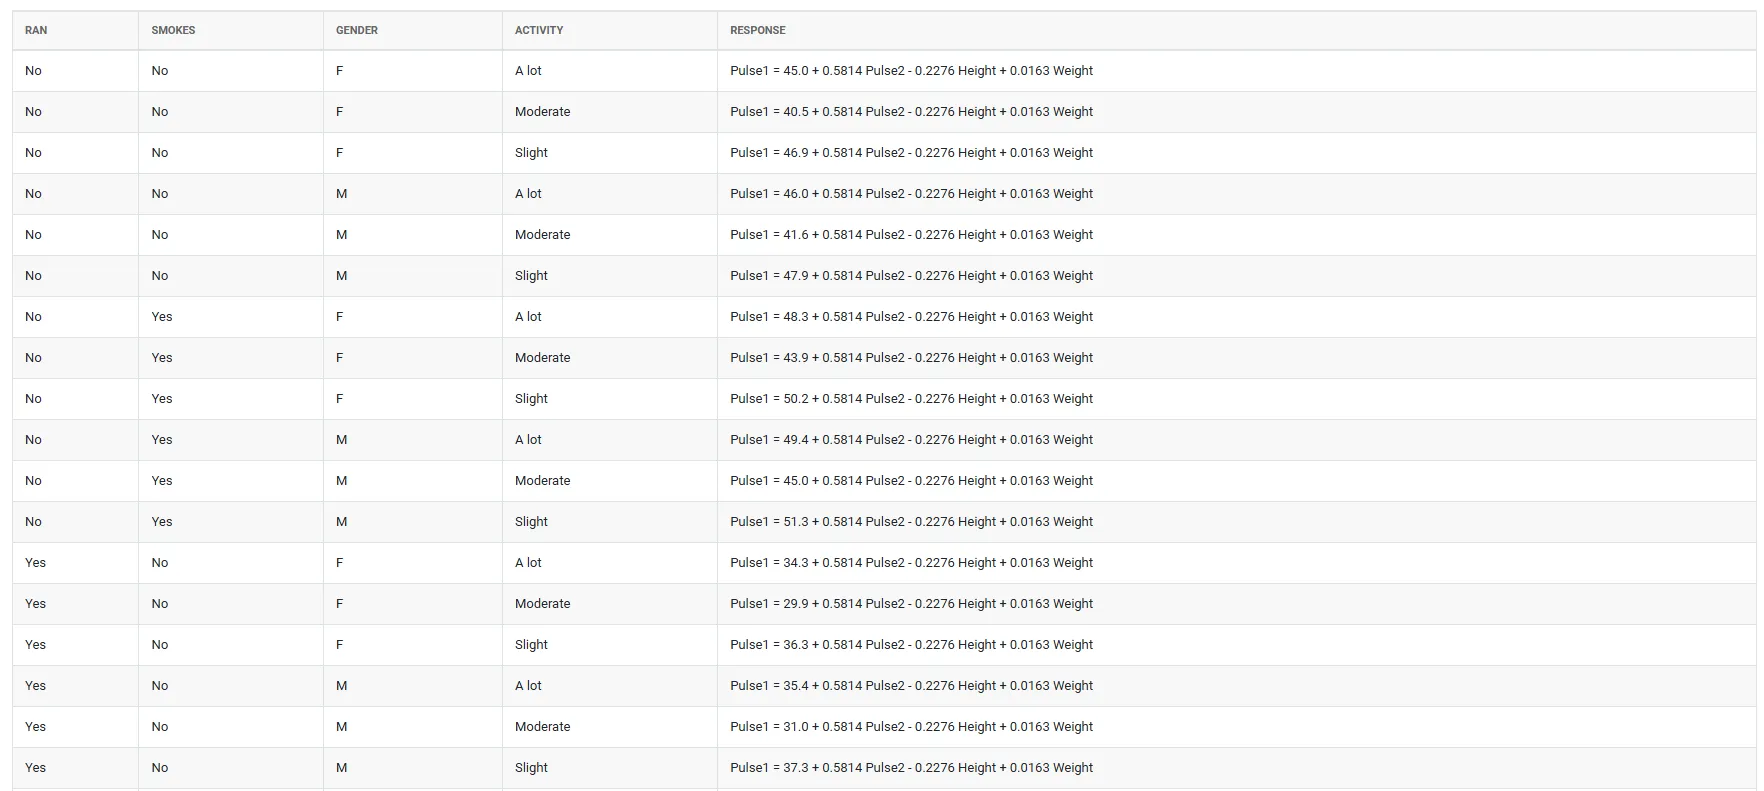
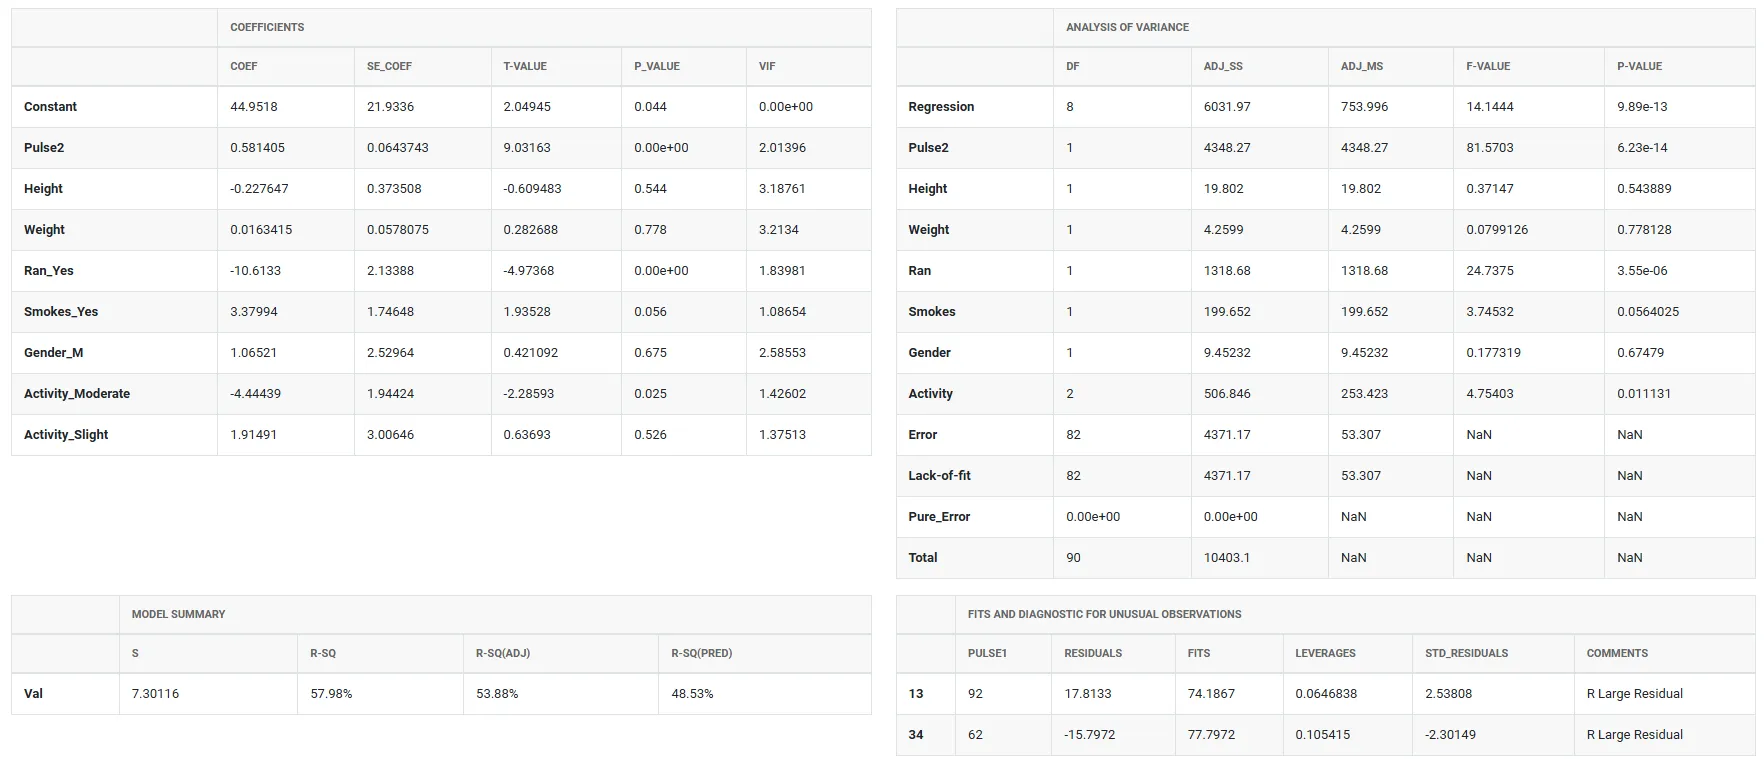
- Nach Ausführung des oben genannten Werkzeugs erhalten Sie folgende Ausgabe:
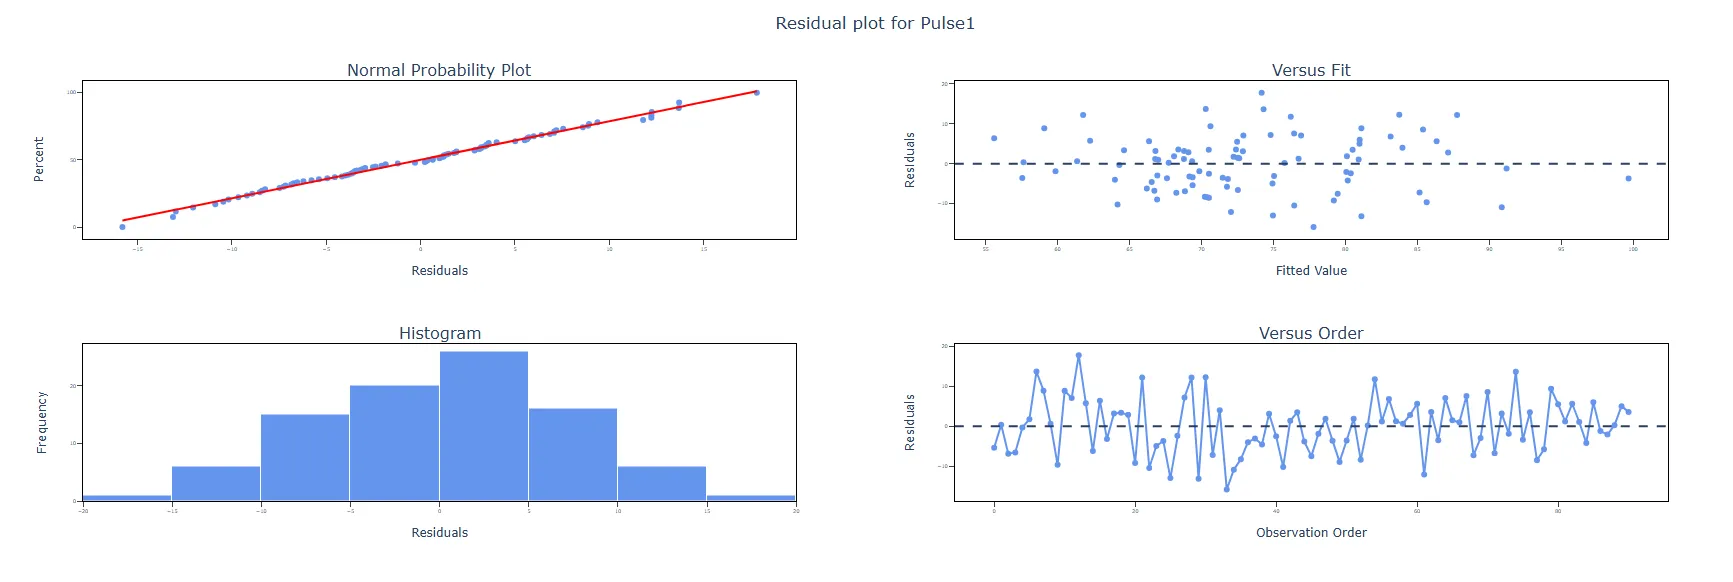
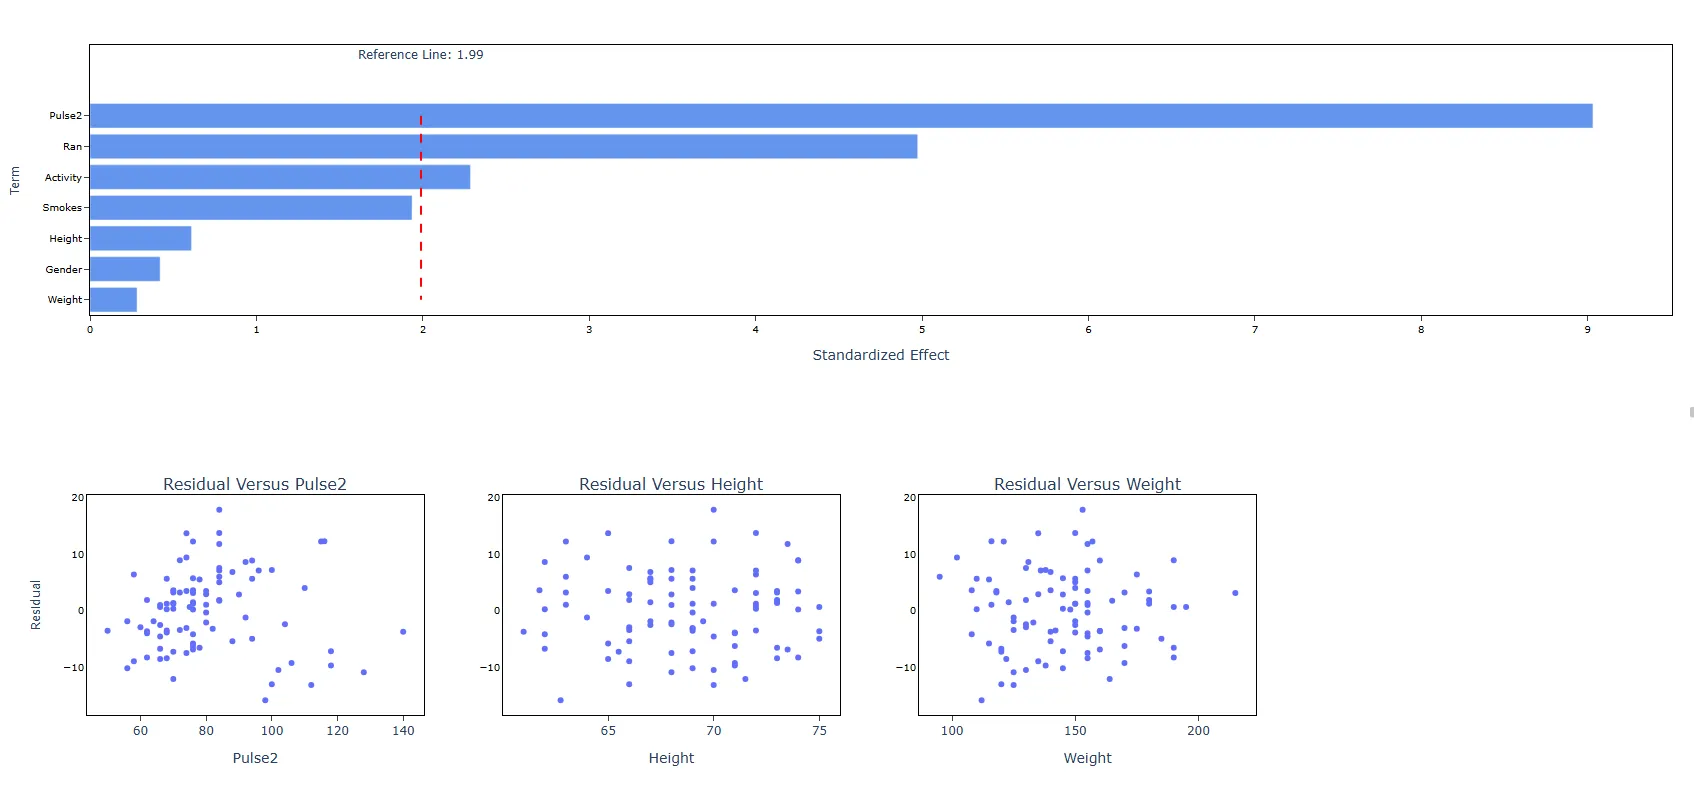
Anleitung: Fit Regression Model durchführen
So gehen Sie vor:
- Melden Sie sich bei Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Regression > Fit Regression Model.
- Geben Sie die Daten anschließend manuell ein, oder kopieren Sie die Daten vollständig (Strg+C) aus einer Excel-Tabelle und fügen Sie sie ein (Strg+V). Alternativ gibt es die Option Load Example, mit der Beispieldaten geladen werden.
- Füllen Sie anschließend die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Das Dashboard von Fit Regression Model ist in zwei Bereiche unterteilt.
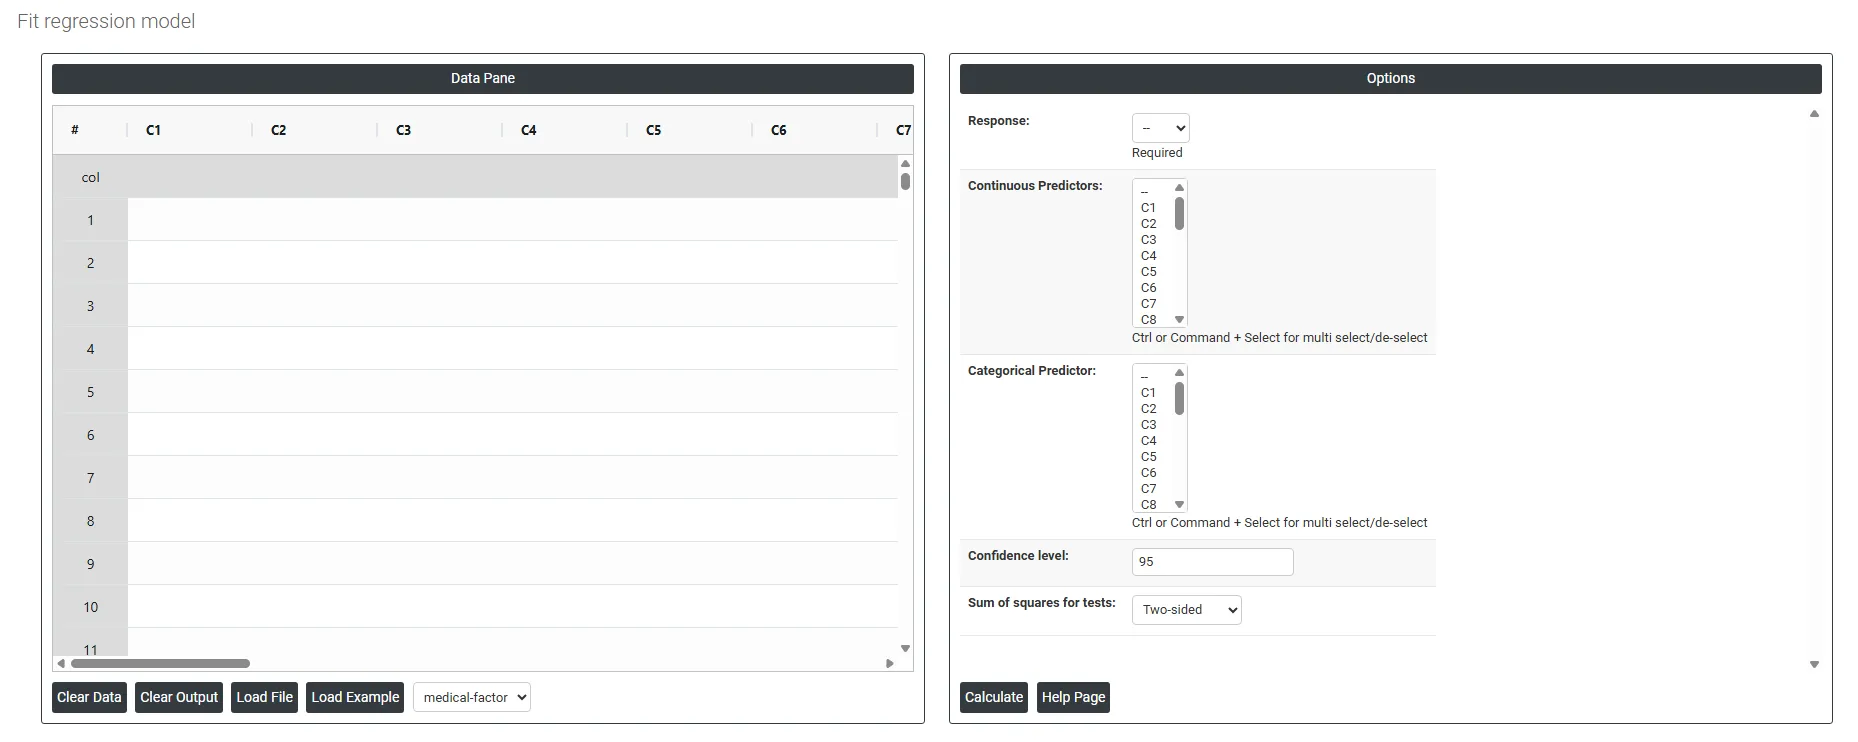
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile eine Teilgruppe. Die Daten können manuell eingegeben oder vollständig aus einer Excel-Tabelle kopiert (Strg+C) und hier eingefügt (Strg+V) werden.
Load example:Es werden Beispieldaten geladen.
Load File: Damit werden Excel-Daten direkt geladen.
Im rechten Bereich stehen folgende Optionen zur Verfügung:
- Response: In einem Regressionsmodell ist die Zielgröße die Variable, die durch die unabhängigen Variablen bzw. Prädiktoren vorhergesagt oder erklärt wird. Sie wird auch abhängige Variable oder Zielvariable genannt. Die Zielgröße ist die Variable, die das Regressionsmodell anhand der Werte der unabhängigen Variablen zu schätzen oder vorherzusagen versucht.
- Continuous Predictors: In einem Regressionsmodell ist ein stetiger Prädiktor eine Variable mit stetigen bzw. numerischen Werten, die zur Vorhersage oder Erklärung der Streuung der Zielgröße dient. Stetige Prädiktoren können jeden Wert innerhalb eines bestimmten Bereichs oder Intervalls annehmen, auch Dezimalstellen oder Brüche.
- Categorical Predictors: In der Regressionsanalyse sind kategoriale Prädiktoren Variablen, die eine begrenzte Anzahl diskreter Werte annehmen, die oft als Kategorien oder Stufen bezeichnet werden. Diese Variablen werden auch qualitative oder nominale Variablen genannt, im Gegensatz zu quantitativen oder numerischen Variablen.
- Confidence level: In der Regressionsanalyse ist das Konfidenzniveau ein Maß für die Präzision und Genauigkeit der geschätzten Koeffizienten des Regressionsmodells. Genauer ist das Konfidenzniveau der langfristige Anteil der auf gleiche Weise aus wiederholten Stichproben berechneten Konfidenzintervalle, die den wahren Wert eines Koeffizienten in der Grundgesamtheit enthalten würden. Das Konfidenzniveau wird üblicherweise als Prozentsatz angegeben; ein gängiger Wert ist 95%. Das bedeutet: Würde dasselbe Regressionsmodell wiederholt mit verschiedenen Datenstichproben geschätzt, enthielten etwa 95% der resultierenden Konfidenzintervalle den wahren Wert dieses Koeffizienten.
- Sum of squares for tests:
- Adjusted (Type III): Die Quadratsumme jedes Terms ist die Verringerung der Fehlerquadratsumme, wenn dieser Term einem Modell hinzugefügt wird, das bereits alle anderen Terme enthält; sein Test hängt daher nicht von der Reihenfolge ab, in der die Terme eingegeben werden. Dies ist der Standard und wird in der Regel bevorzugt. Sequential (Type I): Die Quadratsumme jedes Terms ist die Verringerung der Fehlerquadratsumme, wenn der Term dem Modell in der eingegebenen Reihenfolge hinzugefügt wird; der Test eines Terms hängt daher von den vor ihm eingegebenen Termen ab.
Häufig gestellte Fragen
Was ist Fit Regression Model?
Fit Regression Model untersucht und quantifiziert den Zusammenhang zwischen einer oder mehreren Prädiktorvariablen und einer stetigen Zielgröße. Es erstellt eine Gleichung, die am besten beschreibt, wie die Prädiktoren gemeinsam die Zielgröße beeinflussen, und mit der sich Muster verstehen, signifikante Variablen erkennen und künftige Ergebnisse vorhersagen lassen. Prädiktoren können stetig, kategorial oder eine Kombination aus beidem sein.
Was ist der Unterschied zwischen Fit Regression Model und Fit Line Model?
Fit Line Model verarbeitet nur einen einzigen Prädiktor, Fit Regression Model dagegen mehrere Prädiktoren, sowohl stetige als auch kategoriale. Um den Zusammenhang zwischen einem stetigen Prädiktor und einer stetigen Zielgröße darzustellen, ist ein Diagramm der Anpassungsgeraden (Fitted Line Plot) die einfachere Wahl; bei mehreren Prädiktoren verwenden Sie Fit Regression Model.
Wann sollten Sie Fit Regression Model nicht verwenden?
Die Zielgröße muss stetig sein. Für eine Zielgröße mit zwei Kategorien verwenden Sie Fit Binary Logistic Model. Für drei oder mehr Kategorien mit natürlicher Rangfolge, etwa von „stimme überhaupt nicht zu“ bis „stimme voll zu“, verwenden Sie die ordinale logistische Regression (Ordinal Logistic Regression). Für drei oder mehr Kategorien ohne natürliche Rangfolge, etwa Kratzer, Delle und Riss, verwenden Sie die nominale logistische Regression (Nominal Logistic Regression).
Wie prüfen Sie ein Regressionsmodell auf Multikollinearität?
Beurteilen Sie anhand der Varianzinflationsfaktoren (VIF) in der Tabelle Coefficients, wie stark die Multikollinearität zwischen den Prädiktoren ist. Ist sie stark, lässt sich kaum erkennen, welche Prädiktoren tatsächlich signifikant sind. Validieren Sie das Modell nach der Anpassung außerdem mit Residuendiagrammen, Diagnosestatistiken und Kennzahlen der Modellzusammenfassung, da ein schlecht angepasstes Modell zu irreführenden Schlussfolgerungen führen kann.