
Vollständig hierarchische ANOVA (Fully Nested ANOVA)
Die Fully Nested ANOVA schätzt, wie viel Streuung aus jeder Ebene einer Hierarchie stammt, mit zwei bis vier geschachtelten Zufallsfaktoren und Wiederholmessungen als Fehler. Jede Einheit einer unteren Ebene darf nur zu einer Einheit der übergeordneten Ebene gehören. Die Ausgabe umfasst eine ANOVA-Tabelle (F und P nur bei balancierten Versuchsplänen), Varianzkomponenten mit Anteil an der Gesamtstreuung, erwartete mittlere Quadrate, Modellzusammenfassung und Zellmittelwerte.
Zuletzt geprüft
Kernaussage
Die vollständig hierarchische ANOVA zerlegt die Streuung eines Messwerts auf die Ebenen einer Hierarchie, etwa Chargen, Proben innerhalb der Chargen und Wiederholmessungen, und zeigt, woher der größte Teil der Streuung kommt.
Auf dieser Seite
Zweck
Die vollständig hierarchische (geschachtelte) ANOVA zerlegt die Streuung eines Messwerts auf die Ebenen einer Hierarchie, etwa Chargen, Proben innerhalb jeder Charge und Wiederholmessungen innerhalb jeder Probe. Verwenden Sie sie, wenn jede Einheit einer unteren Ebene nur zu einer Einheit der übergeordneten Ebene gehört (Probe 1 aus Charge 1 ist nicht dasselbe Material wie Probe 1 aus Charge 2) und Sie wissen möchten, woher der größte Teil der Streuung kommt, damit Sie wissen, wo Sie ansetzen müssen: beim Prozess, bei der Probenahme oder bei der Messung.
Wichtige Funktionen
- Zwei bis vier geschachtelte Faktoren, vom äußersten (z. B. Batch) bis zum innersten (z. B. Sample); die Wiederholmessungen innerhalb des innersten Faktors bilden den Fehler.
- Eine Analyse je Zielgröße, wenn mehrere Zielgrößen ausgewählt sind.
- ANOVA-Tabelle mit sequenziellen Quadratsummen und F-Tests jeder Ebene gegen die jeweils darunterliegende Ebene.
- Varianzkomponenten mit ihrem Anteil an der Gesamtvarianz und ihren Standardabweichungen.
- Erwartete mittlere Quadrate, Modellzusammenfassung und eine Tabelle der Mittelwerte und Standardabweichungen für jede Zelle.
- Verarbeitet unbalancierte Daten für die Varianzkomponenten; Data Options zur Auswahl einer Teilmenge der Zeilen.
Statistische Methoden
Alle Faktoren werden als zufällig behandelt, und jeder ist im vorhergehenden geschachtelt. Die Quadratsumme jedes Faktors ist die Streuung seiner Zellmittelwerte um die Mittelwerte der übergeordneten Ebene; die Fehlerquadratsumme ist die Streuung der Messwerte um die Mittelwerte der innersten Zellen. Jeder Faktor hat (Anzahl seiner Zellen − Anzahl der Zellen darüber) Freiheitsgrade, der Fehler hat N − Anzahl der innersten Zellen.
Jeder Faktor wird gegen den nächstinneren Faktor getestet, der innerste Faktor gegen den Fehler: F = MS(factor) / MS(next inner term). F und P werden nur bei balancierten Versuchsplänen angegeben (gleiche Anzahl von Messwerten in jeder Zelle und gleiche Anzahl von Untereinheiten in jeder Einheit); bei unbalancierten Daten weist die Seite darauf hin und lässt sie weg.
Die Varianzkomponenten ergeben sich aus den erwarteten mittleren Quadraten (ANOVA-Methode): E(MS) jedes Faktors ist σ²(error) plus Vielfache der Komponenten dieses Faktors und der darin geschachtelten Faktoren, wie in der Tabelle Expected Mean Squares gezeigt; dort nummerieren (1), (2), … die Faktoren in Schachtelungsreihenfolge, und die letzte Nummer steht für den Fehler. Das Lösen dieser Gleichungen vom innersten Term nach außen liefert jede Komponente; eine negative Schätzung wird mit 0% der Gesamtvarianz angezeigt. % of Total ist der Anteil jeder Komponente an der summierten Varianz, StDev ihre Quadratwurzel. Zeilen mit fehlendem Wert der Zielgröße oder eines Faktors werden entfernt.
Eingabefelder und Optionen
Feld | Beschreibung |
Responses | Eine oder mehrere numerische Spalten. Pflichtfeld; eine Analyse je Zielgröße. |
Factor 1 (outermost) | Die oberste Ebene der Hierarchie, z. B. Batch. Pflichtfeld. |
Factor 2 (nested in Factor 1) | Pflichtfeld, z. B. Sample innerhalb von Batch. |
Factor 3 (nested in Factor 2) / Factor 4 (nested in Factor 3) | Optionale tiefere Ebenen; Factor 4 setzt Factor 3 voraus. |
Data Options: Subset (optional) | Exclude matching rows (Standard) oder Include only matching rows, nach Zeilennummern und/oder einer Bedingung. |
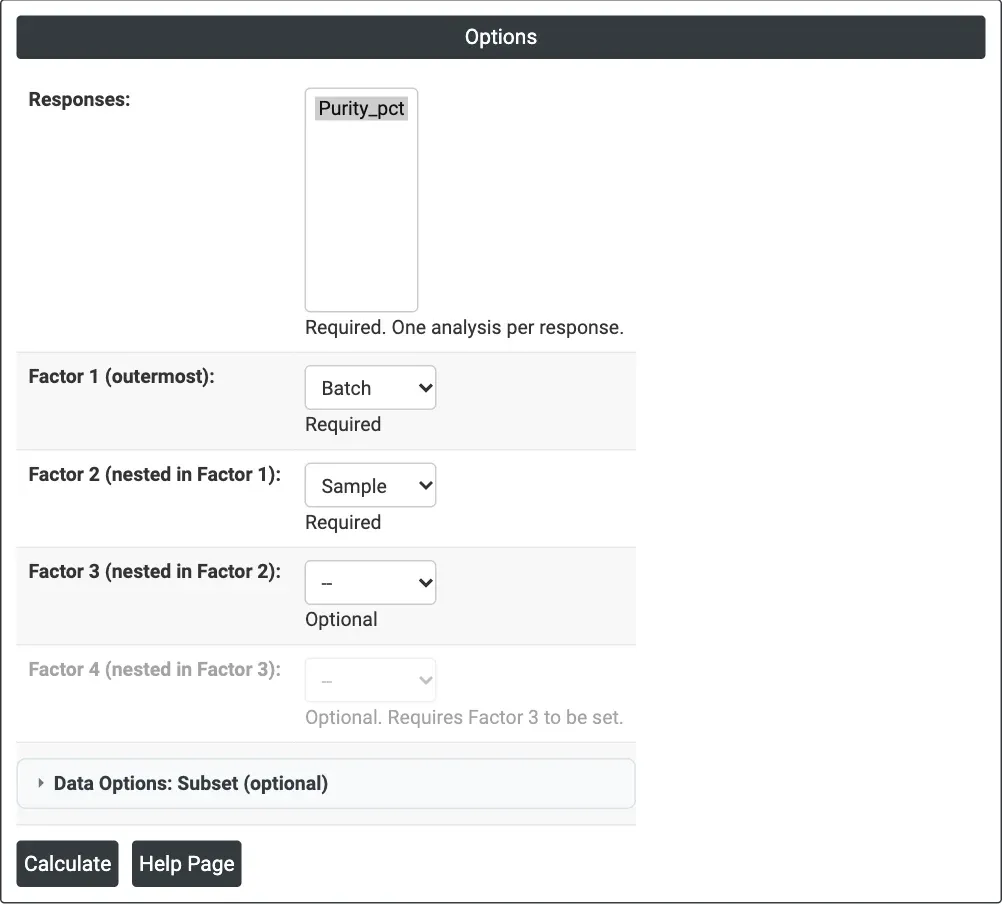
Abbildung 1 – Optionen für das Reinheitsbeispiel: Purity_pct als Zielgröße, Batch als Factor 1 und Sample (in Batch geschachtelt) als Factor 2.
Beschreibung der Ausgabe
- Analysis of Variance – DF, SS, MS, F und P für jeden Faktor, den Fehler und die Summe.
- Variance Components – Var Comp, % of Total und StDev für jeden Faktor, den Fehler und die Summe.
- Expected Mean Squares – die Zusammensetzung jedes mittleren Quadrats aus den Varianzkomponenten.
- Model Summary – S, R-sq und R-sq(adj).
- Means – N, Mittelwert und Standardabweichung jeder innersten Zelle.
- PDF-Export über Download.
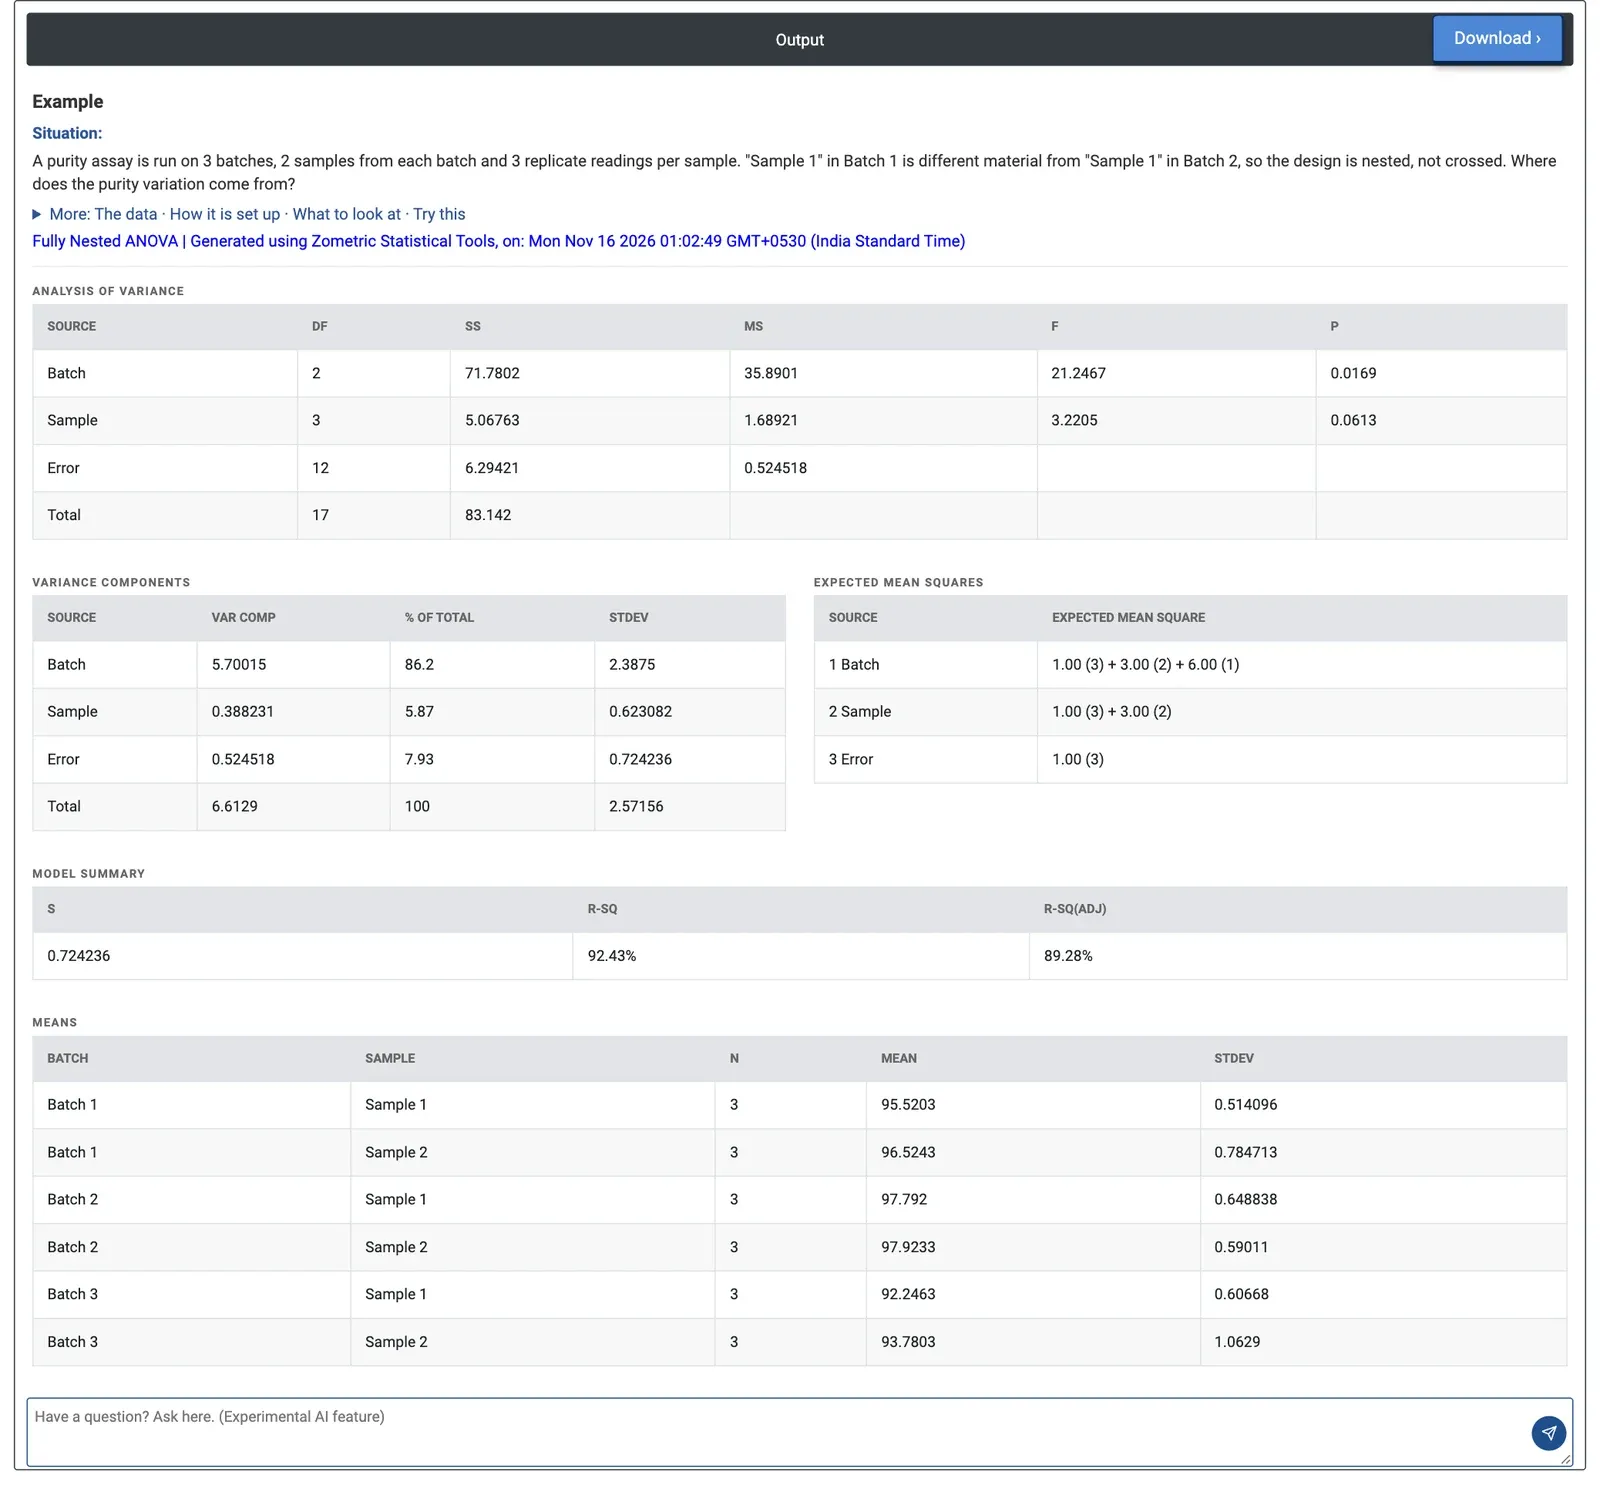
Abbildung 2 – Hierarchische ANOVA der Reinheit: Die Streuung zwischen den Chargen macht 86.2% der Gesamtvarianz aus; Proben innerhalb einer Charge tragen 5.87% bei, Wiederholmessungen 7.93%.
Beispiel
Eine Reinheitsbestimmung wird an 3 Chargen durchgeführt, mit 2 Proben je Charge und 3 Wiederholmessungen je Probe: 18 Ergebnisse. Das Qualitätsteam möchte wissen, ob die Streuung der Reinheit aus dem Chargenprozess, aus der Probenahme oder aus der Messung stammt. Es wählt Purity_pct als Zielgröße, Batch als Factor 1 und Sample als Factor 2; die Wiederholmessungen bilden den Fehler.
Die Chargen unterscheiden sich: F = 21.25 bei 2 und 3 Freiheitsgraden, p = 0.0169 (Batch wird gegen Sample innerhalb von Batch getestet). Die Proben innerhalb einer Charge unterscheiden sich auf dem 5%-Niveau nicht signifikant (F = 3.22, p = 0.0613). Charge 3 liegt am niedrigsten (Zellmittelwerte 92.25% und 93.78%), Charge 2 am höchsten (97.79% und 97.92%).
Die Varianzkomponenten machen das Bild deutlich: Die Varianz zwischen den Chargen beträgt 5.70 (86.2% der Gesamtvarianz, Standardabweichung 2.39 Prozentpunkte), zwischen den Proben 0.388 (5.87%) und bei den Wiederholmessungen 0.525 (7.93%, Standardabweichung 0.72). Eine bessere Probenahme oder ein präziseres Analyseverfahren würde wenig ändern; das Team sollte untersuchen, worin sich die Chargen unterscheiden.
Häufig gestellte Fragen
Wann sollten Sie eine vollständig hierarchische ANOVA verwenden?
Verwenden Sie sie, wenn jede Einheit einer unteren Ebene nur zu einer Einheit der übergeordneten Ebene gehört, etwa wenn Probe 1 aus Charge 1 nicht dasselbe Material ist wie Probe 1 aus Charge 2, und Sie wissen möchten, woher der größte Teil der Streuung kommt. Daraus ergibt sich, ob Sie beim Prozess, bei der Probenahme oder bei der Messung ansetzen sollten.
Wie werden die Faktoren in einer vollständig hierarchischen ANOVA getestet?
Alle Faktoren werden als zufällig behandelt, jeder ist im vorhergehenden geschachtelt. Jeder Faktor wird gegen den nächstinneren Faktor getestet, der innerste gegen den Fehler, also F = MS(factor) / MS(next inner term). F und P werden nur bei balancierten Versuchsplänen angegeben; bei unbalancierten Daten entfallen sie, die Varianzkomponenten werden aber weiterhin geschätzt.
Wie interpretieren Sie die Varianzkomponenten einer hierarchischen ANOVA?
% of Total jeder Komponente ist ihr Anteil an der summierten Varianz, StDev ihre Quadratwurzel. Im Reinheitsbeispiel machte die Varianz zwischen den Chargen 86.2% der Gesamtvarianz aus, Proben innerhalb einer Charge 5.87% und Wiederholmessungen 7.93%; eine bessere Probenahme oder ein präziseres Analyseverfahren würde also wenig ändern, und das Team sollte die Unterschiede zwischen den Chargen untersuchen.
Wie viele geschachtelte Faktoren kann eine vollständig hierarchische ANOVA enthalten?
Zwei bis vier geschachtelte Faktoren, vom äußersten, etwa Batch, bis zum innersten, etwa Sample. Factor 1 und Factor 2 sind Pflichtfelder, Factor 3 und Factor 4 optional, wobei Factor 4 Factor 3 voraussetzt. Die Wiederholmessungen innerhalb des innersten Faktors bilden den Fehler, und je ausgewählter Zielgröße wird eine Analyse durchgeführt.