
Allgemeines lineares Modell (General Linear Model)
Das General Linear Model passt feste kategoriale Faktoren, optionale Zweifach-Wechselwirkungen und stetige Kovariaten nach der Methode der kleinsten Quadrate an, mit angepassten (Typ III) oder sequenziellen Quadratsummen. Verwenden Sie es, wenn eine einfache ANOVA nicht ausreicht oder die Daten unbalanciert sind. Es setzt unabhängige, normalverteilte Fehler mit konstanter Varianz voraus. Die Ausgabe umfasst ANOVA-Tabelle, Kleinste-Quadrate-Mittelwerte, Koeffizienten mit VIF, Mehrfachvergleiche und Residuendiagramme.
Zuletzt geprüft
Kernaussage
Ein allgemeines lineares Modell (GLM) führt eine Varianzanalyse mit einem oder mehreren kategorialen Faktoren, ihren Zweifach-Wechselwirkungen und stetigen Kovariaten in einem Modell durch, auch bei unbalancierten Daten.
Auf dieser Seite
Zweck
Das General Linear Model (GLM, allgemeines lineares Modell) führt eine Varianzanalyse mit einem oder mehreren kategorialen Faktoren, ihren Zweifach-Wechselwirkungen und stetigen Kovariaten in einem Modell durch. Verwenden Sie es, wenn eine einfache ANOVA nicht ausreicht: zum Beispiel, wenn die Ausbeute von der Maschine, dem Bediener, deren Zusammenwirken und zusätzlich von einer gemessenen Bedingung wie der Temperatur abhängen kann, oder wenn die Daten unbalanciert sind. Es deckt auch die klassische zweifaktorielle ANOVA ab.
Wichtige Funktionen
- Beliebig viele feste kategoriale Faktoren, auf Wunsch mit allen Zweifach-Wechselwirkungen der Faktoren.
- Stetige Kovariaten, die als Haupteffekte aufgenommen werden (Kovarianzanalyse).
- Angepasste (Typ III) oder sequenzielle (Typ I) Quadratsummen; korrekte Tests für unbalancierte Daten.
- Kleinste-Quadrate-Mittelwerte für jeden Faktor, bereinigt um die übrigen Terme.
- Mehrfachvergleiche der Kleinste-Quadrate-Mittelwerte eines Faktors nach Tukey, Fisher, Bonferroni, Sidak oder Dunnett (gegen eine Kontrolle), mit Gruppierungsbuchstaben und einem Intervalldiagramm der Differenzen.
- Koeffizienten mit VIF, Modellzusammenfassung mit R-sq(pred), ungewöhnliche Beobachtungen und vier Residuendiagramme.
- Data Options: Auswahl der Zeilen vor der Analyse.
Statistische Methoden
Das Modell wird nach der gewöhnlichen Methode der kleinsten Quadrate angepasst. Faktoren verwenden eine Codierung mit Summe null (−1, 0, +1), sodass jeder Koeffizient die Abweichung einer Stufe vom Gesamtmittelwert ist und der Typ-III-Test eines Haupteffekts über die Stufen der anderen Faktoren mittelt. Zeilen mit fehlendem Wert in einer der ausgewählten Spalten werden entfernt. Jeder Term wird mit F = Adj MS(Term) / MS(Error) mit seinen eigenen und den Fehler-Freiheitsgraden getestet; bei sequenziellen Quadratsummen wird jeder Term nach den darüberstehenden Termen getestet. Die Zeile Total ist die Gesamtquadratsumme um den Mittelwert; bei unbalancierten Daten müssen sich die angepassten Quadratsummen nicht zu ihr aufsummieren.
S = √MS(Error). R-sq(pred) = 1 − PRESS / SS Total, wobei PRESS die quadrierten Leave-One-out-Vorhersagefehler summiert. Ein Kleinste-Quadrate-Mittelwert ist die Vorhersage des Modells für eine Faktorstufe, wobei über die Stufen der anderen Faktoren gemittelt wird und die Kovariaten auf ihrem Mittelwert stehen; anders als Rohmittelwerte ist er nicht durch ungleiche Gruppengrößen oder Unterschiede in den Kovariaten verzerrt.
Die Vergleiche verwenden die Differenz der Kleinste-Quadrate-Mittelwerte mit ihrem Standardfehler aus der Kovarianzmatrix der Koeffizienten. Tukey verwendet für alle Paare die Verteilung der studentisierten Spannweite; Fisher verwendet einzelne t-Tests; Bonferroni und Sidak passen den kritischen t-Wert an die Anzahl der Paare an; Dunnett vergleicht jede Stufe mit einer Kontrolle anhand der multivariaten t-Verteilung. Ein Intervall, das null nicht enthält, oder Mittelwerte ohne gemeinsamen Gruppierungsbuchstaben weisen auf einen signifikanten Unterschied hin. Standardisierte Residuen jenseits von ±2 werden mit R markiert, Hebelwerte über 3p/n mit X. Das Modell setzt unabhängige, normalverteilte Fehler mit konstanter Varianz voraus: Prüfen Sie die Residuendiagramme.
Eingabefelder und Optionen
Feld | Beschreibung |
Response (Y) | Numerische Spalte der Zielgröße. Pflichtfeld. |
Factors (categorical) | Eine oder mehrere kategoriale Prädiktorspalten. Pflichtfeld. |
Covariates (continuous) | Optionale numerische Spalten, die nur als Haupteffekte aufgenommen werden (keine Wechselwirkungen mit Faktoren). |
Include all 2-way factor interactions | Standardmäßig aktiviert: fügt jede Wechselwirkung zweier Faktoren hinzu. |
Confidence level | Standard 95; wird für die Vergleiche verwendet. |
Comparison procedure | None (Standard), Tukey, Fisher, Bonferroni, Sidak oder Dunnett (gegen eine Kontrollstufe). |
Comparison factor | Der Faktor, dessen Kleinste-Quadrate-Mittelwerte verglichen werden; erforderlich, wenn ein Verfahren gewählt ist. |
Control group level (Dunnett) | Kontrollstufe für Dunnett; bleibt das Feld leer, wird die erste Stufe verwendet. |
Grouping information / Interval plot for differences of means | Standardmäßig aktiviert: Tabelle der Gruppierungsbuchstaben und Diagramm der Vergleichsintervalle. |
Sum of squares for tests | Adjusted (Typ III, Standard) oder Sequential (Typ I). |
Residual versus fit graph / Residual versus order graph / Histogram / Probability plot | Residuendiagramme; standardmäßig alle aktiviert. |
Data Options: Subset (optional) | Exclude matching rows (Standard) oder Include only matching rows, nach Zeilennummern (z. B. 3,7,12-15) und/oder einer Bedingung (z. B. Temperature_C > 185). |
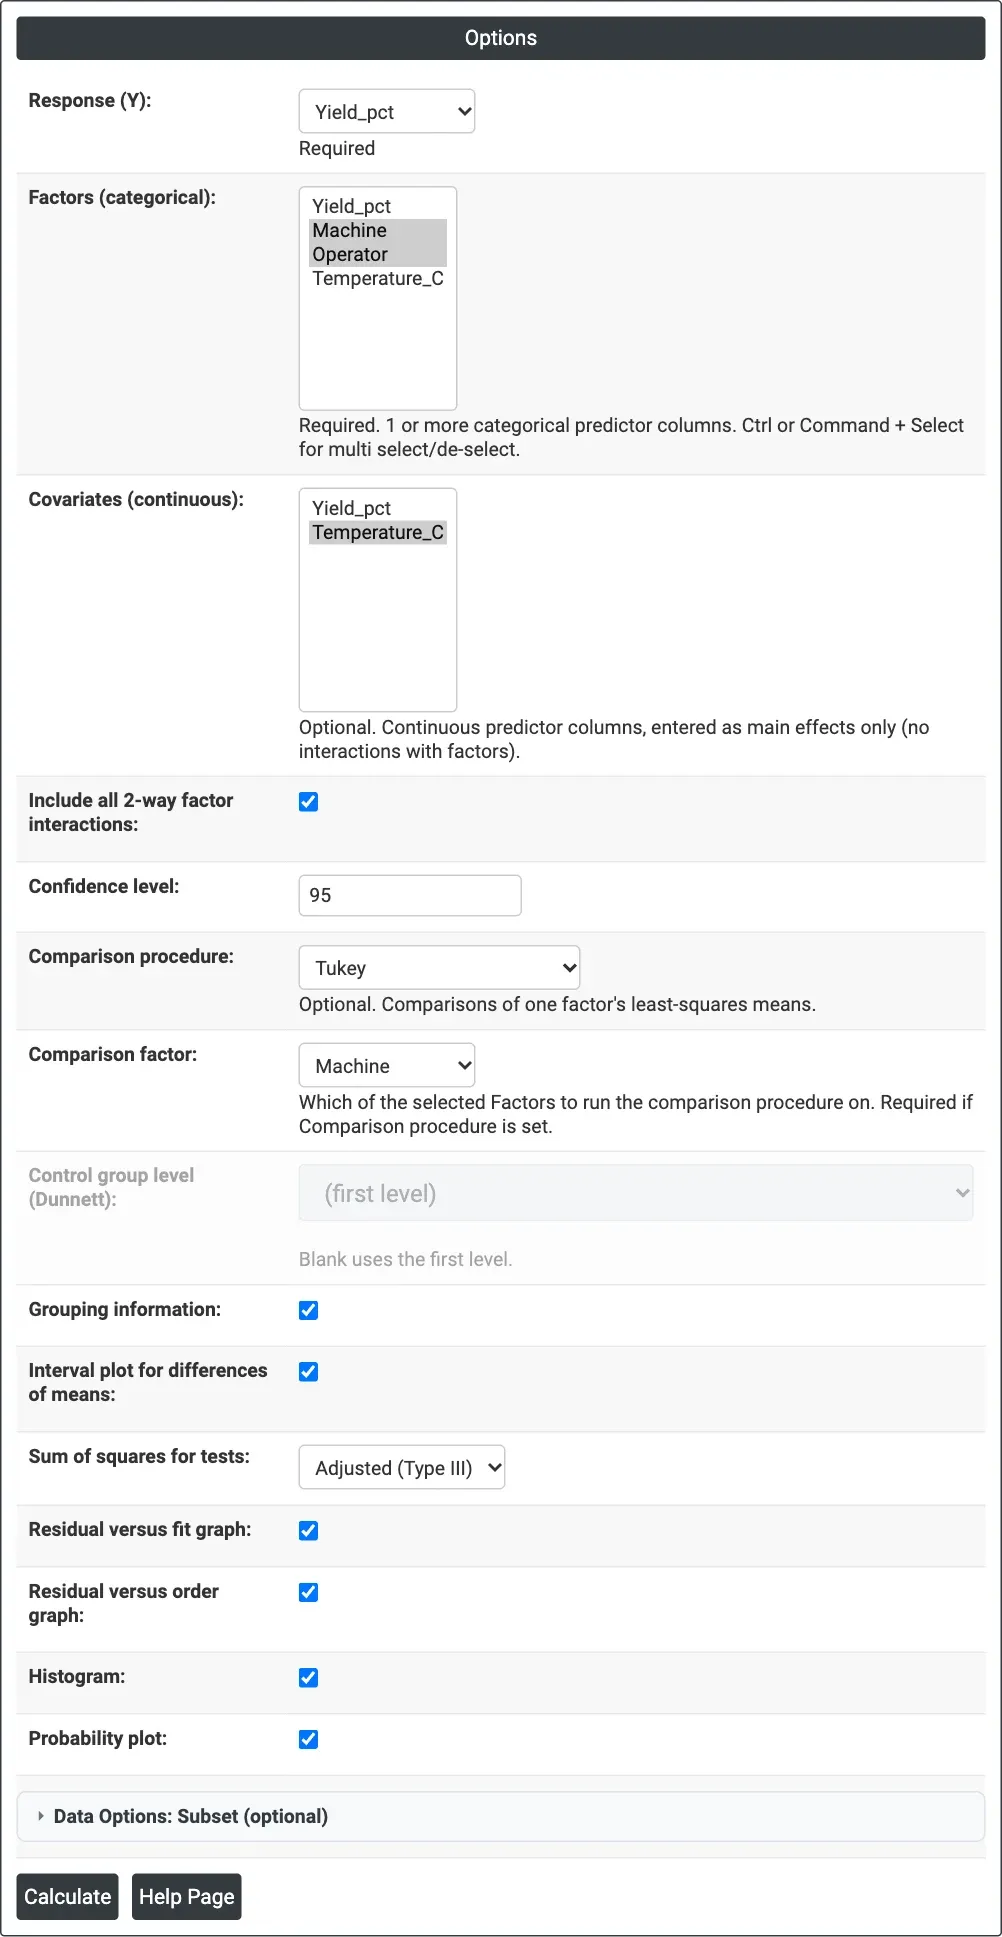
Abbildung 1 – Optionen für das Ausbeute-Beispiel: Yield_pct mit den Faktoren Machine und Operator, ihrer Wechselwirkung, der Kovariate Temperature_C und Tukey-Vergleichen der Maschinen.
Beschreibung der Ausgabe
- Method – Codierung der Faktoren und Art der Quadratsummen.
- Factor Information – Typ, Anzahl der Stufen und Stufenwerte jedes Faktors.
- Analysis of Variance – DF, Adj SS (oder Seq SS), Adj MS, F-Value und P-Value für jeden Term, den Fehler und die Gesamtsumme.
- Model Summary – S, R-sq, R-sq(adj) und R-sq(pred).
- Least-Squares Means – N und LS-Mittelwert jeder Stufe jedes Faktors.
- Coefficients – Coef, SE Coef, T-Value, P-Value und VIF.
- Fits and Diagnostics for Unusual Observations – wird nur angezeigt, wenn es solche gibt.
- Grouping Information, Simultaneous (oder Individual) Tests for Differences of Means und das Intervalldiagramm – wenn ein Vergleichsverfahren gewählt ist.
- Versus Fit, Versus Order, Residuals Histogram und Probability Plot.
- PDF-Export über Download.
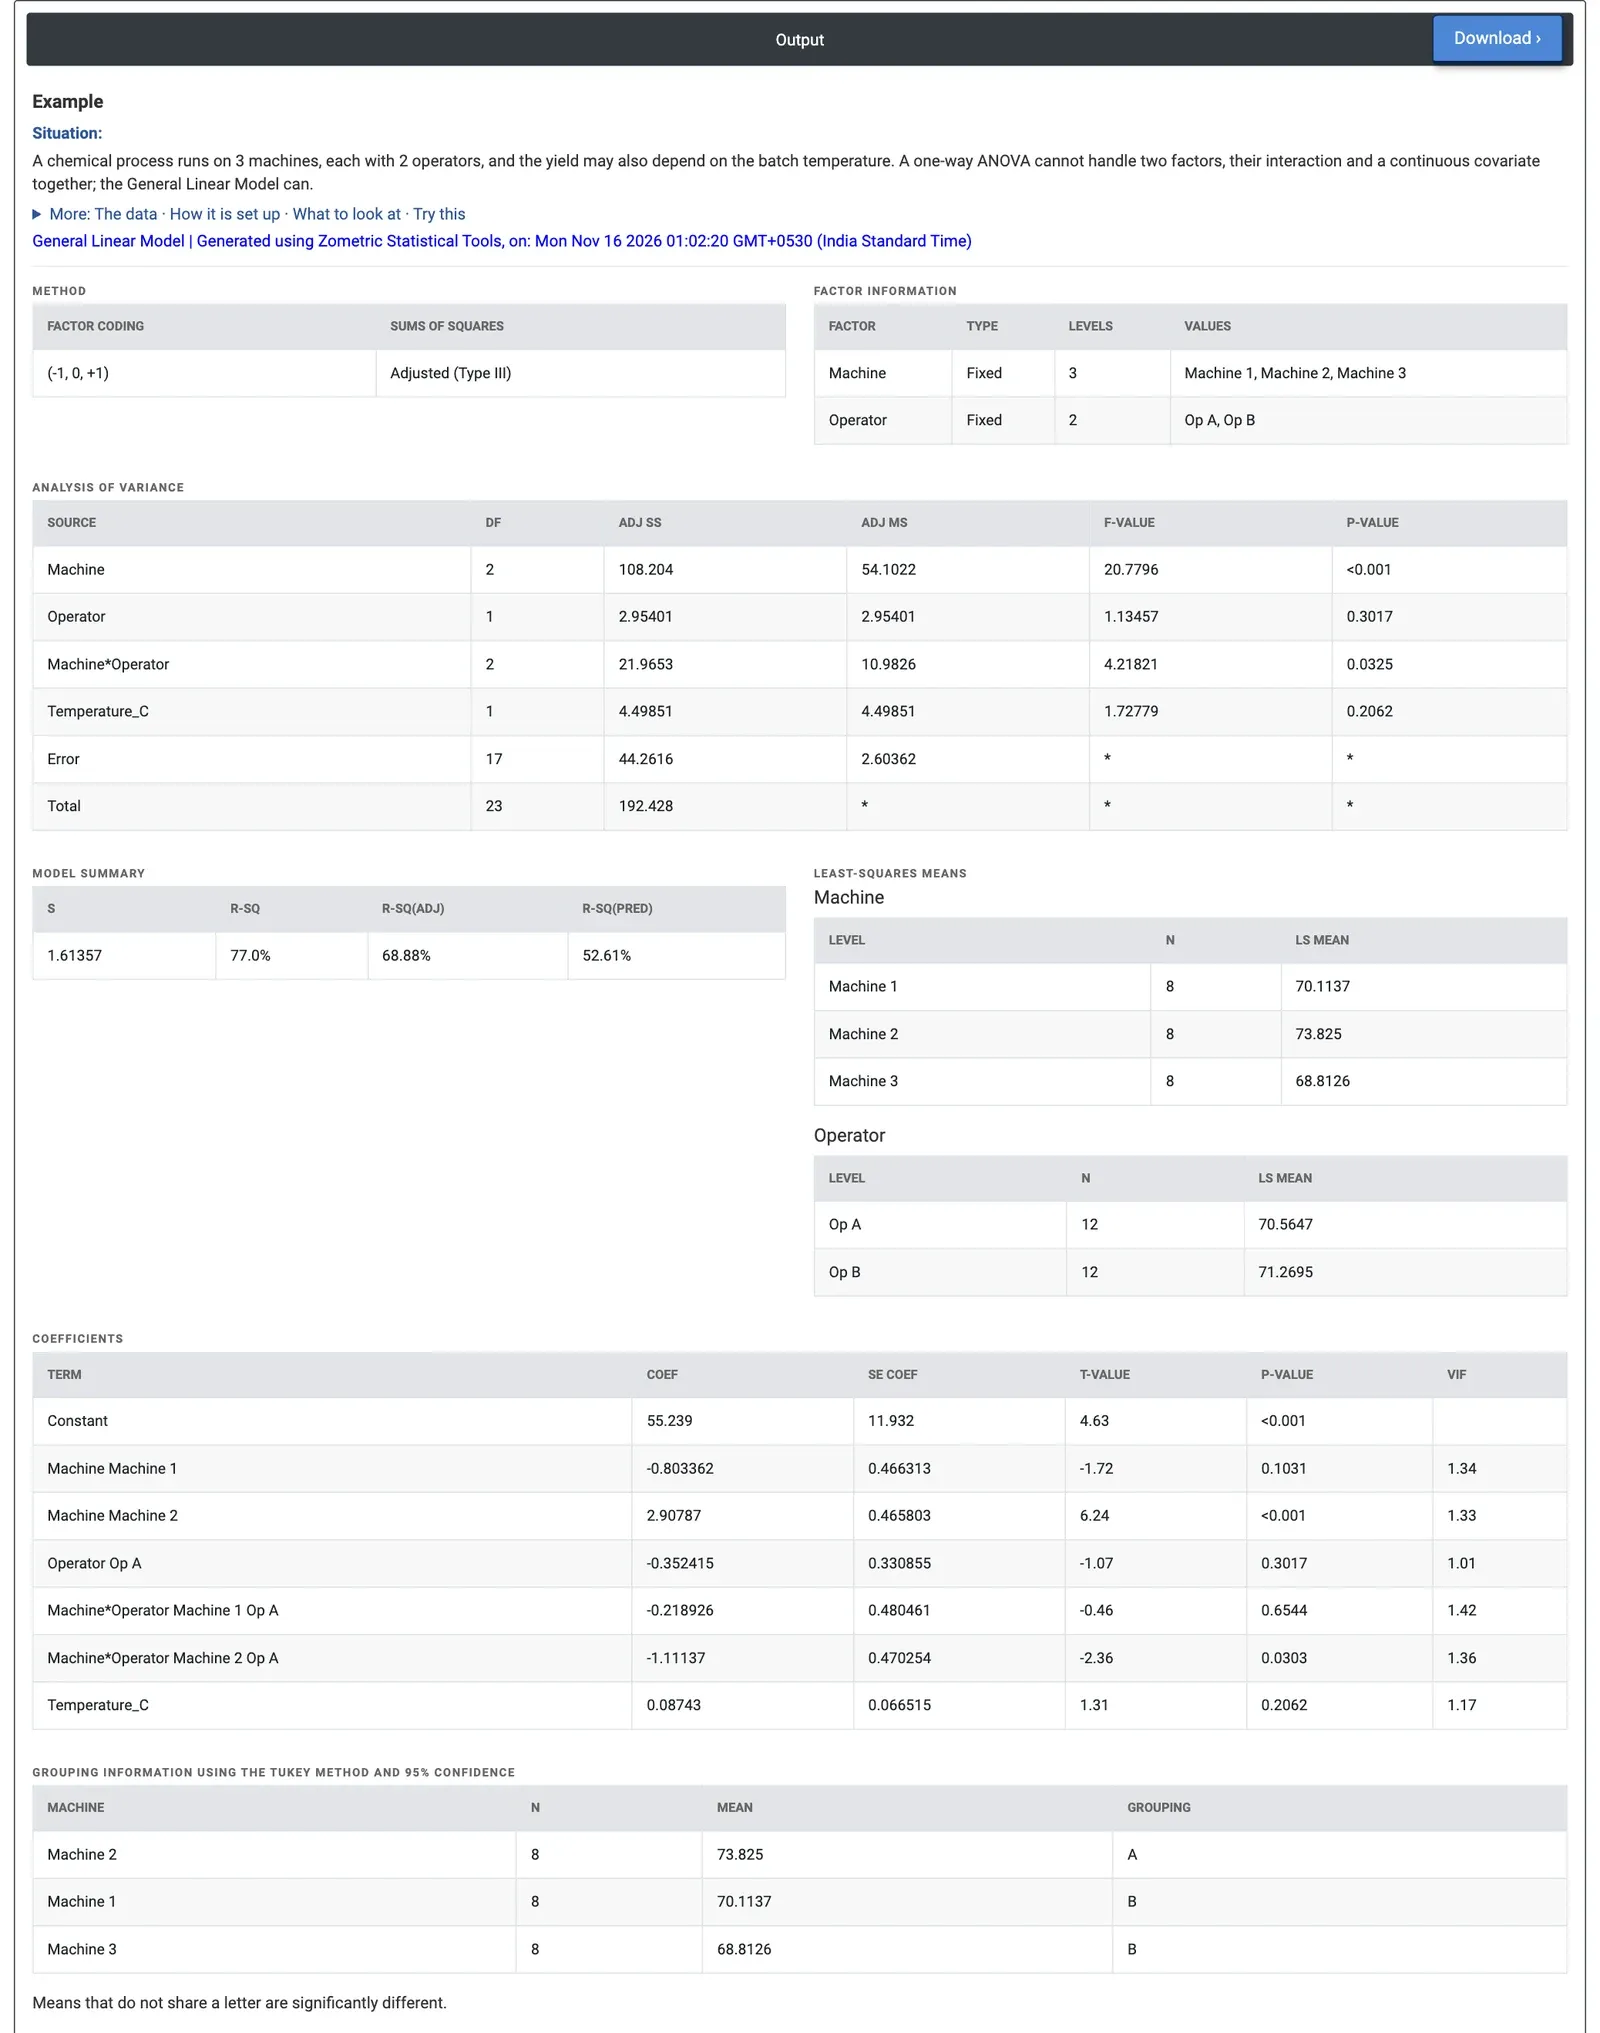
Abbildung 2 – GLM-Ergebnisse für die Ausbeute: Machine ist signifikant (p < 0.001), ebenso die Wechselwirkung Machine*Operator (p = 0.0325); Machine 2 hat den höchsten LS-Mittelwert, 73.83%.
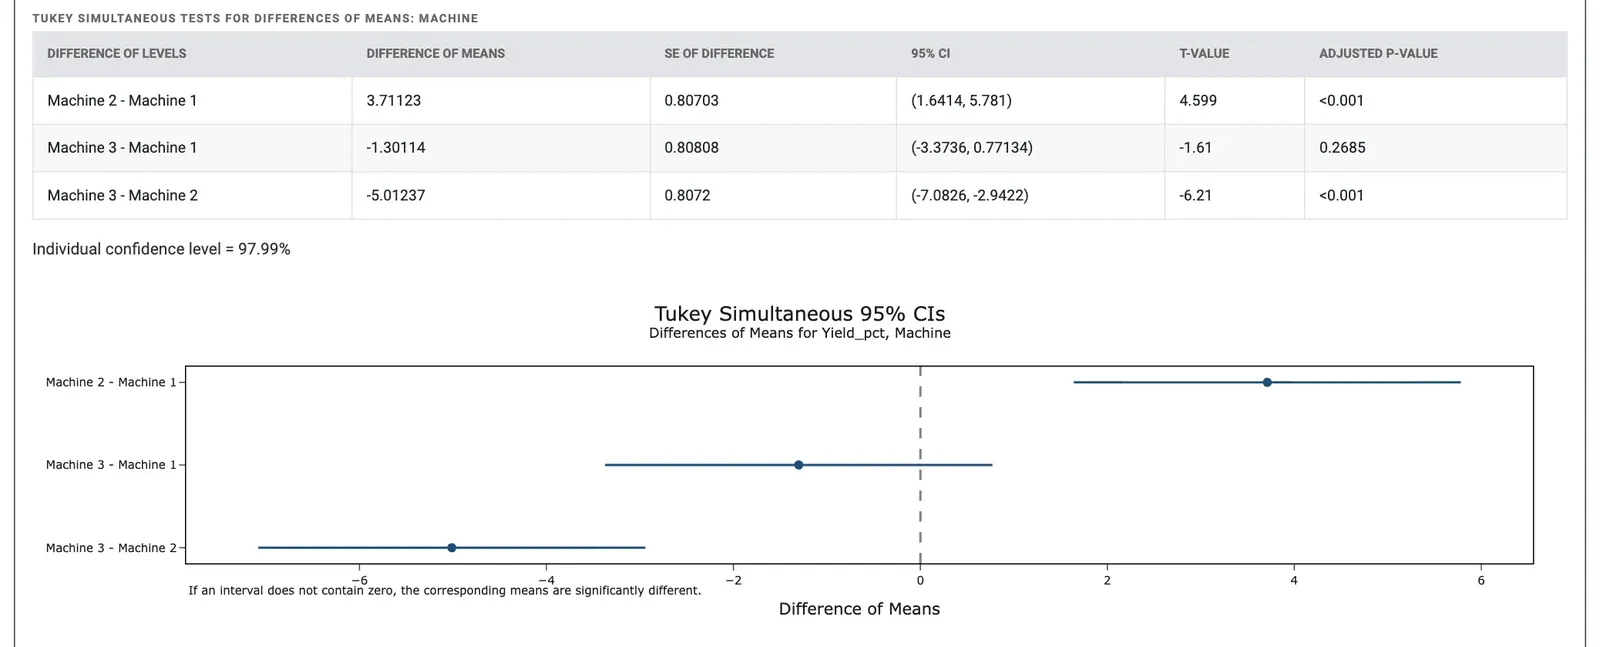
Abbildung 3 – Tukey-Vergleiche der Maschinen: Machine 2 unterscheidet sich von beiden anderen; das Intervall für Machine 3 − Machine 1 enthält null.
Beispiel
Ein chemischer Prozess läuft auf drei Maschinen mit je zwei Bedienern (Op A und Op B), und die Chargenausbeute kann zusätzlich von der Chargentemperatur (170 bis 190 °C) abhängen. Es gibt 24 Chargen, vier je Maschine und Bediener. Der Ingenieur wählt Yield_pct als Zielgröße, Machine und Operator als Faktoren mit ihrer Wechselwirkung, Temperature_C als Kovariate und fordert Tukey-Vergleiche der Maschinen an.
Die Maschinen unterscheiden sich deutlich (F = 20.78, p < 0.001). Auch die Wechselwirkung Machine*Operator ist signifikant (F = 4.22, p = 0.0325): Op B holt aus den Maschinen 1 und 2 mehr heraus, aus Maschine 3 aber weniger. Der Bediener für sich (p = 0.3017) und die Temperatur (p = 0.2062) haben im untersuchten Bereich keinen signifikanten Effekt. Das Modell erklärt 77.0% der Streuung (R-sq(adj) 68.88%), mit S = 1.61 Prozentpunkten; R-sq(pred) ist mit 52.61% niedriger, sodass Vorhersagen für neue Chargen weniger präzise sein werden, als die Anpassung vermuten lässt.
Die Kleinste-Quadrate-Mittelwerte betragen 73.83% für Maschine 2, 70.11% für Maschine 1 und 68.81% für Maschine 3. Tukey stellt Maschine 2 allein in Gruppe A: Sie liefert 3.71 Punkte mehr als Maschine 1 (95% KI 1.64 bis 5.78) und 5.01 mehr als Maschine 3, beide mit angepasstem p < 0.001, während sich die Maschinen 1 und 3 nicht unterscheiden (angepasstes p = 0.2685). Der Ingenieur untersucht, was an Maschine 2 anders ist, und prüft wegen der Wechselwirkung die Bedienerzuordnung an Maschine 3, bevor er das Verfahren standardisiert.
Häufig gestellte Fragen
Wann sollten Sie ein allgemeines lineares Modell statt einer einfachen ANOVA verwenden?
Verwenden Sie ein allgemeines lineares Modell, wenn eine einfache ANOVA nicht ausreicht, zum Beispiel wenn die Ausbeute von der Maschine, dem Bediener, deren Zusammenwirken und einer gemessenen Bedingung wie der Temperatur abhängen kann, oder wenn die Daten unbalanciert sind. Es verarbeitet mehrere kategoriale Faktoren, Zweifach-Wechselwirkungen und stetige Kovariaten in einem Modell und deckt auch die klassische zweifaktorielle ANOVA ab.
Was sind Kleinste-Quadrate-Mittelwerte in einem GLM?
Ein Kleinste-Quadrate-Mittelwert ist die Vorhersage des Modells für eine Faktorstufe, wobei über die Stufen der anderen Faktoren gemittelt wird und die Kovariaten auf ihrem Mittelwert gehalten werden. Anders als Rohmittelwerte ist er nicht durch ungleiche Gruppengrößen oder Unterschiede in den Kovariaten verzerrt. Mehrfachvergleiche im GLM vergleichen diese Kleinste-Quadrate-Mittelwerte zwischen den Stufen eines Faktors.
Welches Verfahren für Mehrfachvergleiche sollten Sie in einem GLM verwenden?
Tukey vergleicht alle Paare anhand der Verteilung der studentisierten Spannweite; Fisher verwendet einzelne t-Tests; Bonferroni und Sidak passen den kritischen t-Wert an die Anzahl der Paare an; Dunnett vergleicht jede Stufe mit einer Kontrolle. Ein Intervall, das null nicht enthält, oder Mittelwerte ohne gemeinsamen Gruppierungsbuchstaben weisen auf einen signifikanten Unterschied hin.
Welche Voraussetzungen hat ein allgemeines lineares Modell?
Das Modell setzt unabhängige, normalverteilte Fehler mit konstanter Varianz voraus, was Sie mit den Residuendiagrammen prüfen: Residuen gegen angepasste Werte, gegen Reihenfolge, Histogramm und Wahrscheinlichkeitsnetz. Standardisierte Residuen jenseits von plus oder minus 2 werden mit R markiert, und Beobachtungen mit einem Hebelwert über 3p/n werden als ungewöhnlich mit X markiert.