
Binomialverteilte Zufallsdaten erzeugen (Generate Random Binomial Data)
Generate Random Binomial Data simuliert attributive Daten: Jeder Wert ist die Anzahl der Erfolge in einer festen Zahl unabhängiger Versuche mit jeweils vorgegebener Erfolgswahrscheinlichkeit. Sie legen die Anzahl der Zeilen und Spalten, die Anzahl der Versuche (typischerweise der Prüflosumfang) und die Ereigniswahrscheinlichkeit zwischen 0 und 1 fest. Nutzen Sie es zum Testen von P- und NP-Karten. Es wird kein fester Startwert (Seed) verwendet.
Zuletzt geprüft
Kernaussage
Generate Random Binomial Data erzeugt Anzahlen von Erfolgen in einer festen Zahl unabhängiger Versuche mit je zwei Ausgängen bei vorgegebener Ereigniswahrscheinlichkeit, um attributive Daten wie gut/schlecht zu simulieren.
Auf dieser Seite
- Was ist Generate Random Binomial Data?
- Wann wird Generate Random Binomial Data eingesetzt?
- Hinweise zur richtigen Anwendung von Generate Random Binomial Data
- Alternativen: Wann Sie Generate Random Binomial Data nicht verwenden sollten
- Beispiel für Generate Random Binomial Data
- Anleitung: Generate Random Binomial Data
Was ist Generate Random Binomial Data?
Random Binomial Data erzeugt Werte auf Grundlage der Binomialverteilung, die die Anzahl der Erfolge in einer festen Zahl unabhängiger Versuche beschreibt, bei denen jeder Versuch genau zwei Ausgänge hat (Erfolg oder Misserfolg). Sie geben die Anzahl der Versuche (n) und die Erfolgswahrscheinlichkeit je Versuch (p) an.
Einfache Definition: Erzeugt zufällige Anzahlen von Erfolgen aus einer festen Zahl von Versuchen; ideal zur Simulation attributiver Daten wie gut/schlecht, fehlerhaft/fehlerfrei oder ja/nein.
Wann wird Generate Random Binomial Data eingesetzt?
- Verwenden Sie es zur Simulation attributiver Daten : Anzahl fehlerhafter Einheiten in einer Charge, Anzahl der Kundenkäufe oder Anzahl fehlgeschlagener Prüfungen.
- Verwenden Sie es zum Testen von P-Karten, NP-Karten oder binärer logistischer Regression mit bekannten Eingangsparametern.
- Verwenden Sie es in Risiko- und Zuverlässigkeitssimulationen , bei denen die Ergebnisse binär sind.
Hinweise zur richtigen Anwendung von Generate Random Binomial Data
- Setzen Sie n (Anzahl der Versuche) entsprechend Ihrem Prüflosumfang.
- Setzen Sie p (Wahrscheinlichkeit) auf einen Wert zwischen 0 und 1 ; z. B. bedeutet 0.05 eine Fehlerrate von 5 % je Versuch.
- Es wird kein fester Startwert (Seed) verwendet, daher liefert jedes Calculate neue Werte; kopieren Sie die erzeugten Daten, wenn Sie denselben Datensatz wiederverwenden möchten.
Alternativen: Wann Sie Generate Random Binomial Data nicht verwenden sollten
- Für Fehleranzahlen je Flächen- oder Zeiteinheitverwenden Sie Poisson-verteilte Zufallsdaten
- Für stetige Messwerteverwenden Sie normal- oder lognormalverteilte Zufallsdaten
Beispiel für Generate Random Binomial Data
Die folgenden Schritte zum Erzeugen binomialverteilter Zufallsdaten:
- Um binomialverteilte Zufallsdaten zu erzeugen, müssen Sie die erforderlichen Optionen ausfüllen.
- Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
- Um Generate Random Binomial Data zu finden, wählen Sie Statistical module> Random Data > Generate Random Binomial Data
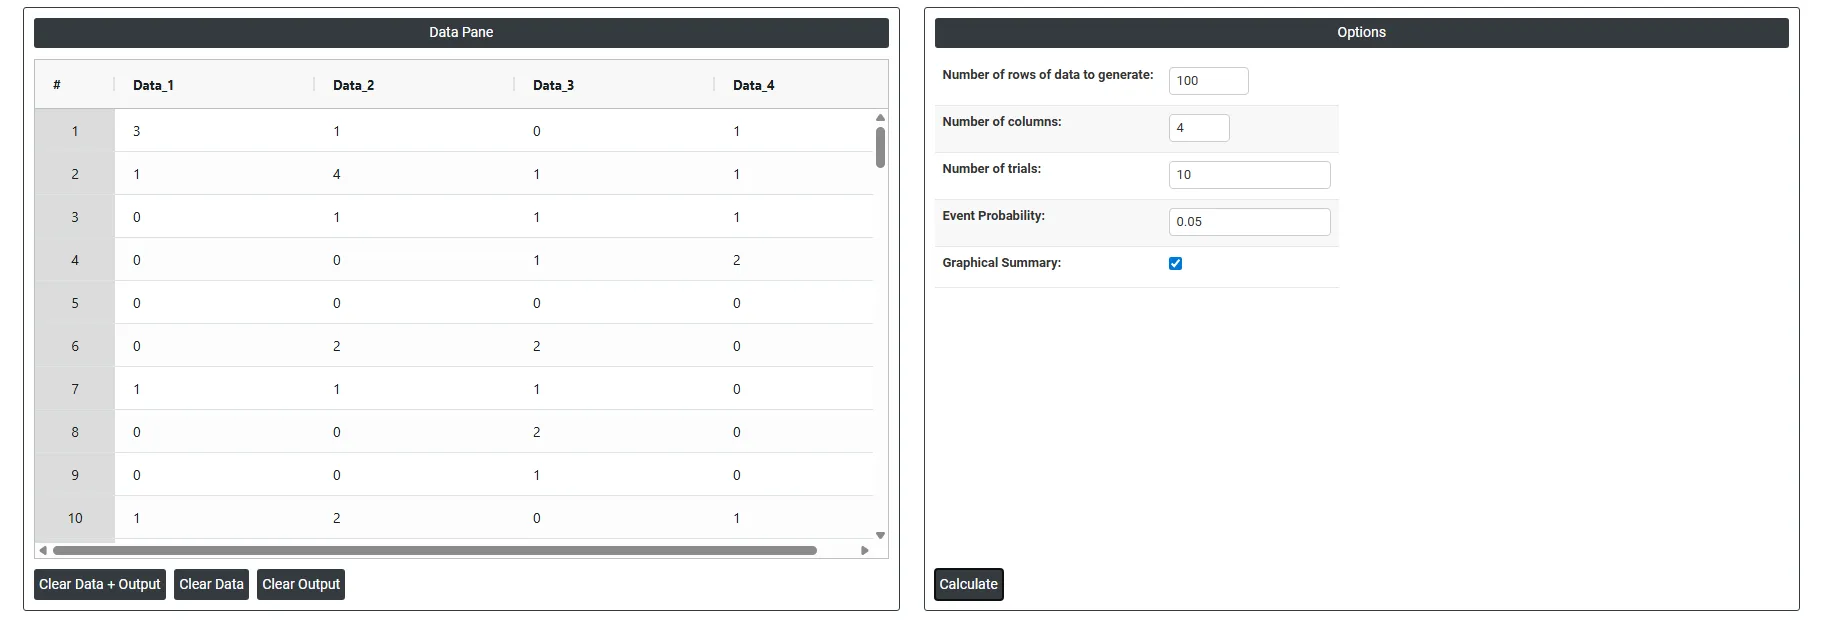
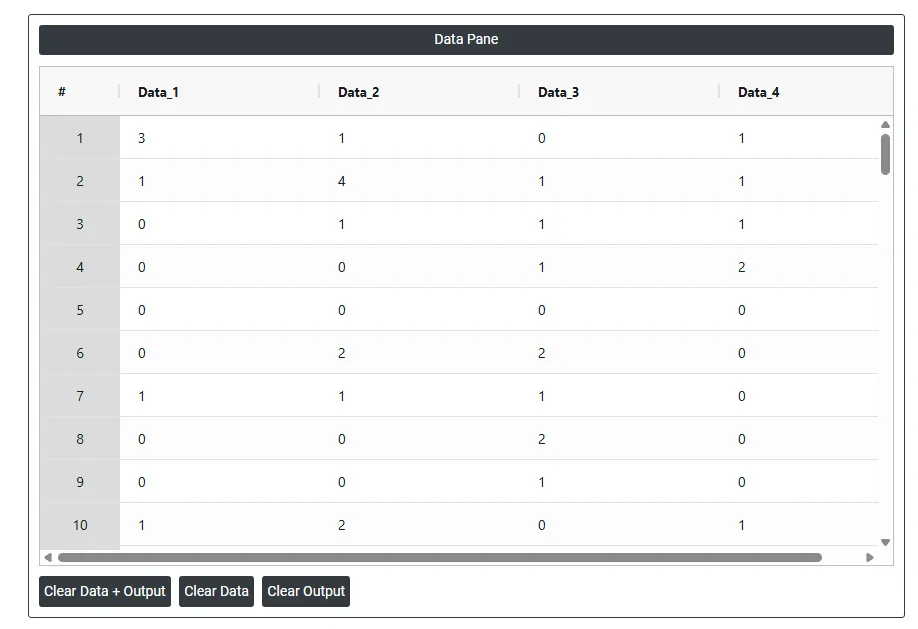
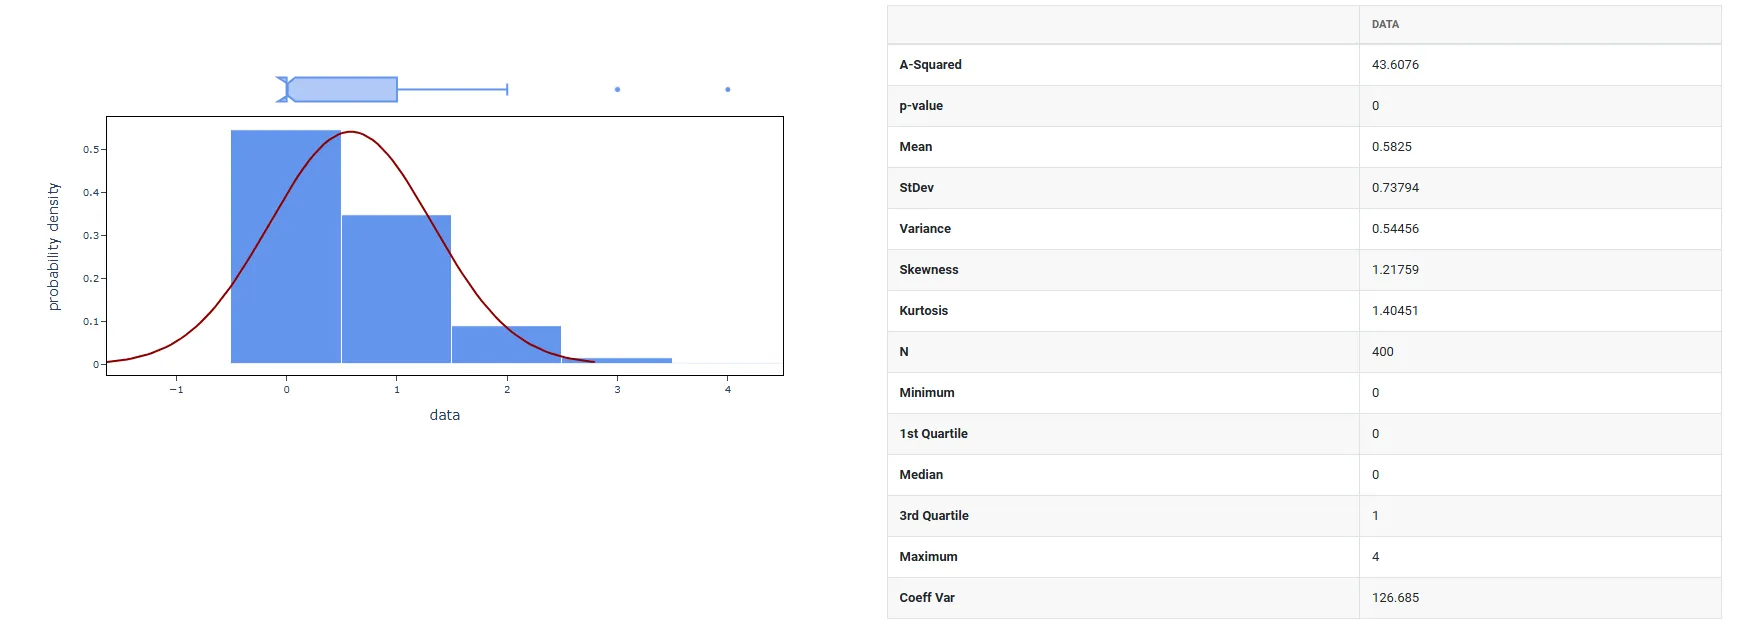
4. Nach Anwendung des oben genannten Werkzeugs erhalten Sie folgende Ausgabe:
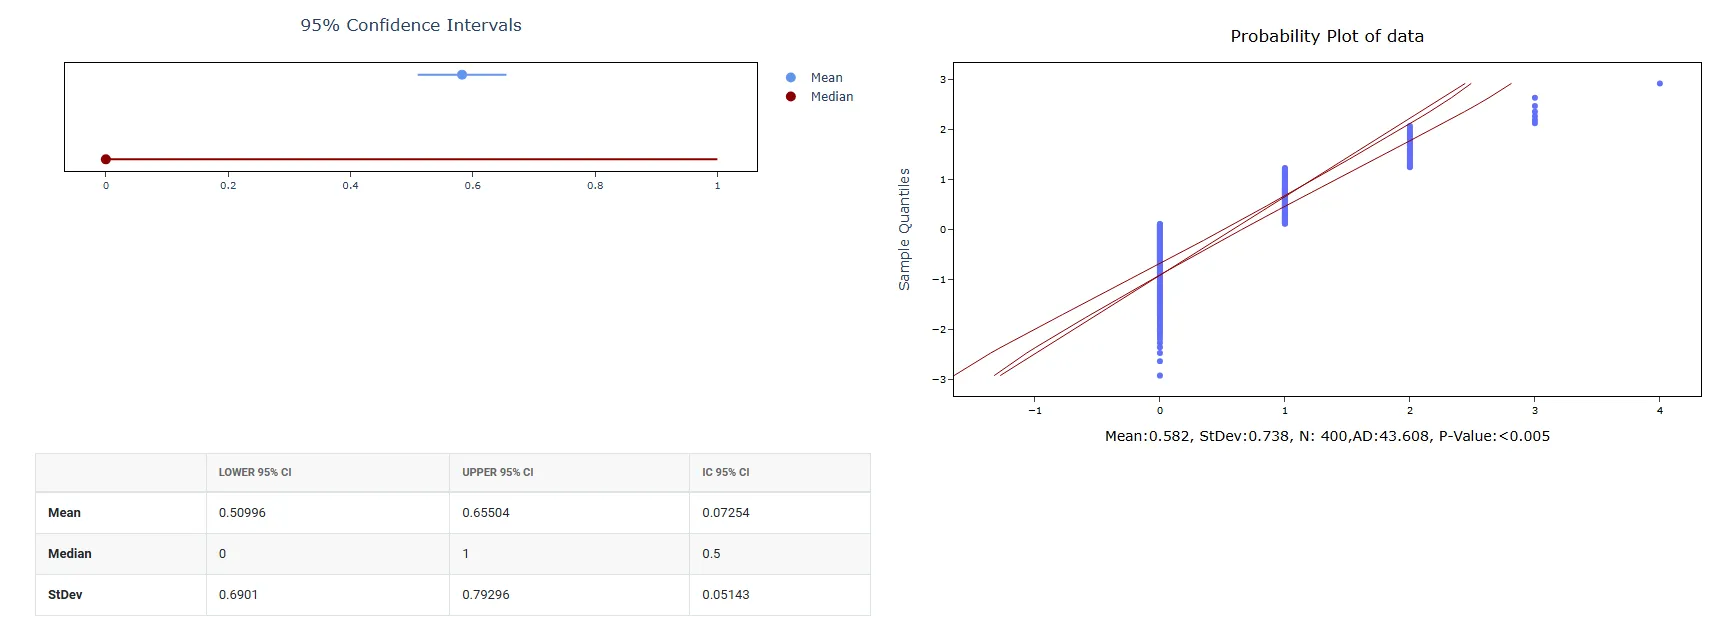
Anleitung: Generate Random Binomial Data
Gehen Sie wie folgt vor:
- Melden Sie sich bei Zometric Statistical Software an: https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Random Data>Generate Random Binomial Data.
- Füllen Sie anschließend die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Auf dem Dashboard von Generate Random Binomial Data ist das Fenster in zwei Bereiche geteilt.
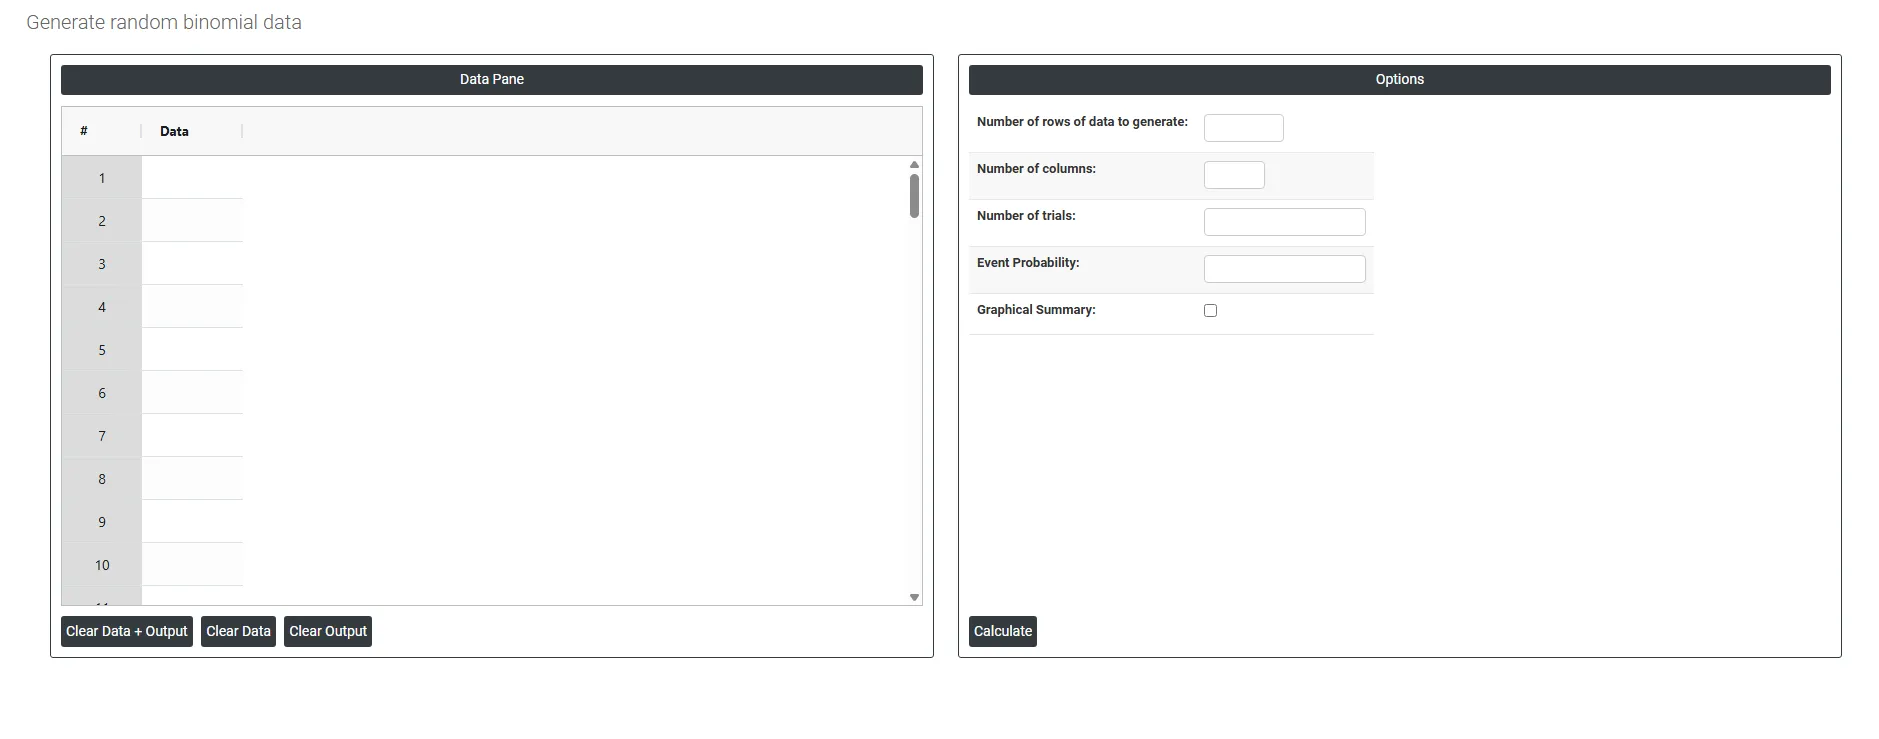
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane enthält jede Zeile erzeugte Zufallsdaten. Die Daten werden erzeugt, nachdem die erforderlichen Optionen ausgefüllt sind.
Im rechten Bereich stehen folgende Optionen zur Verfügung:
- Number of rows of data to generate: Gibt an, wie viele zufällige Datenpunkte erzeugt werden. Bei Eingabe von 10 werden beispielsweise genau 10 Zeilen mit Zufallswerten erzeugt, die alle im Data Pane sichtbar sind.
- Number of columns: Gibt an, wie viele Variablen (Spalten) jede Zeile hat. Bei Eingabe von 3 werden beispielsweise 3 Spalten mit zufällig erzeugten Daten nebeneinander im Data Pane erzeugt.
- Number of trials: Gibt an, wie oft ein Ereignis in jedem Experiment versucht wird. Bei Eingabe von 10 steht beispielsweise jede Zeile der erzeugten Daten für 10 unabhängige Versuche (wie 10-maliges Werfen einer Münze). Der Wert in jeder Zeile ist die Anzahl der Versuche, die zu einem Erfolg geführt haben.
- Event probability: Die Wahrscheinlichkeit, dass ein einzelner Versuch zu einem Erfolg führt, eingegeben als Wert zwischen 0 und 1. So steht 0.5 beispielsweise für eine Erfolgswahrscheinlichkeit von 50 % je Versuch, wie bei einem fairen Münzwurf. Die Zufallsdaten werden auf Grundlage dieser Wahrscheinlichkeit erzeugt: Ein höherer Wert ergibt mehr Erfolge je Zeile, ein niedrigerer weniger.
- Graphical summary: Ist diese Option ausgewählt, werden alle erzeugten Werte zusammengefasst ausgewertet: ein Histogramm mit angepasster Normalverteilungskurve und Boxplot, zusammenfassende Kennzahlen, ein Anderson-Darling-Test auf Normalverteilung, ein Wahrscheinlichkeitsnetz sowie 95-%-Konfidenzintervalle für Mittelwert, Median und Standardabweichung. Es handelt sich um ein grafisches Ergebnis auf Basis der soeben erzeugten Daten.
Häufig gestellte Fragen
Was macht Generate Random Binomial Data?
Es erzeugt Werte aus der Binomialverteilung, die die Anzahl der Erfolge in einer festen Zahl unabhängiger Versuche beschreibt, bei denen jeder Versuch genau zwei Ausgänge hat: Erfolg oder Misserfolg. Sie geben die Anzahl der Versuche (n) und die Erfolgswahrscheinlichkeit je Versuch (p) an, und jeder erzeugte Wert ist die Anzahl der Erfolge.
Wann sollte man binomialverteilte Zufallsdaten erzeugen?
Verwenden Sie sie zur Simulation attributiver Daten, etwa der Anzahl fehlerhafter Einheiten in einer Charge, der Anzahl der Kundenkäufe oder der Anzahl fehlgeschlagener Prüfungen. Sie eignen sich auch zum Testen von P-Karten, NP-Karten oder binärer logistischer Regression mit bekannten Eingangsparametern sowie für Risiko- und Zuverlässigkeitssimulationen mit binären Ergebnissen.
Wie wählt man die Anzahl der Versuche und die Ereigniswahrscheinlichkeit?
Setzen Sie die Anzahl der Versuche entsprechend Ihrem Prüflosumfang. Setzen Sie die Ereigniswahrscheinlichkeit auf einen Wert zwischen 0 und 1; beispielsweise bedeutet 0.05 eine Fehlerrate von 5 % je Versuch. Eine höhere Wahrscheinlichkeit ergibt mehr Erfolge je Zeile, eine niedrigere weniger. Es wird kein fester Startwert (Seed) verwendet; kopieren Sie daher die erzeugten Daten, wenn Sie denselben Datensatz wiederverwenden möchten.
Wann sollte man statt binomialverteilter Daten Poisson- oder normalverteilte Zufallsdaten verwenden?
Verwenden Sie binomialverteilte Daten für Ergebnisse wie gut/schlecht, fehlerhaft/fehlerfrei oder ja/nein aus einer festen Zahl von Versuchen. Für Fehleranzahlen je Flächen- oder Zeiteinheit verwenden Sie stattdessen Poisson-verteilte Zufallsdaten. Für stetige Messwerte verwenden Sie normal- oder lognormalverteilte Zufallsdaten.