
Verteilungsidentifikation für Einzelwerte (Individual Distribution Identification)
Die Verteilungsidentifikation für Einzelwerte passt mehrere Wahrscheinlichkeitsverteilungen gleichzeitig an Ihre Daten an und bewertet, welche Verteilung statistisch am besten passt. Statt eine Normalverteilung vorauszusetzen, prüft dieses Werkzeug eine breite Palette von Verteilungen, darunter Weibull-, Lognormal-, Exponential-, logistische und Gammaverteilung, und ordnet sie danach, wie gut sie Form und Verhalten Ihrer Daten beschreiben.
Zuletzt geprüft
Kernaussage
Die Verteilungsidentifikation für Einzelwerte passt mehrere Wahrscheinlichkeitsverteilungen gleichzeitig an Ihre Daten an und bewertet, welche Verteilung statistisch am besten passt.
Auf dieser Seite
- Was ist die Verteilungsidentifikation für Einzelwerte?
- Wann wird die Verteilungsidentifikation für Einzelwerte eingesetzt?
- Hinweise zur richtigen Anwendung der Verteilungsidentifikation für Einzelwerte
- Alternativen: Wann Sie die Verteilungsidentifikation für Einzelwerte nicht verwenden sollten
- Beispiel für die Verteilungsidentifikation für Einzelwerte
- Anleitung: Verteilungsidentifikation für Einzelwerte durchführen
Was ist die Verteilungsidentifikation für Einzelwerte?
Die Verteilungsidentifikation für Einzelwerte (Individual Distribution Identification) passt mehrere Wahrscheinlichkeitsverteilungen gleichzeitig an Ihre Daten an und bewertet, welche Verteilung statistisch am besten passt. Statt eine Normalverteilung vorauszusetzen, prüft dieses Werkzeug eine breite Palette von Verteilungen, darunter Weibull-, Lognormal-, Exponential-, logistische und Gammaverteilung, und ordnet sie danach, wie gut sie Form und Verhalten Ihrer Daten beschreiben.
Das ist für die Fähigkeitsanalyse nicht normalverteilter Daten unverzichtbar, denn mit der falschen Verteilung erhalten Sie ungenaue Schätzungen für Pp, Ppk bzw. Cp, Cpk und irreführende Vorhersagen der Fehlerrate.
Einfache Definition: Ein Werkzeug, das Ihre Daten gegen viele verschiedene statistische Verteilungen prüft und Ihnen sagt, welche am besten passt, damit Sie auch bei nicht normalverteilten Daten eine genaue Fähigkeitsanalyse durchführen können.
Wann wird die Verteilungsidentifikation für Einzelwerte eingesetzt?
- Verwenden Sie sie, wenn Ihre Daten einen Test auf Normalverteilung nicht bestehen und Sie vor der Fähigkeitsanalyse die richtige Verteilung ermitteln müssen.
- Verwenden Sie sie bei Prozessdaten, die von Natur aus schief verteilt sind , etwa Zykluszeiten, Ausfallzeiten, chemische Konzentrationen oder Partikelgrößen.
- Verwenden Sie sie vor einer Fähigkeitsanalyse für nicht normalverteilte Daten , um sicherzustellen, dass die gewählte Verteilung das Prozessverhalten zutreffend abbildet.
- Verwenden Sie sie, wenn eine Box-Cox-Transformation nicht geeignet ist , zum Beispiel wenn die Daten Nullen oder negative Werte enthalten.
Hinweise zur richtigen Anwendung der Verteilungsidentifikation für Einzelwerte
- Erheben Sie mindestens 50 bis 100 Datenpunkte , damit die Verteilungsanpassung zuverlässig ist. Kleine Stichproben enthalten nicht genug Information, um zwischen Verteilungen zu unterscheiden.
- Verwenden Sie bei der Auswahl der besten Verteilung Anpassungsgüte-Statistiken (Anderson-Darling) und Wahrscheinlichkeitsnetze gemeinsam; verlassen Sie sich nicht allein auf den p-Wert.
- Wählen Sie eine Verteilung, die physikalisch zum Prozess passt . Eine Verteilung mit der niedrigsten AD-Statistik, aber ohne physikalische Grundlage, ist möglicherweise nicht die beste Wahl.
- Stellen Sie sicher, dass die Daten aus einem stabilen, beherrschten Prozess stammen , bevor Sie Verteilungen anpassen. Eine Verteilungsanpassung an Daten eines instabilen Prozesses liefert bedeutungslose Ergebnisse.
- Ziehen Sie als Alternative eine Johnson- oder Box-Cox-Transformation in Betracht, wenn keine Standardverteilung gut passt.
Alternativen: Wann Sie die Verteilungsidentifikation für Einzelwerte nicht verwenden sollten
- Ist bereits bestätigt, dass die Daten normalverteilt sind, fahren Sie direkt mit der üblichen Prozessfähigkeitsanalyse bei Normalverteilung fort; eine Verteilungsidentifikation ist dann unnötig.
- Wenn Sie nur die Normalverteilung prüfen müssen, ohne andere Verteilungen zu untersuchen, verwenden Sie einen einfachen Test auf Normalverteilung
- Haben die Daten klare physikalische Grenzen oder einen bekannten Verteilungstyp, geben Sie diese Verteilung in der Fähigkeitsanalyse direkt an, statt alle Möglichkeiten zu prüfen.
Beispiel für die Verteilungsidentifikation für Einzelwerte
Ein Ingenieur entnimmt eine Zufallsstichprobe von Kapseln und erfasst deren Calciumgehalt. Um die am besten passende Datenverteilung zu bestimmen, führt er eine Verteilungsidentifikation für Einzelwerte durch. Der Test in folgenden Schritten:
- Die erforderlichen Daten wurden erhoben.
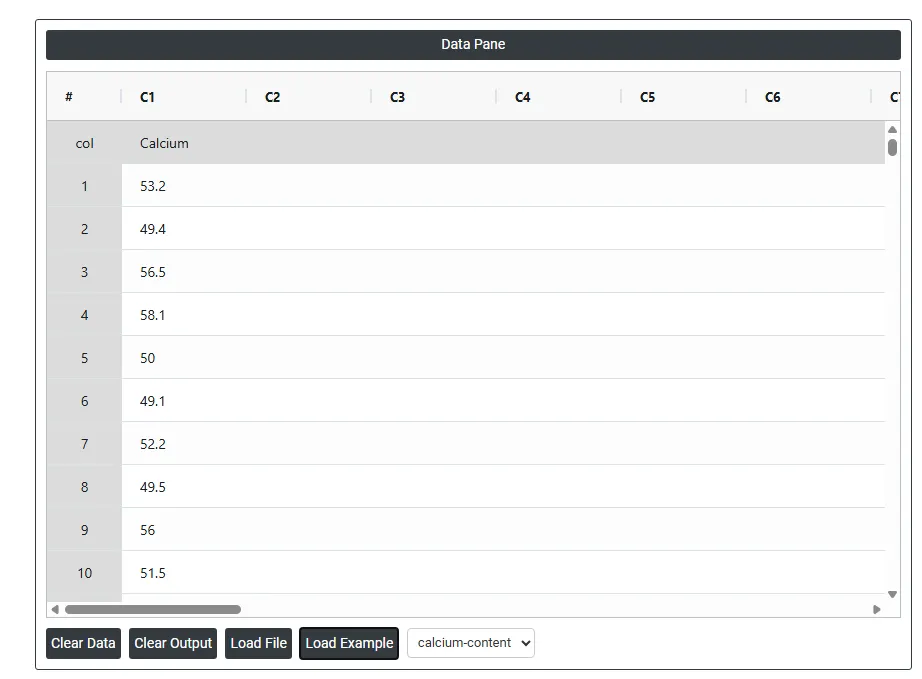
- Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
- Die Verteilungsidentifikation für Einzelwerte finden Sie unter Statistical module> Hypothesis Test> Individual Distribution Identification.
- Geben Sie im Werkzeug die Daten zusammen mit den weiteren Eingaben wie folgt ein:
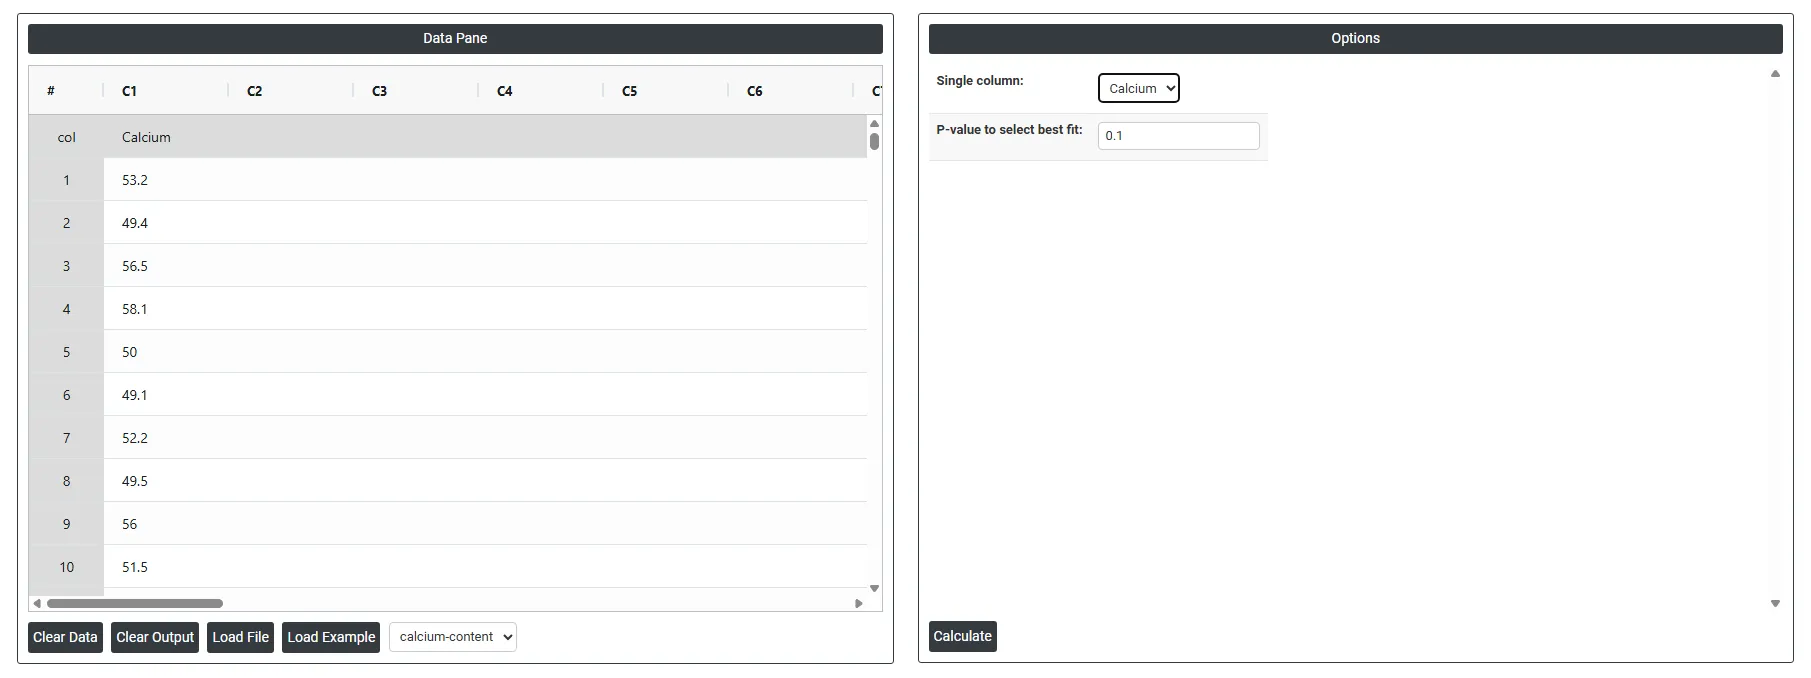
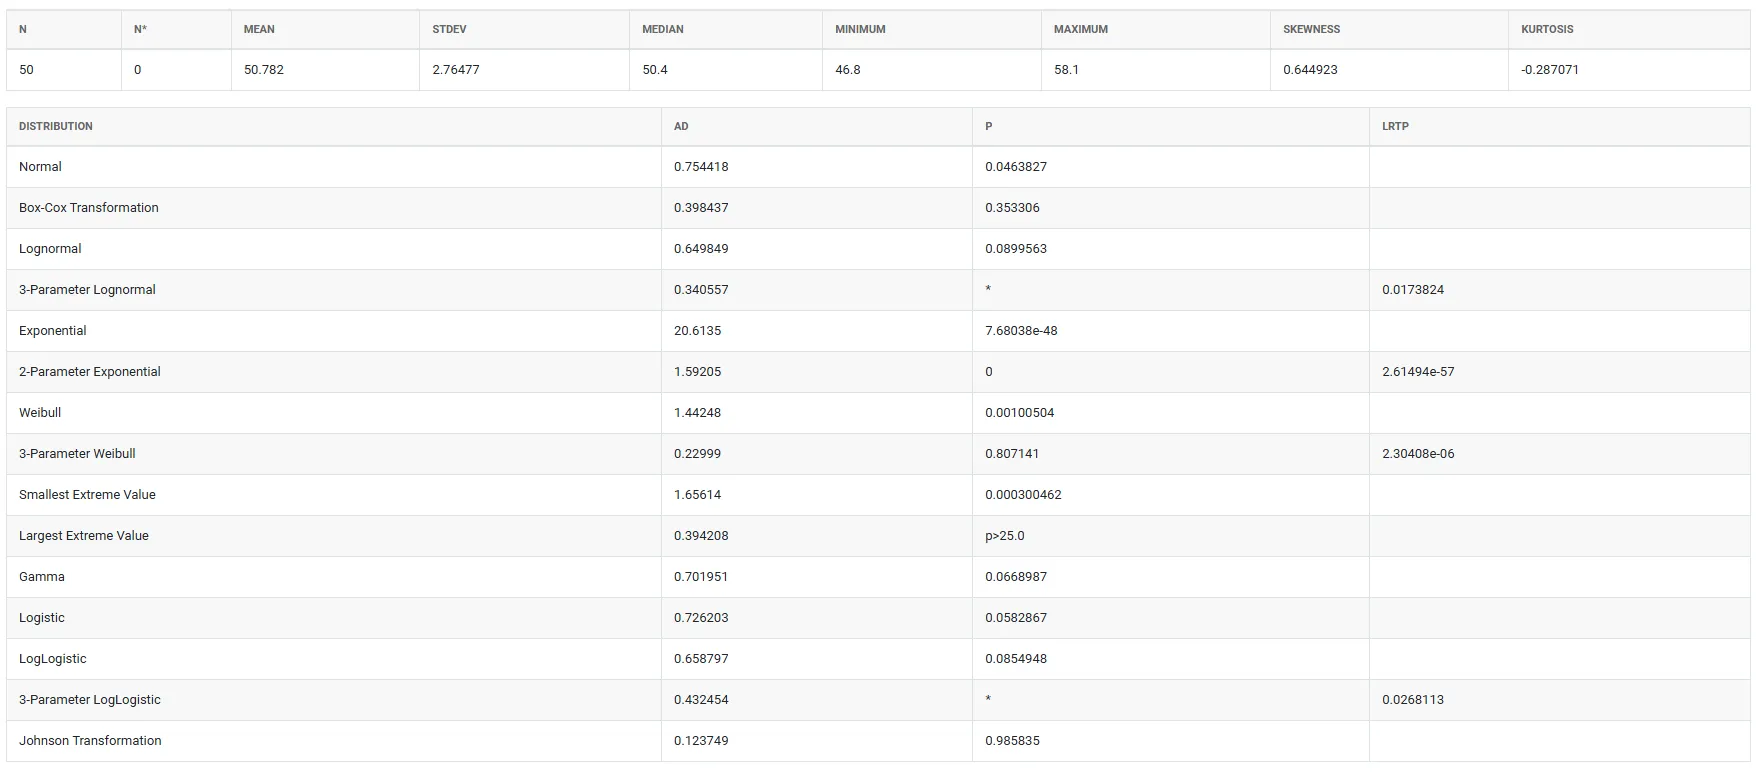
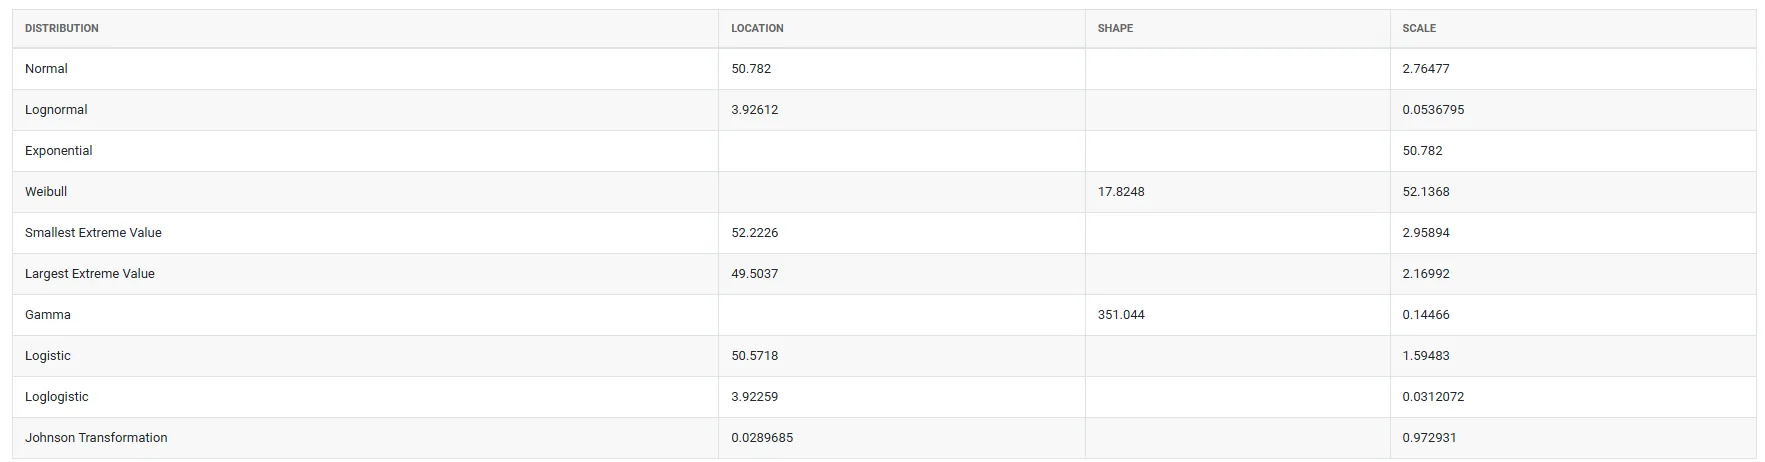
5. Nach Ausführung des oben genannten Werkzeugs erhalten Sie folgende Ausgabe:
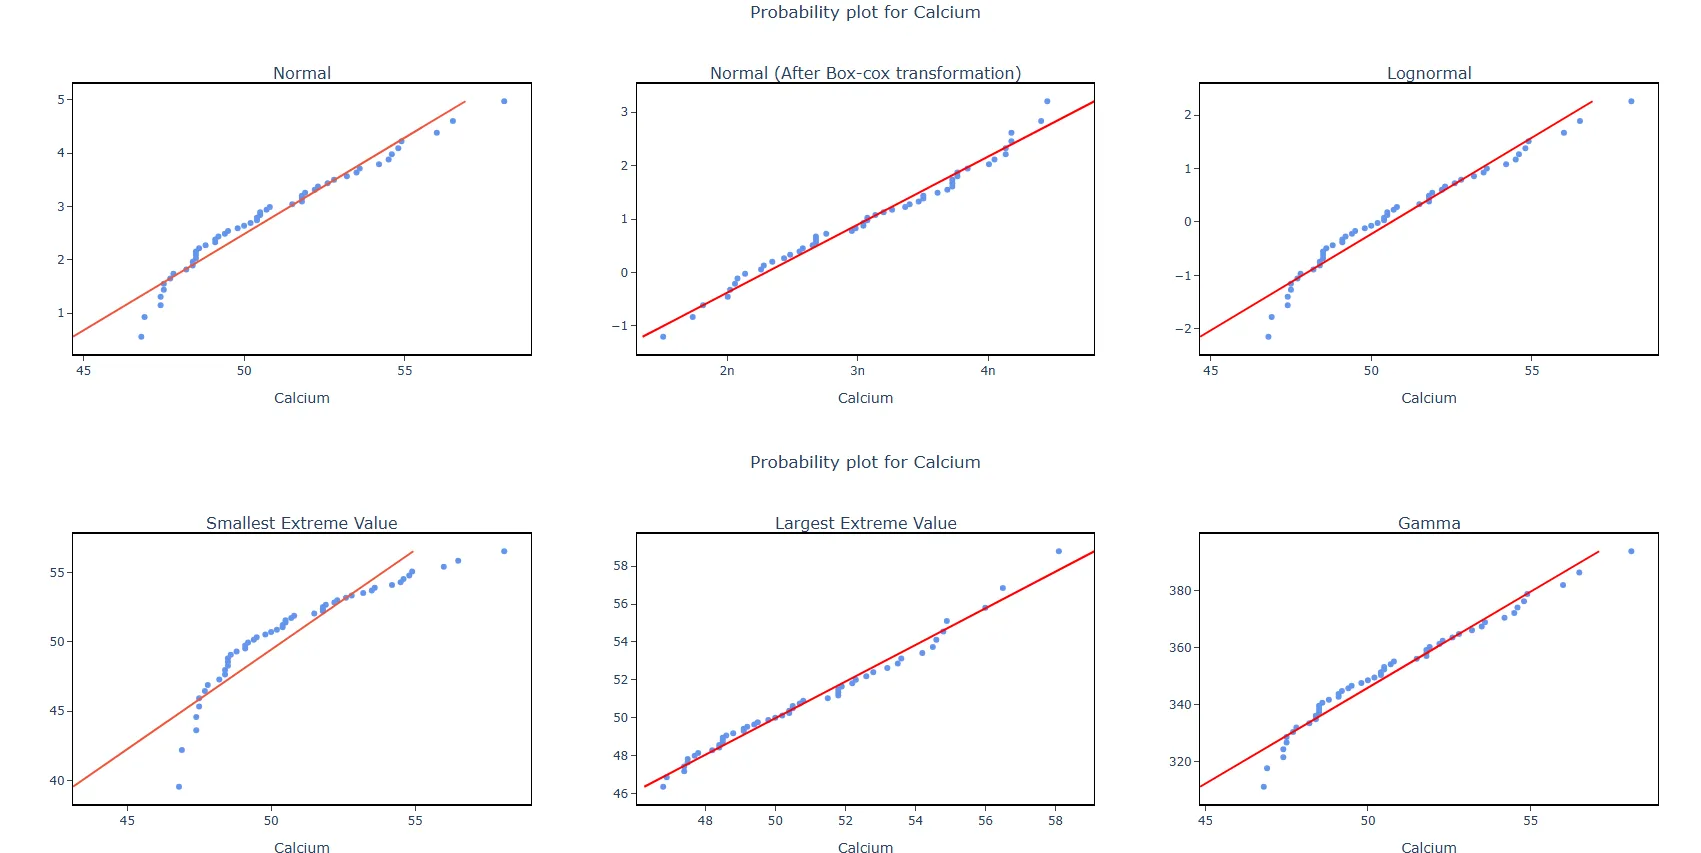
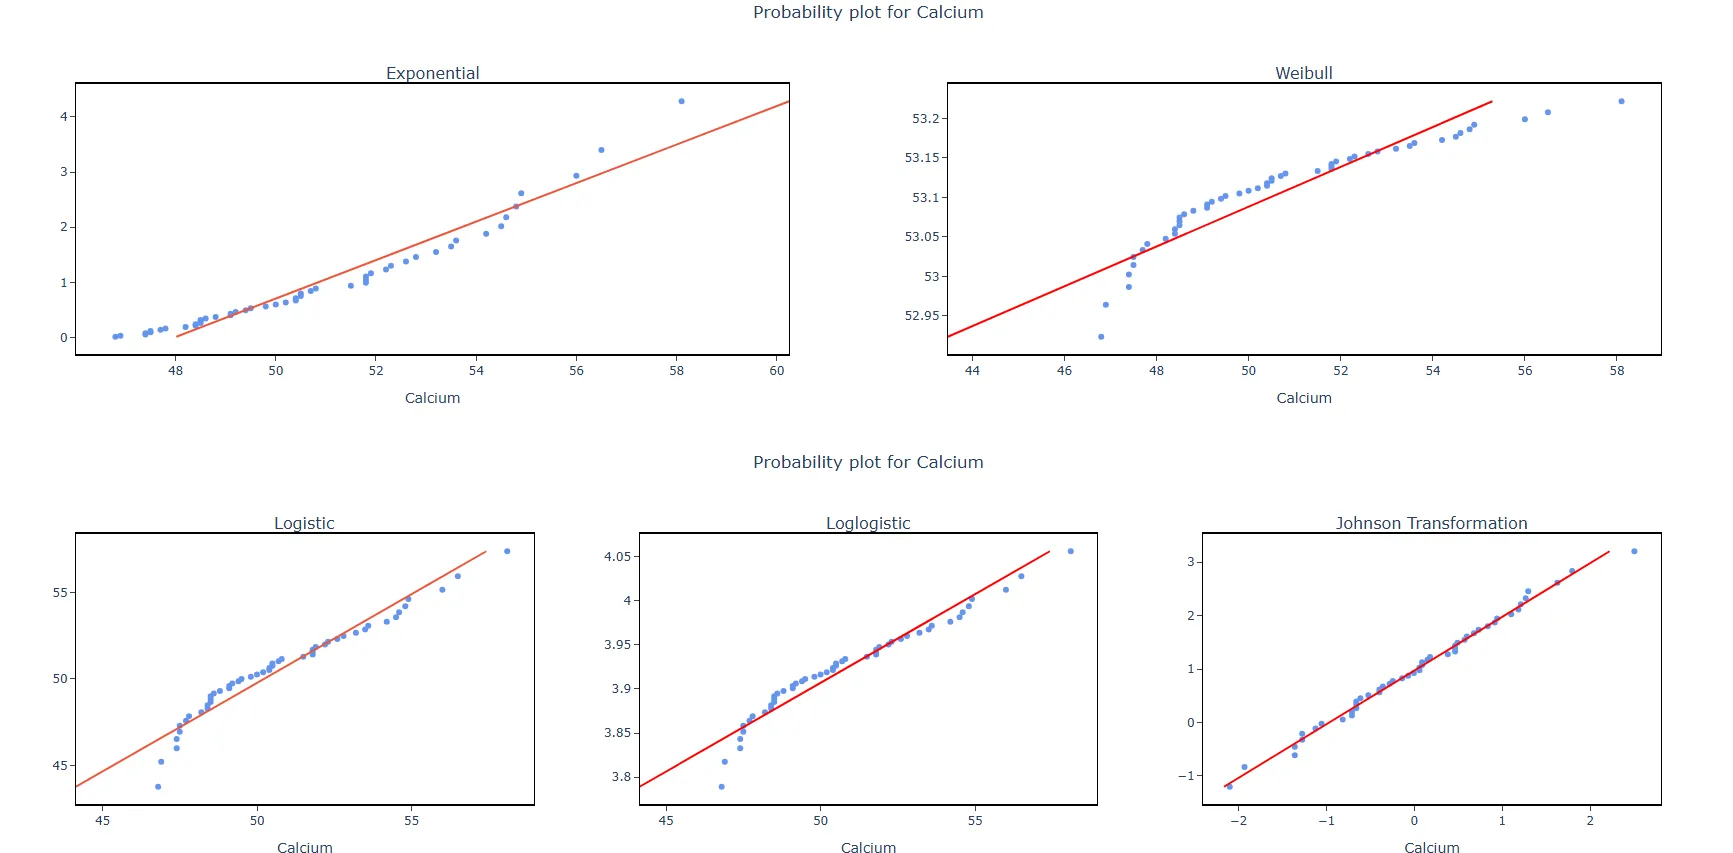
Anleitung: Verteilungsidentifikation für Einzelwerte durchführen
So gehen Sie vor:
- Melden Sie sich bei Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Hypothesis Test >Individual Distribution Identification .
- Geben Sie die Daten anschließend manuell ein, oder kopieren Sie die Daten vollständig (Strg+C) aus einer Excel-Tabelle und fügen Sie sie hier ein (Strg+V).
- Füllen Sie die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Das Dashboard der Verteilungsidentifikation für Einzelwerte ist in zwei Bereiche unterteilt.
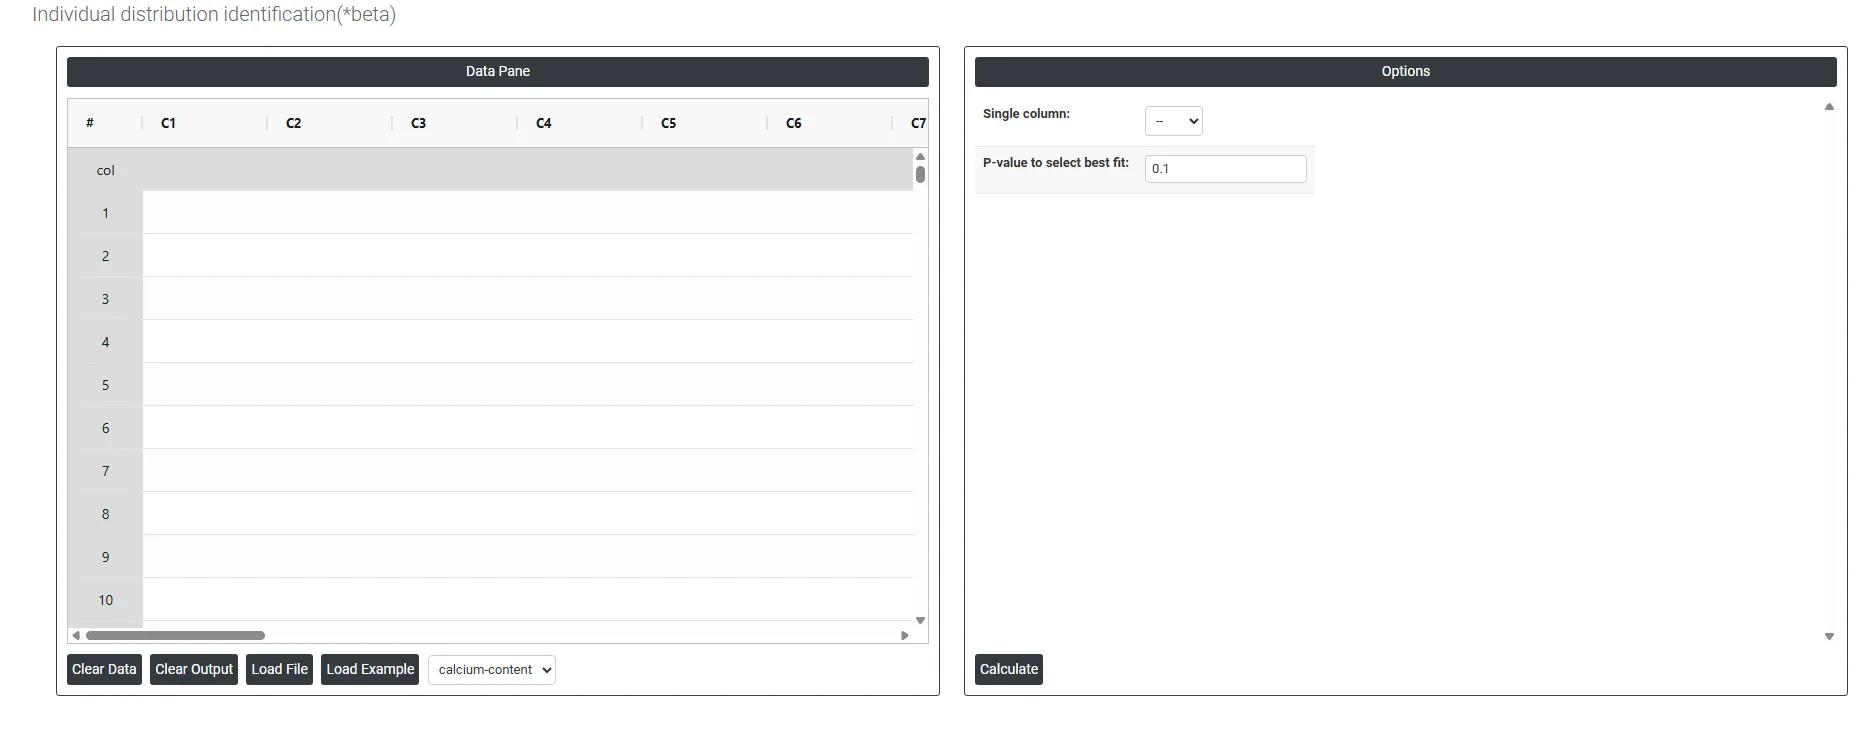
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile eine Teilgruppe. Die Daten können manuell eingegeben oder vollständig aus einer Excel-Tabelle kopiert (Strg+C) und hier eingefügt (Strg+V) werden.
Load example: Es werden Beispieldaten geladen.
Load File: Damit werden Excel-Daten direkt geladen.
Im rechten Bereich stehen zahlreiche Optionen zur Verfügung:
- Single Column: Wählen Sie die Spalte mit den stetigen Daten , an die Sie Verteilungen anpassen möchten, zum Beispiel Messwerte wie Calciumgehalt, Zykluszeiten, Zugfestigkeit oder Partikelgrößen. Das Werkzeug nimmt alle Werte dieser Spalte und prüft sie gleichzeitig gegen mehrere Wahrscheinlichkeitsverteilungen, um zu ermitteln, welche Form und Verhalten Ihrer Daten am besten beschreibt. Es kann jeweils nur eine Spalte ausgewählt werden, da jede Variable unabhängig ausgewertet wird.
- P-Value to Select Best Fit: Legt die Signifikanzschwelle fest, mit der bestimmt wird, welche Verteilungen eine annehmbare Anpassung an Ihre Daten bieten. Der übliche Standardwert ist 0.05. Das bedeutet: Jede Verteilung, deren p-Wert der Anderson-Darling-Anpassungsgüte größer als 0.05 ist, gilt als statistisch annehmbare Anpassung; es gibt dann nicht genügend Belege, um diese Verteilung als Modell für Ihre Daten zu verwerfen. So interpretieren Sie den p-Wert in diesem Zusammenhang:
- P-value > 0.05 : Die Verteilung passt annehmbar zu den Daten. Je höher der p-Wert, desto stärker spricht das dafür, dass die Verteilung gut passt.
- P-value ≤ 0.05 : Die Verteilung passt nicht gut zu den Daten und sollte nicht für die Fähigkeitsanalyse oder weitere Modellierung verwendet werden.
- Ergeben mehrere Verteilungen annehmbare p-Werte, wählen Sie diejenige mit dem höchsten p-Wert als Hauptkandidaten. Kombinieren Sie dies jedoch immer mit einer Sichtprüfung des Wahrscheinlichkeitsnetzes und prüfen Sie, ob die gewählte Verteilung physikalisch zu Ihrem Prozess passt. Eine Verteilung, die statistisch passt, aber keine logische Grundlage für Ihre Datenart hat, sollte vor der Verwendung hinterfragt werden.
Häufig gestellte Fragen
Was ist die Verteilungsidentifikation für Einzelwerte?
Die Verteilungsidentifikation für Einzelwerte passt mehrere Wahrscheinlichkeitsverteilungen gleichzeitig an Ihre Daten an, darunter Weibull-, Lognormal-, Exponential-, logistische und Gammaverteilung, und ordnet sie danach, wie gut sie die Daten beschreiben. Für die Fähigkeitsanalyse nicht normalverteilter Daten ist sie unverzichtbar, denn mit der falschen Verteilung erhalten Sie ungenaue Schätzungen für Pp, Ppk, Cp oder Cpk und irreführende Vorhersagen der Fehlerrate.
Wann sollte man die Verteilungsidentifikation für Einzelwerte verwenden?
Verwenden Sie sie, wenn Daten einen Test auf Normalverteilung nicht bestehen und Sie vor der Fähigkeitsanalyse die richtige Verteilung benötigen, wenn Prozessdaten von Natur aus schief verteilt sind, etwa Zykluszeiten, Ausfallzeiten, chemische Konzentrationen oder Partikelgrößen, und wenn eine Box-Cox-Transformation nicht geeignet ist, zum Beispiel weil die Daten Nullen oder negative Werte enthalten.
Wie wählt man die am besten passende Verteilung aus?
Eine Verteilung, deren Anderson-Darling-p-Wert über der Schwelle liegt (standardmäßig 0.05), passt annehmbar; liegt er auf oder unter der Schwelle, sollte die Verteilung nicht verwendet werden. Passen mehrere, nehmen Sie die mit dem höchsten p-Wert als Hauptkandidaten, prüfen Sie aber auch das Wahrscheinlichkeitsnetz und ob die Verteilung physikalisch zum Prozess passt.
Wie viele Datenpunkte braucht man für eine Verteilungsidentifikation?
Erheben Sie mindestens 50 bis 100 Datenpunkte, denn kleine Stichproben enthalten nicht genug Information, um zwischen Verteilungen zu unterscheiden. Die Daten sollten außerdem aus einem stabilen, beherrschten Prozess stammen, da eine Verteilungsanpassung an Daten eines instabilen Prozesses bedeutungslose Ergebnisse liefert.