
Prozessfähigkeit mehrerer Variablen, nicht normalverteilt (Multiple Variables Process Capability Nonnormal)
Dieses Werkzeug vergleicht die Prozessfähigkeit von zwei oder mehr Spalten mit einer Spezifikation, wenn die Daten schief sind, etwa bei Partikelgröße, Ebenheit oder Verunreinigung. Es passt jeder Spalte ein gewähltes Modell aus fünfzehn an, darunter Weibull, Lognormal, Box-Cox und Johnson, mit der Z-Score- oder ISO-Methode. Jede Spalte benötigt mindestens 4 Werte. Die Ausgabe ist eine Tabelle mit Pp, PPL, PPU, Ppk und PPM sowie Histogramme.
Zuletzt geprüft
Kernaussage
Multiple Variables Process Capability (Nonnormal) vergleicht mehrere Prozesse mit einer Spezifikation, wenn die Daten nicht normalverteilt sind: Es passt jedem dieselbe Verteilung an und listet Pp, Ppk und PPM nebeneinander.
Auf dieser Seite
Zweck
Multiple Variables Process Capability (Nonnormal) vergleicht die Prozessfähigkeit mehrerer Prozesse, Linien, Maschinen oder Kavitäten mit einer Spezifikation, wenn die Daten nicht normalverteilt sind. Es passt jeder Spalte getrennt dieselbe Verteilung an und stellt Pp, PPL, PPU, Ppk sowie die erwarteten und beobachteten Teile pro Million außerhalb der Spezifikation in einer Tabelle nebeneinander, mit einem Histogramm für jede Spalte. Verwenden Sie es für schiefe Merkmale wie Partikelgröße, Ebenheit, Rundlauf oder Verunreinigung, bei denen ein auf der Normalverteilung beruhender Ppk den Verteilungsrand falsch einschätzt, und wenn Sie die Prozesse in eine Rangfolge bringen möchten.
Wichtige Funktionen
- Zwei oder mehr Spalten, jede als eigener Prozess behandelt und unabhängig angepasst.
- Fünfzehn Modelle: Weibull, Exponential, Logistic, Loglogistic, Largest und Smallest Extreme Value, 2-Parameter Exponential, 3-Parameter Weibull, Gamma, Lognormal, 3-Parameter Lognormal, 3-Parameter LogLogistic, Box-Cox- und Johnson-Transformation sowie eine Mixed Distribution (ISO 22514-2).
- Z-Score- oder ISO-Perzentilmethode für die Indizes.
- Ein- oder zweiseitige Spezifikationen, die für jede Spalte gelten.
- Vergleichstabelle mit Pp, PPL, PPU, Ppk, PPM Expected und PPM Observed sowie ein Histogramm jeder Spalte mit den Spezifikationsgrenzen und der angepassten Kurve.
Statistische Methoden
Für jede Spalte wird die gewählte Verteilung nach der Maximum-Likelihood-Methode angepasst (Weibull, Gamma und Exponential mit auf 0 festgelegtem Schwellenwert; die 3-Parameter-Modelle schätzen ihn). Lognormal verwendet Mittelwert und Standardabweichung der logarithmierten Daten. Box-Cox und Johnson transformieren die Daten in eine Normalverteilung und arbeiten auf der transformierten Skala; die Mixed Distribution passt eine Mischung von Normalverteilungen an, wobei die Anzahl der Komponenten per BIC gewählt wird, sofern sie nicht festgelegt ist. Jede Spalte benötigt mindestens 4 Werte.
Z-Score-Methode (Standard): Die angepassten Wahrscheinlichkeiten jenseits jeder Grenze werden in Normalwerte umgerechnet, Z_USL = Φ⁻¹(F(USL)) und Z_LSL = Φ⁻¹(F(LSL)), wobei F die angepasste Verteilungsfunktion ist. Dann gilt PPU = Z_USL / 3, PPL = −Z_LSL / 3, Pp = (Z_USL − Z_LSL) / 6 und Ppk = min(PPL, PPU). ISO-Methode: Die Indizes verwenden die angepassten Perzentile X₀.₁₃₅, X₅₀ und X₉₉.₈₆₅ (die Punkte, die denselben ±3σ-Anteil wie eine Normalverteilung abdecken): Pp = (USL − LSL) / (X₉₉.₈₆₅ − X₀.₁₃₅), PPL = (X₅₀ − LSL) / (X₅₀ − X₀.₁₃₅), PPU = (USL − X₅₀) / (X₉₉.₈₆₅ − X₅₀). Bei nur einer Grenze wird Pp nicht ausgegeben, und Ppk ist der einseitige Index.
PPM Expected ist der angepasste Anteil der Grundgesamtheit jenseits der Grenzen mal 1,000,000; PPM Observed ist der Anteil der Stichprobenwerte jenseits der Grenzen. Dies sind Gesamtindizes (langfristig) aus allen Daten. Sie sind nur so gut wie die Verteilung: Für jede Spalte wird dasselbe Modell verwendet, prüfen Sie daher die Anpassung jeder einzelnen (zum Beispiel mit Individual Distribution Identification), bevor Sie die Spalten vergleichen.
Eingabefelder & Optionen
Feld | Beschreibung |
Process variables | Pflichtfeld. Zwei oder mehr numerische Spalten zum Vergleich; jede wird für sich angepasst. |
Fit distribution | Pflichtfeld. Eines der fünfzehn oben aufgeführten Modelle (Standard Weibull), angewendet auf jede Spalte. |
Mixture components | Nur für Mixed Distribution (ISO 22514-2): Auto (per BIC gewählt, Standard) oder 2 bis 6 Komponenten. |
Method of analysis | Z-Score (Standard) oder ISO. |
LSL / USL | Spezifikationsgrenzen, die für jede Spalte gelten; mindestens eine ist erforderlich, und LSL muss unter USL liegen. |
Company name / Report title | Optionaler Text für den Bericht; Standardtitel Multiple Variables Process Capability (Nonnormal). |
Data Options: Subset (optional) | Exclude matching rows (Standard) oder Include only matching rows, nach Zeilennummern (z. B. 3,7,12-15) und/oder einer Bedingung. |
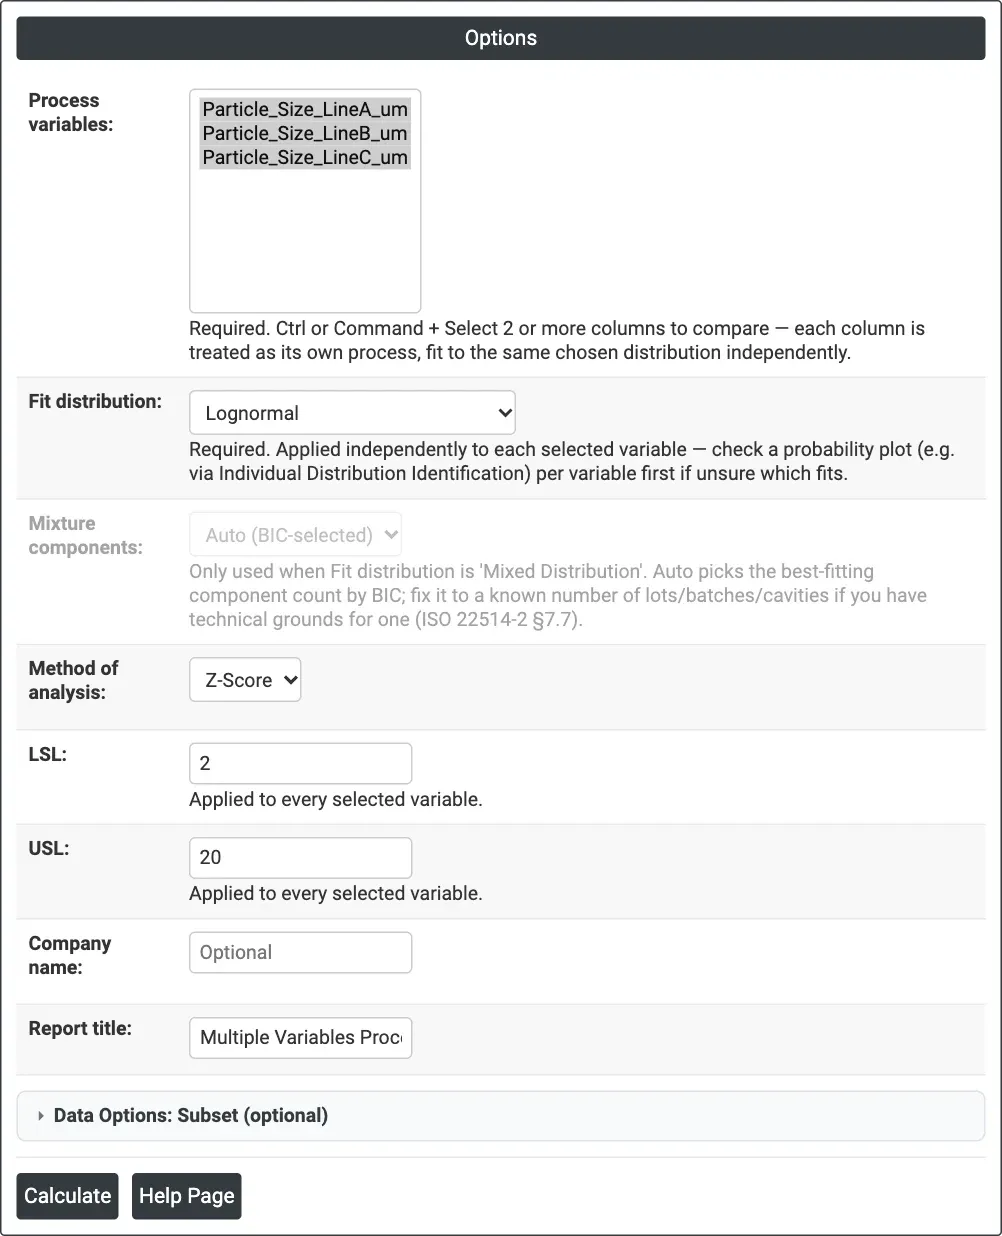
Abbildung 1 – Optionen für das Beispiel: Partikelgröße von drei Linien, Lognormal, Z-Score-Methode, LSL 2 µm und USL 20 µm.
Beschreibung der Ausgabe
- Multiple Variables Process Capability (Nonnormal) – eine Zeile je Spalte: Variable, N, Distribution, Pp, PPL, PPU, Ppk, PPM Expected und PPM Observed.
- Histogram of <distribution> Distribution – eines je Spalte, unter dem Spaltennamen, mit LSL und USL und der angepassten Dichtekurve.
- PDF-Export über Download.
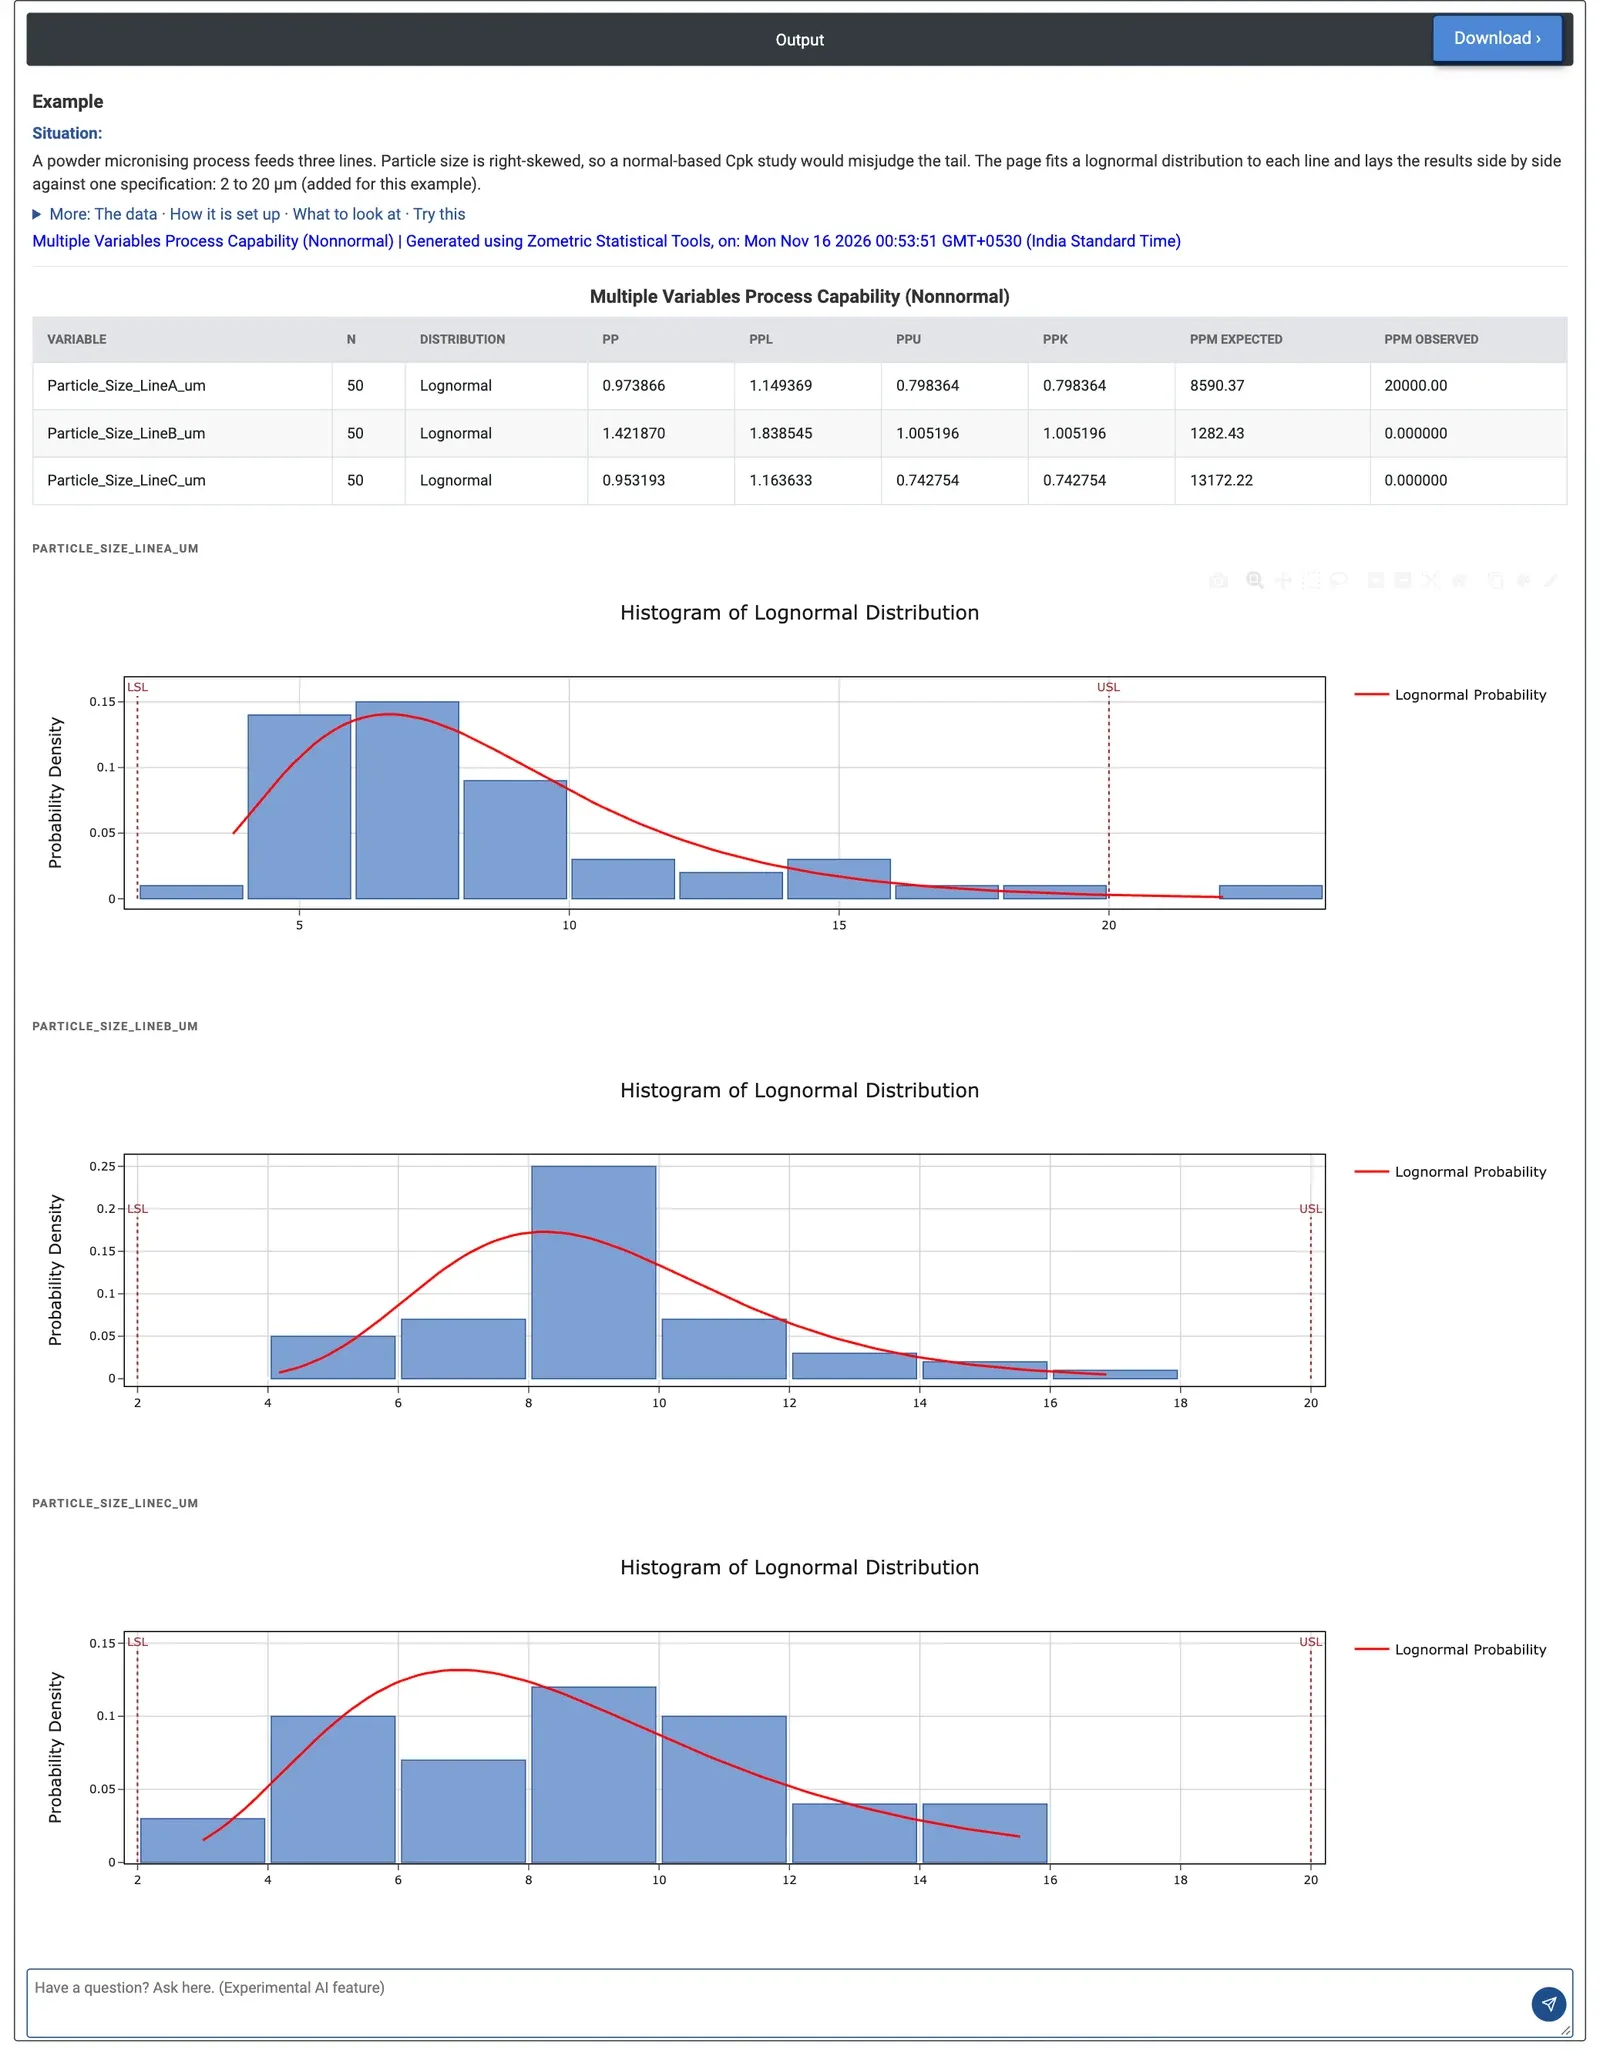
Abbildung 2 – Vergleichstabelle und Lognormal-Histogramme der drei Linien: Ppk 0.798 für Linie A, 1.005 für Linie B und 0.743 für Linie C, mit PPU unter PPL auf jeder Linie; nur Linie A hat einen Stichprobenwert über der USL.
Beispiel
Ein Pulvermikronisierungsprozess versorgt drei Linien, und die Partikelgröße ist rechtsschief (Median etwa 7 bis 9 µm, mit einem langen Rand zu groben Partikeln). Der Prozessingenieur möchte die Linien mit einer Spezifikation von 2 bis 20 µm vergleichen und verwendet dafür 50 Proben je Linie. Process variables = Particle_Size_LineA_um, Particle_Size_LineB_um und Particle_Size_LineC_um, Fit distribution = Lognormal, Method of analysis = Z-Score, LSL = 2, USL = 20.
Linie A hat Ppk 0.798 und 8,590 PPM erwartet außerhalb der Spezifikation; eine Probe (22.11 µm) liegt bereits über 20 µm, daher werden 20,000 PPM beobachtet. Linie B ist am besten, mit Ppk 1.005 und 1,282 PPM erwartet, liegt aber noch unter dem üblichen Zielwert von 1.33. Linie C ist am riskantesten, mit Ppk 0.743 und 13,172 PPM erwartet. Auf jeder Linie ist PPU kleiner als PPL: Das Risiko sind grobe Partikel über 20 µm, nicht Feinanteile unter 2 µm; Verbesserungsmaßnahmen sollten daher auf den groben Rand zielen, beginnend mit Linie C. Die Histogramme zeigen dasselbe Bild: Jede angepasste Kurve hat ihren langen Rand in Richtung USL, und bei Linie A liegt ein Balken jenseits davon.
Das Modell ist entscheidend. Mit der ISO-Methode sinken die Ppk-Werte auf 0.694, 1.008 und 0.619, bei gleicher Rangfolge. Mit einer Weibull-Anpassung wird auf jeder Linie PPL zum kleineren Index, und die Rangfolge ändert sich (Ppk 0.641, 0.948 und 0.798, nun ist Linie A am schlechtesten). Anderson-Darling-Statistiken, die getrennt von dieser Seite berechnet wurden, sprechen für Linie A und B für die Lognormalverteilung (0.79 gegenüber 2.17 und 0.63 gegenüber 1.34), für Linie C jedoch für die Weibull-Verteilung (0.20 gegenüber 0.55); die Linien sollten daher einzeln geprüft werden, bevor die Rangfolge für Entscheidungen verwendet wird.
Häufig gestellte Fragen
Wann sollte man eine Prozessfähigkeitsanalyse für mehrere nicht normalverteilte Variablen verwenden?
Verwenden Sie sie, um die Prozessfähigkeit mehrerer Prozesse, Linien, Maschinen oder Kavitäten mit einer Spezifikation zu vergleichen und in eine Rangfolge zu bringen, wenn die Daten nicht normalverteilt sind. Typische Beispiele sind schiefe Merkmale wie Partikelgröße, Ebenheit, Rundlauf oder Verunreinigung, bei denen ein auf der Normalverteilung beruhender Ppk den Rand der Verteilung falsch einschätzt.
Was ist der Unterschied zwischen der Z-Score- und der ISO-Methode?
Die Z-Score-Methode rechnet die angepassten Wahrscheinlichkeiten jenseits jeder Grenze in Normalwerte um und teilt sie durch 3, um PPU und PPL zu erhalten. Die ISO-Methode verwendet das angepasste 0.135-, 50- und 99.865-Perzentil anstelle der normalen Streubreite von plus/minus 3 Sigma. Beide können unterschiedliche Ppk-Werte ergeben, wie das Beispiel zeigt, auch wenn die Rangfolge gleich bleiben kann.
Warum ist die Wahl der Verteilung bei der Prozessfähigkeit nicht normalverteilter Daten wichtig?
Die Indizes sind nur so gut wie die angepasste Verteilung, und für jede Spalte wird dasselbe Modell verwendet. Im Beispiel änderte der Wechsel von Lognormal zu Weibull, welcher Index kleiner war, und auch die Rangfolge der Linien. Prüfen Sie die Anpassung jeder Spalte, zum Beispiel mit Individual Distribution Identification, bevor Sie sie vergleichen.
Was ist der Unterschied zwischen PPM Expected und PPM Observed?
PPM Expected ist der Anteil der Grundgesamtheit jenseits der Spezifikationsgrenzen laut angepasster Verteilung, mal 1,000,000. PPM Observed ist der Anteil der tatsächlichen Stichprobenwerte jenseits der Grenzen. Beide sind Gesamtmaße (langfristig), berechnet aus allen Daten der jeweiligen Spalte.