
Prozessfähigkeit bei nicht normalverteilten Daten
Verwenden Sie die Prozessfähigkeitsanalyse für nicht normalverteilte Daten bei stetigen Daten, die schief sind oder einer Verteilung wie Weibull, Exponential, Gamma oder Lognormal folgen. Erfassen Sie mindestens 100 Datenpunkte aus einem stabilen Prozess und prüfen Sie die Anpassung der Verteilung. Geben Sie LSL und USL ein und wählen Sie die Z-Score-Methode oder die Perzentilmethode nach ISO 22514. Die Ausgabe enthält Fähigkeitsindizes und den prognostizierten Anteil außerhalb der Spezifikation.
Zuletzt geprüft
Kernaussage
Die Prozessfähigkeitsanalyse für nicht normalverteilte Daten bewertet, ob ein Prozess innerhalb der Spezifikationsgrenzen fertigt, wenn die Daten nicht normalverteilt sind, und passt dazu eine Verteilung wie Weibull oder Lognormal an.
Auf dieser Seite
- Was ist die Prozessfähigkeit bei nicht normalverteilten Daten?
- Wann wird die Prozessfähigkeitsanalyse für nicht normalverteilte Daten eingesetzt?
- Hinweise zur richtigen Anwendung der Prozessfähigkeitsanalyse für nicht normalverteilte Daten
- Alternativen: Wann die Prozessfähigkeitsanalyse für nicht normalverteilte Daten nicht geeignet ist
- Beispiel für die Prozessfähigkeitsanalyse bei nicht normalverteilten Daten
- Anleitung: Prozessfähigkeitsanalyse für nicht normalverteilte Daten durchführen
Was ist die Prozessfähigkeit bei nicht normalverteilten Daten?
Die Prozessfähigkeitsanalyse für nicht normalverteilte Daten ist ein Verfahren, mit dem die Fähigkeit eines Prozesses bewertet wird, innerhalb festgelegter Grenzen zu fertigen, wenn die Daten von einer Normalverteilung abweichen. Diese Analyse ist entscheidend, wenn die Daten Merkmale wie Schiefe oder Ausreißer aufweisen oder einer anderen Verteilung als der Gaußschen Glockenkurve folgen. Durch die Wahl des richtigen nicht normalen Verteilungsmodells beurteilt diese Analyse, wie gut die Prozessergebnisse die Kundenanforderungen erfüllen, bewertet die gesamte Prozessleistung und prognostiziert den Anteil der Ergebnisse, die voraussichtlich außerhalb des zulässigen Bereichs liegen. So lässt sich feststellen, ob der Prozess die geforderten Standards zuverlässig erfüllen kann, auch wenn die Daten nicht normalverteilt sind.
Einfach gesagt: Es ist eine Möglichkeit, sicherzustellen, dass ein Prozess gut funktioniert, auch wenn die Daten nicht so aussehen, wie wir es erwarten.
Wann wird die Prozessfähigkeitsanalyse für nicht normalverteilte Daten eingesetzt?
Die Prozessfähigkeitsanalyse für nicht normalverteilte Daten sollte verwendet werden, wenn die analysierten Daten keiner Normalverteilung folgen, also nicht die typische glockenförmige Kurve zeigen, die symmetrisch um den Mittelwert liegt. In folgenden Situationen verwenden Sie die Prozessfähigkeitsanalyse für nicht normalverteilte Daten:
- Schiefe Daten: Sind Ihre Daten links- oder rechtsschief, liegen also die meisten Werte gehäuft auf einer Seite, ist eine Prozessfähigkeitsanalyse für nicht normalverteilte Daten besser geeignet.
- Vorhandensein von Ausreißern: Enthalten Ihre Daten Extremwerte, die nicht zum Gesamtmuster passen, können diese eine Normalverteilung verzerren. Untersuchen Sie diese zuerst; sind sie ein echter Bestandteil eines Prozesses mit langem Verteilungsende, kann eine nicht normale Verteilung das Verteilungsende besser abbilden als die Normalverteilung.
- Unsymmetrische Verteilungen: Zeigen die Daten ein unsymmetrisches Muster (z. B. Lognormal- oder Exponentialverteilung), ermöglicht die Prozessfähigkeitsanalyse für nicht normalverteilte Daten eine genauere Bewertung.
- Mehrere Gipfel: Haben Ihre Daten mehr als einen Gipfel (bimodale oder multimodale Verteilung), folgen sie keiner Normalverteilung; meist bedeutet dies, dass die Daten aus mehr als einem Prozessstrang stammen (zum Beispiel aus verschiedenen Maschinen oder Chargen), die vor der Beurteilung der Prozessfähigkeit getrennt werden sollten.
- Prozesseigenschaften: Manche Prozesse erzeugen aufgrund der Art des Prozesses oder des Produkts naturgemäß nicht normalverteilte Daten. Beispielsweise können Verschleiß im Zeitverlauf, Chargenprozesse oder Prozesse mit natürlichen Grenzen nicht normalverteilte Daten liefern.
Hinweise zur richtigen Anwendung der Prozessfähigkeitsanalyse für nicht normalverteilte Daten
- Verwenden Sie für die Analyse stetige Daten; bei attributiven Daten wenden Sie stattdessen die binomiale oder die Poisson-Prozessfähigkeitsanalyse an.
- Erfassen Sie mindestens 100 Datenpunkte, um zuverlässige Schätzungen der Prozessfähigkeit und eine genaue Abbildung der Prozessstreuung sicherzustellen.
- Stellen Sie vor der Prozessfähigkeitsanalyse sicher, dass der Prozess stabil und unter Kontrolle ist, gegebenenfalls mit Werkzeugen wie der Xbar-S-Karte oder dem Nonnormal Capability Sixpack.
- Die Daten müssen der gewählten nicht normalen Verteilung eng folgen; verwenden Sie die Verteilungsidentifikation für Einzelwerte, um die beste Anpassung für genaue Fähigkeitsschätzungen zu finden.
Alternativen: Wann die Prozessfähigkeitsanalyse für nicht normalverteilte Daten nicht geeignet ist
- Wenn Sie nicht sicher sind, welche nicht normale Verteilung zu Ihren Daten passt, verwenden Sie vor der Analyse die Verteilungsidentifikation für Einzelwerte.
- Um die Prozessbeherrschung und die Eignung einer bestimmten nicht normalen Verteilung zu prüfen, verwenden Sie zuerst das Nonnormal Capability Sixpack.
- Um die Streuung innerhalb der Teilgruppen und die potenzielle Prozessfähigkeit zusammen mit der Gesamtprozessfähigkeit zu schätzen, verwenden Sie die Prozessfähigkeitsanalyse für Normalverteilung, um nicht normalverteilte Daten zu transformieren und auf Basis einer Normalverteilung zu bewerten.
Beispiel für die Prozessfähigkeitsanalyse bei nicht normalverteilten Daten
Ein Hersteller von Automobilkomponenten prüft, ob eine Bohrmaschine die Spezifikationen für ein kritisches Bauteil einhalten kann. Das Bauteil muss in einem Bereich liegen: untere Spezifikationsgrenze (LSL) 22.15 und obere Spezifikationsgrenze (USL) 22.35. Zur Bewertung entnimmt der Ingenieur der Maschine 125 Proben und führt folgende Schritte durch:
- Die erforderlichen Daten wurden erhoben.
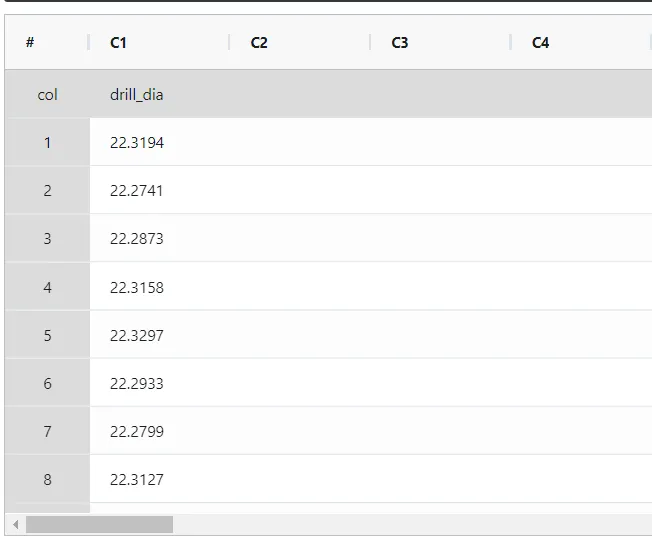
- Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
- Die Prozessfähigkeitsanalyse für nicht normalverteilte Daten finden Sie unter Statistical module> Process Capability>Non-Normal Process Capability.
- Geben Sie im Werkzeug die Daten zusammen mit den weiteren Eingaben wie folgt ein:
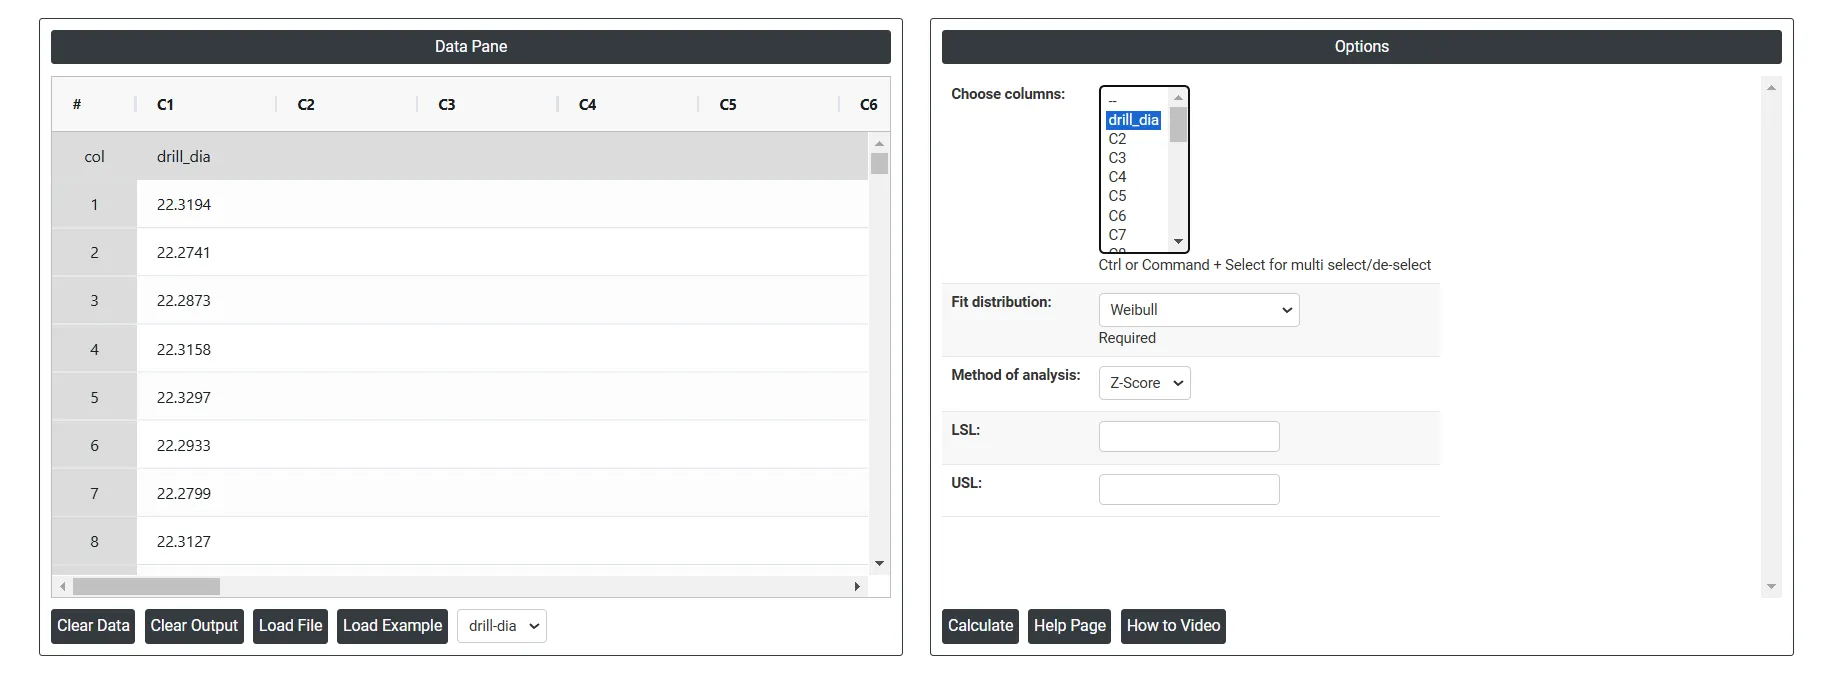
5. Nach Ausführung des oben genannten Werkzeugs erhalten Sie folgende Ausgabe:
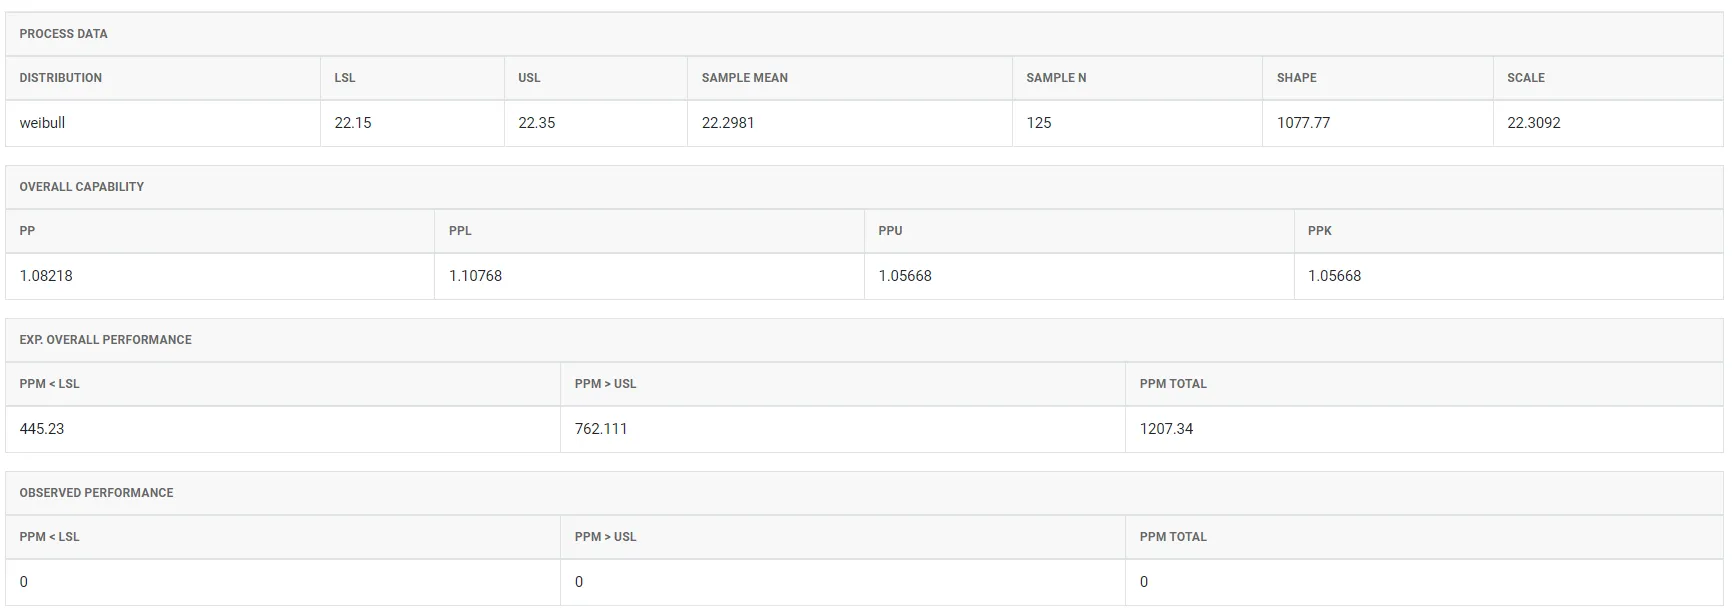
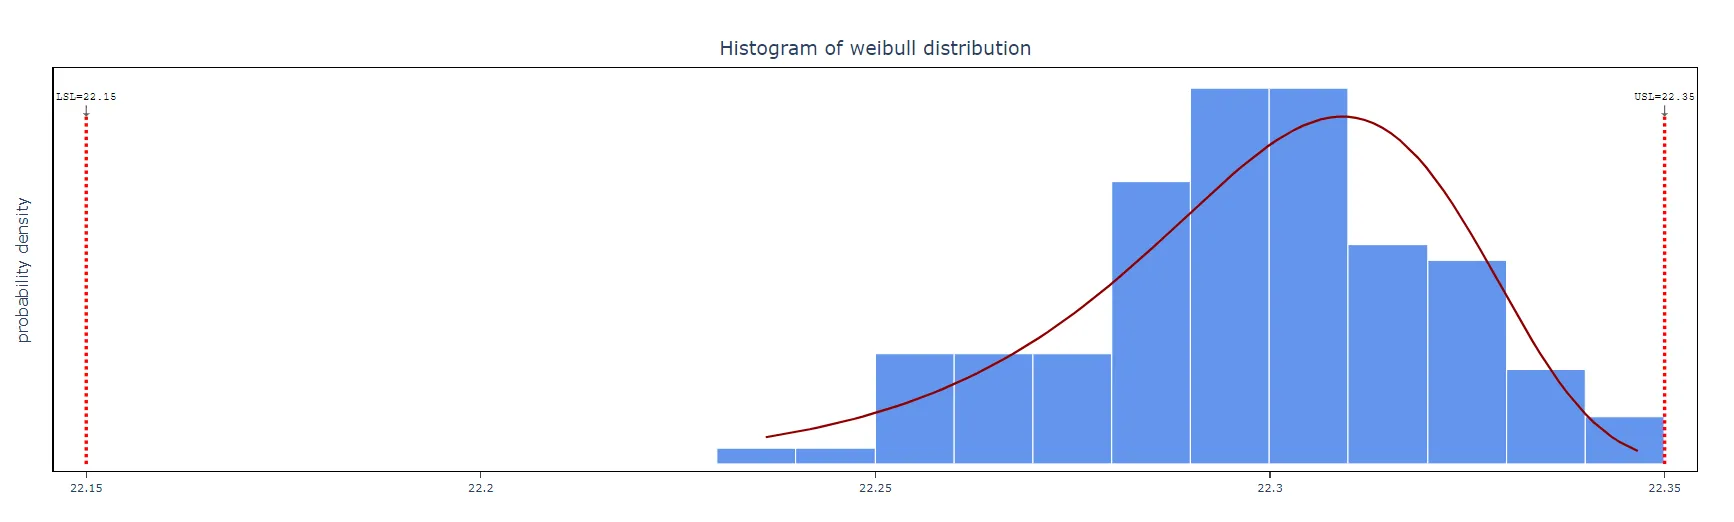
Anleitung: Prozessfähigkeitsanalyse für nicht normalverteilte Daten durchführen
Die Anleitung lautet wie folgt:
- Melden Sie sich bei Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Process Capability >Non-Normal Process Capability.
- Klicken Sie auf Non Normal Process Capability, um zum Dashboard zu gelangen.
- Geben Sie die Daten anschließend manuell ein, oder kopieren Sie die Daten vollständig (Strg+C) aus einer Excel-Tabelle und fügen Sie sie hier ein (Strg+V).
- Wählen Sie anschließend die anzupassende Verteilung, geben Sie LSL und USL ein und wählen Sie die Analysemethode.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Das Dashboard von Non Normal Process Capability ist in zwei Bereiche unterteilt.
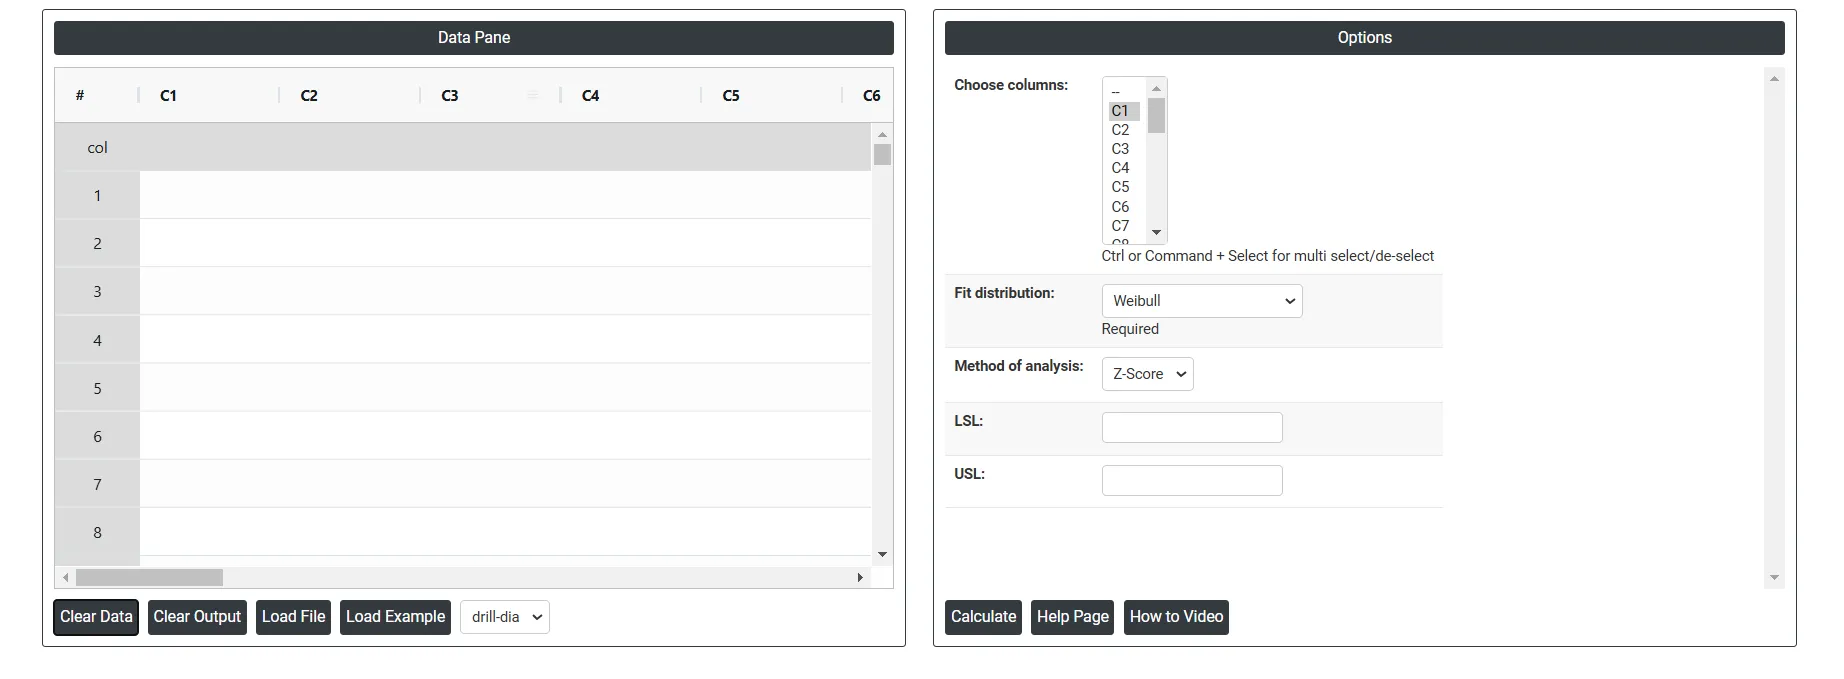
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile eine Teilgruppe. Die Daten können manuell eingegeben oder vollständig aus einer Excel-Tabelle kopiert (Strg+C) und hier eingefügt (Strg+V) werden.
Load example: Es werden Beispieldaten geladen.
Load File: Damit werden Excel-Daten direkt geladen.
Im rechten Bereich stehen folgende Optionen zur Verfügung:
- Fit Distribution:
- Weibull distribution: Die Weibull-Verteilung ist ein flexibles statistisches Modell, das in Technik, medizinischer Forschung, Finanzwesen und Klimatologie eingesetzt wird, insbesondere zur Analyse von Ausfallzeitdaten und zur Behandlung schiefer Prozessdaten. Sie wird durch drei Parameter definiert: Form, Skala und Schwellenwert. Die 3-parametrige Weibull-Verteilung enthält alle drei, während die 2-parametrige Version ohne Schwellenwert nur für positive Werte verwendet wird. Der Formparameter beeinflusst die Schiefe der Verteilung, der Skalenparameter gibt den Punkt an, an dem voraussichtlich 63.2 % der Grundgesamtheit ausgefallen sind, und der Schwellenwertparameter verschiebt die Verteilung entlang der Zeitachse. Diese Verteilung ist entscheidend für die Vorhersage von Ausfällen, die Schätzung von Lebensdauern und das Verständnis komplexer Datenmuster. Ihre Vielseitigkeit erstreckt sich auch auf Qualitätssicherung und Risikomanagement. Exponential: Die Exponentialverteilung ist eine stetige Wahrscheinlichkeitsverteilung, die in der Prozessfähigkeitsanalyse bei nicht normalverteilten Daten häufig verwendet wird, insbesondere bei Ausfallzeitdaten mit konstanter Ausfallrate und bei Zwischenankunftszeiten von Ereignissen in einem Poisson-Prozess, in dem Ereignisse fortlaufend und unabhängig mit konstanter mittlerer Rate auftreten. Diese Verteilung eignet sich ideal zur Modellierung der Zeit bis zum Eintreten eines bestimmten Ereignisses; durch ihre Gedächtnislosigkeit passt sie gut zu Situationen, in denen die Vergangenheit die Zukunft nicht beeinflusst, und ermöglicht eine genaue Analyse schiefer Daten, die keiner Normalverteilung folgen. Logistic: Die logistische Verteilung spielt in der Prozessfähigkeitsanalyse für nicht normalverteilte Daten eine wichtige Rolle, insbesondere wenn die Daten symmetrisch, aber nicht normalverteilt sind. Die logistische Verteilung ähnelt in ihrer Form der Normalverteilung, hat aber schwerere Verteilungsenden, das heißt, sie ordnet Extremwerten eine höhere Wahrscheinlichkeit zu. Diese Eigenschaft macht sie für bestimmte Prozessfähigkeitsanalysen nützlich, bei denen die Daten zu Ausreißern oder zu einer größeren Streuung neigen, als die Normalverteilung abbilden würde. Loglogistic: Die loglogistische Verteilung wird für positive, rechtsschiefe Daten verwendet, deren Logarithmus einer logistischen Verteilung folgt. Sie ähnelt der Lognormalverteilung, hat aber schwerere Verteilungsenden und eignet sich daher für Prozesse, in denen große Werte wahrscheinlicher sind, als eine Lognormalverteilung vorhersagen würde. Largest Extreme Value: Die Verteilung des größten Extremwerts ist in der Prozessfähigkeitsanalyse für nicht normalverteilte Daten unverzichtbar, wenn es um Daten geht, bei denen Maximalwerte im Mittelpunkt stehen, oder um rechtsschiefe Verteilungen. Sie sorgt dafür, dass Extremwerte genau modelliert werden, was zu zuverlässigeren Fähigkeitsbewertungen und besser begründeten Entscheidungen über Prozessleistung und Risiken führt. Smallest Extreme Value: Die Verteilung des kleinsten Extremwerts (SEV) spielt in der Prozessfähigkeitsanalyse für nicht normalverteilte Daten eine entscheidende Rolle, insbesondere wenn die Daten schief sind und nicht zur Normalverteilung passen. Die SEV-Verteilung eignet sich besonders zur Modellierung der Minimalwerte eines Datensatzes, etwa der kürzesten Ausfallzeit oder des schwächsten Glieds in einer Kette von Ereignissen. 2-Parameter Exponential: Die 2-parametrige Exponentialverteilung wird durch einen Skalenparameter (λ) und einen Schwellenwertparameter (θ) definiert. Der Schwellenwertparameter verschiebt die Verteilung um θ Einheiten nach rechts und gibt eine Mindestwartezeit an, bevor Ereignisse eintreten können. Der Skalenparameter steuert die Rate, mit der Ereignisse nach dem Schwellenwert eintreten. 3- Parameter Weibull: Die 3-parametrige Weibull-Verteilung wird durch einen Formparameter (β), einen Skalenparameter (η) und einen Schwellenwertparameter (γ) definiert. Der Formparameter (β) bestimmt das Verhalten der Ausfallrate, der Skalenparameter (η) gibt die charakteristische Lebensdauer an, und der Schwellenwertparameter (γ) verschiebt die Verteilung und steht für die Mindestzeit, bevor Ausfälle beginnen. Diese Verteilung wird zur Modellierung von Lebensdauerdaten mit einer anfänglichen Wartezeit verwendet, bevor Ereignisse eintreten können, und bietet zusätzliche Flexibilität für eine genauere Datenanpassung. Gamma: Die Gammaverteilung ist eine stetige Wahrscheinlichkeitsverteilung, die durch einen Formparameter (k oder α) und einen Skalenparameter (θ) gekennzeichnet ist. Sie wird vor allem zur Modellierung der Wartezeit bis zum Eintreten einer bestimmten Anzahl von Ereignissen verwendet und eignet sich daher ideal für Prozesse mit kumulierten Zeiten oder schiefen Daten. Lognormal: Die Lognormalverteilung ist eine stetige Wahrscheinlichkeitsverteilung, bei der der Logarithmus der Zufallsvariablen normalverteilt ist. Sie ist rechtsschief und wird durch den Mittelwert (μ) und die Standardabweichung (σ) der zugrunde liegenden Normalverteilung definiert. Sie wird häufig in Finanzwesen, Biowissenschaften und Zuverlässigkeitsanalyse eingesetzt und modelliert Daten, die positiv bleiben müssen und multiplikatives Wachstum oder rechtsschiefes Verhalten zeigen.
- LSL: Dies ist der kleinste zulässige Wert für ein Prozessmessergebnis. Jeder Wert unterhalb dieser Grenze zeigt an, dass das Produkt oder der Prozess die Qualitätsanforderungen nicht erfüllt, und gilt als fehlerhaft.
- USL: Dies ist der größte zulässige Wert für ein Prozessmessergebnis. Auch jeder Wert oberhalb dieser Grenze zeigt an, dass das Produkt oder der Prozess außerhalb der Spezifikation liegt und die Qualitätsanforderungen nicht erfüllt.
- Method of Analysis:
- Z-Score: Die Z-Score-Methode ermittelt anhand der angepassten Verteilung die Wahrscheinlichkeit, jede Spezifikationsgrenze zu überschreiten, und rechnet sie in einen äquivalenten Z-Wert der Standardnormalverteilung um. Aus diesen Z-Werten werden dann die Fähigkeitsindizes berechnet (jeder einseitige Index ist Z geteilt durch 3), sodass sie mit den Indizes für normalverteilte Daten vergleichbar sind. Die Methode hilft, Leistungsprobleme zu erkennen, und ermöglicht datenbasierte Entscheidungen zur Qualitätsverbesserung.
Verwenden Sie diese Methode, wenn:
- die Daten keiner Normalverteilung folgen, was bei vielen realen Prozessen häufig vorkommt.
- Sie einen flexibleren Ansatz benötigen, der verschiedene Verteilungen abbilden kann (z. B. Exponential-, Lognormalverteilung).
- Sie Prozessfähigkeitsindizes (Cp, Cpk) berechnen möchten, die danach standardisiert sind, wie viele Standardabweichungen der Prozessmittelwert von den Spezifikationsgrenzen entfernt ist.
Vorteile:
- Die Z-Score-Methode vermittelt ein klareres Bild der Prozessleistung im Verhältnis zu den Spezifikationsgrenzen, da sie die Fähigkeit in Standardabweichungen ausdrückt.
- Sie ermöglicht bessere Vergleiche zwischen verschiedenen Prozessen oder Merkmalen, auch wenn die Daten nicht normalverteilt sind.
- ISO: Die ISO-Methode folgt der Norm ISO 22514 für die Prozessfähigkeitsanalyse bei nicht normalverteilten Daten. Sie berechnet die Fähigkeitsindizes direkt aus Perzentilen der angepassten Verteilung: dem 0.135-%- und dem 99.865-%-Perzentil, die ±3 Standardabweichungen einer Normalverteilung entsprechen, und dem Median als Prozesslage. Diese Methode ist vorzuziehen, wenn die Einhaltung internationaler Qualitätsnormen gefordert ist.
- Download as Excel: Gibt das Ergebnis im Excel-Format aus, das sich leicht bearbeiten und über die Option Load File erneut für Berechnungen laden lässt.
Häufig gestellte Fragen
Was ist die Prozessfähigkeit bei nicht normalverteilten Daten?
Die Prozessfähigkeitsanalyse für nicht normalverteilte Daten bewertet die Fähigkeit eines Prozesses, innerhalb der Spezifikationsgrenzen zu fertigen, wenn die Daten keiner Normalverteilung folgen. Durch Anpassung eines geeigneten nicht normalen Verteilungsmodells beurteilt sie die gesamte Prozessleistung und prognostiziert den Anteil der Ergebnisse, die voraussichtlich außerhalb des zulässigen Bereichs liegen.
Wann sollte man die Prozessfähigkeitsanalyse für nicht normalverteilte Daten verwenden?
Verwenden Sie sie, wenn stetige Daten schief oder unsymmetrisch sind oder aus einem Prozess stammen, der naturgemäß nicht normalverteilte Daten erzeugt, etwa durch Verschleiß im Zeitverlauf oder bei Prozessen mit natürlichen Grenzen. Untersuchen Sie Ausreißer zuerst und trennen Sie Daten mit mehr als einem Gipfel vor der Beurteilung der Prozessfähigkeit nach Prozesssträngen, etwa nach Maschinen oder Chargen. Für attributive Daten verwenden Sie die binomiale oder die Poisson-Prozessfähigkeitsanalyse.
Wie viele Daten benötigt man für die Prozessfähigkeit bei nicht normalverteilten Daten?
Erfassen Sie mindestens 100 Datenpunkte für zuverlässige Fähigkeitsschätzungen. Der Prozess sollte vor der Analyse stabil und unter Kontrolle sein, und die Daten müssen der gewählten Verteilung eng folgen. Wenn Sie nicht sicher sind, welche Verteilung passt, verwenden Sie zuerst die Verteilungsidentifikation für Einzelwerte.
Was ist der Unterschied zwischen der Z-Score- und der ISO-Methode bei nicht normalverteilten Daten?
Die Z-Score-Methode ermittelt anhand der angepassten Verteilung die Wahrscheinlichkeit jenseits jeder Spezifikationsgrenze und rechnet sie in einen äquivalenten Z-Wert der Standardnormalverteilung um; jeder einseitige Index ist Z geteilt durch 3, sodass die Indizes mit denen für normalverteilte Daten vergleichbar sind. Die ISO-Methode folgt ISO 22514 und berechnet die Indizes aus dem 0.135-%- und dem 99.865-%-Perzentil der angepassten Verteilung, mit dem Median als Prozesslage.