
Prozessfähigkeit bei nicht normalverteilten Daten
Die Prozessfähigkeitsanalyse für nicht normalverteilte Daten misst, wie gut ein Prozess seine Spezifikationsgrenzen einhält, wenn die zugrunde liegenden Daten keiner Normalverteilung (Glockenkurve) folgen. Statt schiefen oder ungewöhnlichen Daten eine Normalverteilungsannahme aufzuzwingen, passt diese Analyse eine anerkannte nicht normale Verteilung an, etwa Weibull, Lognormal, Exponential oder Gamma, und berechnet die Fähigkeitsindizes auf Grundlage der tatsächlichen Form dieser Verteilung.
Zuletzt geprüft
Kernaussage
Die Prozessfähigkeitsanalyse für nicht normalverteilte Daten misst, wie gut ein Prozess seine Spezifikationsgrenzen einhält, wenn die Daten keiner Normalverteilung (Glockenkurve) folgen.
Auf dieser Seite
- Was ist die Prozessfähigkeit bei nicht normalverteilten Daten?
- Wann wird die Prozessfähigkeitsanalyse für nicht normalverteilte Daten eingesetzt?
- Hinweise zur richtigen Anwendung der Prozessfähigkeitsanalyse für nicht normalverteilte Daten
- Alternativen: Wann Sie die Prozessfähigkeitsanalyse für nicht normalverteilte Daten nicht verwenden sollten
- Beispiel für die Prozessfähigkeit bei nicht normalverteilten Daten
- Anleitung: Prozessfähigkeit bei nicht normalverteilten Daten berechnen
Was ist die Prozessfähigkeit bei nicht normalverteilten Daten?
Die Prozessfähigkeitsanalyse für nicht normalverteilte Daten misst, wie gut ein Prozess seine Spezifikationsgrenzen einhält, wenn die zugrunde liegenden Daten keiner Normalverteilung (Glockenkurve) folgen. Statt schiefen oder ungewöhnlichen Daten eine Normalverteilungsannahme aufzuzwingen, passt diese Analyse eine anerkannte nicht normale Verteilung an, etwa Weibull, Lognormal, Exponential oder Gamma, und berechnet die Fähigkeitsindizes auf Grundlage der tatsächlichen Form dieser Verteilung.
Übliche Fähigkeitsindizes wie Cp und Cpk setzen eine Normalverteilung voraus. Ist diese Annahme verletzt, werden die Indizes ungenau und können die tatsächliche Prozessfähigkeit über- oder unterschätzen. Die Fähigkeitsanalyse für nicht normalverteilte Daten löst dieses Problem durch das richtige Verteilungsmodell und liefert ein deutlich ehrlicheres und präziseres Bild davon, ob der Prozess beständig Produkte innerhalb der Spezifikation liefern kann.
Einfache Definition: Eine Fähigkeitsanalyse für schiefe oder nicht normalverteilte Daten: Sie passt die richtige Verteilung an Ihre Daten an und berechnet die Fähigkeitsindizes auf Grundlage dieser tatsächlichen Form, statt eine falsche Normalverteilungsannahme aufzuzwingen.
Wann wird die Prozessfähigkeitsanalyse für nicht normalverteilte Daten eingesetzt?
- Wenn Ihre Prozessdaten stetig sind, aber einen Test auf Normalverteilung nicht bestehen, zum Beispiel stark schiefe Zykluszeiten, Festigkeitsmesswerte oder chemische Konzentrationen.
- Wenn ein Wahrscheinlichkeitsnetz oder Test auf Normalverteilung bestätigt, dass Ihre Daten einer bestimmten nicht normalen Verteilung wie Weibull, Lognormal, Exponential oder Gamma folgen.
- Wenn eine Box-Cox- oder Johnson-Transformation nicht geeignet oder nicht praktikabel ist, zum Beispiel wenn sich die transformierten Daten in den ursprünglichen Einheiten schwer interpretieren lassen.
- Wenn das Werkzeug Individual Distribution Identification die am besten passende Verteilung für Ihre Daten bestätigt hat.
Hinweise zur richtigen Anwendung der Prozessfähigkeitsanalyse für nicht normalverteilte Daten
- Führen Sie stets zuerst die Individual Distribution Identification (Verteilungsidentifikation) durch, um die am besten passende Verteilung zu bestimmen, bevor Sie sie in dieser Analyse auswählen. Die Wahl der falschen Verteilung führt zu irreführenden Fähigkeitsindizes.
- Erfassen Sie mindestens 100 Datenpunkte , damit die Verteilungsanpassung zuverlässige und stabile Parameterschätzungen liefert.
- Stellen Sie sicher, dass der Prozess stabil und statistisch beherrscht ist, bevor Sie eine Fähigkeitsanalyse durchführen. Ein instabiler Prozess liefert bedeutungslose Fähigkeitskennzahlen, unabhängig von der verwendeten Verteilung.
- Verwenden Sie diese Analyse nicht für attributive Daten oder Zähldaten ; verwenden Sie stattdessen die binomiale oder Poisson-Prozessfähigkeit.
- Überprüfen Sie die gewählte Verteilung mit Anpassungsgütestatistiken und Wahrscheinlichkeitsnetzen : Ein hoher p-Wert und eine gerade Linie im Wahrscheinlichkeitsnetz bestätigen eine gute Anpassung.
- Fähigkeitsindizes wie Pp, Ppk, Cp und Cpk werden auf Grundlage der Perzentile der angepassten Verteilung statt anhand von Vielfachen der Standardabweichung ausgegeben; interpretieren Sie sie entsprechend.
Alternativen: Wann Sie die Prozessfähigkeitsanalyse für nicht normalverteilte Daten nicht verwenden sollten
- Situation
Stattdessen verwenden
Die Daten sind normalverteilt
Prozessfähigkeitsanalyse für normalverteilte Daten (Standard)
Die Daten lassen sich in eine Normalverteilung transformieren
Fähigkeitsanalyse mit Box-Cox- oder Johnson-Transformation
Die Verteilung ist unbekannt oder unklar
Nichtparametrische Prozessfähigkeit
Gut/Schlecht-Daten oder Anzahlen fehlerhafter Einheiten
Binomiale Prozessfähigkeitsanalyse
Die Daten sind Anzahlen von Ereignissen (Fehler je Einheit)
Poisson-Prozessfähigkeitsanalyse
Ein kombinierter grafischer und statistischer Bericht wird benötigt
Capability Six Pack (Between/Within)
Beispiel für die Prozessfähigkeit bei nicht normalverteilten Daten
Ein Automobilzulieferer entwickelt ein kritisches Bauteil für einen OEM-Kunden. Zur Qualitätssicherung prüft ein Ingenieur, ob eine Bohrmaschine die Spezifikationen einhalten kann. Das Teil muss innerhalb eines Bereichs liegen: LSL (untere Spezifikationsgrenze) 22.15 und USL (obere Spezifikationsgrenze) 22.35. Der Ingenieur entnimmt der Maschine 125 Proben und führt eine Maschinenfähigkeitsuntersuchung durch. Er ist in folgenden Schritten vorgegangen:
- Er hat die erforderlichen Daten erfasst.
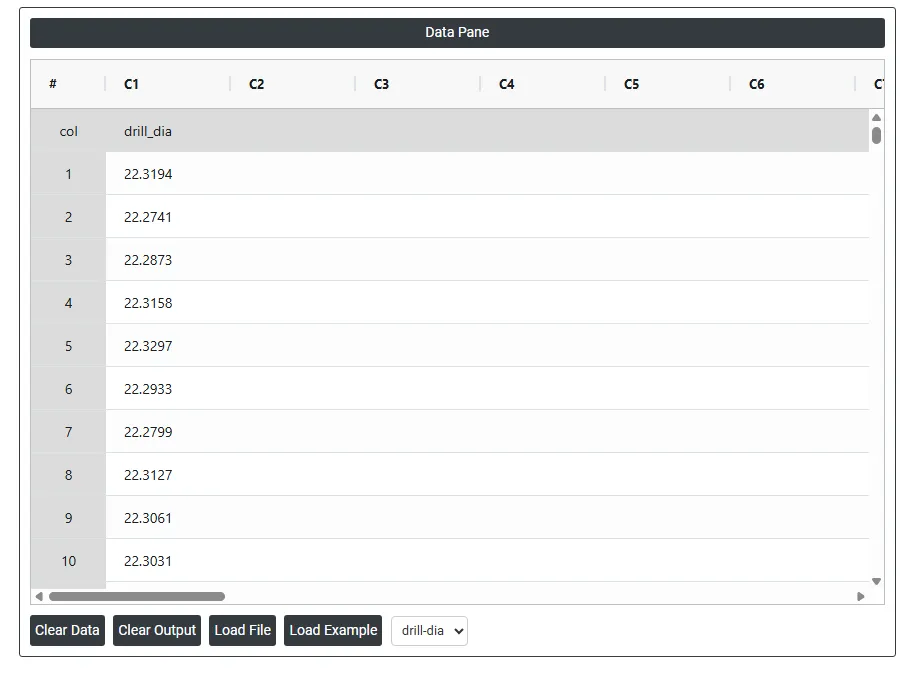
- Nun analysiert er die Daten in Zometric Statistical Software unter https://statsai.zometric.com/.
- Um die Prozessfähigkeit bei nicht normalverteilten Daten aufzurufen, wählen Sie Statistical module> Control Chart>Non-Normal Process Capability.
- Im Werkzeug gibt er die Daten zusammen mit den weiteren Eingaben wie folgt ein:
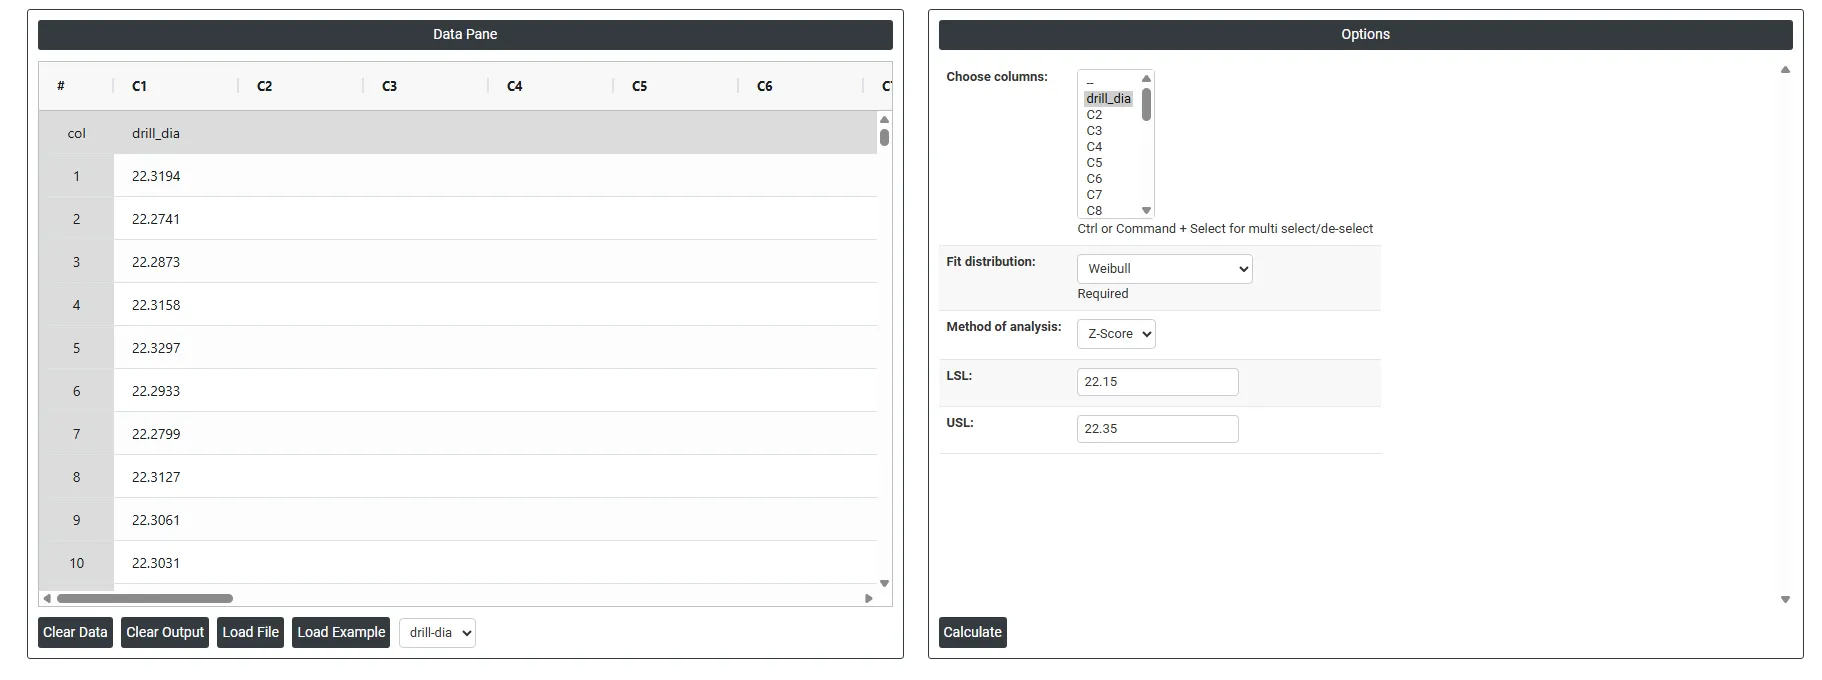
5. Nach Ausführung des oben genannten Werkzeugs erhält er folgende Ausgabe:
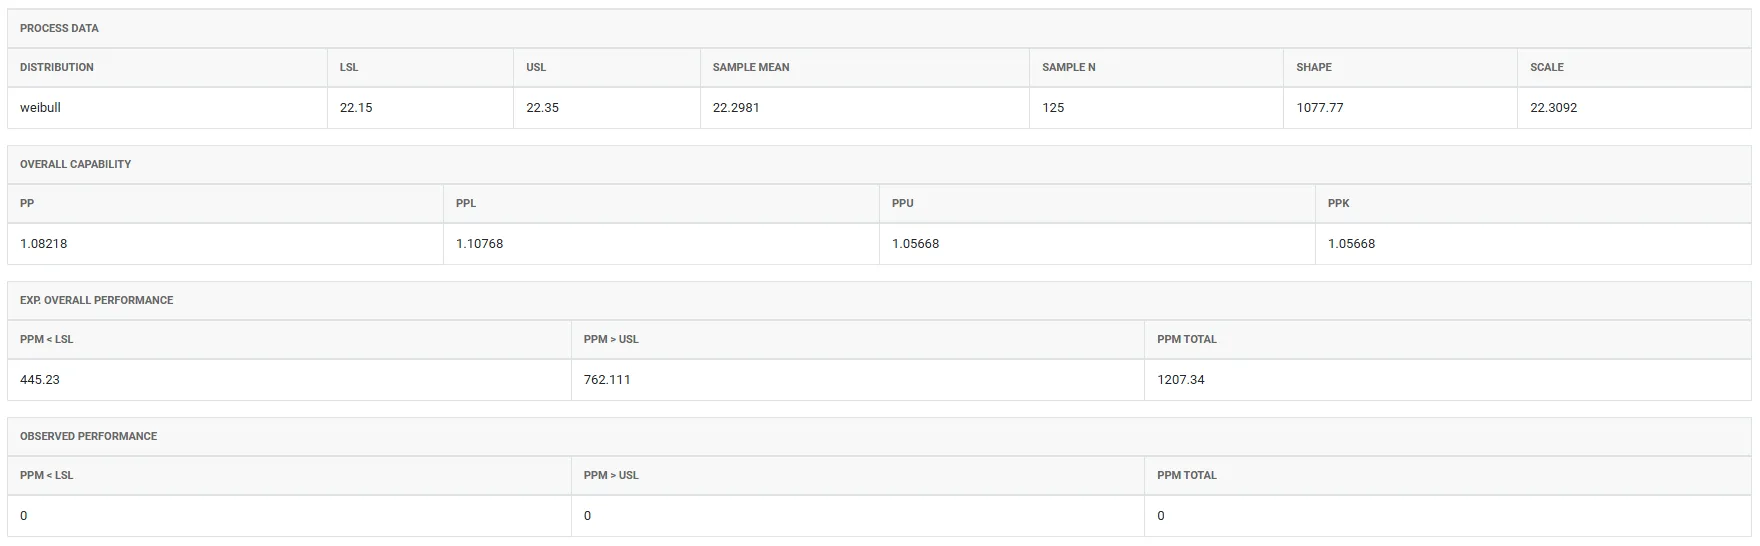
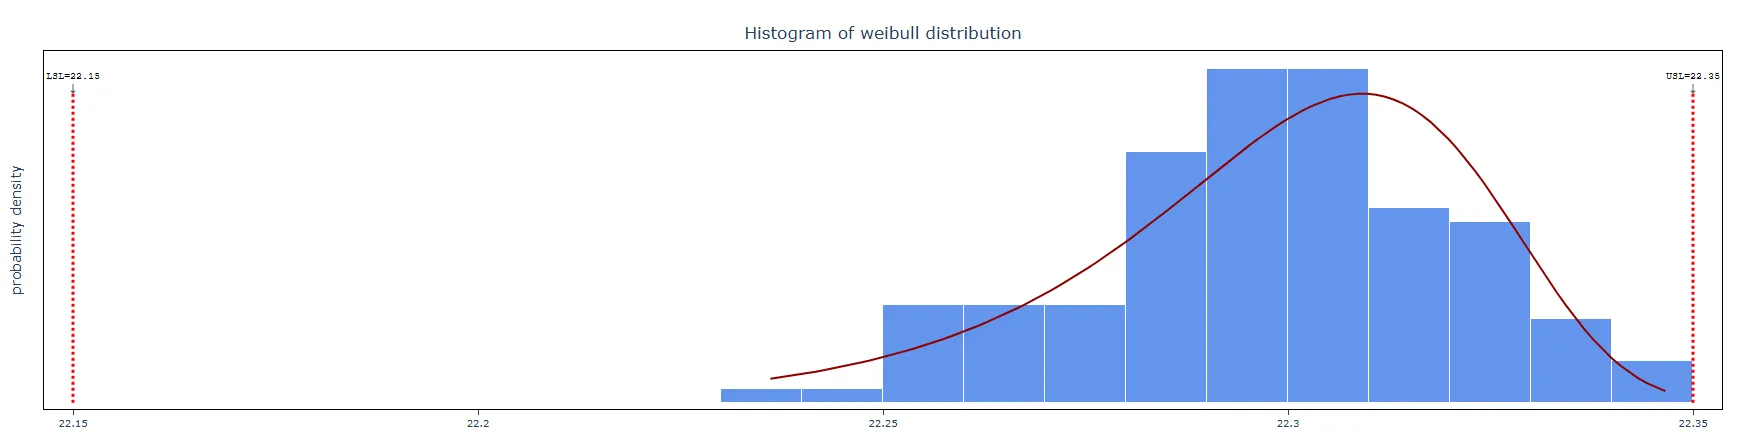
Anleitung: Prozessfähigkeit bei nicht normalverteilten Daten berechnen
So gehen Sie vor:
- Melden Sie sich bei Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Control Chart>Non-Normal Process Capability .
- Geben Sie die Daten anschließend manuell ein, oder kopieren Sie die Daten vollständig (Strg+C) aus einer Excel-Tabelle und fügen Sie sie hier ein (Strg+V).
- Füllen Sie die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Das Dashboard der Prozessfähigkeit bei nicht normalverteilten Daten ist in zwei Bereiche unterteilt.
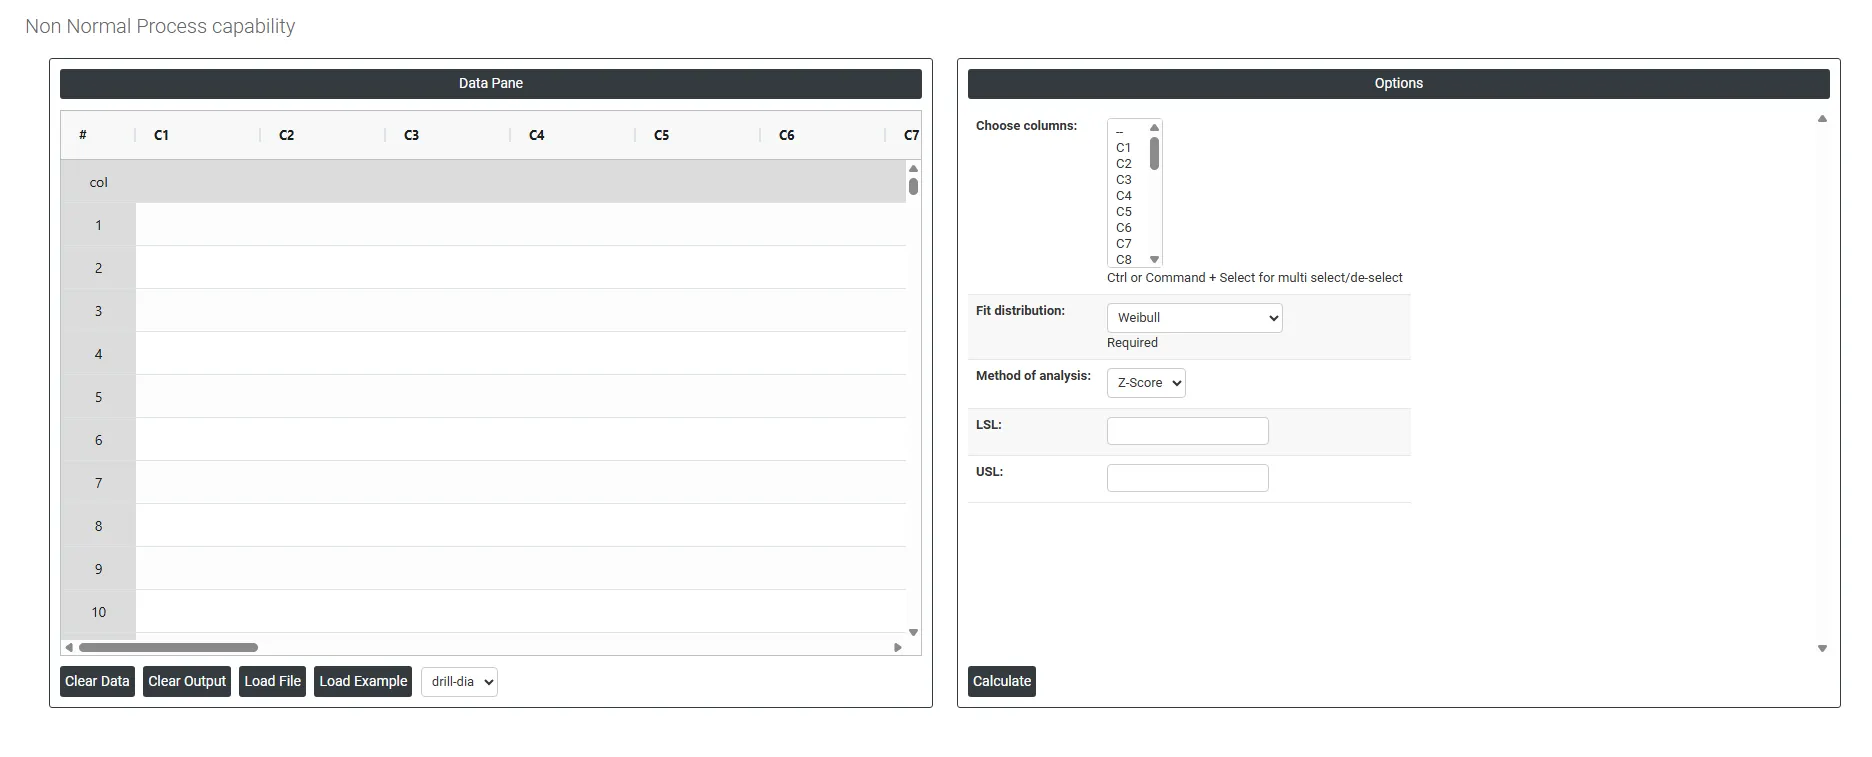
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile eine Teilgruppe. Die Daten können manuell eingegeben oder vollständig aus einer Excel-Tabelle kopiert (Strg+C) und hier eingefügt (Strg+V) werden.
Load example: Es werden Beispieldaten geladen.
Load File: Damit werden Excel-Daten direkt geladen.
Im rechten Bereich stehen folgende Optionen zur Verfügung:
- Choose Columns Wählen Sie die Spalte(n) mit Ihren stetigen Messdaten. Mit Strg- bzw. Command-Klick wählen Sie mehrere Spalten gleichzeitig aus. Dies sind die eigentlichen Prozessmesswerte, etwa Bohrungsdurchmesser, Zugfestigkeiten oder Zykluszeiten, deren Fähigkeit mit der gewählten nicht normalen Verteilung gegenüber den Spezifikationsgrenzen analysiert wird.
- Fit Distribution Wählen Sie die Verteilung, die die Form Ihrer Daten am besten beschreibt. Dies ist die wichtigste Einstellung der Analyse: Die Fähigkeitsindizes werden auf Grundlage der mathematischen Eigenschaften der gewählten Verteilung berechnet, sodass eine falsche Wahl zu ungenauen Ergebnissen führt. Führen Sie stets zuerst die Individual Distribution Identification durch, um zu bestätigen, welche Verteilung zu Ihren Daten passt, bevor Sie diese Auswahl treffen. Verfügbare Optionen und ihre typischen Anwendungsfälle:
- Weibull – häufig verwendet für Zuverlässigkeits-, Ermüdungslebensdauer- und Ausfallzeitdaten. Bildet rechtsschiefe Daten gut ab und ist eine der flexibelsten und am weitesten verbreiteten nicht normalen Verteilungen.
- Exponential – verwendet für Daten, die die Zeit zwischen unabhängigen zufälligen Ereignissen darstellen, etwa die Zeit zwischen Maschinenausfällen oder zwischen eingehenden Serviceanrufen. Setzt eine konstante Ausfallrate voraus.
- Logistic – in der Form der Normalverteilung ähnlich, aber mit stärkeren Rändern (Tails). Verwendet, wenn die Daten symmetrisch sind, aber mehr Extremwerte aufweisen, als bei einer Normalverteilung zu erwarten wären.
- Loglogistic – eine rechtsschiefe Verteilung für Überlebens- und Zuverlässigkeitsdaten, ähnlich der Lognormalverteilung, aber mit stärkeren Rändern. Geeignet für Ausfallzeiten oder einkommensähnliche Daten.
- Largest Extreme Value – modelliert die Verteilung des größten Werts in einer Stichprobe. Verwendet, wenn die Daten Spitzenwerte darstellen, etwa maximale Spannung, Hochwasserstände oder Höchsttemperaturen.
- Smallest Extreme Value – modelliert die Verteilung des kleinsten Werts in einer Stichprobe. Häufig verwendet für Mindestfestigkeiten oder kleinste beobachtete Messwerte.
- 2-Parameter Exponential – eine Erweiterung der Exponentialverteilung um einen Schwellenparameter, sodass die Verteilung bei einem anderen Wert als null beginnen kann. Nützlich, wenn Messwerte einen bestimmten Mindestwert nicht unterschreiten können.
- 3-Parameter Weibull – ergänzt die Weibull-Verteilung um einen Lage- (Schwellen-)Parameter, sodass die Verteilung an einem Punkt ungleich null beginnen kann. Nützlich, wenn unterhalb eines bekannten Mindestwerts keine Ausfälle oder Messwerte auftreten können.
- Gamma – eine flexible rechtsschiefe Verteilung, die häufig für Prozesszeiten, Wartezeiten, Niederschlagsmengen und andere positive, stetige, mäßig schiefe Messgrößen verwendet wird.
- Lognormal – verwendet, wenn der Logarithmus der Daten normalverteilt ist. Häufig bei chemischen Konzentrationen, Partikelgrößen, Reparaturzeiten und Finanzdaten, deren Werte streng positiv und rechtsschief sind.
- Method of Analysis Legt fest, wie die Fähigkeitskennzahlen und Spezifikationsgrenzen interpretiert und ausgegeben werden. Zwei Optionen stehen zur Verfügung:
- Z-Score – berechnet die Fähigkeit, indem die Spezifikationsgrenzen anhand der Perzentile der angepassten Verteilung in standardisierte Z-Werte umgerechnet werden. Damit wird die Fähigkeit darüber ausgedrückt, wie viele Standardabweichungen die Spezifikationsgrenzen von der Prozessmitte entfernt sind, sodass die Ergebnisse mit üblichen Fähigkeitsindizes für normalverteilte Daten wie Cp und Cpk vergleichbar sind.
- ISO – folgt der Methodik der Norm ISO 22514 für die Fähigkeitsanalyse nicht normalverteilter Daten. Diese Methode berechnet die Fähigkeitsindizes direkt aus den Perzentilen der Verteilung (konkret dem 0.135- und dem 99.865-Perzentil, die bei einer Normalverteilung den Grenzen ±3 Sigma entsprechen), ohne Umrechnung in Z-Werte. Dies ist die bevorzugte Methode, wenn die Einhaltung internationaler Qualitätsnormen gefordert ist.
- LSL (Lower Specification Limit) Der kleinste zulässige Wert der Messgröße. Jeder Datenpunkt unterhalb dieses Werts gilt als außerhalb der Spezifikation. Geben Sie die LSL aus Ihrer technischen Zeichnung, der Kundenanforderung oder der Produktspezifikation ein. Mindestens eine Spezifikationsgrenze (LSL oder USL) muss angegeben werden; bei zweiseitiger Spezifikation können beide eingegeben werden.
- USL (Upper Specification Limit) Der größte zulässige Wert der Messgröße. Jeder Datenpunkt oberhalb dieses Werts gilt als außerhalb der Spezifikation. Geben Sie die USL aus Ihrer technischen Zeichnung oder Produktspezifikation ein. Hat das Prozessmerkmal nur eine einseitige Anforderung, zum Beispiel eine Mindestfestigkeit ohne Obergrenze, muss nur die betreffende Grenze eingegeben werden.
Häufig gestellte Fragen
Was ist die Prozessfähigkeitsanalyse für nicht normalverteilte Daten?
Die Prozessfähigkeitsanalyse für nicht normalverteilte Daten misst, wie gut ein Prozess seine Spezifikationsgrenzen einhält, wenn die Daten keiner Normalverteilung folgen. Statt eine Normalverteilungsannahme aufzuzwingen, passt sie eine anerkannte Verteilung wie Weibull, Lognormal, Exponential oder Gamma an und berechnet die Fähigkeitsindizes aus der tatsächlichen Form dieser Verteilung.
Warum sollte man für nicht normalverteilte Daten nicht die üblichen Cp und Cpk verwenden?
Die üblichen Cp und Cpk setzen eine Normalverteilung voraus. Sind die Daten schief oder anderweitig nicht normalverteilt, werden diese Indizes ungenau und können die tatsächliche Prozessfähigkeit über- oder unterschätzen. Das richtige Verteilungsmodell liefert ein ehrlicheres und präziseres Bild davon, ob der Prozess beständig Produkte innerhalb der Spezifikation liefern kann.
Wie wählt man die richtige Verteilung für die Fähigkeitsanalyse nicht normalverteilter Daten?
Führen Sie zuerst die Individual Distribution Identification durch, um die am besten passende Verteilung zu finden, und überprüfen Sie sie dann mit Anpassungsgütestatistiken und Wahrscheinlichkeitsnetzen; ein hoher p-Wert und eine gerade Linie im Wahrscheinlichkeitsnetz zeigen eine gute Anpassung an. Die Wahl der falschen Verteilung führt zu irreführenden Fähigkeitsindizes. Passt keine Verteilung, verwenden Sie die nichtparametrische Prozessfähigkeit.
Was ist der Unterschied zwischen der Z-Score- und der ISO-Methode?
Die Z-Score-Methode rechnet die Spezifikationsgrenzen anhand der Perzentile der angepassten Verteilung in standardisierte Z-Werte um, sodass die Ergebnisse mit Cp und Cpk für normalverteilte Daten vergleichbar sind. Die ISO-Methode folgt ISO 22514, berechnet die Indizes direkt aus dem 0.135- und dem 99.865-Perzentil der angepassten Verteilung und wird bevorzugt, wenn die Einhaltung internationaler Normen gefordert ist.