
Nichtlineare Regression
Die nichtlineare Regression passt eine Kurve, deren Parameter nicht linear eingehen, an eine Zielgröße und einen Prädiktor an. Nutzen Sie sie, wenn Physik oder Chemie des Prozesses die Kurvenform vorgeben. Wählen Sie eine von sieben integrierten Funktionen oder eine eigene und geben Sie sinnvolle Startwerte an. Ausgabe: Parameterschätzungen mit Standardfehlern und Konfidenzintervallen, ein Diagramm der angepassten Kurve, eine Korrelationsmatrix und ein Test auf fehlende Anpassung.
Zuletzt geprüft
Kernaussage
Die nichtlineare Regression passt eine Kurve an, deren Parameter nichtlinear eingehen, etwa eine exponentielle Annäherung an einen Grenzwert, um Parameter wie Grenzwert oder Geschwindigkeitskonstante mit Konfidenzintervallen zu schätzen.
Auf dieser Seite
Zweck
Die nichtlineare Regression (Nonlinear Regression) passt eine Kurve, deren Parameter nicht linear eingehen, etwa eine exponentielle Annäherung an einen Grenzwert, eine Sättigungskurve oder eine S-förmige Wachstumskurve, an eine Zielgröße und einen Prädiktor an. Verwenden Sie sie, wenn Ihnen Physik oder Chemie des Prozesses die Form der Kurve vorgeben und Sie Schätzungen ihrer Parameter, etwa eines Grenzwerts oder einer Geschwindigkeitskonstante, mit Konfidenzintervallen erhalten möchten.
Wichtige Funktionen
- Sieben integrierte Erwartungsfunktionen: exponentieller Abfall, exponentielles Wachstum, Potenzfunktion, logistische Funktion mit 3 Parametern, Michaelis-Menten, Gompertz und quadratische Funktion.
- Benutzerdefinierte Erwartungsfunktion in X mit den Parametern b1, b2, … unter Verwendung von + − * / ^ sowie exp, log, ln, log10, sqrt, abs, sin, cos, tan, arctan.
- Anpassung mit Gauss-Newton, Levenberg-Marquardt oder Trust Region Reflective, mit eigenen Startwerten, Iterationsgrenze und Toleranz.
- Parameterschätzungen mit Standardfehlern und Konfidenzintervallen sowie deren Korrelationsmatrix.
- Diagramm der angepassten Kurve mit optionalen Konfidenz- und Vorhersagebändern.
- Test auf fehlende Anpassung (Lack of Fit), wenn der Prädiktor wiederholte Werte enthält.
- Optionale Gewichtungsspalte und Residuendiagramme.
Statistische Methoden
Das Werkzeug ermittelt die Parameterwerte θ, die die Fehlerquadratsumme SSE = Σ (yᵢ − f(xᵢ, θ))² minimieren, bzw. Σ wᵢ (yᵢ − f(xᵢ, θ))² bei einer Gewichtungsspalte. Levenberg-Marquardt (Standard) und Trust Region Reflective verwenden die Kleinste-Quadrate-Löser von SciPy; Gauss-Newton verwendet Schrittweitenhalbierung und gibt die Anzahl der Iterationen aus. Die Iteration endet, wenn die relative Änderung von SSE und der Parameter unter die Konvergenztoleranz fällt. Zeilen mit einem fehlenden Wert in Zielgröße, Prädiktor oder Gewichten werden verworfen.
Die Standardfehler stammen aus der linearen Approximation an der Lösung: Cov(θ) = MSE·(JᵀJ)⁻¹, wobei J die Matrix der Ableitungen von f nach den Parametern ist und MSE = SSE / (n − p) bei p Parametern; S = √MSE. Die Konfidenzintervalle sind θ ± t(1−α/2, n−p)·SE. Das Konfidenzband für die Kurve verwendet dieselbe Approximation; das Vorhersageband addiert MSE für einen einzelnen neuen Messwert. Diese Intervalle sind Näherungen und werden unzuverlässig, wenn die Parameter schlecht bestimmt sind, was sich in Korrelationen nahe ±1 in der Korrelationsmatrix zeigt.
Sind einige Prädiktorwerte wiederholt, wird die Fehlerquadratsumme in reinen Fehler (Streuung zwischen Wiederholungen) und fehlende Anpassung aufgeteilt, und F = MS lack-of-fit / MS pure error prüft, ob die gewählte Kurve passt. Die Startwerte sind wichtig: Integrierte Funktionen beginnen mit festen Standardwerten (zum Beispiel a = 1, b = 1 für Michaelis-Menten), wobei c bei der logistischen und der Gompertz-Kurve auf dem Median von X liegt; eine benutzerdefinierte Funktion benötigt einen Startwert je Parameter. Geben Sie Werte nahe an Ihren Erwartungen an, sonst kann die Anpassung scheitern oder ein schlechtes lokales Minimum finden.
Eingabefelder und Optionen
Feld | Beschreibung |
Response (Y) / Predictor (X) | Numerische Spalten; müssen verschieden sein. Erforderlich. |
Expectation function | Exponential decay y = a·exp(−b·x) (Standard), Exponential growth, Power y = a·x^b, Logistic (3-param), Michaelis-Menten y = a·x/(b + x), Gompertz, Quadratic oder User-defined expectation function. |
Expectation function (user-defined) | Wird bei der benutzerdefinierten Auswahl angezeigt. Formel in X mit den Parametern b1, b2, …, z. B. b1 * exp(-b2 * X). |
Weights (optional) | Spalte mit Gewichten für die gewichtete Methode der kleinsten Quadrate. |
Starting values (space-separated) | Ein Wert je Parameter, in der richtigen Reihenfolge. Optional für integrierte Funktionen (bei leerem Feld werden Standardwerte verwendet), erforderlich für eine benutzerdefinierte Funktion. |
Confidence level | Standard 95. |
Fitting algorithm | Gauss-Newton, Levenberg-Marquardt (Standard) oder Trust Region Reflective. |
Maximum number of iterations / Convergence tolerance | Standardwerte 200 und 1e-05. |
Display confidence interval on fitted curve / Display prediction interval on fitted curve | Fügt die Bänder zum Diagramm der angepassten Kurve hinzu. Standardmäßig deaktiviert. |
Histogram of residuals / Normal plot of residuals / Residuals versus fits / Residuals versus order / Four in one | Residuendiagramme; Four in one zeichnet alle vier zusammen. |
Residuals versus the variables | Stellt die Residuen gegen eine gewählte Spalte dar. |
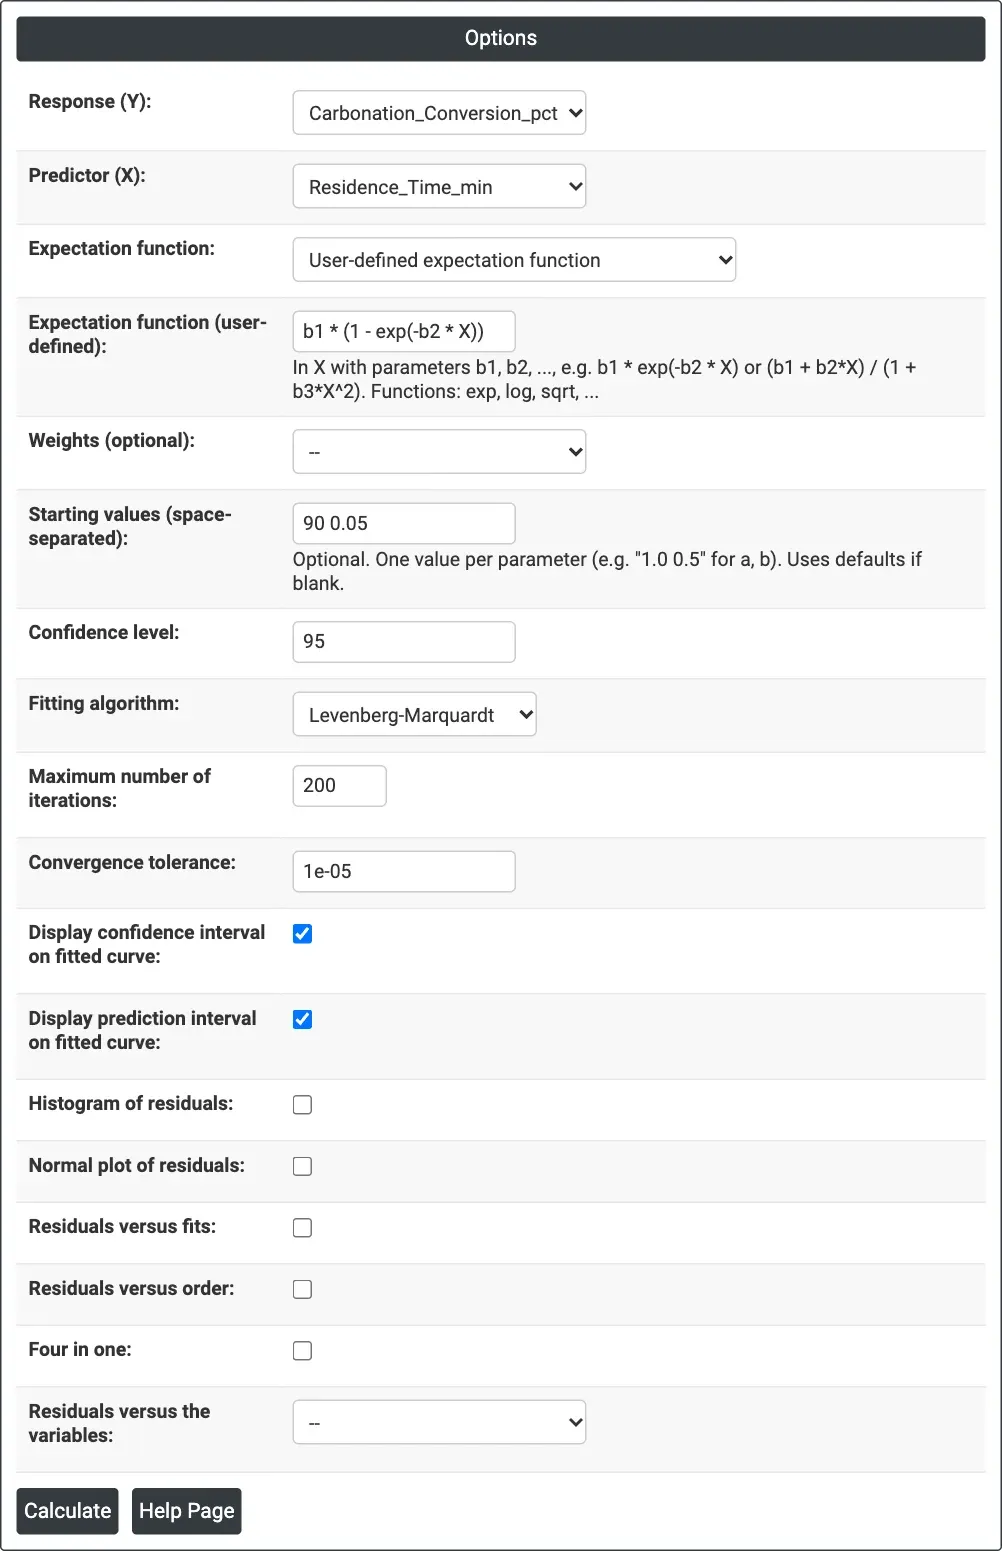
Abbildung 1 — Optionen für das Karbonisierungsbeispiel: benutzerdefinierte Funktion b1 * (1 - exp(-b2 * X)) mit den Startwerten 90 und 0.05, Konfidenz- und Vorhersageband aktiviert.
Beschreibung der Ausgaben
- Method — Algorithmus, maximale Iterationen, Toleranz und bei Gauss-Newton die benötigten Iterationen.
- Starting Values for Parameters — die Werte, mit denen die Anpassung begonnen hat.
- Regression Equation — die angepasste Kurve mit den Spaltennamen.
- Parameter Estimates — Estimate, SE Estimate und Konfidenzgrenzen für jeden Parameter.
- Summary of Fit — Final SSE, DFE, MSE und S.
- Fitted Line Plot — Daten, angepasste Kurve und optionale CI- und PI-Bänder.
- Correlation Matrix for Parameter Estimates (Korrelationsmatrix der Parameterschätzungen).
- Lack-of-Fit — Zeilen für Fehler, fehlende Anpassung und reinen Fehler mit F und P, wenn der Prädiktor wiederholte Werte enthält.
- Residuendiagramme, falls ausgewählt.
- PDF-Export über Download.
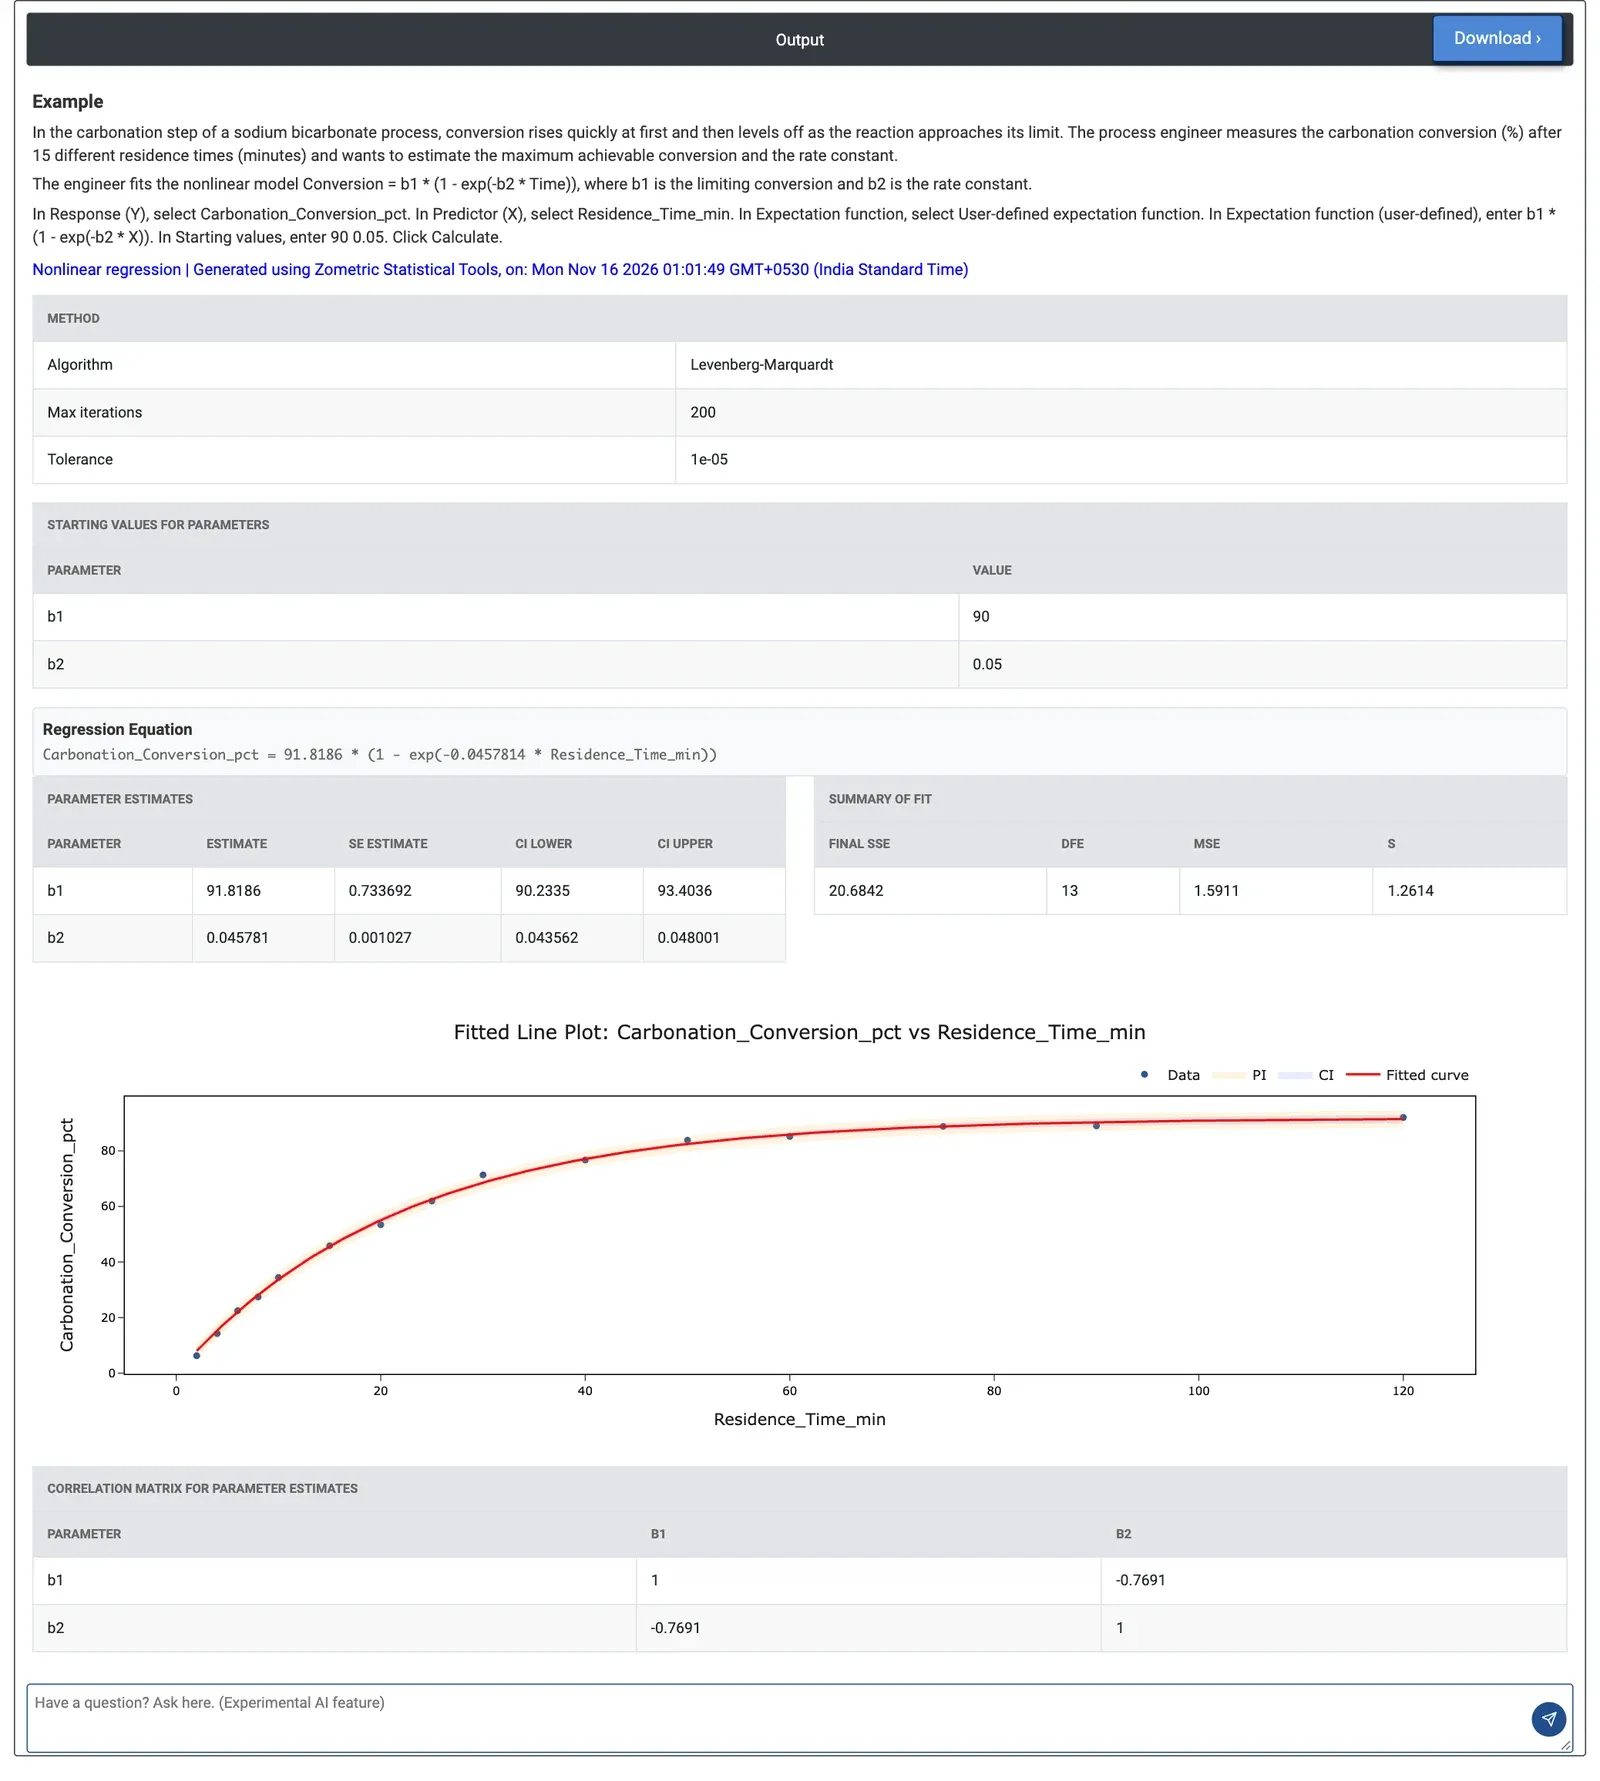
Abbildung 2 — Karbonisierungsumsatz gegen Verweilzeit: Grenzumsatz b1 = 91.82 % und Geschwindigkeitskonstante b2 = 0.0458 pro Minute, S = 1.26.
Beispiel
Im Karbonisierungsschritt eines Natriumhydrogencarbonat-Prozesses steigt der Umsatz zunächst schnell an und flacht dann ab. Ein Verfahrensingenieur misst den Umsatz (%) bei 15 Verweilzeiten von 2 bis 120 Minuten und möchte den Grenzumsatz und die Geschwindigkeitskonstante bestimmen. Er gibt das Modell erster Ordnung Conversion = b1·(1 − exp(−b2·Time)) als benutzerdefinierte Funktion ein, gibt die Startwerte 90 und 0.05 an und aktiviert beide Bänder.
Die Anpassung konvergiert zu b1 = 91.82 % (95-%-KI 90.23 bis 93.40) und b2 = 0.0458 pro Minute (95-%-KI 0.0436 bis 0.0480). S beträgt 1.26 Prozentpunkte, wenig im Vergleich zu einem Bereich von 6 bis 92 %, und die Punkte liegen über die gesamte Länge auf der Kurve. Die Korrelation zwischen b1 und b2 beträgt −0.77: mäßig, sodass beide Parameter gut bestimmt sind. Gauss-Newton liefert dieselben Schätzungen in 3 Iterationen. Da keine Verweilzeiten wiederholt sind, wird kein Test auf fehlende Anpassung angezeigt.
Laut angepasster Kurve werden 90 % des Grenzumsatzes bei ln(10)/b2 ≈ 50 Minuten und 95 % bei etwa 65 Minuten erreicht; nach 30 Minuten beträgt der Umsatz erst etwa 69 %. Verweilzeiten deutlich über einer Stunde bringen kaum zusätzlichen Umsatz, was dem Ingenieur hilft, den Durchsatz des Turms festzulegen.
Häufig gestellte Fragen
Was ist nichtlineare Regression?
Die nichtlineare Regression passt eine Kurve, deren Parameter nicht linear eingehen, etwa eine exponentielle Annäherung an einen Grenzwert, eine Sättigungskurve oder eine S-förmige Wachstumskurve, an eine Zielgröße und einen Prädiktor an. Sie ermittelt die Parameterwerte, die die Fehlerquadratsumme minimieren, und gibt sie mit Standardfehlern und Konfidenzintervallen aus.
Wann sollte man nichtlineare Regression verwenden?
Verwenden Sie die nichtlineare Regression, wenn Ihnen Physik oder Chemie des Prozesses die Form der Kurve vorgeben und Sie Schätzungen ihrer Parameter, etwa eines Grenzwerts oder einer Geschwindigkeitskonstante, erhalten möchten. Integrierte Formen sind exponentieller Abfall und exponentielles Wachstum, Potenzfunktion, logistische Funktion mit 3 Parametern, Michaelis-Menten, Gompertz und quadratische Funktion; alternativ können Sie eine eigene Funktion definieren.
Warum sind Startwerte bei der nichtlinearen Regression wichtig?
Die Anpassung ist iterativ und beginnt daher bei Startwerten. Integrierte Funktionen verwenden feste Standardwerte, während eine benutzerdefinierte Funktion einen Startwert je Parameter benötigt. Werte nahe an Ihren Erwartungen helfen der Anpassung zu konvergieren; schlechte Startwerte können die Anpassung scheitern lassen oder zu einem schlechten lokalen Minimum führen.
Woran erkennt man, ob eine nichtlineare Regression verlässlich ist?
Prüfen Sie S und wie eng die Punkte der Kurve folgen, und sehen Sie sich die Residuendiagramme an. Die Konfidenzintervalle sind Näherungen und werden unzuverlässig, wenn Parameter schlecht bestimmt sind, was sich in Korrelationen nahe plus oder minus 1 in der Korrelationsmatrix der Parameter zeigt. Sind Prädiktorwerte wiederholt, prüft ein F-Test auf fehlende Anpassung, ob die gewählte Kurve passt.