
OECD-Entscheidungsbaum (OECD)
Das Werkzeug OECD Statistical Decision Tree ist ein geführtes statistisches Analysesystem, das auf dem Entscheidungsrahmen zur Auswahl und Anwendung des richtigen statistischen Tests für Versuchsdaten beruht. Statt dass Anwender sich selbst durch komplexe statistische Theorie arbeiten müssen, folgt das Werkzeug automatisch dem OECD-Entscheidungspfad, bewertet in jeder Stufe Datentyp, Normalität, Varianzhomogenität und Gruppenanzahl und wendet den passenden Test an.
Zuletzt geprüft
Kernaussage
Das Werkzeug OECD Statistical Decision Tree ist ein geführtes statistisches Analysesystem auf Basis des Entscheidungsrahmens zur Auswahl und Anwendung des richtigen statistischen Tests für Versuchsdaten.
Auf dieser Seite
- Was ist OECD?
- Wann wird OECD eingesetzt?
- Schritt 1 – Beurteilung des Datentyps
- Schritt 2 – Normalitätsprüfung (stetige Daten)
- Schritt 3 – Parametrischer Pfad
- Schritt 4 – Nichtparametrischer Pfad
- Hinweise zur richtigen Anwendung von OECD
- Alternativen: Wann Sie OECD nicht verwenden sollten
- Beispiel für OECD
- Anleitung: OECD durchführen
Was ist OECD?
Das Werkzeug OECD Statistical Decision Tree ist ein geführtes statistisches Analysesystem, das auf dem Entscheidungsrahmen zur Auswahl und Anwendung des richtigen statistischen Tests für Versuchsdaten beruht. Statt dass Anwender sich selbst durch komplexe statistische Theorie arbeiten müssen, folgt das Werkzeug automatisch dem OECD-Entscheidungspfad, bewertet in jeder Stufe Datentyp, Normalität, Varianzhomogenität und Gruppenanzahl und wendet den passenden Test an.
Das Werkzeug soll sicherstellen, dass statistische Schlussfolgerungen wissenschaftlich gültig, vollständig reproduzierbar und mit international anerkannten Richtlinien konform sind. Das ist besonders wichtig in der Toxikologie, den Umweltwissenschaften, der pharmazeutischen Forschung und bei Studien für Zulassungsanträge, in denen die Wahl des statistischen Tests dokumentiert, begründet und bei einem Audit vertretbar sein muss.
Einfache Definition: Ein intelligentes, automatisiertes Werkzeug, das dem statistischen OECD-Entscheidungsflussdiagramm Schritt für Schritt folgt, Datentyp, Verteilung und Gruppenstruktur Ihrer Daten bewertet und automatisch den richtigen statistischen Test auswählt und anwendet, sodass Sie stets ein gültiges und vertretbares Ergebnis erhalten.
Wann wird OECD eingesetzt?
- Der Ansatz mit dem OECD-Flussdiagramm wird eingesetzt, wenn Sie eine vollständige statistische Vergleichskette in einem Durchgang ausführen möchten, statt Test für Test unterwegs zu entscheiden. Statt nach jedem Test anzuhalten und zu überlegen, was als Nächstes kommt, geben Sie die Eigenschaften Ihrer Daten vorab ein – Datentyp, Ergebnis der Normalitätsprüfung, Ergebnis der Varianzprüfung –, und der gesamte Entscheidungsbaum wird auf einmal durchlaufen.
- Er ist in erster Linie ein Vergleichsrahmen : Er ist speziell dafür ausgelegt, zu bestimmen, welcher statistische Test beim Vergleich von Gruppen (2 Gruppen oder 3+ Gruppen) untereinander oder mit einer Kontrolle geeignet ist. Statt Test für Test bei jedem Schritt zu entscheiden, geben Sie die Eigenschaften Ihrer Daten vorab ein. Hauptsächlich eingesetzt im Bereich Pharma.
Das Werkzeug folgt dem OECD-Flussdiagramm in einer strengen logischen Reihenfolge. Jeder Schritt liefert eine Entscheidung, die bestimmt, welchem Zweig des Pfads als Nächstes gefolgt wird. Wenn Sie diesen Ablauf verstehen, können Sie die Ausgaben des Werkzeugs interpretieren und nachvollziehen, warum für Ihre Daten ein bestimmter statistischer Test gewählt wurde.
Schritt 1 – Beurteilung des Datentyps
Der erste Entscheidungspunkt bestimmt, ob Ihre Daten stetig oder diskret/quantal sind. Diese Unterscheidung steuert den gesamten weiteren Pfad.
Datentyp
Beschreibung und Beispiele
Stetige Daten
Gemessene numerische Werte, die jeden Wert innerhalb eines Bereichs annehmen können, etwa Körpergewicht, Enzymaktivität, Organgewicht, Konzentration oder hämatologische Parameter. Bei stetigen Daten fährt das Werkzeug mit einer Normalitätsprüfung fort.
Diskrete oder quantale Daten
Zählwerte, Prozentsätze, Anteile, Rangfolgen oder kategoriale Ergebnisse, etwa die Anzahl betroffener Tiere, die Inzidenz einer Läsion, das Vorhandensein oder Fehlen einer Reaktion oder Schweregrad-Scores. Das Werkzeug geht direkt zur Auswahl eines nichtparametrischen oder kategorialen Tests über.
Schritt 2 – Normalitätsprüfung (stetige Daten)
Bei stetigen Daten prüft das Werkzeug mit den ausgewählten Tests auf Normalverteilung, ob die Daten einer Normalverteilung (Glockenkurve) folgen. Das Ergebnis bestimmt, welchem statistischen Pfad gefolgt wird.
Wird die Normalität NICHT verworfen (p ≥ α) – die Daten sind normalverteilt:
→ Das Werkzeug folgt dem parametrischen Pfad.
→ Parametrische Tests haben eine höhere Trennschärfe und sollten immer verwendet werden, wenn die Normalität bestätigt ist.
Wird die Normalität verworfen (p < α) – die Daten sind nicht normalverteilt:
→ Es wird eine Datentransformation versucht (Logarithmus, Quadratwurzel usw.).
→ Die Normalität wird an den transformierten Daten erneut geprüft.
→ Sind die transformierten Daten normalverteilt → werden parametrische Tests auf die transformierten Daten angewendet.
→ Sind die transformierten Daten weiterhin nicht normalverteilt → wechselt das Werkzeug zum nichtparametrischen Pfad.
Schritt 3 – Parametrischer Pfad
Sobald die Daten als normalverteilt bestätigt (oder erfolgreich in eine Normalverteilung transformiert) sind, bestimmt das Werkzeug den geeigneten parametrischen Test anhand der Anzahl der verglichenen Gruppen.
Vergleich von 2 Gruppen
Das Werkzeug prüft die Varianzhomogenität mit dem F-Test, um festzustellen, ob die beiden Gruppen statistisch gleiche Varianzen haben.
Ergebnis der Varianzhomogenität
Angewandter statistischer Test
Varianzen gleich (F-Test nicht signifikant)
Es wird der t-Test nach Student angewendet. Dies ist der Standard-t-Test für zwei Stichproben, der gleiche Varianzen in beiden Gruppen voraussetzt.
Varianzen ungleich (F-Test signifikant)
Es wird die Methode nach Satterthwaite (Welch-t-Test) angewendet. Diese Variante setzt keine gleichen Varianzen voraus und passt die Freiheitsgrade entsprechend an.
Vergleich von 3 oder mehr Gruppen
Das Werkzeug prüft die Varianzhomogenität mit dem Bartlett-Test, dem Levene-Test oder dem Brown-Forsythe-Test.
Ergebnis der Varianzhomogenität
Angewandter statistischer Test
Varianzen gleich (nicht signifikant)
Es wird eine Varianzanalyse (ANOVA) angewendet. → Ist die ANOVA signifikant: Der Dunnett-Test wird für den paarweisen Vergleich jeder Behandlungsgruppe mit der Kontrolle durchgeführt. → Ist die ANOVA nicht signifikant: Es sind keine weiteren Tests erforderlich. Ende.
Varianzen ungleich (signifikant)
Das Werkzeug geht direkt zum passenden Test über, der keine Varianzhomogenität voraussetzt.
Schritt 4 – Nichtparametrischer Pfad
Lassen sich die Daten nicht in eine Normalverteilung überführen oder bestehen sie aus Zählwerten, Prozentsätzen oder Rängen, folgt das Werkzeug dem nichtparametrischen Pfad.
Datensituation
Angewandter Test
Ergebnis / Folgeschritt
Zähl-/Prozent-/Rangdaten, ≥ 3 Gruppen
Kruskal-Wallis-Test
Wenn signifikant → Dunn-Test (Post-hoc). Wenn nicht signifikant → Ende.
Zähl-/Prozent-/Rangdaten, 2 Gruppen
Mann-Whitney-U-Test
Direkter Vergleich zweier unabhängiger Gruppen.
Kategoriale Daten oder Indexdaten
Chi-Quadrat
Die Testauswahl hängt von der konkreten Datenstruktur und dem Studiendesign ab.
Hinweise zur richtigen Anwendung von OECD
- Stellen Sie sicher, dass die Daten korrekt und einheitlich eingegeben werden: Eingabefehler bei der Dateneingabe pflanzen sich durch jede nachfolgende Entscheidung im Baum fort und können dazu führen, dass ein falscher Test angewendet wird.
- Wählen Sie die Zielgrößen-Spalten sorgfältig aus: Sind mehrere Zielgrößen ausgewählt, muss jede Spalte einen vollständigen, unabhängigen Gruppendatensatzdarstellen. Ist eine einzelne Zielgröße ausgewählt, stellen Sie sicher, dass die Faktorspalte die Gruppenzugehörigkeit jeder Beobachtung korrekt und vollständig angibt.
- Lassen Sie sowohl den Anderson-Darling- als auch den Shapiro-Wilk- Test auf Normalverteilung aktiviert (Standard). Bestätigen zwei unabhängige Tests dieselbe Schlussfolgerung zur Normalität, stärkt das die wissenschaftliche Vertretbarkeit des gewählten Pfads.
Alternativen: Wann Sie OECD nicht verwenden sollten
- Wenn Ihre Studie keine Konformität mit OECD-Richtlinien erfordert und keinen regulatorischen Kontext hat, verwenden Sie direkt den am besten geeigneten spezifischen statistischen Test – der OECD-Entscheidungsbaum bringt einen strukturierten Mehraufwand mit sich, der für rein explorative oder akademische Analysen unnötig sein kann.
- Wenn Ihre Studie Regression, Korrelationsanalyse oder Dosis-Wirkungs-Modellierung statt eines einfachen Gruppenvergleichs erfordert, verwenden Sie die passenden Regressions- oder Modellierungswerkzeuge – das OECD-Werkzeug ist speziell für den Vergleich von Gruppenmittelwerten ausgelegt, nicht für die Anpassung von Zusammenhängen zwischen stetigen Variablen.
- Wenn Sie gepaarte Beobachtungen haben, zum Beispiel Vorher-Nachher-Messungen am selben Objekt, verwenden Sie den gepaarten t-Test oder den Wilcoxon-Vorzeichen-Rang-Test. Der hier implementierte OECD-Entscheidungsbaum setzt unabhängige Gruppen voraus.
- Wenn die Daten Zeitreihen- oder Längsschnittcharakter haben, bei dem sich die Messwerte über mehrere aufeinanderfolgende Zeitpunkte entwickeln, verwenden Sie eine ANOVA mit Messwiederholung, gemischte Modelle oder eine Zeitreihenanalyse
- Ist das primäre Analyseziel ein Äquivalenztest oder eine Nichtunterlegenheitsbewertung statt des Nachweises eines Unterschieds, verwenden Sie spezielle Verfahren für Äquivalenztests statt des üblichen Überlegenheitsrahmens des OECD-Entscheidungsbaums.
Beispiel für OECD
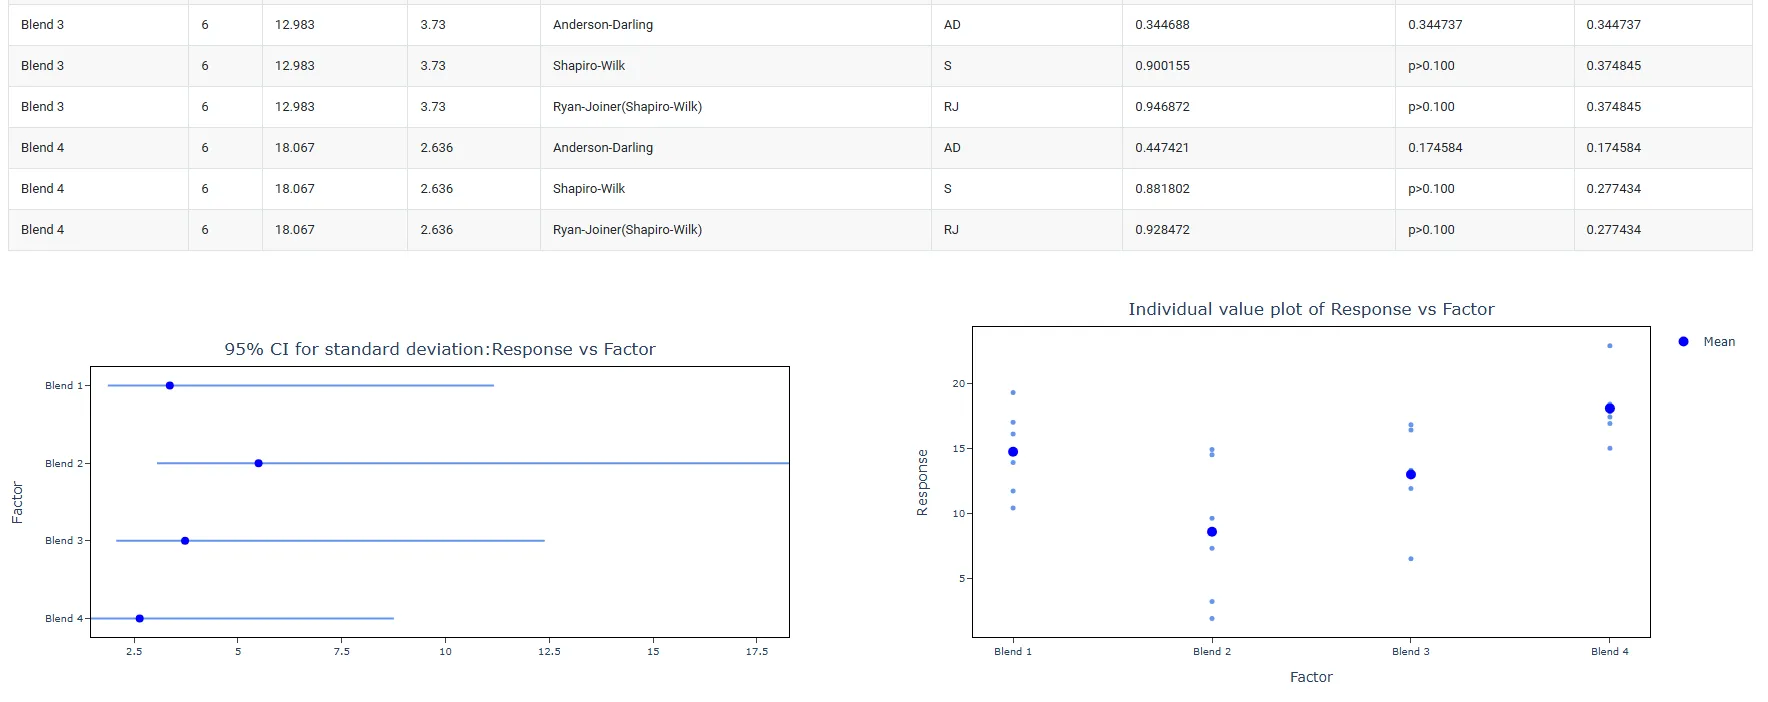
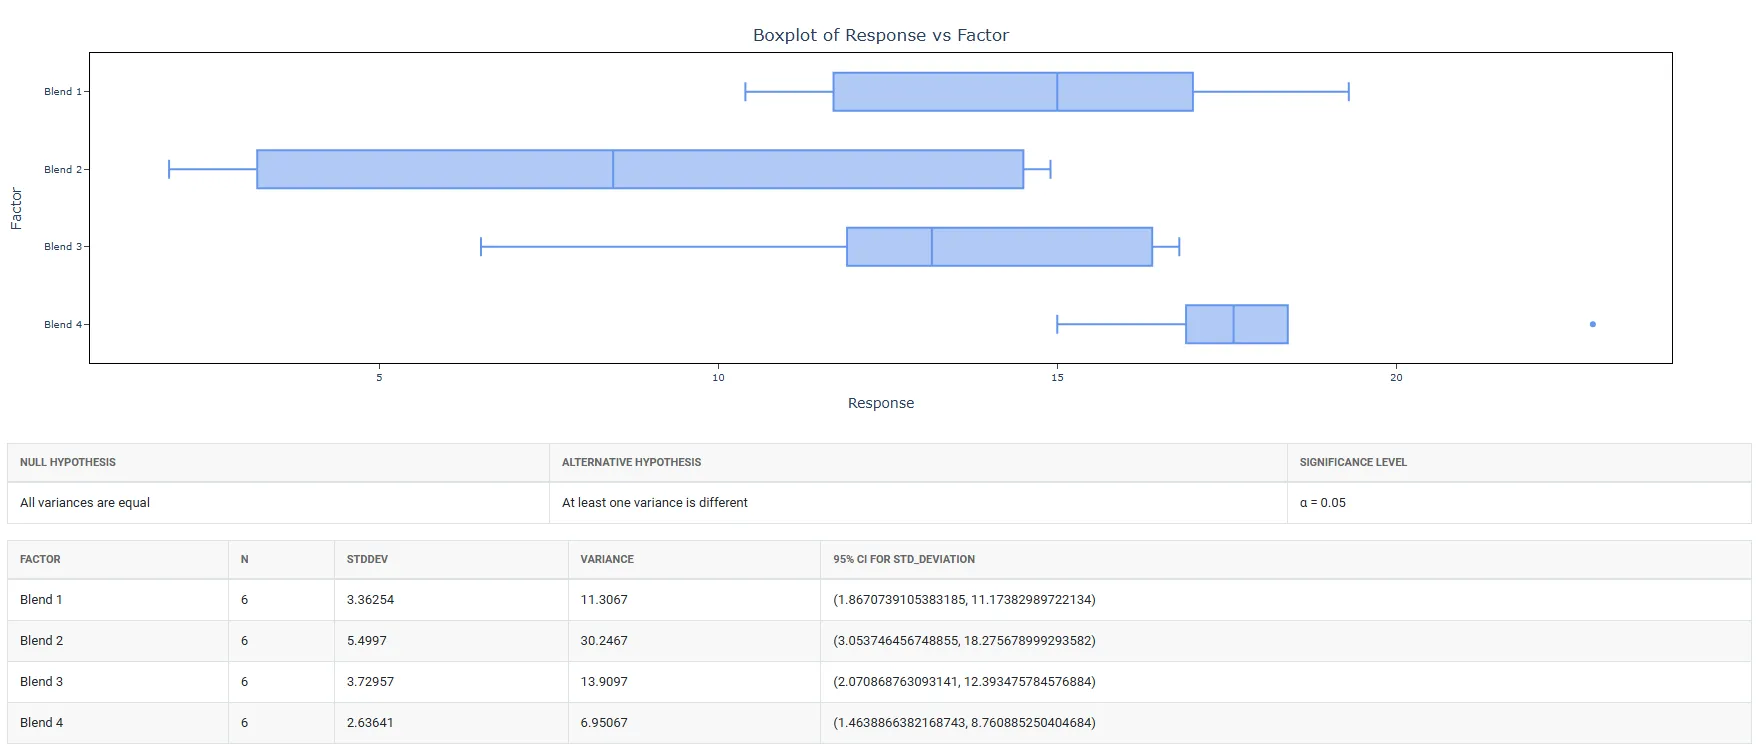
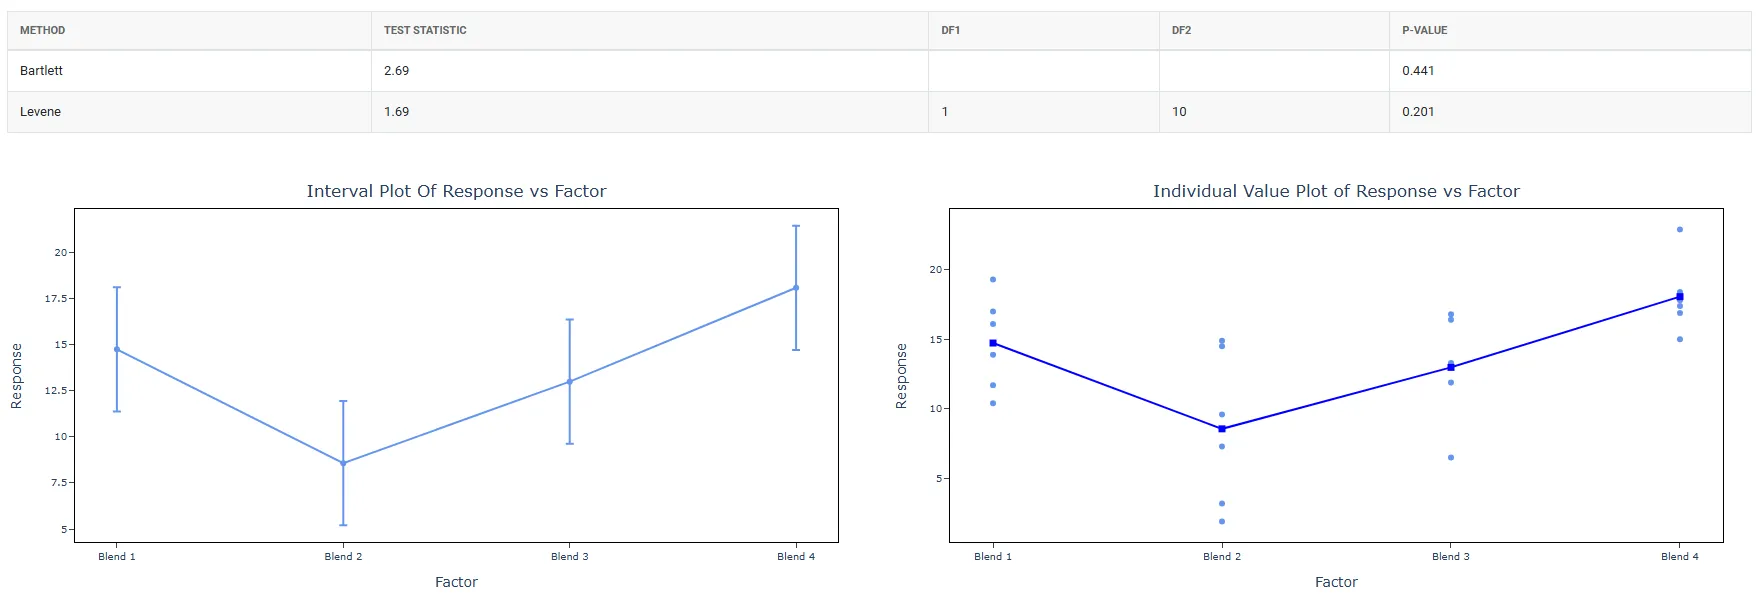
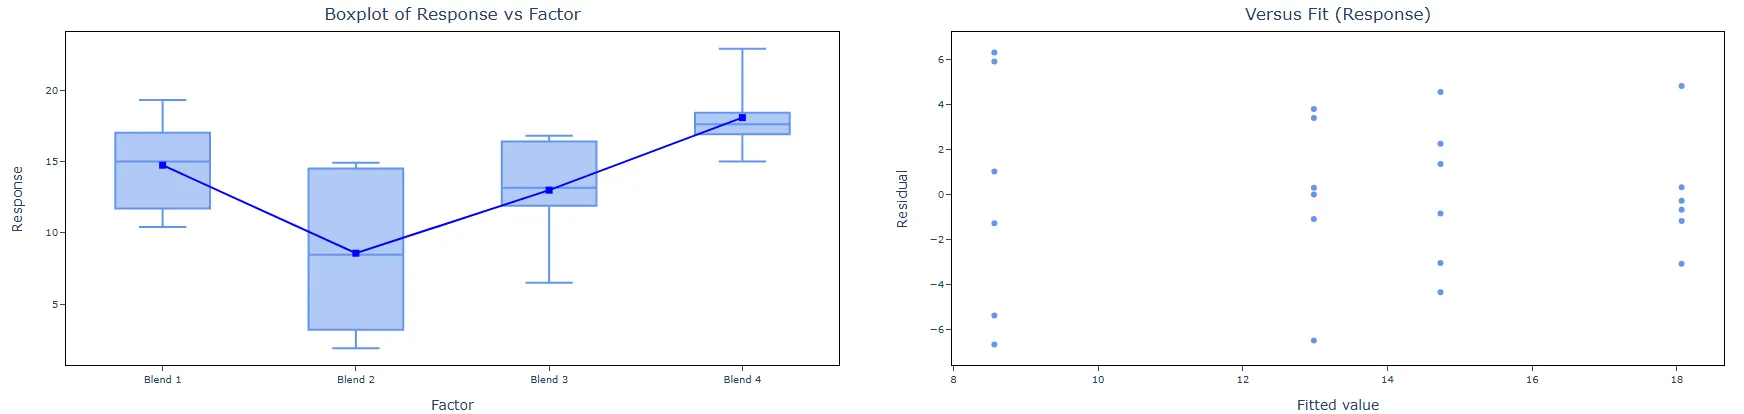
Ein Chemieingenieur möchte die Härte von vier Lackmischungen vergleichen. Von jeder Lackmischung wurden sechs Proben auf ein Metallstück aufgetragen, das anschließend ausgehärtet wurde. Danach wurde die Härte jeder Probe gemessen. Die Schritte:
- Die erforderlichen Daten wurden erhoben.
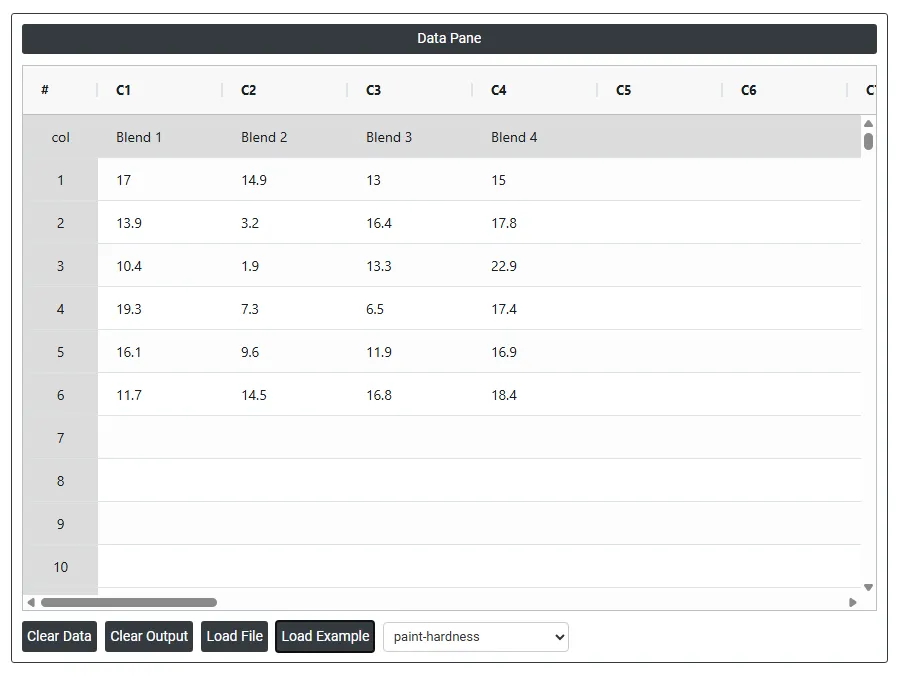
2. Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
3. OECD finden Sie unter Statistical module> OECD>OECD.
4. Geben Sie im Werkzeug die Daten zusammen mit den weiteren Eingaben wie folgt ein:
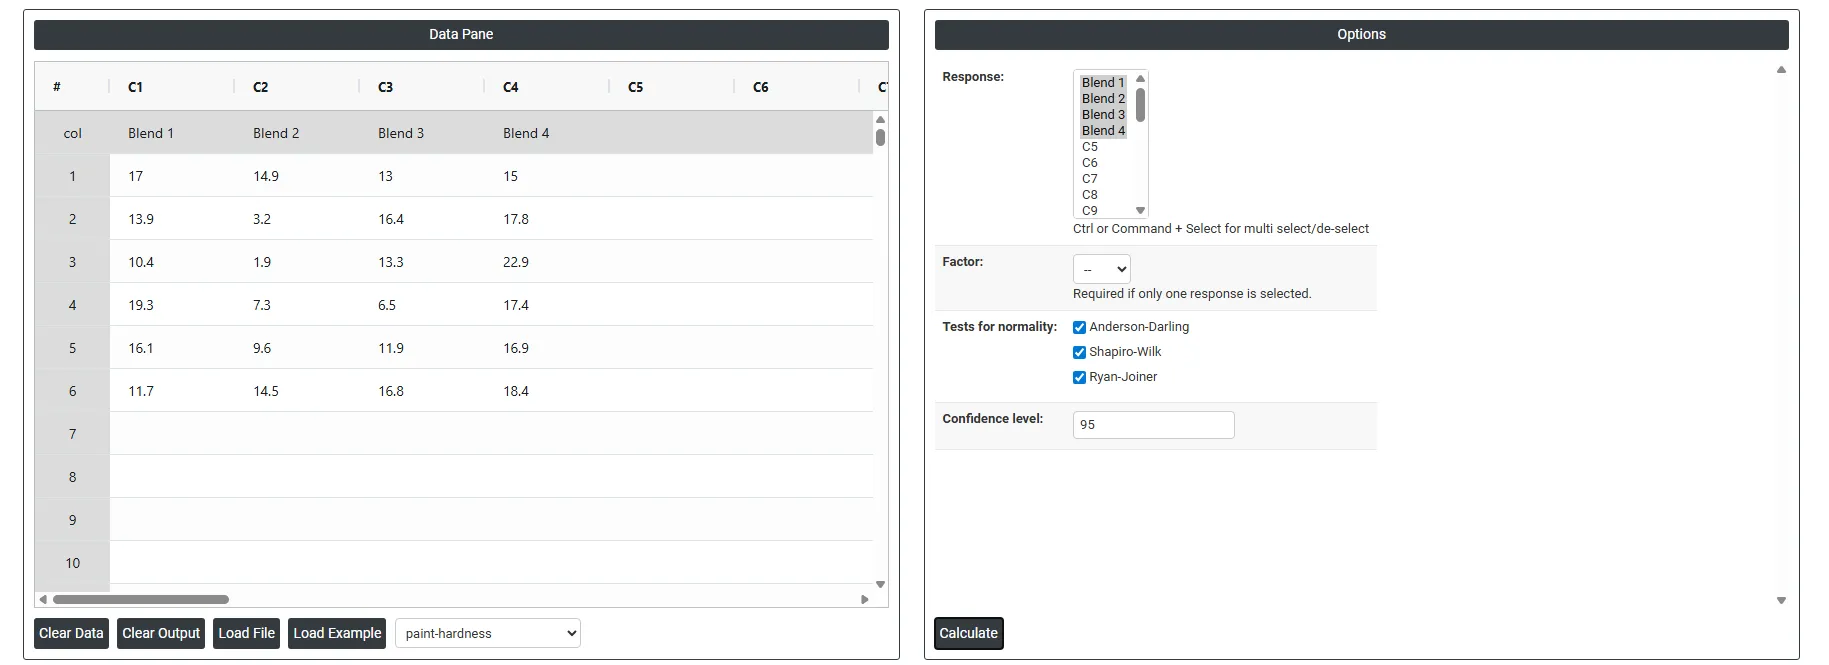
5. Nach Ausführung des oben genannten Werkzeugs erhalten Sie folgende Ausgabe:
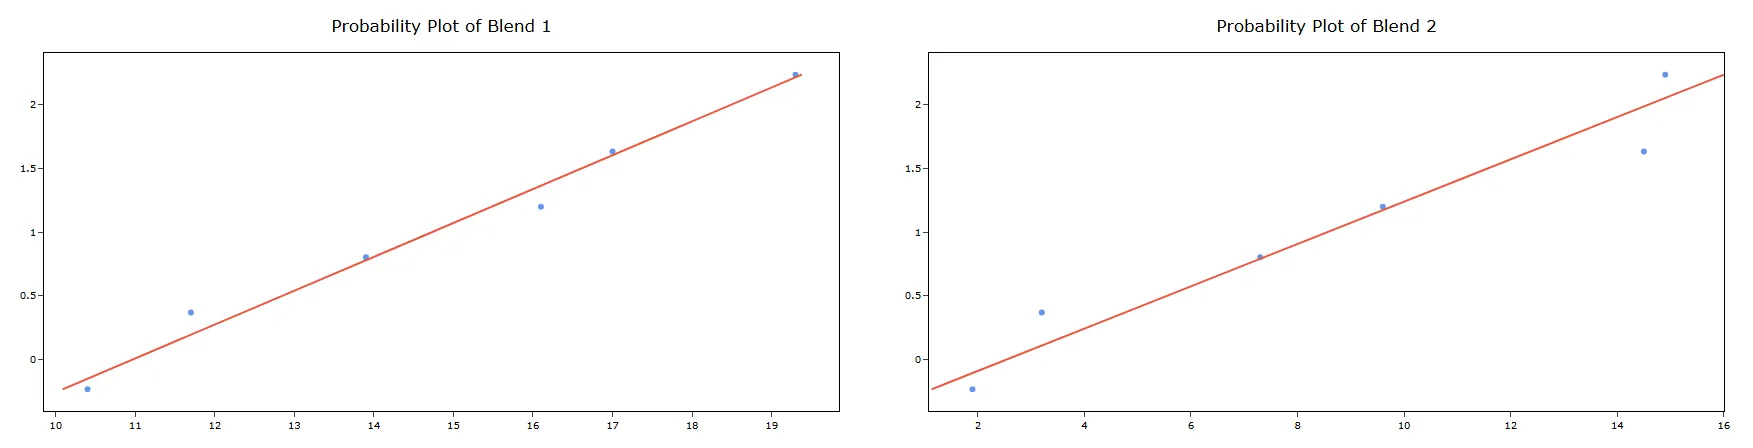
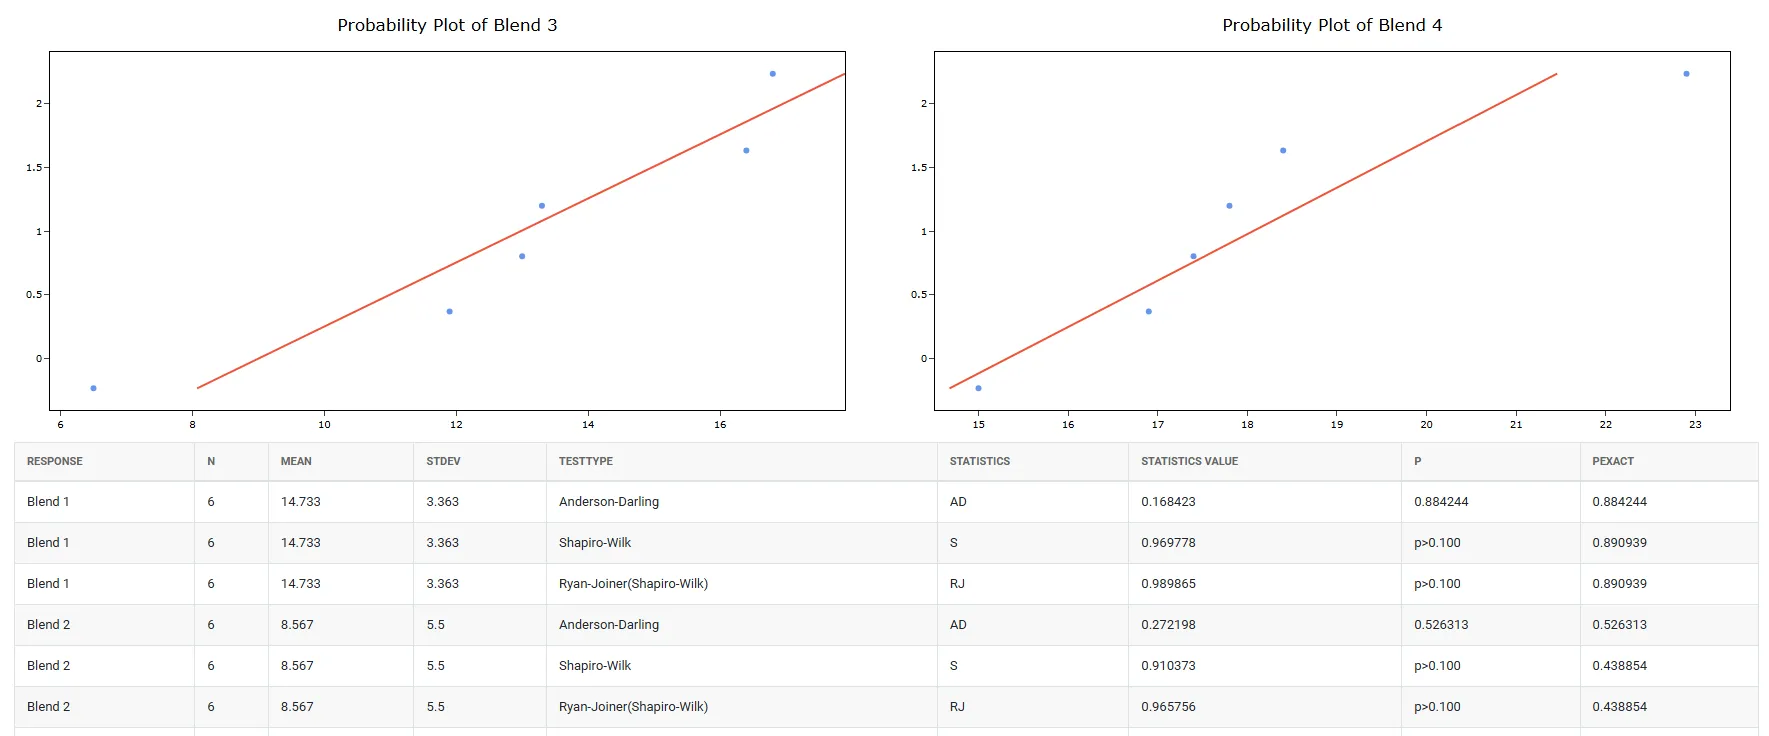
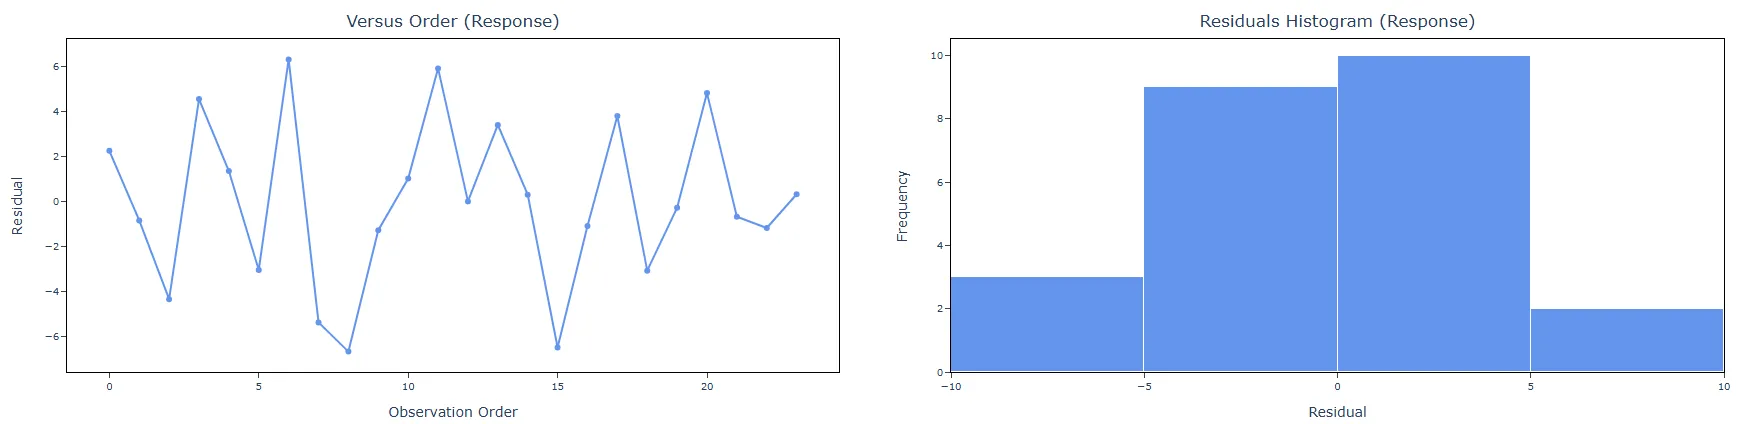
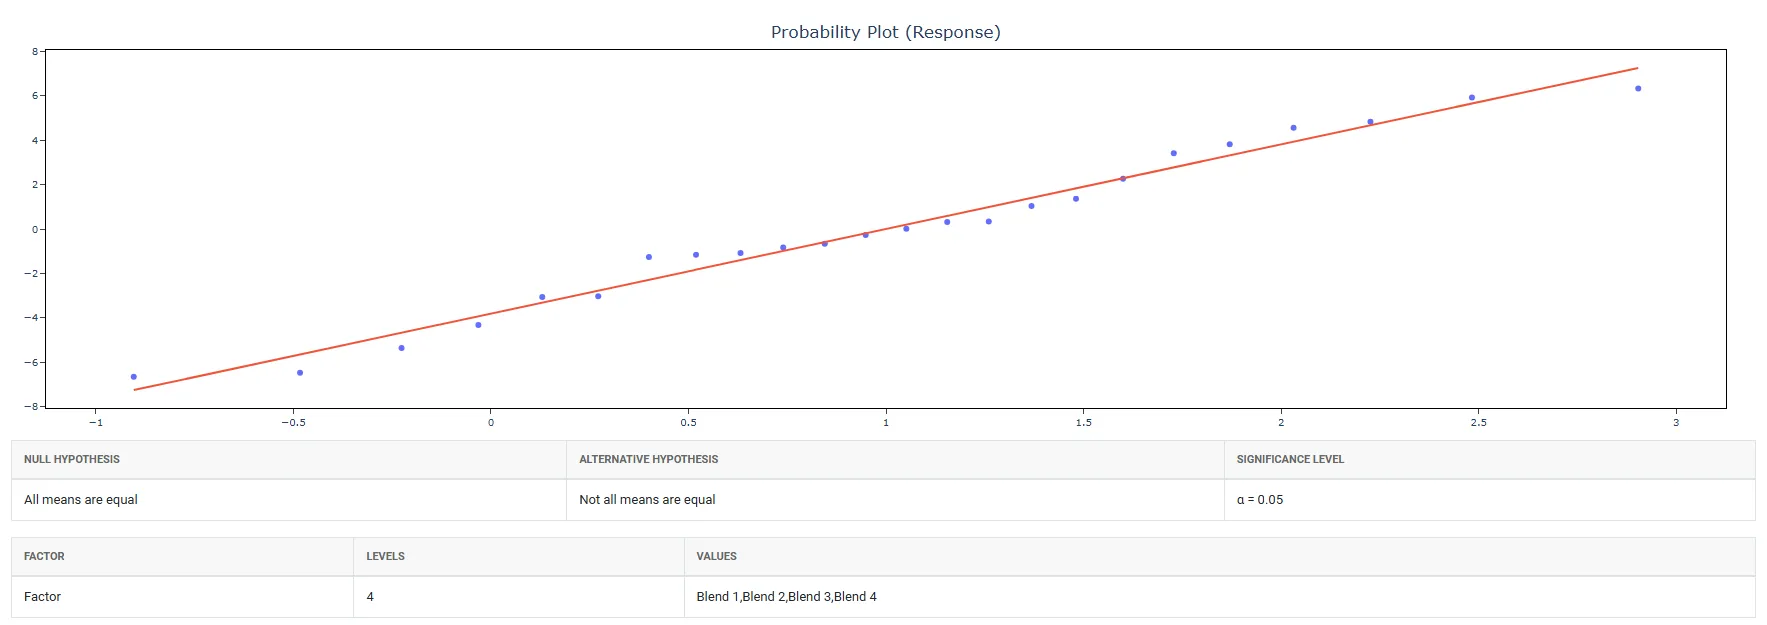
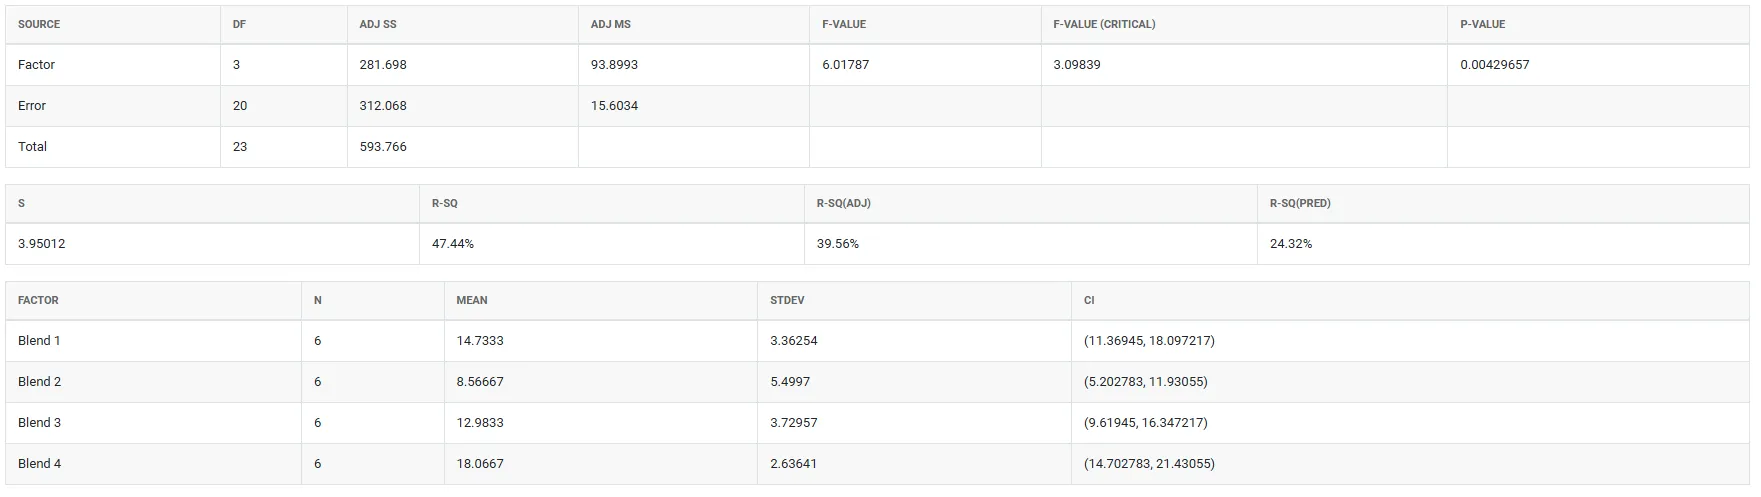
Anleitung: OECD durchführen
So gehen Sie vor:
- Melden Sie sich bei Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> OECD>OECD.
- Geben Sie die Daten anschließend manuell ein, oder kopieren Sie die Daten vollständig (Strg+C) aus einer Excel-Tabelle und fügen Sie sie ein (Strg+V). Alternativ gibt es die Option Load Example, mit der Beispieldaten geladen werden.
- Füllen Sie anschließend die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Das Dashboard von OECD ist in zwei Bereiche unterteilt.
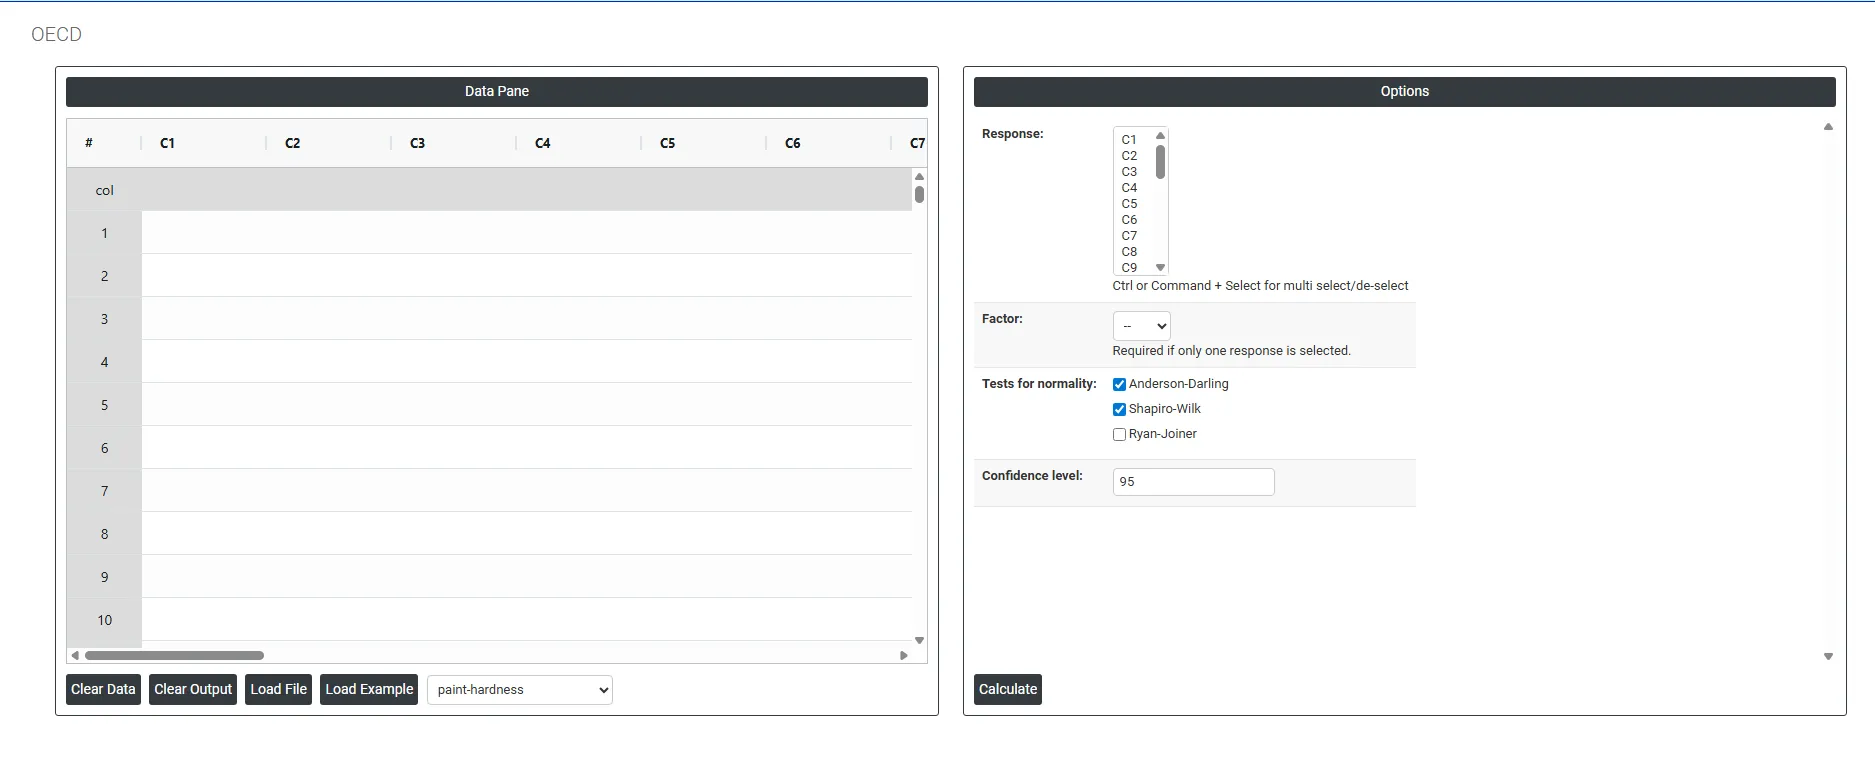
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile eine Teilgruppe. Die Daten können manuell eingegeben oder vollständig aus einer Excel-Tabelle kopiert (Strg+C) und hier eingefügt (Strg+V) werden.
Load example: Es werden Beispieldaten geladen.
Load File: Damit werden Excel-Daten direkt geladen.
Im rechten Bereich stehen folgende Optionen zur Verfügung:
- Response: Wählen Sie die Spalte oder Spalten mit den Ergebnismesswerten, die Sie analysieren möchten – etwa Körpergewicht, Enzymaktivität, Tumorinzidenz, hämatologische Werte oder einen anderen Endpunkt, der in der Studie über die Gruppen hinweg erfasst wurde. Mit Strg- bzw. Befehlstaste + Klick wählen Sie mehrere Zielgrößen-Spalten gleichzeitig aus.
Die Anzahl der ausgewählten Zielgrößen-Spalten bestimmt direkt, ob die Option Factor erforderlich ist:
Auswahl
Verhalten des Werkzeugs
Mehrere Zielgrößen ausgewählt
Jede ausgewählte Spalte stellt eine eigene Gruppe dar. Das Werkzeug definiert die Gruppen über die Spalten selbst; eine zusätzliche Factor-Spalte ist nicht nötig. Die Messwerte in den einzelnen Spalten werden direkt miteinander verglichen.
Einzelne Zielgröße ausgewählt
Alle Messwerte stehen gestapelt in einer Spalte, und es muss eine separate Factor-Spalte ausgewählt werden, die angibt, zu welcher Gruppe jeder Messwert gehört. Ohne die Factor-Spalte kann das Werkzeug nicht bestimmen, welche Beobachtungen zu welcher Gruppe gehören.
⚠ Wichtig: Ist eine einzelne Zielgröße ausgewählt, wird das Feld Factor zum Pflichtfeld. Das Werkzeug fordert Sie auf, eine Factor-Spalte auszuwählen, bevor die Analyse fortgesetzt werden kann.
- Factor: Wählen Sie die Spalte, die die Gruppenzugehörigkeit jeder Beobachtung angibt. Diese Spalte enthält kategoriale Bezeichnungen oder Codes, die angeben, zu welcher Versuchsgruppe jede Datenzeile gehört, zum Beispiel Control, Low Dose, Mid Dose, High Dose oder Group 1, Group 2, Group 3. Die Faktorspalte teilt dem Werkzeug mit, wie die einzelne Zielgrößen-Spalte für den Vergleich in separate Gruppen aufgeteilt wird. Ohne korrekte Angabe des Faktors würden alle Messwerte als zur selben Gruppe gehörig behandelt, und es wäre kein aussagekräftiger Vergleich möglich. Dieses Feld ist nur erforderlich, wenn genau eine Zielgrößen-Spalte ausgewählt ist. Sind mehrere Zielgrößen-Spalten ausgewählt, stellt jede Spalte eine Gruppe dar, und es wird kein Factor benötigt. Das Feld ist dann ausgegraut oder wird ignoriert
- Tests for Normality: Legt fest, welcher statistische Test bzw. welche Tests in Schritt 2 des Entscheidungsbaums verwendet werden, um zu beurteilen, ob die Zielgrößendaten einer Normalverteilung folgen. Das Ergebnis dieses Tests bestimmt, ob für die gesamte Analyse der parametrische oder der nichtparametrische Analysepfad verfolgt wird. Drei Tests stehen zur Verfügung:
- Anderson-Darling : Ein leistungsfähiger Omnibus-Test auf Normalverteilung, der besonderes Gewicht auf die Enden der Verteilung legt, also die extrem hohen und niedrigen Werte. Dadurch ist er besonders empfindlich für Abweichungen von der Normalität in den Verteilungsenden, die in toxikologischen und Umweltdaten oft die praktisch wichtigsten Bereiche sind. Der Anderson-Darling-Test wird für den allgemeinen Einsatz über einen weiten Bereich von Stichprobenumfängen empfohlen und ist besonders wirksam, wenn erwartet wird, dass sich das Verhalten in den Verteilungsenden von der Normalverteilung unterscheidet.
- Shapiro-Wilk: Gilt weithin als der leistungsfähigste und zuverlässigste Test auf Normalverteilung für kleine Stichprobenumfänge – typischerweise n < 50 –, die häufigste Situation in Studien nach OECD-Richtlinien, in denen die Gruppengrößen oft 5 bis 20 Tiere betragen. Der Shapiro-Wilk-Test ist der in den statistischen OECD-Leitlinien vorrangig genannte Test auf Normalverteilung und die Standardwahl in der pharmazeutischen und toxikologischen Statistik. Es wird dringend empfohlen, diesen Test bei Analysen regulatorischer Studien stets aktiviert zu lassen.
- Ryan-Joiner: Ein korrelationsbasierter Test auf Normalverteilung, der beurteilt, wie eng die Daten dem für eine Normalverteilung erwarteten Muster folgen, indem er die Korrelation zwischen den beobachteten Daten und den theoretischen Quantilen der Normalverteilung misst. Er ähnelt konzeptionell dem Shapiro-Wilk-Test, verwendet aber einen anderen Rechenansatz. In der regulatorischen Arbeit seltener gefordert, kann aber aktiviert werden, wenn eine korrelationsbasierte Normalitätsbeurteilung ausdrücklich verlangt oder von der prüfenden Behörde bevorzugt wird.
- Sind mehrere Tests auf Normalverteilung ausgewählt, führt das Werkzeug alle angehakten Tests aus und berichtet alle Ergebnisse. Die Gesamtentscheidung zur Normalität beruht auf dem konservativsten Ergebnis: Zeigt einer der ausgewählten Tests Nicht-Normalität an (p < α), werden die Daten als nicht normalverteilt behandelt, und es wird dem nichtparametrischen Pfad gefolgt
Confidence Level (Default: 95): Legt die Signifikanzschwelle fest, die einheitlich für jeden Hypothesentest im gesamten Entscheidungsbaum verwendet wird, einschließlich Test auf Normalverteilung, Test auf Varianzhomogenität und abschließendem Gruppenvergleichstest. Der eingegebene Wert ist das Konfidenzniveau in Prozent, und das für alle Entscheidungen verwendete zugehörige Alpha (α) wird als (100 − Confidence Level) ÷ 100 berechnet.
Confidence Level
Alpha-Niveau und Einsatz
95 (Standard)
Alpha = 0.05. Das Standard-Konfidenzniveau für die meisten wissenschaftlichen und regulatorischen OECD-Studien. Die Wahrscheinlichkeit einer falsch positiven Schlussfolgerung beträgt 5%. Dieses Niveau wird von OECD-Richtlinien und Behörden weltweit am häufigsten gefordert.
99
Alpha = 0.01. Konservativeres Testen erfordert stärkere Belege, bevor ein signifikantes Ergebnis festgestellt wird. Verringert falsch positive Ergebnisse, kann aber kleinere reale Effekte übersehen. Verwenden Sie es, wenn die Folgen eines falsch positiven Ergebnisses besonders schwerwiegend sind.
90
Alpha = 0.10. Empfindlicheres Testen erkennt kleinere Unterschiede, erhöht aber das Risiko falsch positiver Schlussfolgerungen. Nur für explorative oder Pilotstudien geeignet, bei denen das Übersehen eines realen Effekts das größere Problem ist.
Häufig gestellte Fragen
Was ist der statistische OECD-Entscheidungsbaum?
Das Werkzeug OECD Statistical Decision Tree ist ein geführtes Analysesystem, das den richtigen statistischen Test für Versuchsdaten auswählt und anwendet. Es folgt dem OECD-Entscheidungspfad und bewertet in jeder Stufe Datentyp, Normalität, Varianzhomogenität und Gruppenanzahl, sodass die Schlussfolgerungen reproduzierbar und vertretbar sind. Es wird in der Toxikologie, den Umweltwissenschaften, der pharmazeutischen Forschung und bei Zulassungsanträgen eingesetzt.
Welche Tests wendet der OECD-Entscheidungsbaum auf normalverteilte Daten an?
Bei zwei Gruppen prüft ein F-Test die Varianz: Gleiche Varianzen führen zum t-Test nach Student, ungleiche Varianzen zur Methode nach Satterthwaite (Welch-t-Test). Bei drei oder mehr Gruppen prüft der Bartlett-, Levene- oder Brown-Forsythe-Test die Varianz; bei gleichen Varianzen wird eine ANOVA angewendet, gefolgt vom Dunnett-Test gegen die Kontrolle, wenn die ANOVA signifikant ist.
Was passiert im OECD-Entscheidungsbaum, wenn die Daten nicht normalverteilt sind?
Wird die Normalität verworfen, wird eine Transformation wie Logarithmus oder Quadratwurzel versucht und die Normalität erneut geprüft. Sind die transformierten Daten weiterhin nicht normalverteilt, wird dem nichtparametrischen Pfad gefolgt: Kruskal-Wallis mit Dunn-Post-hoc-Test bei drei oder mehr Gruppen, Mann-Whitney-U-Test bei zwei Gruppen und Chi-Quadrat bei kategorialen Daten oder Indexdaten.
Wann sollten Sie den OECD-Entscheidungsbaum nicht verwenden?
Verwenden Sie ihn nicht für gepaarte Beobachtungen, für die ein gepaarter t-Test oder ein Wilcoxon-Vorzeichen-Rang-Test nötig ist, nicht für Regression oder Dosis-Wirkungs-Modellierung, nicht für Zeitreihen- oder Längsschnittdaten und nicht für Äquivalenz- oder Nichtunterlegenheitstests. Ohne regulatorischen OECD-Kontext kann es einfacher sein, direkt den am besten geeigneten spezifischen Test zu verwenden.