
Ordinale logistische Regression
Die ordinale logistische Regression ist ein statistisches Modell zur Analyse des Zusammenhangs zwischen einer oder mehreren Prädiktorvariablen und einer Zielgröße mit drei oder mehr geordneten Kategorien. Die Kategorien haben eine natürliche Rangfolge, etwa niedrig/mittel/hoch oder stimme nicht zu/neutral/stimme zu, der genaue Abstand zwischen ihnen ist jedoch nicht messbar.
Zuletzt geprüft
Kernaussage
Die ordinale logistische Regression ist ein statistisches Modell zur Analyse des Zusammenhangs zwischen einer oder mehreren Prädiktorvariablen und einer Zielgröße mit drei oder mehr geordneten Kategorien.
Auf dieser Seite
- Was ist die ordinale logistische Regression?
- Wann wird die ordinale logistische Regression eingesetzt?
- Hinweise zur richtigen Anwendung der ordinalen logistischen Regression
- Alternativen: Wann Sie die ordinale logistische Regression nicht verwenden sollten
- Beispiel für eine ordinale logistische Regression
- Anleitung: ordinale logistische Regression durchführen
Was ist die ordinale logistische Regression?
Die ordinale logistische Regression ist ein statistisches Modell zur Analyse des Zusammenhangs zwischen einer oder mehreren Prädiktorvariablen und einer Zielgröße mit drei oder mehr geordneten Kategorien. Die Kategorien haben eine natürliche Rangfolge, etwa niedrig/mittel/hoch oder stimme nicht zu/neutral/stimme zu, der genaue Abstand zwischen ihnen ist jedoch nicht messbar. Das Modell sagt anhand der Prädiktoren die Wahrscheinlichkeit voraus, in jede Kategorie zu fallen.
Wann wird die ordinale logistische Regression eingesetzt?
Prädiktorvariablen
- Prädiktoren können stetig, kategorial oder eine Mischung aus beidem sein
- Diskrete Variablen können je nach Anzahl der Stufen und Zweck der Analyse als stetig oder kategorial behandelt werden
- Nur ein stetiger Prädiktor mit stetiger Zielgröße → verwenden Sie Fit Line Model
- Mehrere Prädiktoren mit stetiger Zielgröße → verwenden Sie Fit Regression Model
Zielgröße
- Die Zielgröße muss drei oder mehr geordnete Kategorien mit einer natürlichen Rangfolge haben (z. B. niedrig/mittel/hoch, nie/manchmal/immer)
- Die Reihenfolge ist wichtig – die Abstände zwischen den Kategorien müssen jedoch nicht gleich sein
- Zielgröße hat nur zwei Kategorien (Gut/Schlecht) → verwenden Sie Fit Binary Logistic Model
- Zielgröße hat ungeordnete Kategorien (Kratzer/Delle/Riss) → verwenden Sie die nominale logistische Regression
- Zielgröße ist stetig → verwenden Sie Fit Regression Model oder Fit Line Model
Hinweise zur richtigen Anwendung der ordinalen logistischen Regression
- Stellen Sie sicher, dass die Zielgröße drei oder mehr Kategorien mit sinnvoller Reihenfolgehat; spielt die Reihenfolge keine Rolle, verwenden Sie stattdessen die nominale logistische Regression.
- Prädiktoren können stetig oder kategorialsein; stellen Sie sicher, dass jeder Prädiktor vor dem Ausführen des Modells korrekt eingeordnet ist.
- Stellen Sie sicher, dass die Daten die Zielgrundgesamtheit zutreffend abbilden; verzerrte oder unvollständige Daten führen zu unzuverlässigen Ergebnissen.
- Erheben Sie ausreichend viele Datenpunkte je Kategorie, um über alle Stufen der Zielgröße stabile und zuverlässige Wahrscheinlichkeitsschätzungen zu erhalten.
- Messen Sie alle Variablen so genau wie möglich; Fehler bei Einstufung oder Messung wirken sich direkt auf die Genauigkeit des Modells aus.
- Erfassen Sie die Daten in der Reihenfolge ihrer Erhebung , um zeitabhängige Trends oder Unstimmigkeiten erkennen zu können.
- Validieren Sie das Modell nach der Anpassung anhand der Anpassungsgütestatistiken und der Residuendiagnostik; ein schlecht angepasstes Modell liefert irreführende Vorhersagen.
- Prüfen Sie die Annahme proportionaler Odds (Proportional-Odds-Annahme) – die ordinale logistische Regression setzt voraus, dass der Zusammenhang zwischen jedem Paar von Ergebnisgruppen gleich ist. Ist diese Annahme verletzt, erwägen Sie stattdessen die nominale logistische Regression.
Alternativen: Wann Sie die ordinale logistische Regression nicht verwenden sollten
- Hat die Zielgröße nur zwei Kategorien (z. B. Gut/Schlecht), verwenden Sie stattdessen Fit Binary Logistic Model .
- Haben die Kategorien der Zielgröße keine natürliche Reihenfolge (z. B. Kratzer/Delle/Riss), verwenden Sie stattdessen die nominale logistische Regression .
- Ist die Zielgröße stetig, verwenden Sie stattdessen Fit Regression Model oder Fit Line Model .
- Haben Sie nur einen stetigen Prädiktor und eine stetige Zielgröße, verwenden Sie stattdessen Fit Line Model .
- Haben Sie mehrere Prädiktoren und eine stetige Zielgröße, verwenden Sie stattdessen Fit Regression Model .
Beispiel für eine ordinale logistische Regression
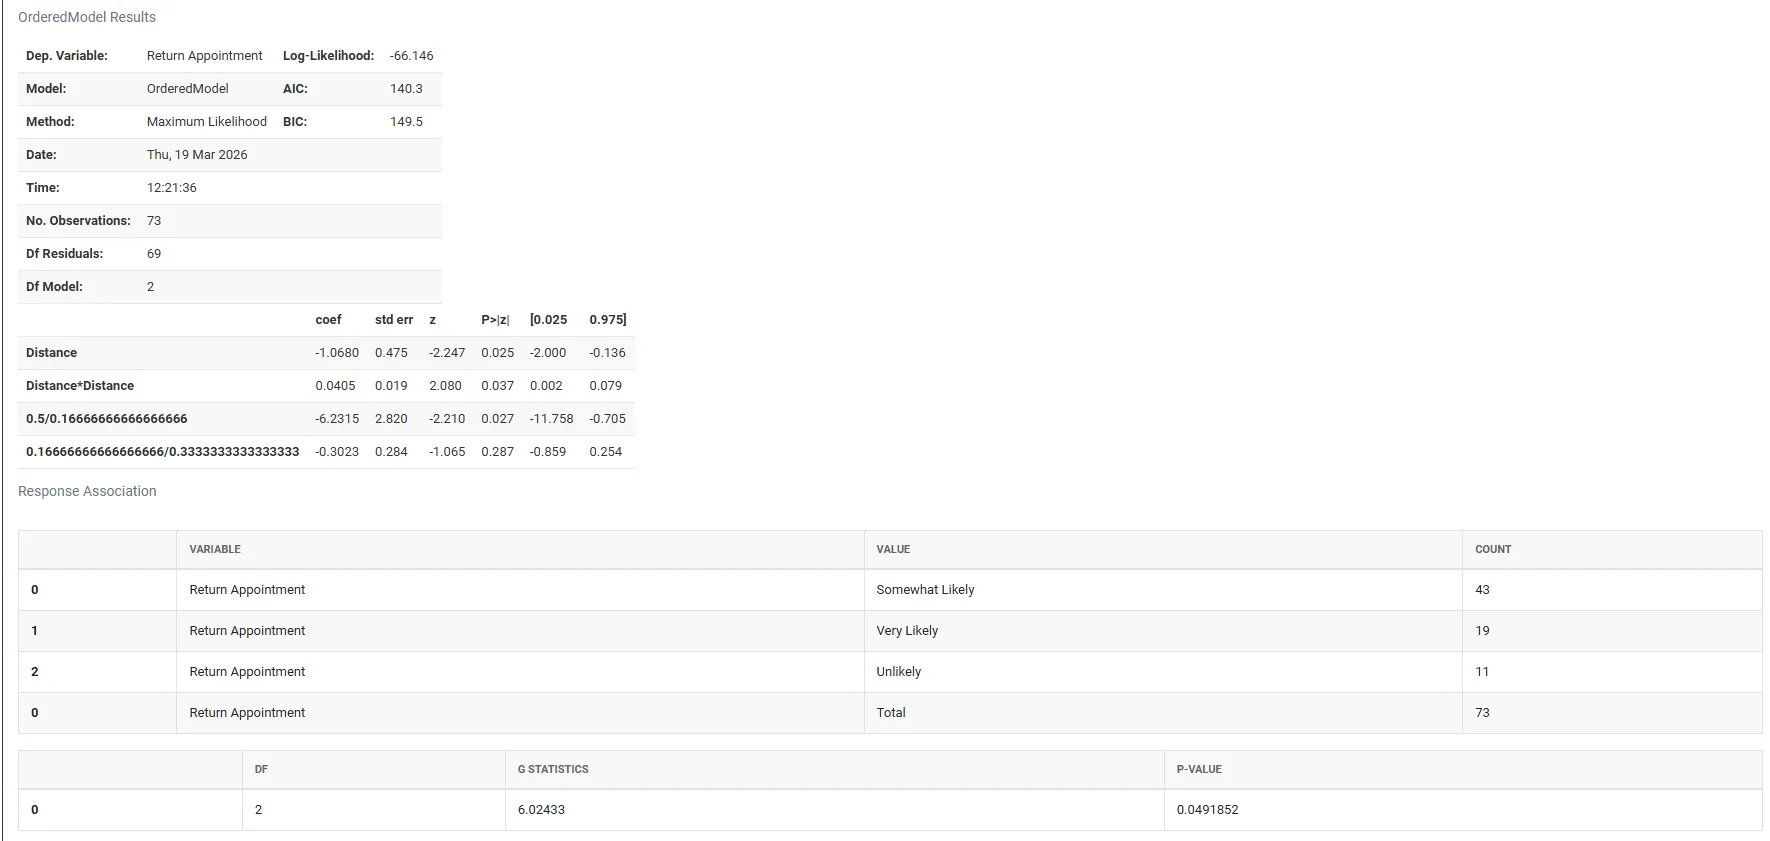
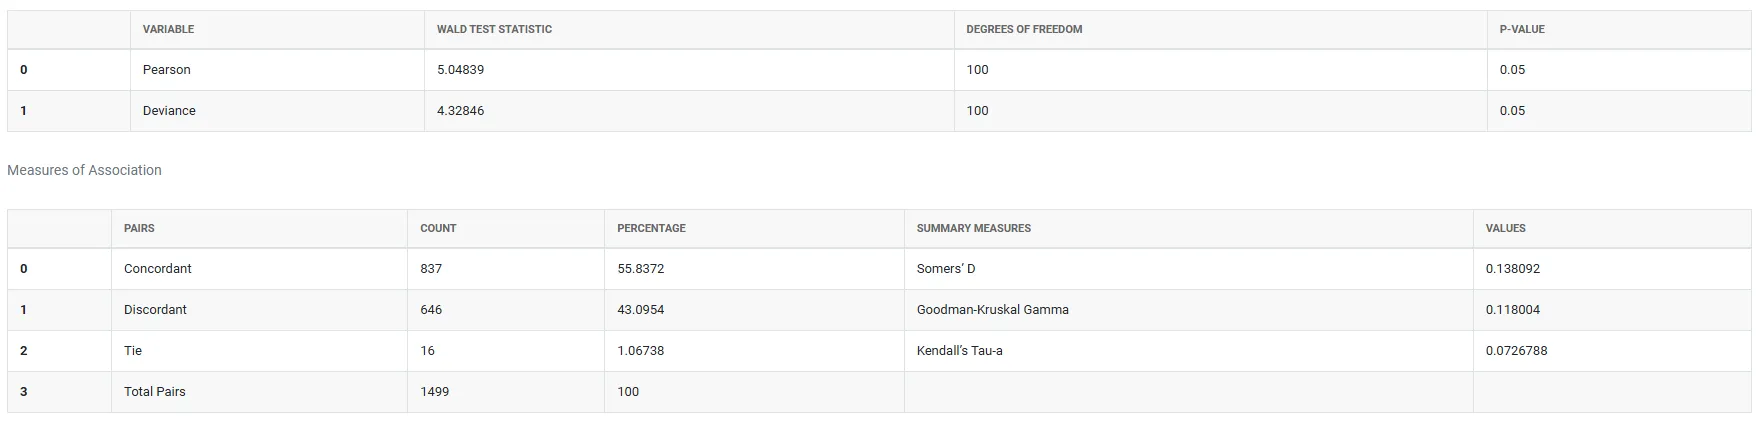
Die Leiterin einer Arztpraxis möchte herausfinden, welche Faktoren die Patientenzufriedenheit beeinflussen. Die Patienten werden befragt, wie wahrscheinlich es ist, dass sie zur Nachsorge wiederkommen; die Antworten werden in unwahrscheinlich, eher wahrscheinlich und sehr wahrscheinlich eingeteilt. Da diese Antwortkategorien eine natürliche Reihenfolge haben, behandelt die Leiterin das Ergebnis als ordinale Variable und untersucht mit der ordinalen logistischen Regression den Zusammenhang zwischen der Wiederkehrwahrscheinlichkeit und Prädiktoren wie Beschäftigungsstatus, Alter und Entfernung zur Praxis. Zur Beurteilung der statistischen Signifikanz und der Anpassungsgüte des Modells wird ein Signifikanzniveau von 0.05 verwendet. Dabei wurden folgende Schritte durchgeführt:
- Die nötigen Daten wurden erhoben.
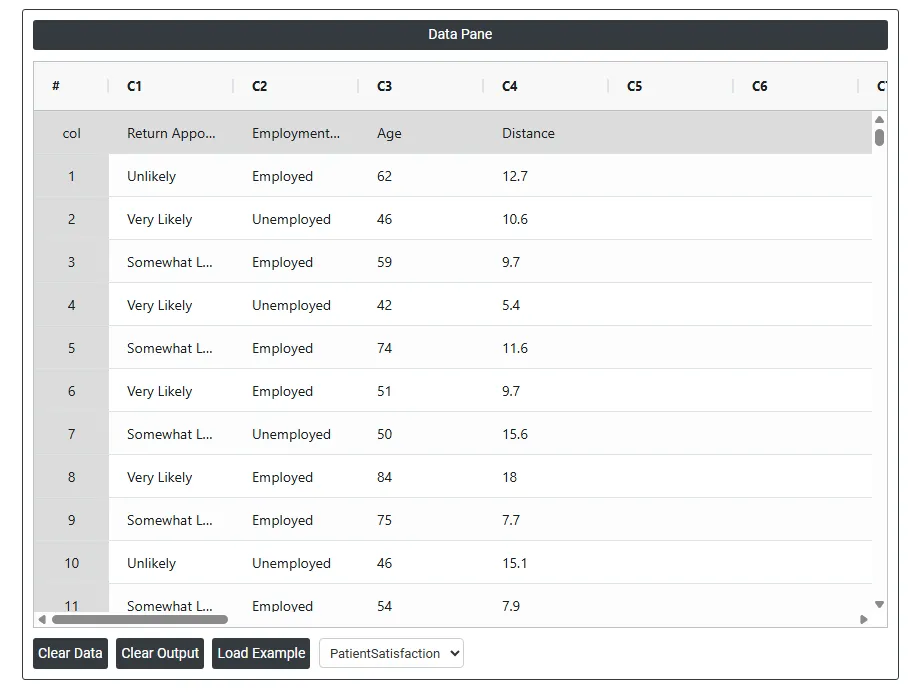
- Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
- Um Ordinal Logistic Regression zu finden, wählen Sie Statistical module> Regression>Ordinal Logistic Regression.
- Geben Sie im Tool die Daten zusammen mit weiteren Eingaben wie folgt ein:
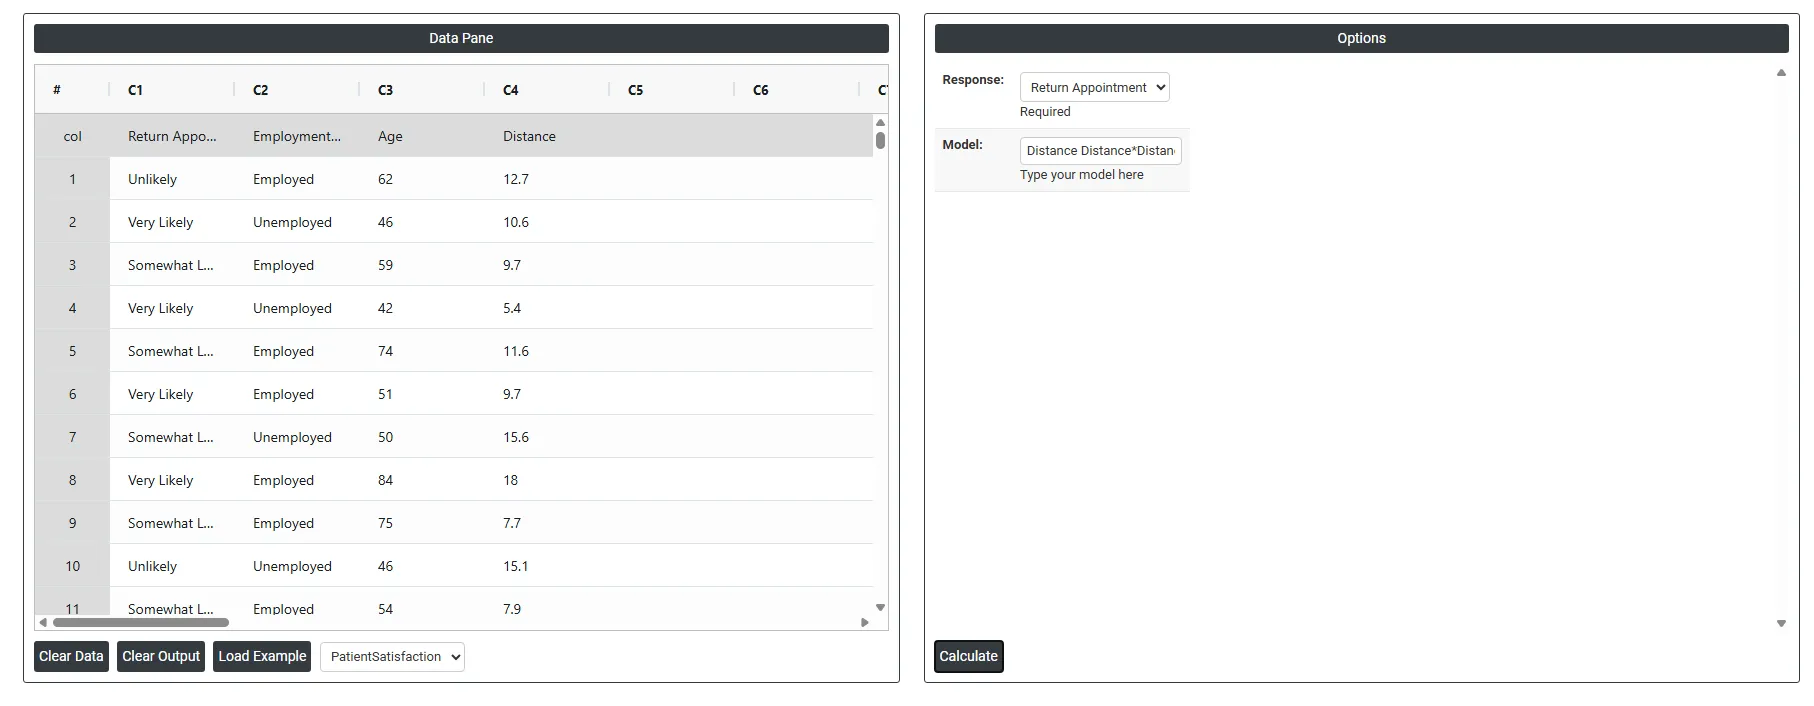
5. Mit dem oben genannten Tool erhalten Sie folgende Ausgabe:
Anleitung: ordinale logistische Regression durchführen
Gehen Sie wie folgt vor:
- Melden Sie sich bei Zometric Statistical Software an: https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Regression > Ordinal Logistic Regression.
- Geben Sie anschließend die Daten manuell ein oder kopieren Sie sie vollständig (Ctrl+C) aus einer Excel-Tabelle und fügen Sie sie ein (Ctrl+V); alternativ gibt es die Option Load Example, mit der die Beispieldaten geladen werden.
- Füllen Sie anschließend die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Das Dashboard von Ordinal Logistic Regression ist in zwei Bereiche geteilt.
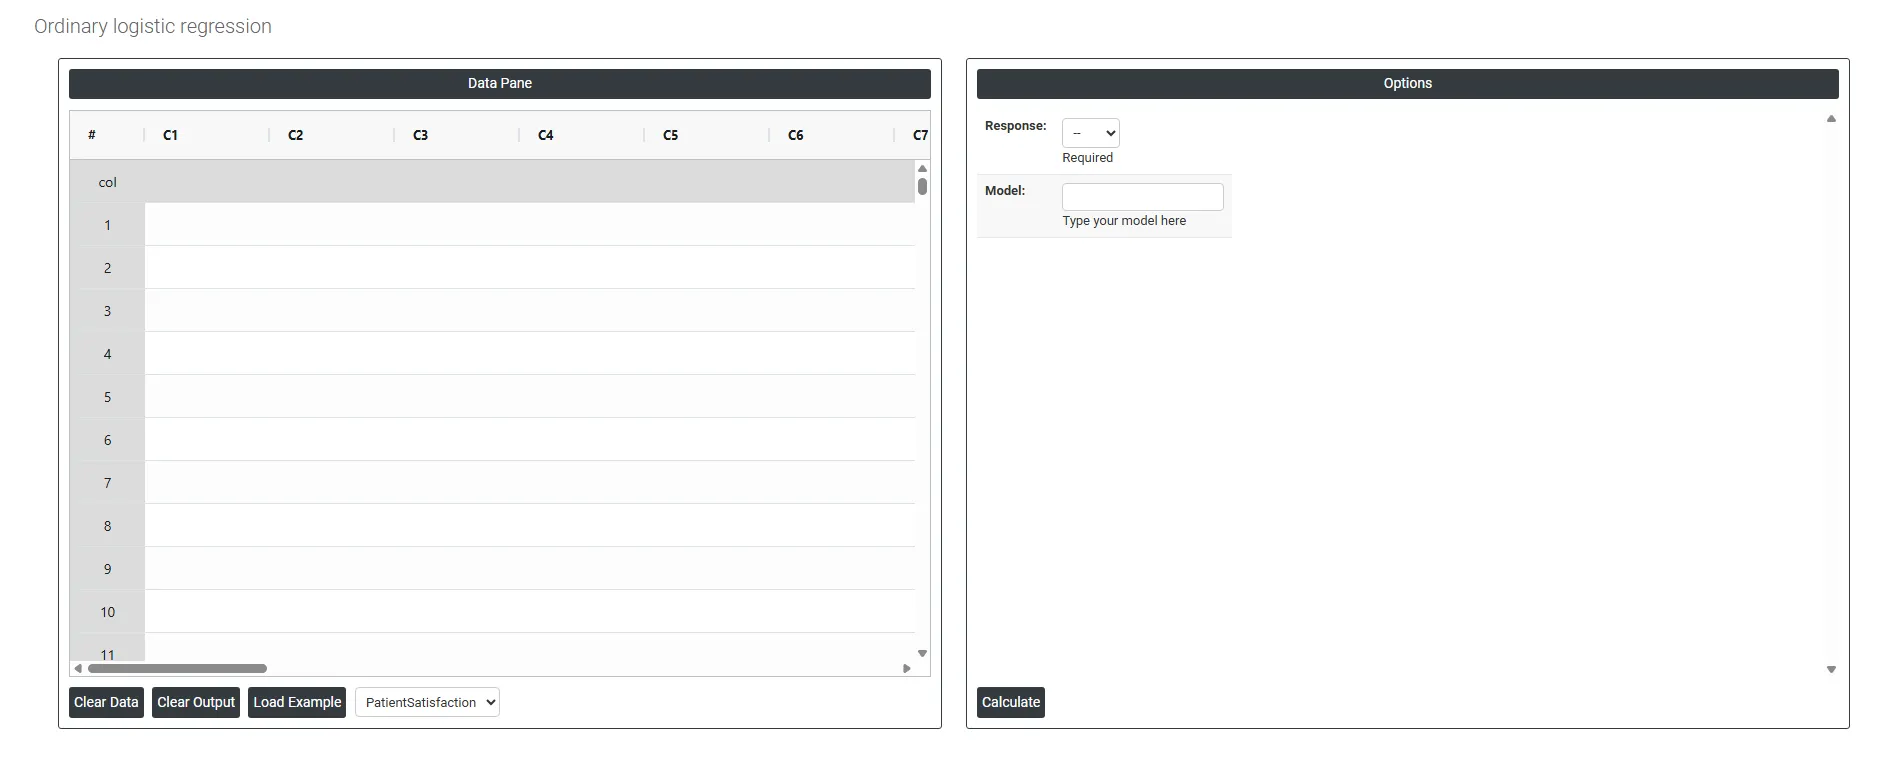
Links befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile eine Teilgruppe. Die Daten können manuell eingegeben oder vollständig aus einer Excel-Tabelle kopiert (Ctrl+C) und hier eingefügt (Ctrl+V) werden.
Load example: Beispieldaten werden geladen.
Load File: Damit laden Sie Excel-Daten direkt.
Rechts stehen folgende Optionen zur Verfügung:
- Response: Die Zielgröße ist die Ergebnisvariable, die Sie vorhersagen oder untersuchen möchten. Bei der ordinalen logistischen Regression muss die Zielgröße drei oder mehr Kategorien mit einer natürlichen, sinnvollen Reihenfolge enthalten – die Kategorien lassen sich ordnen, die Abstände zwischen ihnen müssen aber nicht gleich sein.
Zum Beispiel:
Das Modell berechnet dann anhand der Prädiktorvariablen die Wahrscheinlichkeit, mit der eine Beobachtung in jede Kategorie fällt. - Schmerzstärke → Leicht / Mäßig / Stark
- Antwort in einer Befragung → Stimme nicht zu / Neutral / Stimme zu
- Model Legt die Struktur Ihrer Analyse fest, indem angegeben wird, welche Prädiktoren und Wechselwirkungsterme in das Modell aufgenommen werden. Sie können Folgendes aufnehmen:
- Stetige Prädiktoren – numerische Variablen wie Temperatur, Alter oder Dosierung
- Kategoriale Prädiktoren – gruppierte Variablen wie Geschlecht, Werkstoffart oder Region
- Wechselwirkungsterme – Kombinationen aus zwei oder mehr Prädiktoren, die gemeinsam eine Wirkung über ihre Einzelbeiträge hinaus haben können
Häufig gestellte Fragen
Was ist die ordinale logistische Regression?
Die ordinale logistische Regression analysiert den Zusammenhang zwischen einem oder mehreren Prädiktoren und einer Zielgröße mit drei oder mehr geordneten Kategorien, etwa niedrig/mittel/hoch oder stimme nicht zu/neutral/stimme zu, wobei die Kategorien eine natürliche Rangfolge haben, der Abstand zwischen ihnen aber nicht messbar ist. Sie sagt anhand der Prädiktoren die Wahrscheinlichkeit voraus, in jede Kategorie zu fallen.
Wann sollten Sie die ordinale statt der nominalen logistischen Regression verwenden?
Verwenden Sie die ordinale logistische Regression, wenn die Kategorien der Zielgröße eine sinnvolle Reihenfolge haben, etwa nie/manchmal/immer. Spielt die Reihenfolge keine Rolle, wie bei Kratzer/Delle/Riss, verwenden Sie die nominale logistische Regression. Für eine Zielgröße mit zwei Kategorien wie Gut/Schlecht verwenden Sie das binäre logistische Modell und für eine stetige Zielgröße die Regressions- oder Geradenmodelle.
Was ist die Annahme proportionaler Odds?
Die ordinale logistische Regression setzt voraus, dass der Zusammenhang zwischen jedem Paar von Ergebnisgruppen gleich ist; dies wird als Annahme proportionaler Odds (Proportional-Odds-Annahme) bezeichnet. Sie sollte nach der Anpassung geprüft werden; ist sie verletzt, erwägen Sie stattdessen die nominale logistische Regression. Validieren Sie das Modell mit Anpassungsgütestatistiken und Residuendiagnostik.
Welche Prädiktoren können in der ordinalen logistischen Regression verwendet werden?
Prädiktoren können stetig sein, etwa Temperatur, Alter oder Dosierung, kategorial, etwa Werkstoffart oder Region, oder eine Mischung aus beidem. Diskrete Variablen können je nach Anzahl der Stufen und Zweck der Analyse als das eine oder das andere behandelt werden. Das Modell kann auch Wechselwirkungsterme zwischen Prädiktoren enthalten.