
Poisson-Regression
Die Poisson-Regression modelliert Anzahlen von Ereignissen in einer festen Zeit, Fläche oder Produktmenge in Abhängigkeit von stetigen und kategorialen Prädiktoren. Sie wird statt der gewöhnlichen Regression verwendet, weil Anzahlen nicht negativ sein können und ihre Streuung mit dem Mittelwert wächst. Für die Zielgröße wird eine Poisson-Verteilung angenommen, mit Log-, Wurzel- oder Identitäts-Linkfunktion. Die Ausgabe umfasst Koeffizienten, Devianzanalyse, Anpassungstests und Residuendiagramme.
Zuletzt geprüft
Kernaussage
Die Poisson-Regression ist ein verallgemeinertes lineares Modell, das eine Zielgröße aus Anzahlen (z. B. Fehler je Schicht, Ausfälle je Monat) per Maximum-Likelihood mit stetigen und kategorialen Prädiktoren verknüpft.
Auf dieser Seite
Zweck
Die Poisson-Regression verknüpft eine Zielgröße aus Anzahlen, etwa Fehler je Schicht, Ausfälle je Monat oder Fehlstellen je Platte, mit stetigen und kategorialen Prädiktoren. Verwenden Sie sie statt der gewöhnlichen Regression, wenn die Zielgröße eine Anzahl von Ereignissen in einer festen Zeit, Fläche oder Produktmenge ist: Die Anzahlen können nicht negativ sein, und ihre Streuung wächst mit ihrem Mittelwert, was die Methode der kleinsten Quadrate nicht berücksichtigt.
Wichtigste Funktionen
- Stetige und kategoriale Prädiktoren, mit Wechselwirkungen und quadratischen Termen aus der Termliste.
- Log-Linkfunktion (Standard), Wurzel- oder Identitäts-Linkfunktion.
- Schrittweise Auswahl, Vorwärtsauswahl oder Rückwärtselimination von Termen, wobei Terme in jedes Modell erzwungen werden können.
- Koeffizienten mit Konfidenzintervallen und VIF, Regressionsgleichungen für jede Stufe eines kategorialen Prädiktors, Modellzusammenfassung und Anpassungstests.
- Devianzanalyse mit Wald- oder Likelihood-Quotienten-Tests (adjustiert oder sequenziell).
- Ungewöhnliche Beobachtungen, Residuendiagramme, Haupteffekt- und Wechselwirkungsdiagramme, Kontur- und Flächendiagramme der angepassten Anzahlen.
- Vorhersage für eingegebene Einstellungen und ein Response Optimizer (Zielgrößenoptimierung).
Statistische Methoden
Für die Zielgröße wird eine Poisson-Verteilung mit dem Mittelwert μ angenommen, der über die Linkfunktion von den Prädiktoren abhängt: Mit der Log-Linkfunktion gilt ln μ = b₀ + b₁x₁ + … , sodass jeder Koeffizient die erwartete Anzahl je Einheit seines Prädiktors mit exp(b) multipliziert. Das Modell ist ein verallgemeinertes lineares Modell, das nach der Maximum-Likelihood-Methode (iterativ neu gewichtete kleinste Quadrate) angepasst wird. Kategoriale Prädiktoren verwenden eine (1, 0)-Kodierung gegenüber einer Referenzstufe, standardmäßig der ersten Stufe in Sortierreihenfolge. Zeilen mit fehlendem Wert werden verworfen; eine Häufigkeitsspalte wiederholt Zeilen, und eine Gewichtsspalte liefert Varianzgewichte.
Die Koeffiziententabelle enthält Wald-z-Werte (Coef / SE Coef) und Konfidenzintervalle. Die Devianzanalyse prüft jeden Term: standardmäßig mit einem Wald-Chi-Quadrat (z² bei einem stetigen Term, ein gemeinsamer Test für die Dummy-Spalten eines kategorialen Terms); beim LR-Test über die Änderung der Devianz, wenn der Term aus dem vollständigen Modell entfernt (adjustiert, Typ III) oder in Reihenfolge hinzugefügt wird (sequenziell, Typ I). Deviance R-Sq = 1 − Residualdevianz / Nulldevianz.
Die Anpassungstests vergleichen die Devianz und das Pearson-Chi-Quadrat mit einer Chi-Quadrat-Verteilung mit den Freiheitsgraden des Fehlers. Ein kleiner p-Wert oder ein Mean (Devianz / DF) deutlich über 1 bedeutet, dass die Anzahlen stärker streuen, als ein Poisson-Modell zulässt (Überdispersion); die p-Werte der Terme sind dann zu klein. Beobachtungen mit einem standardisierten Residuum jenseits von ±2 werden mit R gekennzeichnet, solche mit einer Hebelwirkung über 3p/n mit X.
Eingabefelder und Optionen
Feld | Beschreibung |
Response | Spalte mit den Anzahlen. Pflichtfeld. |
Continuous Predictors / Categorical Predictor | Numerische und Text- (oder kodierte) Prädiktorspalten; mindestens eine. Mit Strg- bzw. Befehlstaste + Klick wählen Sie mehrere aus. |
Model terms (optional) | Termliste: Terme anhaken oder Add all, Interactions und Powers bis zu der in Terms through order (2 oder 3) gewählten Ordnung verwenden. Entfernen Sie den Haken bei In model, um einen linearen Term zu entfernen und seine Wechselwirkungen zu behalten. |
Reference level (optional) | Für kategoriale Prädiktoren „Predictor Level“, durch Kommas getrennt. Standard: erste Stufe in Sortierreihenfolge. |
Stepwise method | None (Standard), Stepwise, Forward selection oder Backward elimination; mit Alpha to enter und Alpha to remove (0.15), Hierarchieregeln, Terms in every model (E), Initial model terms (I) und Model selection details. |
Frequency (optional) / Weights (optional) | Spalten mit Zeilenhäufigkeiten und mit Gewichten. |
Link function | Log (Standard), Square root oder Identity. |
Confidence level / Type of confidence interval | Standard 95, Two-sided; oder Lower bound bzw. Upper bound. |
Fits and diagnostics for all observations | Listet angepassten Wert und Residuum für jede Zeile auf, nicht nur für ungewöhnliche. |
Test for ANOVA table / Type of deviance (LR test only) | Wald test (Standard) oder LR test; bei LR Adjusted (Typ III, Standard) oder Sequential (Typ I). |
Residuals for diagnostics/plots | Deviance (Standard) oder Pearson. |
Histogram of residuals / Normal probability plot of residuals / Residuals versus fits / Residuals versus order / Four in one / Residuals versus the variables | Residuendiagramme. |
Main effects plot / Interaction plot | Angepasste Anzahl gegen jeden Prädiktor, wobei die übrigen auf ihrem Mittelwert bzw. ihrer Referenzstufe gehalten werden. |
Contour plot / Surface plot / Overlaid contour plot of fitted values | Erfordern Variablen für die X1- und X2-Achse; das überlagerte Konturdiagramm benötigt zusätzlich Response low und Response high. |
Prediction / Response Optimizer | Fügt einen Bereich hinzu, um die mittlere Anzahl (mit SE und Konfidenzintervall) für eingegebene Einstellungen vorherzusagen oder Einstellungen zu suchen, die ein Ziel für die Anzahl erfüllen. |
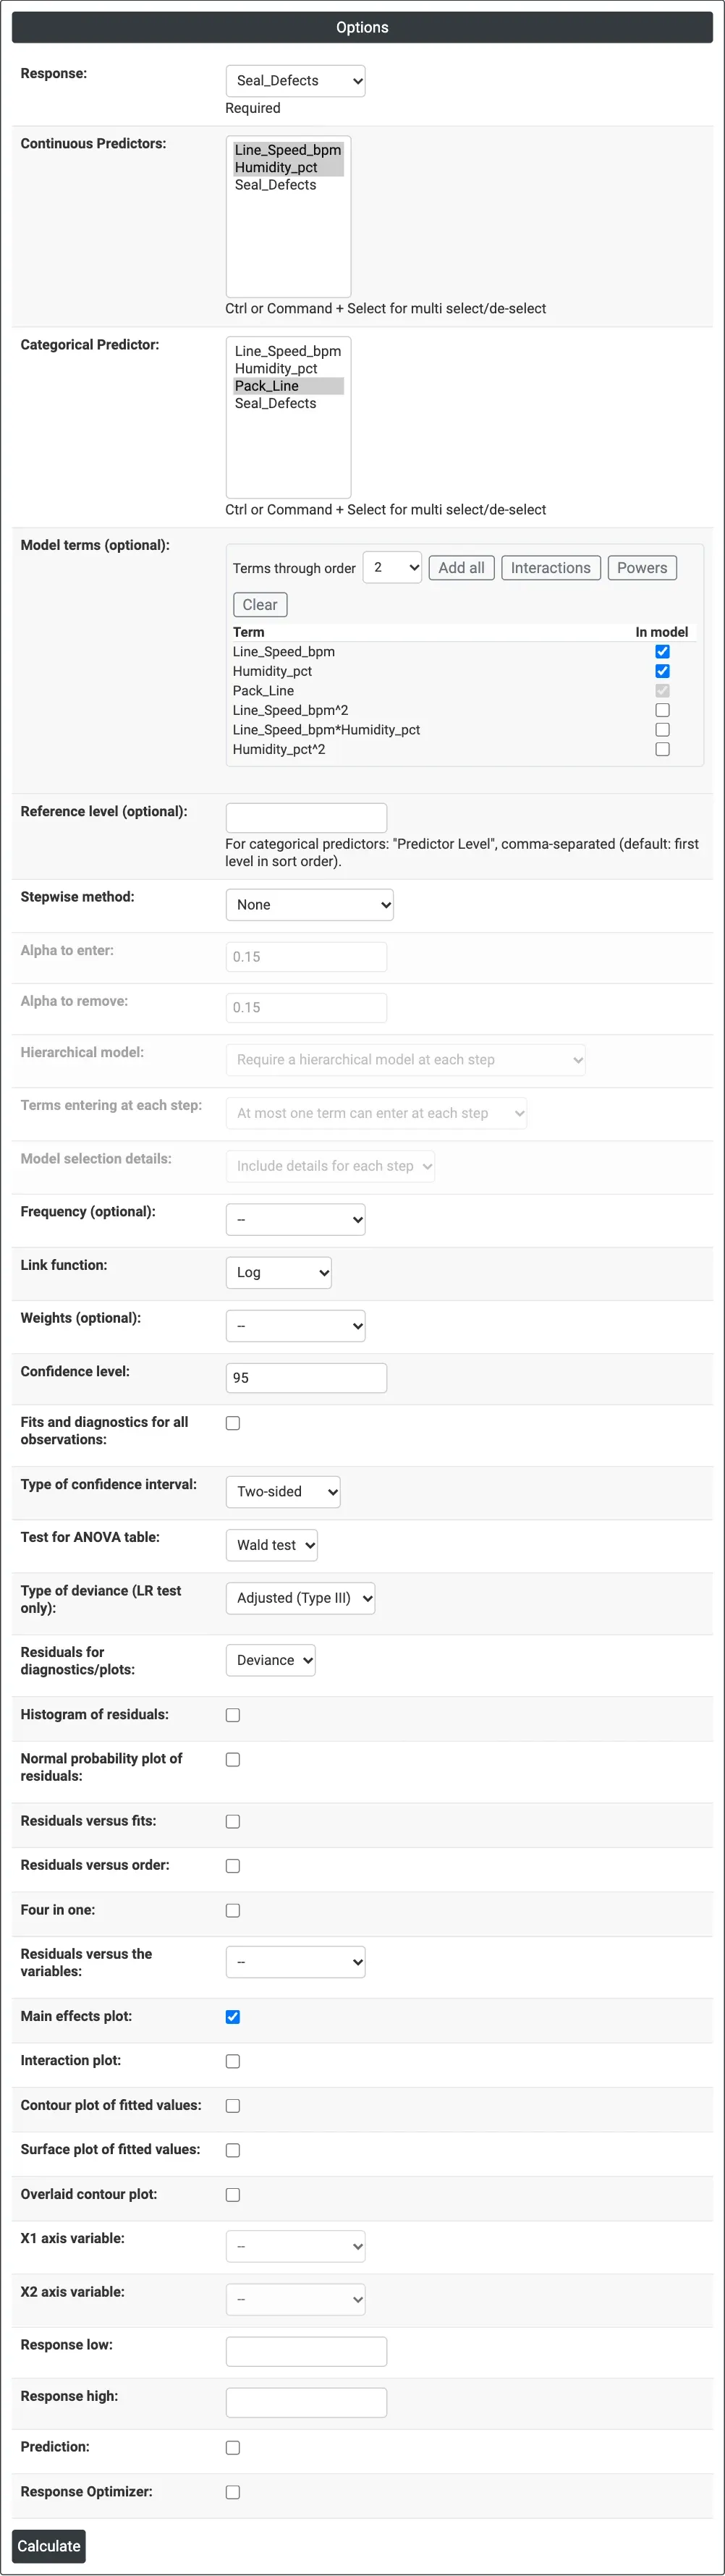
Abbildung 1: Optionen für das Beispiel der Sackverschweißung: Seal_Defects als Zielgröße, Liniengeschwindigkeit und Luftfeuchtigkeit als stetige Prädiktoren, Packlinie als kategorialer Prädiktor, Main effects plot aktiviert.
Beschreibung der Ausgabe
- Method: Linkfunktion, kategoriale Kodierung und verwendete Zeilen.
- Response Information: N, Mittelwert, Standardabweichung, Minimum und Maximum der Anzahlen.
- Coefficients: Coef, SE Coef, Z-Value, P-Value, Konfidenzgrenzen und VIF.
- Regression Equation: der lineare Prädiktor Y' (ln der erwarteten Anzahl bei Log-Linkfunktion) für jede Stufe der kategorialen Prädiktoren.
- Model Summary: Deviance R-Sq, Adj R-Sq, AIC, AICc und BIC.
- Goodness-of-Fit Tests: Devianz- und Pearson-Chi-Quadrat-Tests.
- Fits and Diagnostics for Unusual Observations (angepasste Werte und Diagnosen für ungewöhnliche Beobachtungen).
- Analysis of Deviance: Chi-Quadrat und p-Wert für die Regression und jeden Term.
- Tabelle der schrittweisen Auswahl, Residuen-, Faktor-, Kontur- und Flächendiagramme sowie Vorhersage- und Optimierungsbereiche, sofern ausgewählt.
- PDF-Export über Download.
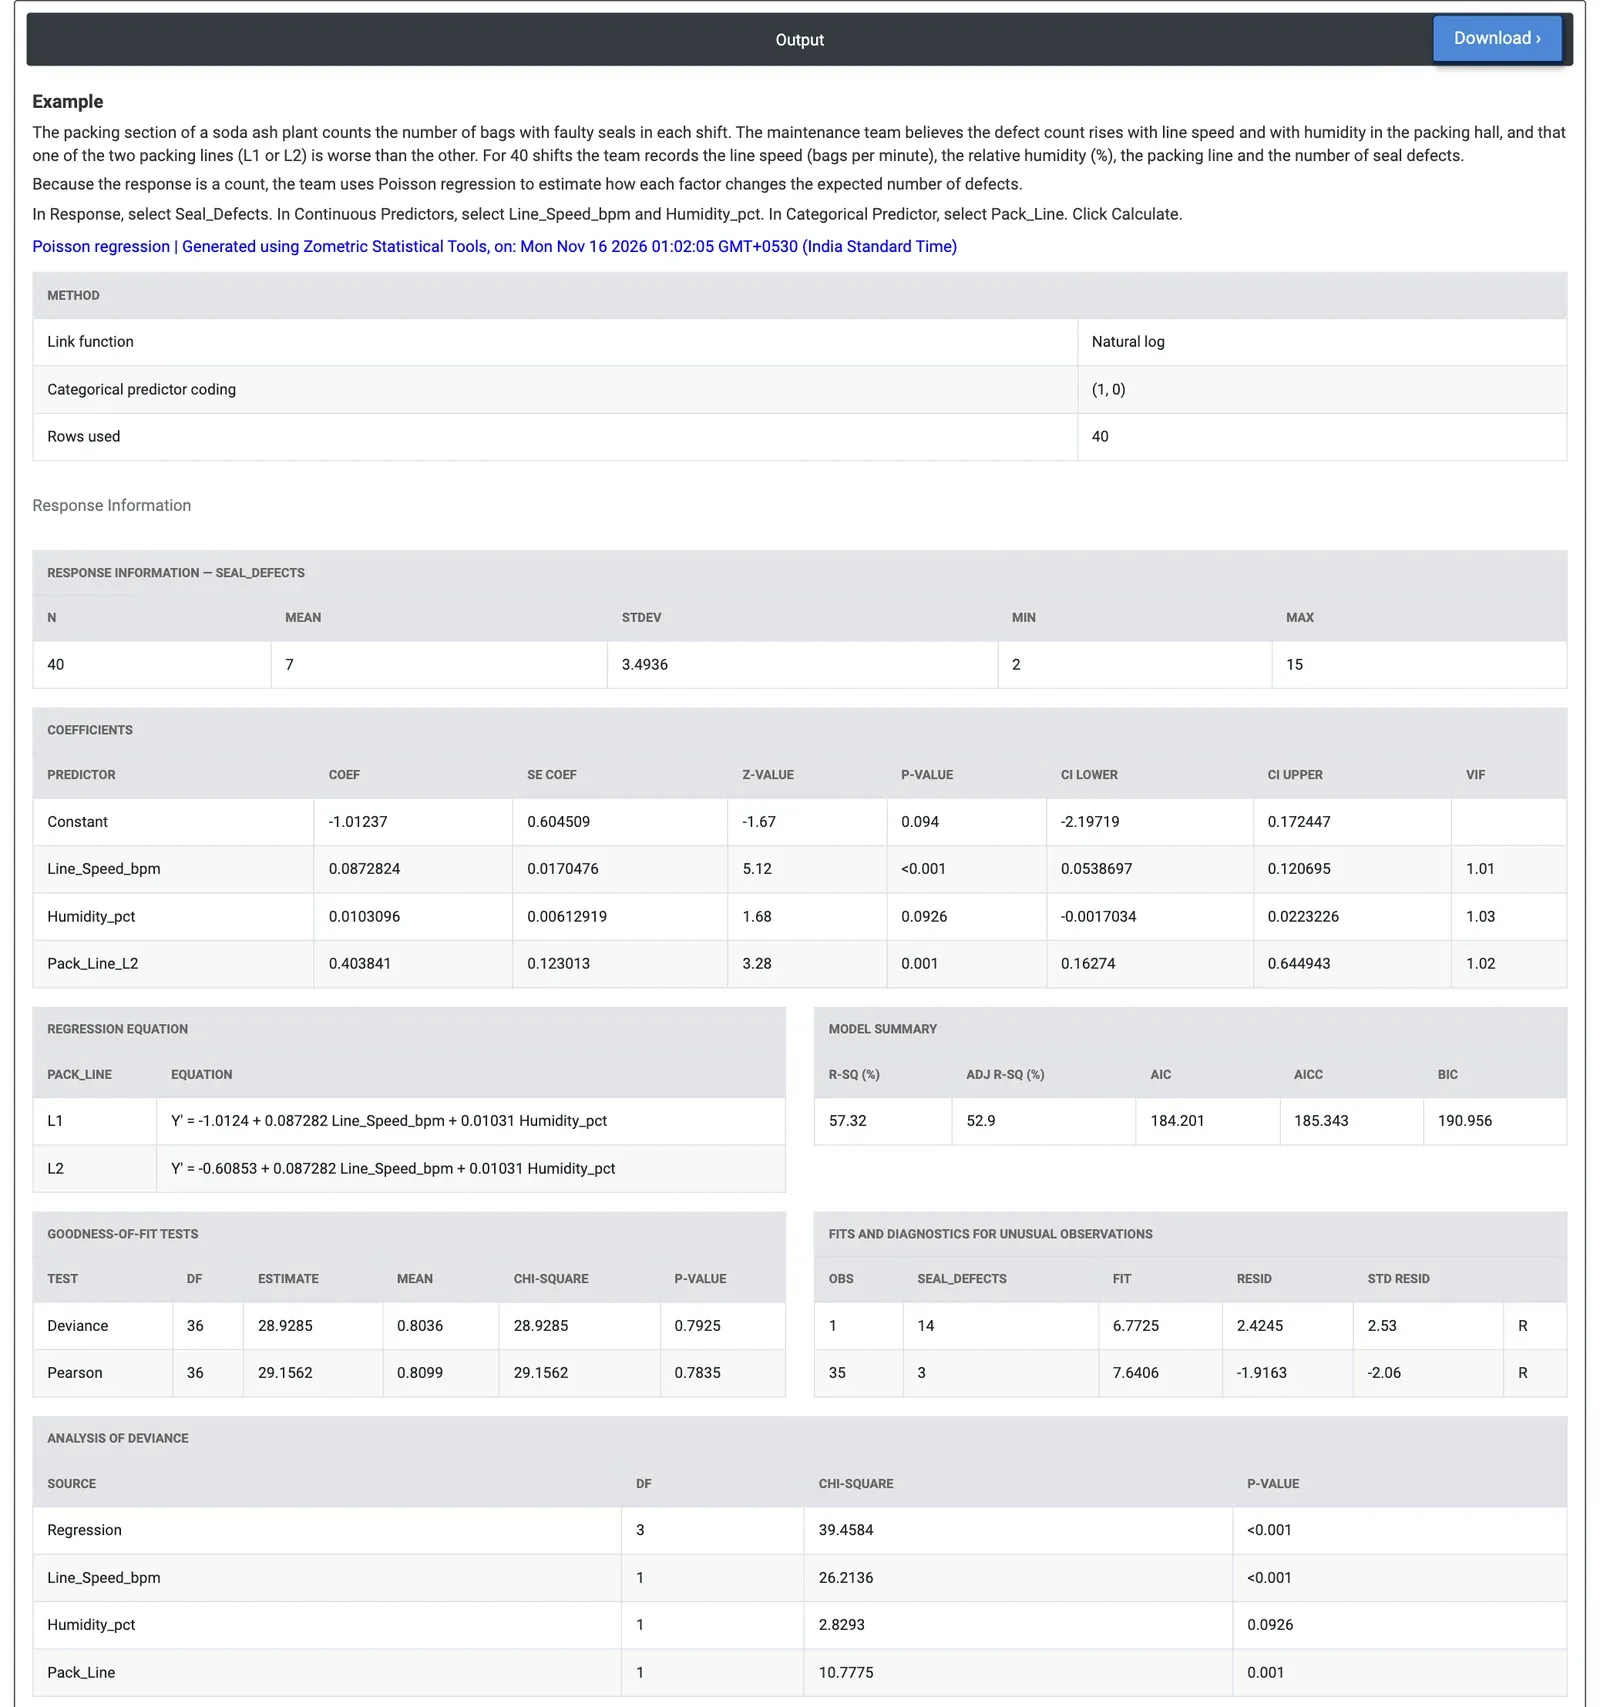
Abbildung 2: Poisson-Regression der Verschweißungsfehler je Schicht: Liniengeschwindigkeit (p < 0.001) und Packlinie (p = 0.001) sind von Bedeutung, die Luftfeuchtigkeit auf dem 5-%-Niveau nicht (p = 0.0926).
Beispiel
Die Verpackungsabteilung eines Sodawerks zählt in jeder Schicht die Säcke mit fehlerhafter Verschweißung. Für 40 Schichten erfasst das Team die Liniengeschwindigkeit (Säcke pro Minute), die Luftfeuchtigkeit in der Packhalle (%), die Packlinie (L1 oder L2) und die Anzahl der Verschweißungsfehler (2 bis 15, Mittelwert 7). Es wählt Seal_Defects als Zielgröße, Liniengeschwindigkeit und Luftfeuchtigkeit als stetige Prädiktoren und Pack_Line als kategorialen Prädiktor und behält die Log-Linkfunktion bei.
Die Liniengeschwindigkeit hat den stärksten Effekt (Wald-Chi-Quadrat 26.21, p < 0.001): Ihr Koeffizient 0.0873 bedeutet, dass jeder zusätzliche Sack pro Minute die erwarteten Fehler mit exp(0.0873) = 1.09 multipliziert, und 5 Säcke pro Minute mehr mit etwa 1.55. Linie L2 hat den Koeffizienten 0.404 (p = 0.001) und verursacht damit bei gleicher Geschwindigkeit und Luftfeuchtigkeit etwa 1.50-mal so viele Verschweißungsfehler wie L1. Die Luftfeuchtigkeit weist in dieselbe Richtung (etwa 11% mehr Fehler je 10% relative Feuchte), ist aber auf dem 5-%-Niveau nicht signifikant (p = 0.0926).
Das Modell passt zu den Anzahlen: Devianz-Chi-Quadrat 28.93 bei 36 DF (p = 0.7925) und Pearson 29.16 (p = 0.7835), mit einem Mean unter 1; es gibt also keinen Hinweis auf Überdispersion. Zwei Schichten werden gekennzeichnet: Schicht 1 mit 14 Fehlern gegenüber einem angepassten Wert von 6.8 und Schicht 35 mit 3 gegenüber 7.6. Das Team prüft zuerst die Schweißbacken an L2 und den Sollwert der Geschwindigkeit und sammelt weiter Daten zur Luftfeuchtigkeit, bevor es über eine Entfeuchtung entscheidet.
Häufig gestellte Fragen
Wann sollte man die Poisson-Regression statt der Regression nach der Methode der kleinsten Quadrate verwenden?
Verwenden Sie die Poisson-Regression, wenn die Zielgröße eine Anzahl von Ereignissen in einer festen Zeit, Fläche oder Produktmenge ist, etwa Fehler je Schicht oder Ausfälle je Monat. Anzahlen können nicht negativ sein, und ihre Streuung wächst mit ihrem Mittelwert, was die Regression nach der Methode der kleinsten Quadrate nicht berücksichtigt. Die Poisson-Regression behandelt dies als verallgemeinertes lineares Modell, angepasst nach der Maximum-Likelihood-Methode.
Wie interpretiert man die Koeffizienten einer Poisson-Regression?
Mit der standardmäßigen Log-Linkfunktion ist ln der erwarteten Anzahl gleich b0 + b1x1 + ..., sodass jeder Koeffizient die erwartete Anzahl je Einheit Zunahme seines Prädiktors mit exp(b) multipliziert. Ein Koeffizient der Liniengeschwindigkeit von 0.0873 bedeutet zum Beispiel, dass jeder zusätzliche Sack pro Minute die erwarteten Fehler mit exp(0.0873) = 1.09 multipliziert. Kategoriale Prädiktoren werden mit einer Referenzstufe verglichen.
Wie prüft man eine Poisson-Regression auf Überdispersion?
Die Anpassungstests vergleichen die Devianz und das Pearson-Chi-Quadrat mit einer Chi-Quadrat-Verteilung mit den Freiheitsgraden des Fehlers. Ein kleiner p-Wert oder ein Mean (Devianz geteilt durch DF) deutlich über 1 bedeutet, dass die Anzahlen stärker streuen, als ein Poisson-Modell zulässt. In diesem Fall sind die p-Werte der Modellterme zu klein, und man sollte ihnen nicht vertrauen.
Wie werden ungewöhnliche Beobachtungen in der Poisson-Regression gekennzeichnet?
Beobachtungen mit einem standardisierten Residuum jenseits von plus oder minus 2 werden mit R gekennzeichnet, Beobachtungen mit einer Hebelwirkung über 3p/n mit X. Sie werden in der Tabelle Fits and Diagnostics for Unusual Observations aufgeführt, und Residuendiagramme wie Residuen gegen angepasste Werte und ein Normalverteilungs-Wahrscheinlichkeitsnetz der Residuen können hinzugefügt werden, um sie näher zu untersuchen.