
Power und Stichprobenumfang für den gepaarten Äquivalenztest
Plant einen gepaarten Äquivalenztest, bei dem jede Einheit zweimal gemessen wird, etwa mit einem neuen und einem Referenzprüfmittel, und gezeigt werden muss, dass die mittlere Differenz vernachlässigbar klein ist. Geben Sie Äquivalenzgrenzen, die Standardabweichung der paarweisen Differenzen und zwei der drei Größen Anzahl der Paare, Differenz und Power ein; das Werkzeug berechnet die dritte mit der exakten TOST-Power. Ausgegeben werden eine Ergebnistabelle und eine Powerkurve.
Zuletzt geprüft
Kernaussage
Power and Sample Size for Paired Equivalence Test berechnet, wie viele Paare nötig sind, um mit zwei einseitigen t-Tests (TOST) zu zeigen, dass die mittlere paarweise Differenz innerhalb eines Äquivalenzfensters liegt.
Auf dieser Seite
Zweck
Power and Sample Size for Paired Equivalence Test plant eine Studie, in der jede Einheit zweimal gemessen wird, zum Beispiel mit einer neuen und einer Referenzmethode, vor und nach einer Prozessänderung oder auf zwei Vorrichtungen, und in der gezeigt werden soll, dass die mittlere paarweise Differenz vernachlässigbar klein ist. Sie legen ein Äquivalenzfenster für die mittlere Differenz fest, und das Werkzeug sagt Ihnen, wie viele Paare nötig sind, welche Power (Trennschärfe) eine geplante Anzahl von Paaren liefert oder wie groß eine wahre Differenz sein darf. Geben Sie zwei der drei Größen Stichprobenumfang, Differenz und Power ein, und das Werkzeug berechnet die dritte. Verwenden Sie es vor einem gepaarten Äquivalenztest.
Wichtigste Funktionen
- Berechnet Stichprobenumfang (Anzahl der Paare), Power oder Differenz: Lassen Sie die gesuchte Größe leer.
- Mehrere Werte gleichzeitig, z. B. Stichprobenumfänge „10 20 30“, ergeben je Kombination eine Zeile.
- Beliebiges Äquivalenzfenster, symmetrisch oder nicht.
- Exakte Power für das Verfahren der zwei einseitigen Tests (TOST) auf die paarweisen Differenzen.
- Powerkurve der Power gegen die Anzahl der Paare für jede Differenz, mit markierten berechneten Punkten.
Statistische Methoden
Eine gepaarte Studie wird über die Differenzen innerhalb jedes Paares (Test − Referenz) ausgewertet; die Berechnung ist daher der TOST für eine Stichprobe, angewendet auf diese Differenzen. Mit n Paaren und der Standardabweichung der Differenzen σ_d ist der Standardfehler SE = σ_d/√n mit n − 1 Freiheitsgraden. Äquivalenz wird festgestellt, wenn gezeigt ist, dass die mittlere Differenz über der unteren Grenze L und unter der oberen Grenze U liegt, jeweils mit einem einseitigen t-Test auf dem Signifikanzniveau α (Feld Significance level (alpha), Standard 0.05).
Die Power ist die Wahrscheinlichkeit, dass beide einseitigen Tests erfolgreich sind, wenn die wahre mittlere Differenz δ beträgt. Sie wird exakt berechnet: Für eine gegebene Stichprobenstandardabweichung der Differenzen s ist die Erfolgswahrscheinlichkeit Φ(−t·s/σ_d − (δ − U)/SE) − Φ(t·s/σ_d − (δ − L)/SE), mit t = t₁₋α,n−1, und dieser Wert wird durch numerische Integration über die Chi-Quadrat-Verteilung der Stichprobenvarianz gemittelt. Für den Stichprobenumfang wird die Anzahl der Paare ermittelt, die die Zielpower erreicht, und aufgerundet; die Power bei dieser Anzahl wird als tatsächliche Power ausgegeben. Bei der Berechnung der Differenz sucht das Werkzeug zwischen dem Mittelpunkt der Grenzen und der oberen Grenze.
Einzugeben ist die Standardabweichung der paarweisen Differenzen, nicht die der einzelnen Messwerte. Paarung lohnt sich, wenn die beiden Messungen an einer Einheit stark zusammenhängen, denn σ_d ist dann viel kleiner als die Streuung von Einheit zu Einheit. Die Differenz muss echt zwischen den Grenzen liegen; die Power ist im Mittelpunkt des Fensters am höchsten.
Eingabefelder und Optionen
Feld | Beschreibung |
Sample sizes | Anzahl der Paare. Durch Leerzeichen oder Komma getrennt, z. B. „20 30 40“. Leer lassen, um den Stichprobenumfang zu berechnen. |
Difference(s) to detect | Durch Leerzeichen oder Komma getrennt, z. B. „0.5 0.7“. Die erwartete wahre mittlere paarweise Differenz; sie muss echt zwischen den Grenzen liegen. Leer lassen, um sie zu berechnen (Suche zwischen dem Mittelpunkt der Grenzen und der oberen Grenze). |
Power values | Durch Leerzeichen oder Komma getrennt, z. B. „0.8 0.9“. Leer lassen, um die Power zu berechnen. |
Lower equivalence limit / Upper equivalence limit | Erforderlich. Die kleinste und größte zulässige mittlere Differenz; die untere Grenze muss kleiner als die obere sein. |
Standard deviation of the differences | Erforderlich. Angenommene oder historische Standardabweichung der paarweisen Differenzen. |
Significance level (alpha) | Standard 0.05. Gilt für jeden der beiden einseitigen Tests. |
Power curve | Standardmäßig aktiviert: zeichnet die Power gegen den Stichprobenumfang. |
Title | Titel, der in der Ausgabe und auf der Powerkurve angezeigt wird. |
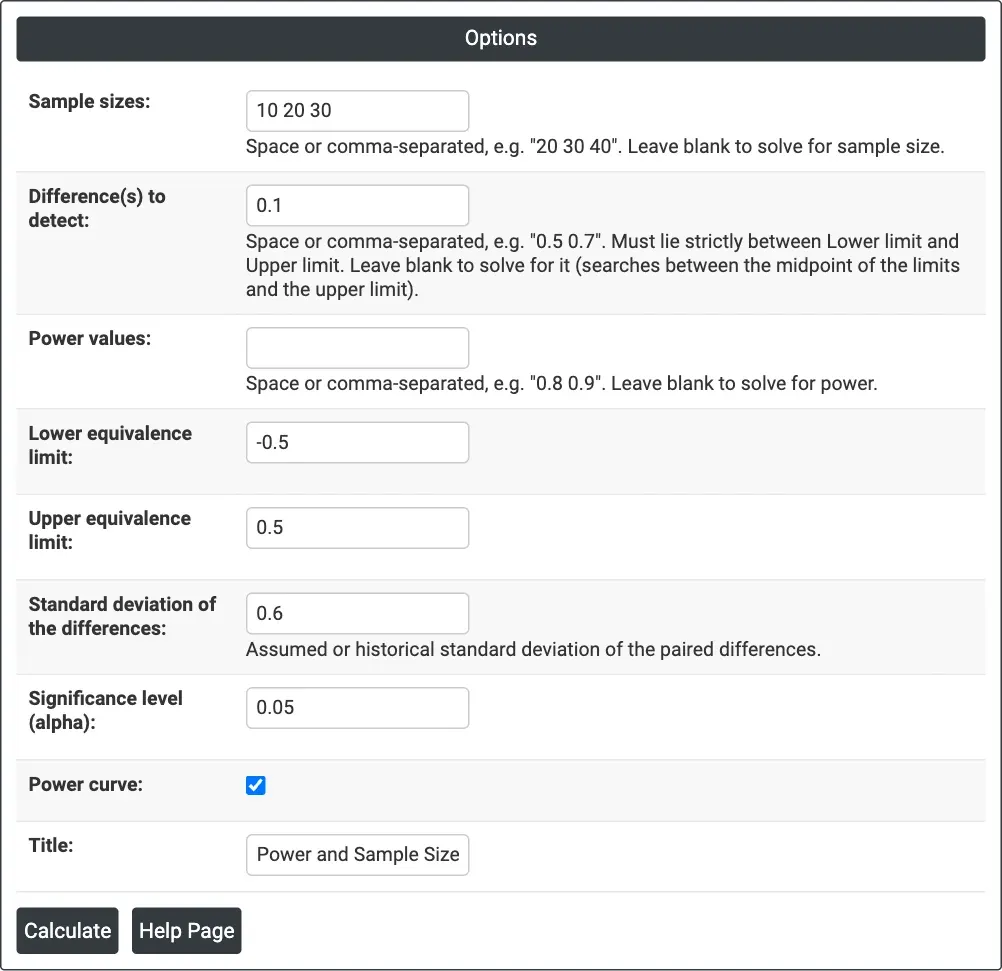
Abbildung 1 – Berechnung der Power: Sample sizes = 10 20 30, Difference(s) to detect = 0.1, Grenzen −0.5 und 0.5, Standard deviation of the differences = 0.6, alpha = 0.05.
Beschreibung der Ausgaben
- Settings: was berechnet wurde, untere und obere Äquivalenzgrenze, Standardabweichung der Differenzen und Signifikanzniveau.
- Results: eine Zeile je Kombination: Differenz, Stichprobenumfang (Paare) und Power bei Berechnung der Power, Ziel- und tatsächliche Power bei Berechnung des Stichprobenumfangs oder Differenz bei Berechnung der Differenz.
- Power Curve: Power gegen Stichprobenumfang für jede Differenz, mit markierten berechneten Punkten.
- PDF-Export über Download.
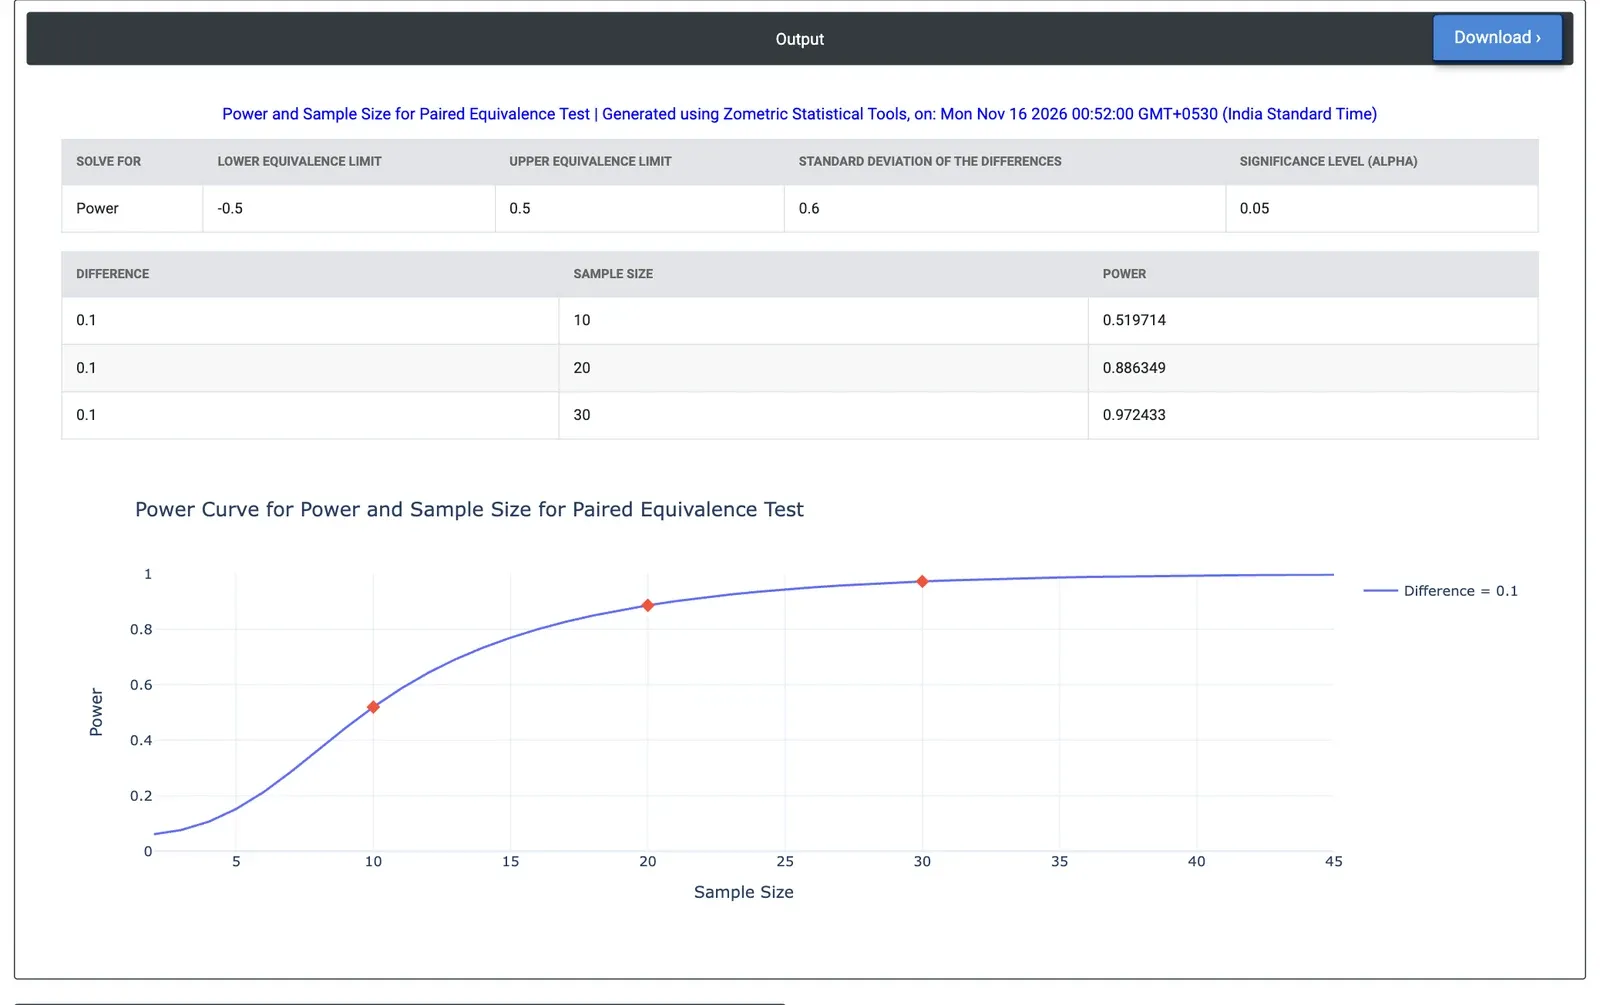
Abbildung 2 – Ergebnisse für das Beispiel: Power 0.520, 0.886 und 0.972 für 10, 20 und 30 Prüfbleche, wenn der wahre Bias 0.1 µm innerhalb eines Fensters von ±0.5 µm beträgt.
Beispiel
Eine Lackiererei möchte ihr Referenzmessgerät für die Schichtdicke durch ein günstigeres Handgerät ersetzen. Jedes Prüfblech wird mit beiden Geräten gemessen, und das Handgerät ist annehmbar, wenn sein mittlerer Bias innerhalb von ±0.5 µm liegt. Ein Vorversuch ergab eine Standardabweichung der paarweisen Differenzen von 0.6 µm, und der erwartete Bias beträgt etwa 0.1 µm. Die Messtechnikerin gibt Sample sizes = 10 20 30, Difference(s) to detect = 0.1, Lower equivalence limit = −0.5, Upper equivalence limit = 0.5 und Standard deviation of the differences = 0.6 ein, lässt Power values leer und behält alpha = 0.05 bei.
Die Power beträgt 0.520 mit 10 Prüfblechen, 0.886 mit 20 und 0.972 mit 30. Bei zehn Prüfblechen bestünde etwa eine Wahrscheinlichkeit von eins zu zwei, ein tatsächlich annehmbares Messgerät abzulehnen. Die Berechnung des Stichprobenumfangs (Power values = 0.8 0.9) ergibt stattdessen 16 Prüfbleche für 80% Power und 21 für 90%. Beträgt der Bias tatsächlich 0.2 µm, ergeben 20 Prüfbleche eine Power von 0.695; ganz ohne Bias ergeben sie 0.948.
Häufig gestellte Fragen
Wie wird eine Poweranalyse für einen gepaarten Äquivalenztest berechnet?
Eine gepaarte Studie wird über die Differenzen innerhalb jedes Paares (Test minus Referenz) ausgewertet; die Berechnung ist daher ein TOST für eine Stichprobe, angewendet auf diese Differenzen. Äquivalenz wird festgestellt, wenn gezeigt ist, dass die mittlere Differenz über der unteren und unter der oberen Grenze liegt, jeweils mit einem einseitigen t-Test beim gewählten Alpha. Die Power wird durch numerische Integration exakt berechnet.
Welche Standardabweichung sollten Sie für einen gepaarten Äquivalenztest eingeben?
Geben Sie die Standardabweichung der paarweisen Differenzen ein, nicht die der einzelnen Messwerte. Paarung lohnt sich, wenn die beiden Messungen an einer Einheit stark zusammenhängen, denn die Standardabweichung der Differenzen ist dann viel kleiner als die Streuung von Einheit zu Einheit, was die Anzahl der benötigten Paare verringert.
Wie viele Paare sind für einen gepaarten Äquivalenztest nötig?
In einem Beispiel mit einem Fenster von plus/minus 0.5 Mikrometer, einer Standardabweichung der Differenzen von 0.6 und einem erwarteten Bias von 0.1 ergeben 16 Prüfbleche 80% Power und 21 ergeben 90%. Die Power beträgt 0.520 mit 10 Prüfblechen, 0.886 mit 20 und 0.972 mit 30. Ein größerer Bias von 0.2 senkt die Power bei 20 Prüfblechen auf 0.695.
Warum muss die Differenz echt zwischen den Äquivalenzgrenzen liegen?
Eine wahre mittlere Differenz auf oder jenseits einer Grenze kann nie als äquivalent nachgewiesen werden; die erwartete Differenz muss daher echt zwischen der unteren und der oberen Grenze liegen. Die Power ist am höchsten, wenn die wahre Differenz im Mittelpunkt des Fensters liegt, und sinkt, je näher sie einer der beiden Grenzen kommt.