
Verteilungsdiagramm (Probability Distribution Plot)
Das Verteilungsdiagramm zeichnet die Dichte-, Wahrscheinlichkeits- oder Verteilungsfunktion einer theoretischen Verteilung aus eingegebenen Parametern, ohne Daten. Es umfasst zwölf Verteilungen, darunter Normal, t, Chi-Quadrat, F, Weibull, Lognormal, Binomial und Poisson. Verwenden Sie es, um die Form einer Verteilung zu sehen, einen Stichprobenplan oder eine Teststatistik zu erklären oder Wahrscheinlichkeiten abzulesen. Stetige Verteilungen erscheinen als Kurven, Binomial und Poisson als Balken.
Zuletzt geprüft
Kernaussage
Ein Verteilungsdiagramm zeichnet die Dichte- (oder Wahrscheinlichkeits-) bzw. Verteilungsfunktion einer theoretischen Verteilung, etwa Normal, Weibull oder Binomial, aus eingegebenen Parametern, ganz ohne Daten.
Auf dieser Seite
Zweck
Das Verteilungsdiagramm (Probability Distribution Plot) zeichnet die Kurve einer theoretischen Verteilung für die von Ihnen eingegebenen Parameter: ihre Wahrscheinlichkeitsdichte (bzw. bei Zählwerten ihre Wahrscheinlichkeitsfunktion) oder ihre Verteilungsfunktion. Es werden keine Daten benötigt. Verwenden Sie es, um zu sehen, wie eine Verteilung aussieht, bevor Sie sie verwenden, um einen Stichprobenplan oder eine Teststatistik zu erklären oder um abzulesen, wie wahrscheinlich eine Anzahl oder ein Messwert unter einem angenommenen Modell ist, zum Beispiel die Anzahl fehlerhafter Einheiten in einer Stichprobe von 50, wenn der Prozess mit 4% fehlerhaften Einheiten läuft.
Wichtigste Funktionen
- Zwölf Verteilungen: Normal, Student-t, Chi-Quadrat, F, Exponential, Weibull, Lognormal, Gleichverteilung (Uniform), Gamma, Beta, Binomial und Poisson.
- Wahrscheinlichkeitsdichte-/Wahrscheinlichkeitsfunktion oder Verteilungsfunktion.
- Stetige Verteilungen werden als glatte Kurve gezeichnet (die Dichte ist schattiert); Binomial und Poisson werden als Balken bei jeder ganzen Zahl gezeichnet.
- Der horizontale Bereich wird automatisch so gewählt, dass er die Verteilung vom 0.05. bis zum 99.95. Perzentil abdeckt.
- Titel aus Verteilung und Kurve generiert oder Ihr eigener Titel.
Statistische Methoden
Das Werkzeug bildet die gewählte Verteilung aus den Parametern und wertet sie mit Standardformeln aus. Die Parameter sind: Normal: Parameter 1 = Mittelwert, Parameter 2 = Standardabweichung; Student-t und Chi-Quadrat: Freiheitsgrade; F: Zähler- und Nennerfreiheitsgrade; Exponential: Skala (der Mittelwert); Weibull und Gamma: Form und Skala; Lognormal: Lage und Form, d. h. Mittelwert und Standardabweichung von ln(X); Uniform: untere und obere Grenze; Beta: die beiden Formparameter α und β; Binomial: Anzahl der Versuche n und Ereigniswahrscheinlichkeit p; Poisson: Mittelwert λ. Verteilungen mit einem Parameter verwenden nur Parameter 1.
Bei einer stetigen Verteilung wird die Kurve an 500 gleichmäßig verteilten Punkten zwischen ihrem 0.05. und 99.95. Perzentil ausgewertet. Bei Binomial und Poisson wird sie an jeder ganzen Zahl in diesem Bereich ausgewertet: Die Wahrscheinlichkeitsfunktion P(X = k) gibt die Höhe jedes Balkens an, und die Verteilungsfunktion P(X ≤ k) gibt die Höhe jedes Balkens im CDF-Diagramm an. Bei einer Dichte ist die Fläche unter der Kurve über einem Intervall die Wahrscheinlichkeit, in dieses Intervall zu fallen; die Verteilungsfunktion liefert diese Wahrscheinlichkeit direkt als Differenz zweier Höhen.
Eingabefelder und Optionen
Feld | Beschreibung |
Distribution | Erforderlich. Normal, Student's t, Chi-Square, F, Exponential, Weibull, Lognormal, Uniform, Gamma, Beta, Binomial oder Poisson. |
Parameter 1 | Die Bedeutung hängt von der Verteilung ab: z. B. Mittelwert bei Normal, Freiheitsgrade bei t und Chi-Quadrat, Form bei Weibull und Gamma, Anzahl der Versuche bei Binomial, Mittelwert bei Poisson. |
Parameter 2 | Wird nur von Verteilungen mit zwei Parametern verwendet: z. B. Standardabweichung bei Normal, Skala bei Weibull und Gamma, Ereigniswahrscheinlichkeit bei Binomial. |
Plot | Probability density/mass function (Standard) oder Cumulative distribution function. |
Title | Optional. Standardmäßig ein aus der gewählten Verteilung und Kurve generierter Titel. |
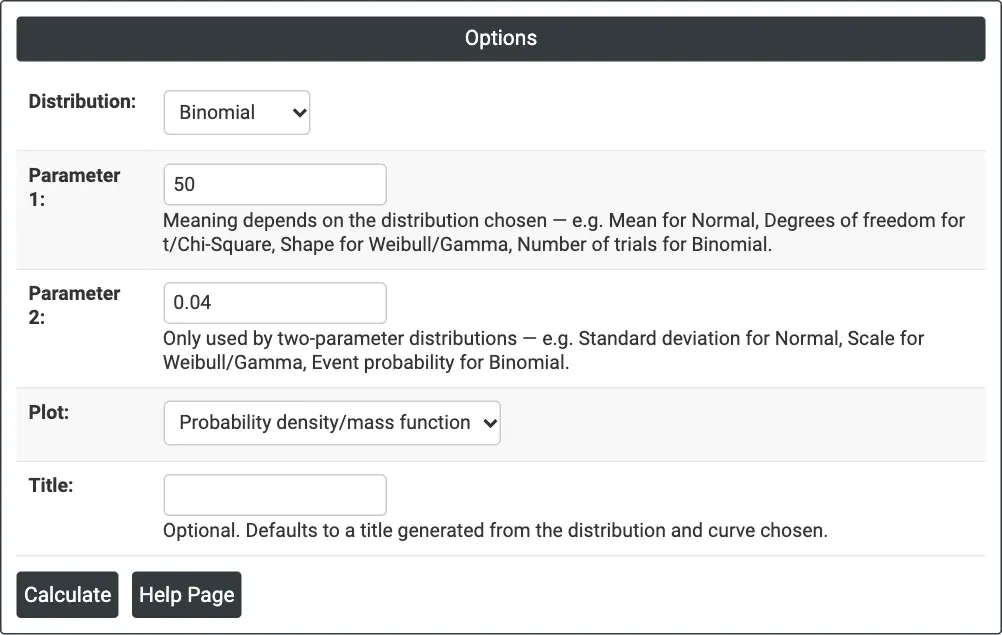
Abbildung 1 – Optionen für das Beispiel: Binomialverteilung mit 50 Versuchen und Ereigniswahrscheinlichkeit 0.04.
Beschreibung der Ausgaben
- <Distribution> Distribution — Probability Density: die Dichtekurve (Achse beschriftet mit Probability density); bei Binomial und Poisson <Distribution> Distribution — Probability Mass, mit der Wahrscheinlichkeit jeder Anzahl als Balken (Achse beschriftet mit Probability).
- <Distribution> Distribution — Cumulative Distribution: die kumulierte Wahrscheinlichkeit P(X ≤ x).
- PDF-Export über Download.
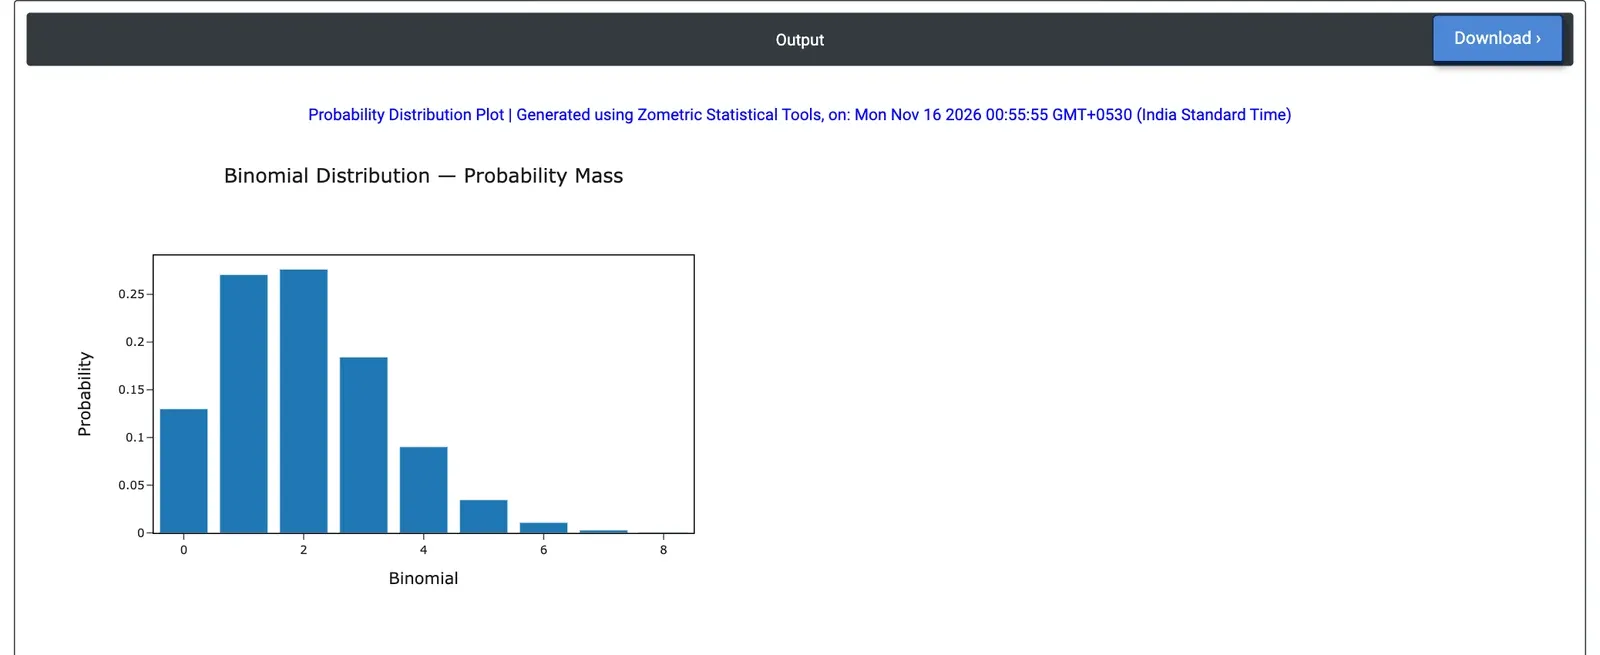
Abbildung 2 – Wahrscheinlichkeit für 0 bis 8 fehlerhafte Einheiten in einer Stichprobe von 50, wenn der Prozess 4% fehlerhafte Einheiten liefert (Binomial, n = 50, p = 0.04).
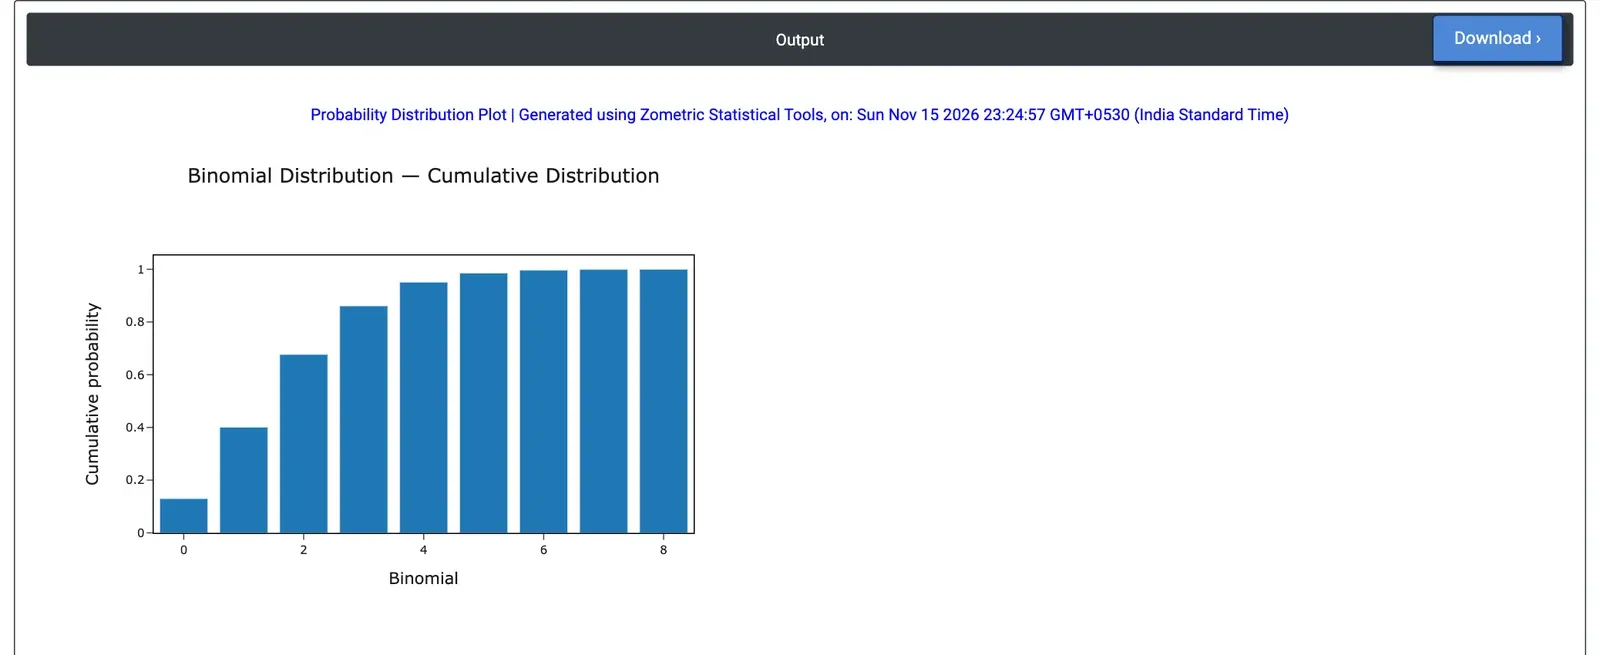
Abbildung 3 – Dieselbe Verteilung mit Plot = Cumulative distribution function: P(X ≤ k) für k = 0 bis 8.
Beispiel
Der Prozess eines Lieferanten läuft mit etwa 4% fehlerhaften Einheiten. Die Wareneingangsprüfung entnimmt jedem Los eine Stichprobe von 50 Teilen, und die Qualitätsingenieurin möchte wissen, wie viele fehlerhafte Einheiten zu erwarten sind und wie oft ein Los aus diesem Prozess 3 oder mehr aufweisen würde. Distribution = Binomial, Parameter 1 = 50 (Versuche), Parameter 2 = 0.04 (Ereigniswahrscheinlichkeit), Plot = Probability density/mass function.
Die Balken reichen von 0 bis 8 fehlerhaften Einheiten. Die wahrscheinlichsten Anzahlen sind 1 (Wahrscheinlichkeit 0.271) und 2 (0.276), passend zum Mittelwert n·p = 2. Eine Stichprobe ohne fehlerhafte Einheiten tritt in 13.0% der Fälle auf; eine fehlerfreie Stichprobe sagt also wenig darüber aus, ob sich der Prozess verbessert hat. Wird Plot auf Cumulative distribution function umgestellt, ergibt sich P(X ≤ 2) = 0.677; 32.3% der Stichproben aus diesem Prozess würden also 3 oder mehr fehlerhafte Einheiten enthalten und 13.9% 4 oder mehr.
Für den Prüfplan bedeutet das: Eine Annahmezahl von 2 würde etwa jedes dritte Los zurückweisen, selbst wenn der Lieferant mit seinen normalen 4% arbeitet. Sollen solche Lose in der Regel angenommen werden, muss die Annahmezahl höher sein oder der Stichprobenplan neu ausgelegt werden; die Werkzeuge zur Annahmestichprobenprüfung (Acceptance Sampling) und zur AQL berechnen dies anhand der vereinbarten Qualitätslagen.
Häufig gestellte Fragen
Wofür wird ein Verteilungsdiagramm verwendet?
Es zeigt, wie eine theoretische Verteilung für gegebene Parameter aussieht, ganz ohne Daten. Verwenden Sie es, um die Form einer Verteilung zu sehen, bevor Sie sie verwenden, um einen Stichprobenplan oder eine Teststatistik zu erklären oder um abzulesen, wie wahrscheinlich eine Anzahl oder ein Messwert unter einem angenommenen Modell ist, etwa die Anzahl fehlerhafter Einheiten in einer Stichprobe von 50 aus einem Prozess mit 4% fehlerhaften Einheiten.
Welche Verteilungen kann ein Verteilungsdiagramm darstellen?
Zwölf: Normal, Student-t, Chi-Quadrat, F, Exponential, Weibull, Lognormal, Gleichverteilung, Gamma, Beta, Binomial und Poisson. Parameter 1 und Parameter 2 hängen von der Verteilung ab, zum Beispiel Mittelwert und Standardabweichung bei der Normalverteilung, Form und Skala bei Weibull und Gamma sowie Anzahl der Versuche und Ereigniswahrscheinlichkeit bei der Binomialverteilung. Verteilungen mit einem Parameter verwenden nur Parameter 1.
Was ist der Unterschied zwischen dem PDF- und dem CDF-Diagramm?
Die Wahrscheinlichkeitsdichte- (bzw. Wahrscheinlichkeits-)funktion zeigt die Höhe der Verteilung bei jedem Wert; bei einer Dichte ist die Fläche unter der Kurve über einem Intervall die Wahrscheinlichkeit, in dieses Intervall zu fallen, und bei Binomial oder Poisson ist jeder Balken P(X = k). Die Verteilungsfunktion zeigt P(X kleiner oder gleich x), sodass eine Wahrscheinlichkeit die Differenz zweier Höhen ist.
Wie lesen Sie ein Diagramm der Binomialverteilung?
In einem Beispiel mit 50 Versuchen und einer Ereigniswahrscheinlichkeit von 0.04 sind die wahrscheinlichsten Anzahlen 1 (0.271) und 2 (0.276), passend zum Mittelwert n mal p = 2, und null fehlerhafte Einheiten treten in 13.0% der Fälle auf. Das kumulierte Diagramm ergibt P(X kleiner oder gleich 2) = 0.677; 32.3% der Stichproben würden also 3 oder mehr fehlerhafte Einheiten enthalten.