
Wahrscheinlichkeitsnetz (Probability Plot)
Das Wahrscheinlichkeitsnetz (Probability Plot) prüft, ob Daten zu einer Verteilung passen, indem es die geordneten Werte auf einer Skala darstellt, auf der die Verteilung als Gerade erscheint, mit Konfidenzgrenzen. Es unterstützt neun Verteilungen, darunter Normal, Lognormal, Weibull und Exponential, und gibt für jede die Anderson-Darling-Statistik und den p-Wert aus. Verwenden Sie es vor Prozessfähigkeitsanalysen, Eingriffsgrenzen oder t-Tests, die Normalverteilung voraussetzen, und zur Wahl einer Zuverlässigkeitsverteilung.
Zuletzt geprüft
Kernaussage
Ein Wahrscheinlichkeitsnetz prüft, ob Daten einer gewählten Verteilung folgen, meist der Normalverteilung: Geordnete Daten liegen auf einer Skala, auf der diese Verteilung eine Gerade ist, mit Anderson-Darling-Statistik und p-Wert.
Auf dieser Seite
Zweck
Das Wahrscheinlichkeitsnetz (Probability Plot) prüft, ob Daten einer gewählten Verteilung folgen, meist der Normalverteilung. Die geordneten Daten werden auf einer Skala dargestellt, auf der die gewählte Verteilung als Gerade erscheint: Folgen die Punkte der Linie, passt die Verteilung. Verwenden Sie es vor Prozessfähigkeitsanalysen, Eingriffsgrenzen, Toleranzintervallen oder t-Tests, die Normalverteilung voraussetzen, und zur Wahl einer Verteilung (Weibull, Lognormal, Exponential) für Zuverlässigkeitsanalysen oder Prozessfähigkeitsanalysen bei nicht normalverteilten Daten.
Wichtigste Funktionen
- Neun Verteilungen: Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic und Loglogistic.
- Angepasste Referenzlinie mit punktweisen Konfidenzgrenzen auf einem gewählten Niveau (Standard 95%).
- Anderson-Darling-Statistik (AD) und ihr p-Wert in der Legende für jede Verteilung, sodass sich die Anpassungen vergleichen lassen.
- Mehrere Variablen in einem Diagramm überlagert oder eine Variable über eine By-Spalte in Gruppen aufgeteilt, jeweils mit eigener angepasster Linie.
- Logarithmische Datenachse für Lognormal, Weibull und Loglogistic, wie auf üblichem Wahrscheinlichkeitspapier.
Statistische Methoden
Für jede Variable bzw. Gruppe (mindestens 3 Werte) werden die Daten sortiert, x₍₁₎ ≤ … ≤ x₍ₙ₎, und jedem Wert wird die Plotposition pᵢ = (i − 0.3) / (n + 0.4) zugewiesen, die Median-Rang-Näherung nach Benard. Die vertikale Achse ist die inverse Verteilungsfunktion der gewählten Verteilung, beschriftet in Prozent, sodass eine Stichprobe aus dieser Verteilung nahe an einer Geraden liegt. Die Referenzlinie ist die angepasste Verteilungsfunktion: für die Normalverteilung Mittelwert und Standardabweichung der Stichprobe (Divisor n − 1); für die übrigen Verteilungen die Maximum-Likelihood-Schätzung, mit auf 0 festgesetztem Schwellenwert für Lognormal, Weibull, Exponential und Loglogistic (diese benötigen positive Werte).
Die Konfidenzgrenzen werden durch jeden Punkt gezogen: Beim Niveau C ist die untere Grenze das α/2-Quantil einer Beta(i, n − i + 1)-Verteilung und die obere Grenze das 1 − α/2-Quantil einer Beta(i + 1, n − i)-Verteilung, mit α = 1 − C/100. Punkte außerhalb der Grenzen sprechen gegen die Verteilung.
Die Anderson-Darling-Statistik AD = −n − (1/n) Σ (2i − 1)[ln F(x₍ᵢ₎) + ln(1 − F(x₍ₙ₊₁₋ᵢ₎))] misst, wie weit die Punkte von der angepassten Verteilungsfunktion F entfernt sind, mit zusätzlicher Gewichtung der Ränder; kleiner ist besser. Die Legende zeigt diese nicht korrigierte AD-Statistik für jede Verteilung, wie Minitab. Der p-Wert ergibt sich aus einer modifizierten Statistik nach D'Agostino und Stephens: für Normal und Lognormal (auf den Logarithmen) AD·(1 + 0.75/n + 2.25/n²), umgerechnet mit der Näherung nach Stephens; für Weibull und die beiden Extremwertverteilungen AD·(1 + 0.2/√n); für Exponential AD·(1 + 0.6/n); für Logistic und Loglogistic AD·(1 + 0.25/n). Die letzten drei werden in Stephens' Tabellen kritischer Werte nachgeschlagen und interpoliert; ein p-Wert außerhalb der Tabelle wird daher als Grenze angezeigt, etwa >0.250 oder <0.010. Bei 2-Parameter Exponential werden die n − 1 Abstände x₍ᵢ₎ − x₍₁₎ auf Exponentialverteilung getestet. Ein p-Wert unter 0.05 spricht dafür, dass die Daten der Verteilung nicht folgen; beim Vergleich von Verteilungen bedeutet der größere p-Wert in der Regel die bessere Anpassung.
Eingabefelder & Optionen
Feld | Beschreibung |
Variables | Pflichtfeld. Eine numerische Spalte oder mehrere zum Überlagern (ein „Multiple“-Wahrscheinlichkeitsnetz). |
By (grouping) column | Optional. Eine angepasste Linie je Gruppe. Wird nur verwendet, wenn eine einzelne Variable gewählt ist. |
Distribution | Normal (Standard), Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic oder Loglogistic. |
Confidence level (%) | Standard 95; 1 bis 99.99. Niveau der Konfidenzgrenzen. |
Display confidence interval bounds | Standardmäßig aktiviert. Zeichnet die Grenzen als gepunktete Linien. |
Title | Titel des Diagramms. Standard „Probability Plot“. |
Data Options: Subset (optional) | Exclude matching rows (Standard) oder Include only matching rows; Row numbers (z. B. 3,7,12-15) und/oder eine Condition (z. B. Tensile_Strength_MPa > 205) wählen die Zeilen aus. |
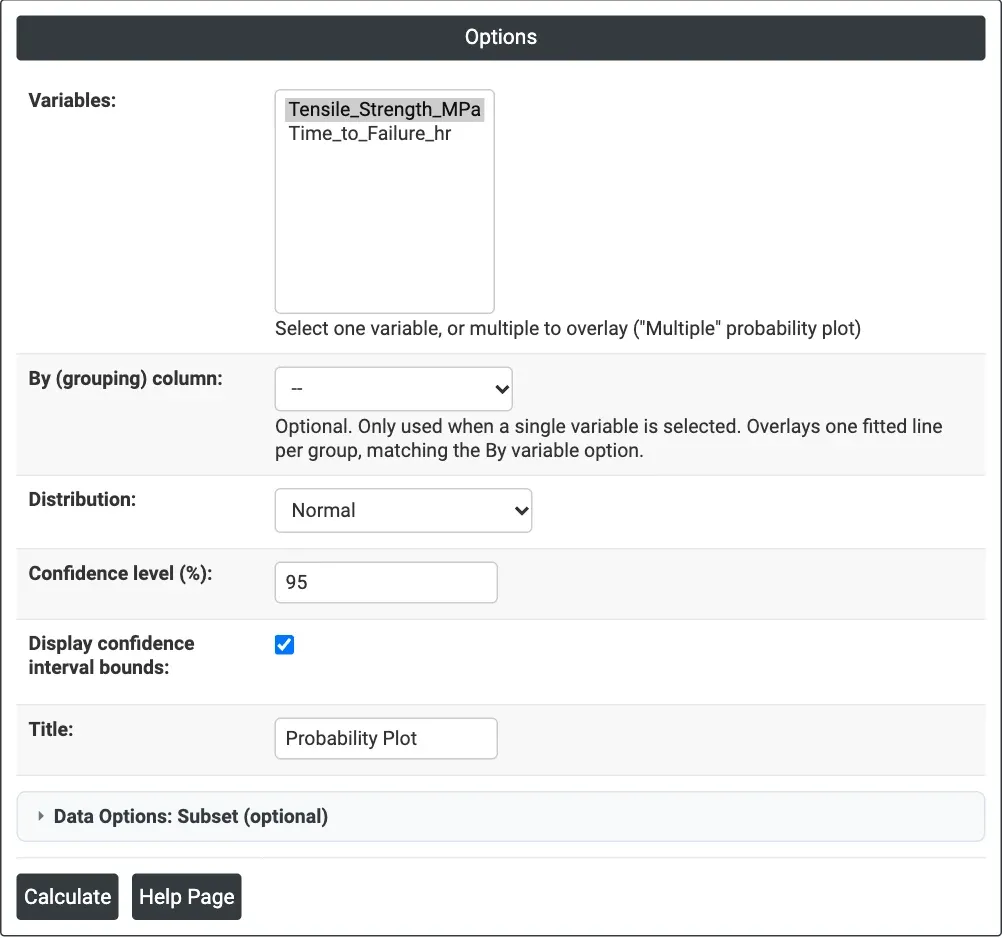
Abbildung 1 – Optionen für das Beispiel: Tensile_Strength_MPa in einem Normalverteilungs-Wahrscheinlichkeitsnetz mit 95%-Grenzen.
Beschreibung der Ausgabe
- Probability Plot – die Daten (horizontale Achse) gegen den Prozentsatz auf der Wahrscheinlichkeitsskala der Verteilung, mit angepasster Linie und gepunkteten Konfidenzgrenzen. Die Legende gibt für jede Reihe die AD-Statistik und ihren p-Wert an.
- PDF-Export über Download.
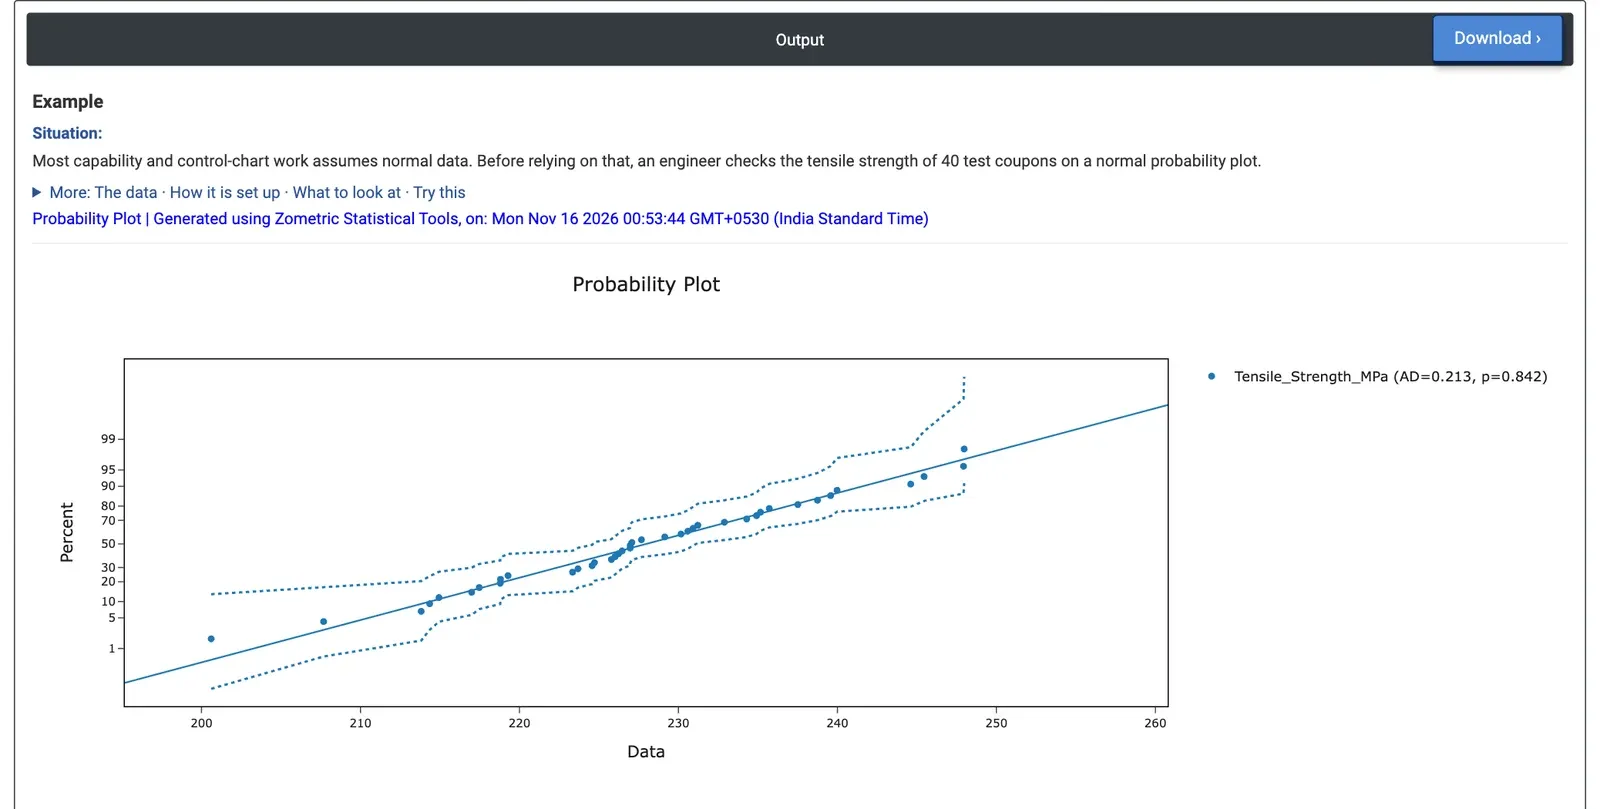
Abbildung 2 – Normalverteilungs-Wahrscheinlichkeitsnetz der Zugfestigkeit von 40 Proben: AD = 0.213, p = 0.842.
Beispiel
Bevor ein Ingenieur Eingriffsgrenzen festlegt und die Prozessfähigkeit berechnet, prüft er, ob die Zugfestigkeit von 40 Prüfproben als normalverteilt behandelt werden kann. Variables = Tensile_Strength_MPa, Distribution = Normal, Confidence level 95, Grenzen angezeigt.
Die Punkte folgen der Geraden und bleiben über den gesamten Bereich von 200.61 bis 247.97 MPa innerhalb der gepunkteten Grenzen. Die Legende zeigt AD = 0.213 mit p = 0.842, weit über 0.05: Es gibt keinen Hinweis gegen die Normalverteilung. Die angepasste Linie hat den Mittelwert 227.97 MPa und die Standardabweichung 10.61 MPa, sodass auf der Normalverteilung beruhende Methoden für Prozessfähigkeit und Regelkarten verwendet werden können. Punkte, die an einem der Enden von der Linie abbiegen, hätten auf eine schiefe Verteilung oder eine Verteilung mit schweren Rändern hingewiesen.
Dasselbe Arbeitsblatt enthält 40 Ausfallzeiten (Stunden). Wird Time_to_Failure_hr gegen mehrere Verteilungen aufgetragen, ergibt sich AD = 0.210 mit p > 0.250 für Weibull (Formparameter 3.23, Skalenparameter 192.96 Stunden), AD = 0.158 mit p = 0.947 für Normal, AD = 1.228 mit p < 0.005 für Lognormal und AD = 7.628 mit p < 0.010 für Exponential. Die Exponentialverteilung, die eine konstante Ausfallrate annimmt, passt eindeutig nicht, die Lognormalverteilung ebenso wenig. Weibull- und Normalverteilung passen beide gut; für Ausfallzeiten ist die Weibull-Verteilung die übliche Wahl, da ihr Formparameter über 1 Verschleiß beschreibt und sie keine negativen Lebensdauern vorhersagen kann.
Häufig gestellte Fragen
Wie interpretieren Sie ein Wahrscheinlichkeitsnetz?
Folgen die Punkte der angepassten Geraden und bleiben sie innerhalb der Konfidenzgrenzen, passt die Verteilung. Punkte außerhalb der Grenzen sprechen gegen sie, und Punkte, die an einem der Enden von der Linie abbiegen, deuten auf eine schiefe Verteilung oder eine Verteilung mit schweren Rändern hin. Die Legende gibt die Anderson-Darling-Statistik und den p-Wert an; ein p-Wert unter 0.05 spricht dafür, dass die Daten der Verteilung nicht folgen.
Wann sollten Sie ein Wahrscheinlichkeitsnetz verwenden?
Verwenden Sie es, um vor Prozessfähigkeitsanalysen, Eingriffsgrenzen, Toleranzintervallen oder t-Tests, die normalverteilte Daten voraussetzen, die Normalverteilung zu prüfen. Es dient auch zur Wahl einer Verteilung wie Weibull, Lognormal oder Exponential für Zuverlässigkeitsanalysen oder Prozessfähigkeitsanalysen bei nicht normalverteilten Daten. Jede Variable bzw. Gruppe benötigt mindestens 3 Werte, und mehrere Variablen oder Gruppen können überlagert werden.
Wie vergleichen Sie Verteilungen in einem Wahrscheinlichkeitsnetz?
Tragen Sie dieselben Daten gegen mehrere Verteilungen auf und vergleichen Sie die Anderson-Darling-Statistiken und p-Werte; eine kleinere AD-Statistik und ein größerer p-Wert bedeuten in der Regel eine bessere Anpassung. In einem Beispiel mit 40 Ausfallzeiten passen Weibull (p > 0.250) und Normal (p = 0.947) gut, Lognormal und Exponential (p < 0.010) dagegen nicht.
Welche Verteilungen kann ein Wahrscheinlichkeitsnetz prüfen?
Neun: Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic und Loglogistic. Lognormal, Weibull, Exponential und Loglogistic benötigen positive Werte, und Lognormal, Weibull und Loglogistic verwenden eine logarithmische Datenachse, wie auf üblichem Wahrscheinlichkeitspapier.