
Probit-Analyse (Probit Analysis)
Die Probit-Analyse passt gruppierte Gut/Schlecht-Daten an – geprüfte und ausgefallene Einheiten auf mehreren Belastungsstufen – aus Fall-, Schlag-, Druck-, Spannungs- oder Dosis-Wirkungs-Prüfungen. Sie nimmt an, dass die Toleranzen der Einheiten einer Normal- (Probit) oder logistischen (Logit) Verteilung folgen, meist über ln(Belastung), angepasst per Maximum-Likelihood. Sie benötigt mindestens 3 Belastungsstufen und liefert Koeffizienten, die Belastung bei gewählten Ausfallprozentsätzen mit Konfidenzintervallen und ein Probit-Diagramm.
Zuletzt geprüft
Kernaussage
Die Probit-Analyse modelliert aus Gut/Schlecht-Prüfzahlen, wie der Anteil ausfallender oder reagierender Einheiten mit der Belastung steigt, und schätzt die Belastung, bei der ein gewählter Prozentsatz ausfällt, mit Konfidenzintervall.
Auf dieser Seite
Zweck
Die Probit-Analyse modelliert, wie der Anteil ausfallender (oder reagierender) Einheiten mit der Höhe einer Belastung steigt, auf Basis von Gut/Schlecht-Prüfungen auf mehreren Belastungsstufen. Typische Anwendungen sind Fallprüfungen, Schlagprüfungen, Berstdruck- oder Spannungsstufenprüfungen und Dosis-Wirkungs-Versuche. Sie beantwortet Fragen wie: Bei welcher Fallhöhe bricht die Hälfte der Einheiten, und bei welcher Höhe brechen 90%? Das Ergebnis liefert eine Belastungsgrenze mit Konfidenzintervall, die mit einer Spezifikation oder einer Einsatzbedingung verglichen werden kann.
Wichtige Funktionen
- Arbeitet mit gruppierten Gut/Schlecht-Daten: Anzahl der geprüften Einheiten und Anzahl der ausgefallenen Einheiten auf jeder Belastungsstufe.
- Toleranzverteilung Normal (Probit) oder Logistic (Logit).
- Anpassung über ln(Belastung), die übliche Wahl für physikalische Belastungen, oder über die Belastung selbst.
- Koeffiziententabelle mit Z-Tests für Achsenabschnitt und Steigung.
- Belastung, bei der beliebige gewählte Prozentsätze der Einheiten ausfallen, mit Konfidenzintervallen, sowie ein Probit-Diagramm der beobachteten gegen die angepassten Werte.
Statistische Methoden
Auf jeder Belastungsstufe s reagieren r von n Einheiten. Das Modell nimmt an, dass jede Einheit ihre eigene Toleranz hat, also die Belastung, bei der sie ausfällt, und dass diese Toleranzen in x einer Normal- oder logistischen Verteilung folgen, wobei x = ln(s), wenn Fit against ln(stress) angehakt ist, und sonst x = s. Die Ausfallwahrscheinlichkeit bei Belastung s ist dann P = G(b₀ + b₁·x), wobei G die Verteilungsfunktion der Standardnormalverteilung (Probit-Link) bzw. der logistischen Standardverteilung (Logit-Link) ist. Die Zählwerte werden als binomiales verallgemeinertes lineares Modell per Maximum-Likelihood angepasst, und Achsenabschnitt b₀ und Steigung b₁ werden mit Wald-Z-Statistiken getestet. Eine signifikant über 0 liegende Steigung bedeutet, dass der Ausfallanteil mit der Belastung steigt.
Die Belastung, bei der p% der Einheiten ausfallen, ergibt sich aus G⁻¹(p/100) = b₀ + b₁·x, also x_p = (G⁻¹(p/100) − b₀) / b₁, und auf der logarithmischen Skala s_p = exp(x_p). Ihr Konfidenzintervall wird mit der Delta-Methode berechnet: Die Varianz von x_p ergibt sich aus der Kovarianzmatrix von b₀ und b₁, das Intervall x_p ± z·SE wird gebildet, und auf der logarithmischen Skala werden beide Grenzen mit exp zurückgerechnet, sodass das Intervall nicht symmetrisch ist. Normal und Logistic liefern um 50% meist ähnliche Ergebnisse und unterscheiden sich stärker in den Verteilungsenden.
Das Probit-Diagramm zeigt den beobachteten Anteil jeder Belastungsstufe auf einer Wahrscheinlichkeitsskala gegen die Belastung (logarithmische Skala bei Anpassung über ln(Belastung)), zusammen mit der angepassten Geraden. Liegen die Punkte nahe an der Geraden, passt das Modell. Eine Stufe, auf der keine oder alle Einheiten ausgefallen sind, hat auf der Wahrscheinlichkeitsskala keine endliche Position; sie wird daher wie in Minitab nicht dargestellt (aber weiterhin für die Anpassung verwendet), und ein Hinweis unter dem Diagramm gibt an, wie viele Zeilen ausgelassen wurden.
Eingabefelder und Optionen
Feld | Beschreibung |
Response (number of events) | Pflichtfeld. Anzahl der Einheiten, die auf jeder Belastungsstufe ausgefallen sind oder reagiert haben. Darf Trials nicht übersteigen. |
Trials (number of tests) | Pflichtfeld. Anzahl der auf jeder Belastungsstufe geprüften Einheiten. |
Stress (predictor) | Pflichtfeld. Die Belastungsstufe jeder Zeile. Es sind mindestens 3 Zeilen erforderlich. |
Fit against ln(stress) | Standardmäßig angehakt. Standard für physikalische Belastungs- und Dosisvariablen; die Belastung muss dann positiv sein. Entfernen Sie den Haken, wenn die Belastung auf einer linearen Skala bleiben soll. |
Distribution | Normal (probit link) (Standard) oder Logistic (logit link). |
Percent levels | Durch Komma getrennte Prozentwerte, für die die effektive Belastung angegeben wird. Standard 50, 90, 95. |
Confidence level (%) | Für die Intervalle der effektiven Belastung. Standard 95; 50 bis 99.99. |
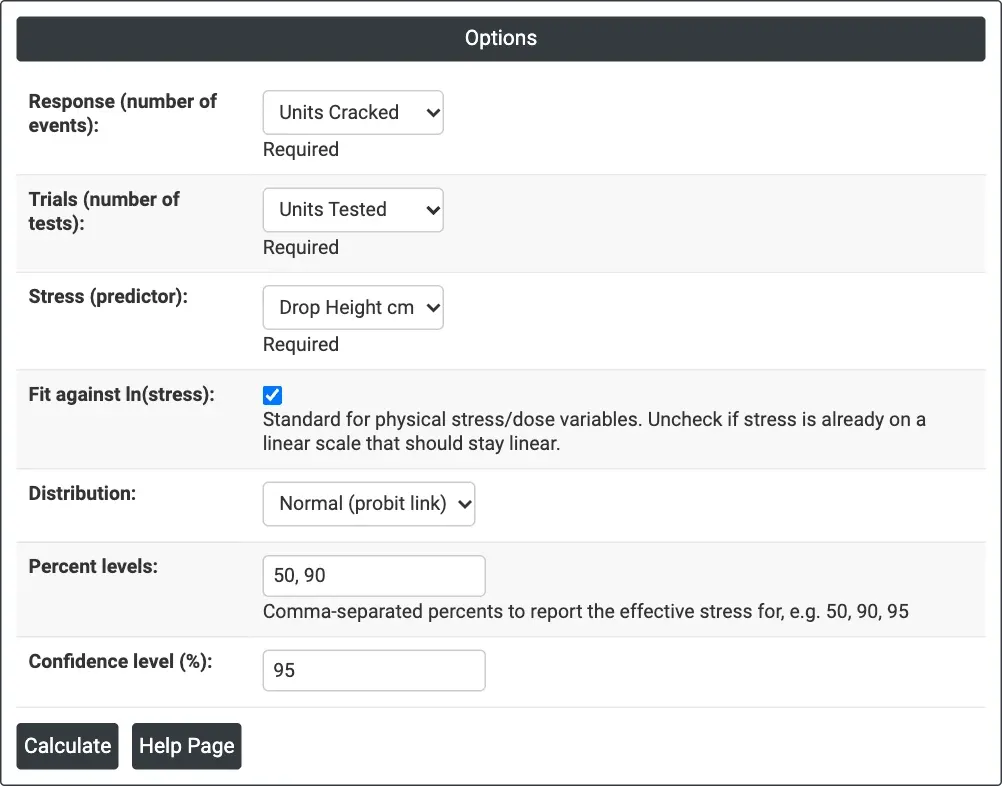
Abbildung 1 – Optionen für das Fallprüfungsbeispiel: gebrochene und geprüfte Einheiten je Fallhöhe, angepasst über ln(Höhe) mit der Normalverteilung, Prozentstufen 50 und 90.
Beschreibung der Ausgabe
- Coefficients – Intercept und Slope mit Coef, SE Coef, Z und P.
- Percent table – für jede Prozentstufe die Belastung (Stress), bei der dieser Prozentsatz der Einheiten ausfällt, mit unterer und oberer Konfidenzgrenze.
- Probit Plot – beobachteter Anteil auf jeder Belastungsstufe auf einer Wahrscheinlichkeitsskala (Percent), mit der angepassten Geraden.
- PDF-Export über Download.
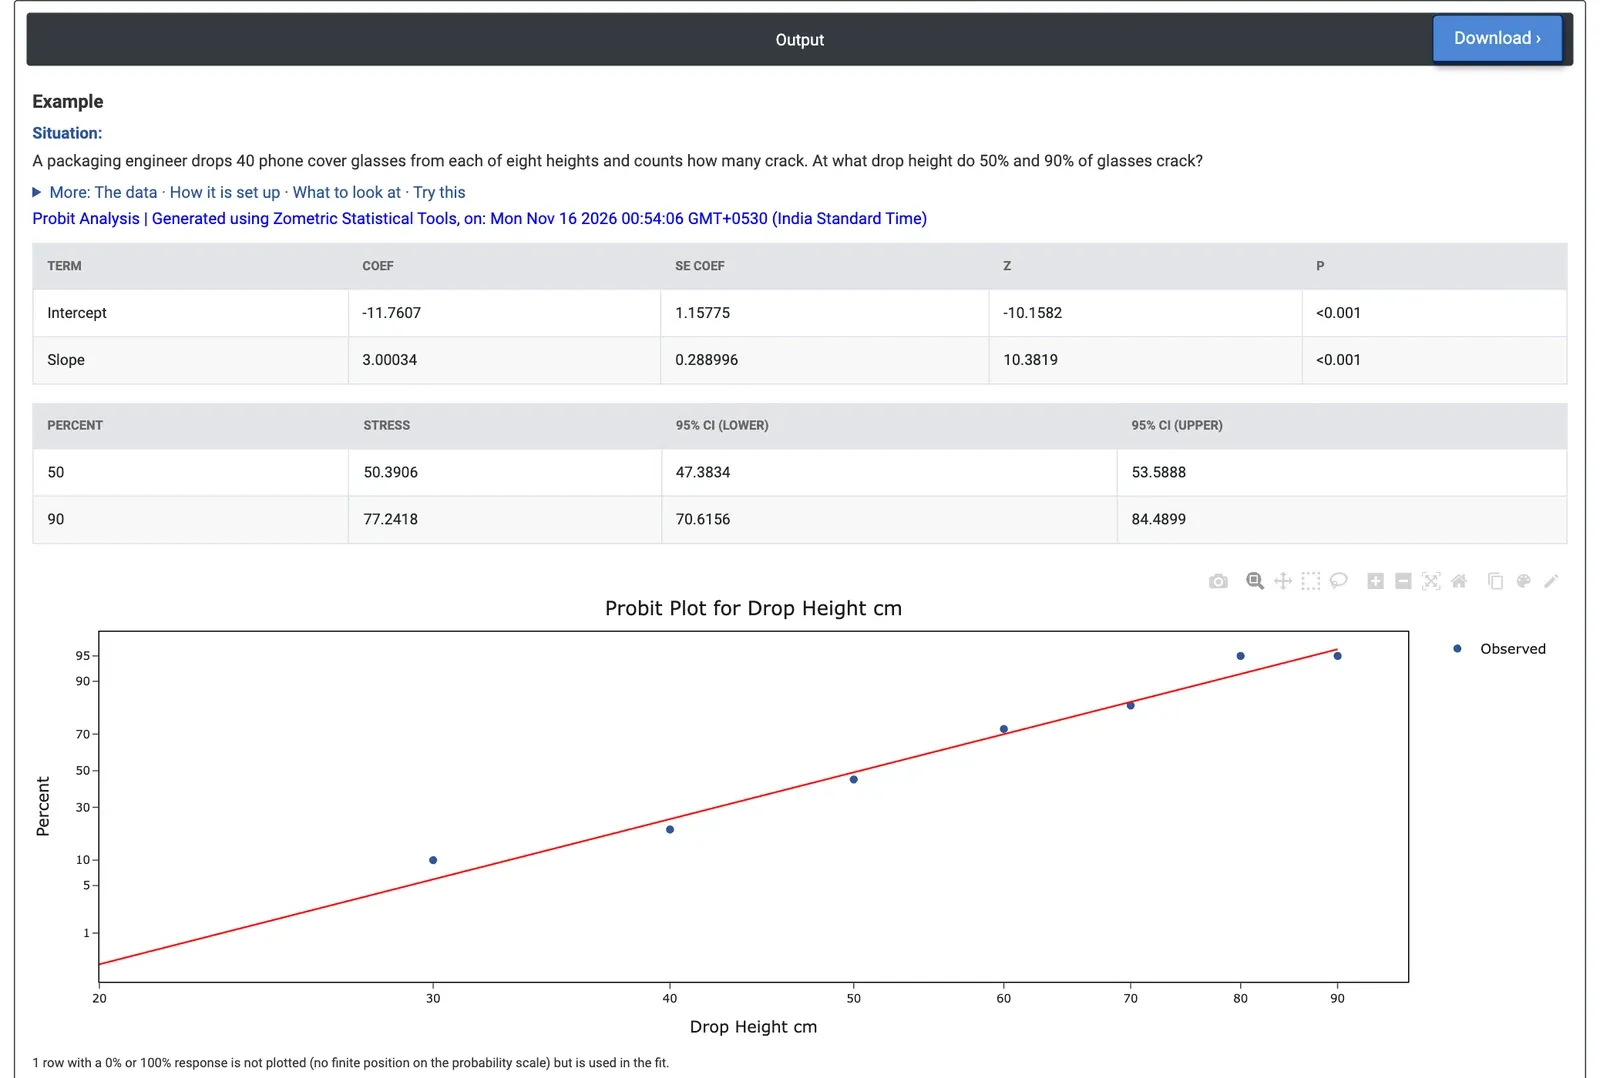
Abbildung 2 – Ergebnisse der Fallprüfung: 50% der Gläser brechen bei 50.4 cm (95%-KI 47.4 bis 53.6) und 90% bei 77.2 cm (70.6 bis 84.5).
Beispiel
Ein Verpackungsingenieur lässt aus jeder von acht Höhen zwischen 20 und 90 cm je 40 Deckgläser für Mobiltelefone fallen und zählt, wie viele brechen. Der Anteil gebrochener Gläser steigt von null bei 20 cm (die eine Stufe, die im Probit-Diagramm ausgelassen wird) auf 45% (18 von 40) bei 50 cm und 95% (38 von 40) bei 80 und 90 cm. Der Ingenieur möchte wissen, bei welchen Höhen 50% bzw. 90% der Gläser brechen. Er setzt Response = Units Cracked, Trials = Units Tested, Stress = Drop Height cm, lässt Fit against ln(stress) angehakt und Distribution = Normal und gibt Percent levels = 50, 90 ein.
Die Steigung über ln(Höhe) beträgt 3.000 (Z = 10.38, p < 0.001); die Fallhöhe bestimmt also eindeutig das Brechen. Bei 50.4 cm ist zu erwarten, dass die Hälfte der Gläser bricht (95%-KI 47.4 bis 53.6 cm), bei 77.2 cm 90% (95%-KI 70.6 bis 84.5 cm). Das Intervall bei 90% ist breiter, weil es weiter von der Mitte der Daten entfernt liegt. Ergänzt man 10 bei den Prozentstufen, ergeben sich 32.9 cm (29.4 bis 36.8 cm): Unterhalb von etwa 30 cm brechen nur wenige Gläser.
Mit der logistischen Verteilung sind die Ergebnisse nahezu gleich: 50.7 cm für 50% und 76.9 cm für 90%. Die Anpassung über die Höhe statt über ln(Höhe) verschiebt den 50%-Punkt auf 53.2 cm; die Wahl der Skala ist hier also wichtiger als die Wahl der Verteilung. Für das Verpackungsteam sind diese Höhen die Werte, die mit den Fallhöhen zu vergleichen sind, die das verpackte Glas bei der Handhabung überstehen muss: Ist höchstens etwa 10% Bruch akzeptabel, sollte das Glas allein keiner Belastung ausgesetzt werden, die einem Fall aus mehr als etwa 33 cm entspricht.
Häufig gestellte Fragen
Wofür wird die Probit-Analyse eingesetzt?
Die Probit-Analyse modelliert, wie der Anteil ausfallender oder reagierender Einheiten mit der Höhe einer Belastung steigt, auf Basis von Gut/Schlecht-Prüfungen auf mehreren Belastungsstufen. Typische Anwendungen sind Fallprüfungen, Schlagprüfungen, Berstdruck- oder Spannungsstufenprüfungen und Dosis-Wirkungs-Versuche. Sie beantwortet Fragen wie die nach der Fallhöhe, bei der die Hälfte oder 90% der Einheiten brechen, mit Konfidenzintervall.
Was ist bei der Probit-Analyse der Unterschied zwischen Probit und Logit?
Die Option Normal verwendet den Probit-Link, die Option Logistic den Logit-Link; beide beschreiben, wie die Toleranzen der Einheiten gegenüber der Belastung verteilt sind. Um 50% liefern sie meist ähnliche Ergebnisse und unterscheiden sich stärker in den Verteilungsenden. In einem Fallprüfungsbeispiel lag der 50%-Punkt mit Normal bei 50.4 cm und mit Logistic bei 50.7 cm.
Welche Daten benötigt die Probit-Analyse?
Geben Sie für jede Belastungsstufe die Anzahl der geprüften Einheiten (Trials), die Anzahl der ausgefallenen oder reagierenden Einheiten und die Belastungsstufe ein. Es sind mindestens 3 Zeilen nötig, und die Ausfälle dürfen die Trials nicht übersteigen. Die Anpassung über ln(Belastung) ist die Voreinstellung und Standard für physikalische Belastungs- und Dosisvariablen; sie erfordert positive Belastungswerte.
Wie interpretieren Sie die Ergebnisse der Probit-Analyse?
Eine signifikant über 0 liegende Steigung bedeutet, dass der Ausfallanteil mit der Belastung steigt. Die Prozenttabelle gibt die Belastung an, bei der jeder gewählte Prozentsatz der Einheiten ausfällt, mit Konfidenzgrenzen; die Intervalle sind weiter von der Mitte der Daten entfernt breiter und auf der logarithmischen Skala nicht symmetrisch. Liegen die Punkte im Probit-Diagramm nahe an der angepassten Geraden, passt das Modell.