
Zufallsdaten erzeugen (Random Data)
Random Data zieht 10 bis 10,000 Zeilen in bis zu 10 unabhängigen Spalten aus einer von 26 Verteilungen, darunter Normal, Lognormal, Weibull, Triangular, Binomial, Poisson und Multivariate Normal. Die Werte werden ohne festen Startwert (Seed) gezogen, sodass jeder Durchlauf neue Zahlen liefert. Optionales Runden und eine grafische Zusammenfassung mit Histogramm, Anderson-Darling-Test auf Normalverteilung, Konfidenzintervallen und Wahrscheinlichkeitsnetz beschreiben die erzeugten Daten.
Zuletzt geprüft
Kernaussage
Random Data erzeugt Zufallszahlen aus 26 stetigen, diskreten oder multivariat normalen Verteilungen im Datenbereich, für Schulungsdaten, Simulation, Was-wäre-wenn-Studien und um die Streuung von Stichproben zu zeigen.
Auf dieser Seite
Zweck
Random Data erzeugt Zufallszahlen aus einer von 26 Verteilungen und stellt sie in den Datenbereich (Data Pane), bereit zum Kopieren oder zur Verwendung in anderen Werkzeugen. Nutzen Sie es, um Übungsdaten für Schulungen zu erstellen, um zu sehen, wie stark eine Stichprobe aus einem bekannten Prozess streut (ein Histogramm von 30 Werten aus einem perfekt normalverteilten Prozess ist selten glockenförmig), um eine Analyse vor dem Eintreffen der echten Daten auszuprobieren oder um einen Prozess für eine Was-wäre-wenn-Studie zu simulieren, zum Beispiel Zykluszeiten aus einer Dreiecksschätzung oder Ausfallzeiten aus einem Weibull-Modell. Eine optionale grafische Zusammenfassung beschreibt die erzeugten Zahlen.
Wichtige Funktionen
- 26 Verteilungen in einer Liste Distribution: stetig (Normal, Lognormal, Weibull, Exponential, Gamma, Uniform, Triangular und weitere), diskret (Binomial, Poisson, Geometric, Hypergeometric, Integer, Discrete und weitere) sowie Multivariate Normal.
- Es werden nur die Parameterfelder der gewählten Verteilung angezeigt.
- 10 bis 10,000 Zeilen und 1 bis 10 unabhängige Spalten (data_1, data_2, …).
- Optionales Runden auf eine festgelegte Anzahl von Dezimalstellen.
- Optionale grafische Zusammenfassung aller erzeugten Werte: Histogramm, Kennzahlen, Anderson-Darling-Test auf Normalverteilung, Konfidenzintervalle und Wahrscheinlichkeitsnetz.
- Multivariate Normal: korrelierte Spalten aus einem Mittelwertvektor und einer Kovarianzmatrix, mit den Korrelations- und Kovarianzmatrizen der Stichprobe zur Kontrolle.
Statistische Methoden
Die Werte werden unabhängig mit den Zufallszahlengeneratoren von NumPy und SciPy ohne festen Startwert gezogen, sodass jedes Calculate neue Zahlen liefert. Jede Spalte ist eine eigene Stichprobe des gewählten Umfangs aus derselben Verteilung. Die Parameter folgen den üblichen Definitionen: zum Beispiel Normal (Mittelwert μ, Standardabweichung σ), Weibull (Form β, Skala η, optionaler Schwellenwert, der zu jedem Wert addiert wird), Exponential (Skala = Mittelwert, optionaler Schwellenwert), Integer (ganze Zahlen von Minimum bis Maximum, beide eingeschlossen), Geometric (Anzahl der Versuche bis einschließlich zum ersten Ereignis) und Negative Binomial (Anzahl der Nicht-Ereignisse vor der geforderten Anzahl von Ereignissen). Bei Lognormal geben Sie Mittelwert und Standardabweichung der Daten selbst ein: Das Werkzeug rechnet sie in die Parameter der logarithmischen Skala σ = √ln(1 + (s/m)²) und μ = ln(m) − σ²/2 um. Bei Discrete werden die Wahrscheinlichkeiten so umskaliert, dass ihre Summe 1 ergibt.
Ist Graphical Summary aktiviert, werden alle Spalten zu einer Stichprobe zusammengefasst und beschrieben: Mittelwert, Standardabweichung, Varianz, Schiefe, Kurtosis, N, Minimum, Quartile, Median, Maximum und Variationskoeffizient (%); der Anderson-Darling-Test auf Normalverteilung (A-squared und p-Wert); 95%-Konfidenzintervalle für den Mittelwert (t), den Median (Hettmansperger-Sheather) und die Standardabweichung (Chi-Quadrat). Ist Exclude outliers aktiviert, werden Werte außerhalb von Q1 − 1.5×IQR oder Q3 + 1.5×IQR nur aus der Zusammenfassung ausgeschlossen; die erzeugten Daten behalten sie. Bei Multivariate Normal muss die Kovarianzmatrix quadratisch, symmetrisch und positiv semidefinit sein und zur Anzahl der Mittelwerte passen.
Eingabefelder und Optionen
Feld | Beschreibung |
Distribution | Erforderlich. Eine von 26 Verteilungen; die Parameterfelder darunter ändern sich entsprechend. |
Number of rows of data to generate | Erforderlich, 10 bis 10,000. |
Number of columns | Standard 1, bis zu 10. Jede Spalte ist eine unabhängige Stichprobe. Wird bei Multivariate Normal nicht verwendet (eine Spalte je Mittelwert). |
Graphical Summary | Standardmäßig deaktiviert. Fügt der Ausgabe die grafische Zusammenfassung der erzeugten Werte hinzu. |
Exclude outliers (1.5×IQR rule) | Optional. Wirkt nur, wenn Graphical Summary aktiviert ist; dann werden Ausreißer nur aus der Zusammenfassung entfernt. |
Decimals | Optional, 0 bis 10. Rundet die erzeugten Werte der stetigen Verteilungen (Normal, Lognormal, Weibull, Exponential, T, F, Beta, Cauchy, Chi-Square, Gamma, Laplace, die Extremwertverteilungen, Logistic, Loglogistic, Triangular und Uniform). Bei Normal werden mindestens so viele Dezimalstellen beibehalten, dass die Standardabweichung sichtbar bleibt. Nicht angezeigt für Verteilungen, die ganze Zahlen oder aufgelistete Werte liefern (Binomial, Poisson, Bernoulli, Discrete, Geometric, Hypergeometric, Integer und Negative Binomial), sowie für Multivariate Normal. |
Mean / Standard Deviation | Normal; Lognormal (Mittelwert und Standardabweichung der Daten); Poisson verwendet nur Mean. |
Number of trials / Event probability | Binomial. Nur Event probability: Bernoulli und Geometric; mit Number of events (geforderte Erfolge): Negative Binomial. |
Shape parameter / Scale parameter / Threshold parameter | Weibull (Schwellenwert optional); Gamma und Loglogistic verwenden Form und Skala. |
Scale parameter / Threshold parameter | Exponential (Schwellenwert optional). |
Location parameter / Scale parameter | Cauchy, Laplace, Largest Extreme Value, Smallest Extreme Value und Logistic. |
Degrees of freedom / Numerator and Denominator degrees of freedom | T und Chi-Square; F. |
First shape parameter / Second shape parameter | Beta. |
Values / Probabilities | Discrete. Durch Kommas oder Leerzeichen getrennt, gleiche Anzahl, z. B. „1 2 3“ und „0.2 0.3 0.5“ (werden neu normiert, wenn ihre Summe nicht 1 ist). |
Population size (N) / Event count in population / Sample size (n) | Hypergeometric. Die Anzahl der Ereignisse und der Stichprobenumfang dürfen die Größe der Grundgesamtheit nicht übersteigen. |
Minimum / Maximum / Mode (most likely value) | Integer (Minimum und Maximum); Triangular (alle drei, Modus dazwischen). |
Lower endpoint / Upper endpoint | Uniform. |
Means / Covariance matrix | Multivariate Normal. Ein Mittelwert je Variable, z. B. „10 20 30“; Zeilen der Kovarianzmatrix durch Semikolons getrennt, z. B. „4,2,0; 2,9,1; 0,1,1“. |
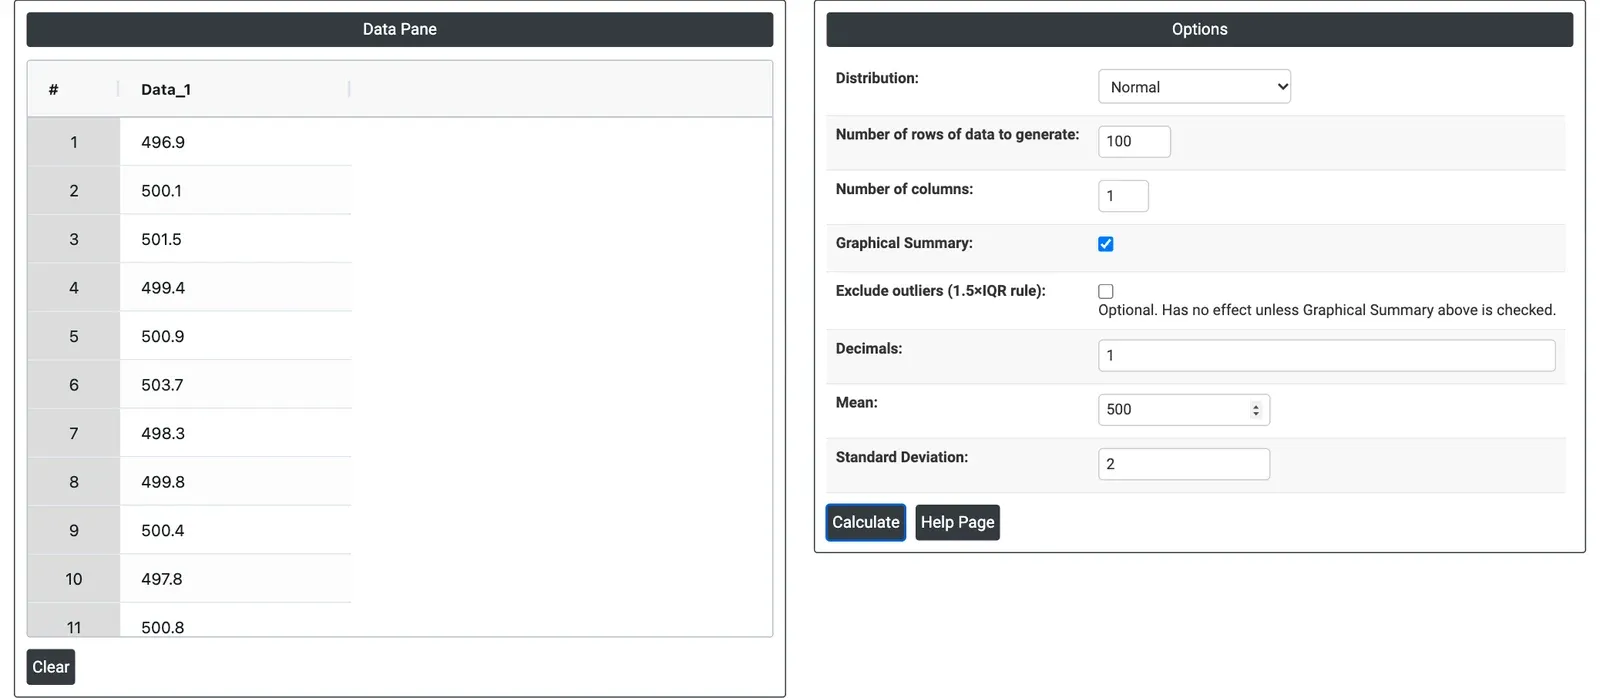
Abbildung 1 — 100 Werte aus einer Normalverteilung mit Mittelwert 500 und Standardabweichung 2, auf 1 Dezimalstelle gerundet, im Data Pane (links) mit den Optionen (rechts).
Beschreibung der Ausgabe
- Data Pane — die erzeugten Werte, eine Spalte je Stichprobe (data_1, data_2, …); sie ersetzen den bisherigen Inhalt.
- Grafische Zusammenfassung (wenn aktiviert) — Histogramm mit angepasster Normalverteilungskurve und Boxplot; Kennzahlentabelle mit A-Squared, p-value, Mean, StDev, Variance, Skewness, Kurtosis, N, Minimum, 1st Quartile, Median, 3rd Quartile, Maximum und Coeff Var; Diagramm 95% Confidence Intervals für Mittelwert und Median; Probability Plot mit dem Anderson-Darling-Ergebnis; und eine Tabelle der unteren und oberen 95%-Grenzen für Mittelwert, Median und Standardabweichung mit der halben Breite jedes Intervalls.
- Multivariate Normal — Korrelations- und Kovarianzmatrizen der Stichprobe für die erzeugten Spalten.
- PDF-Export über Download as PDF.
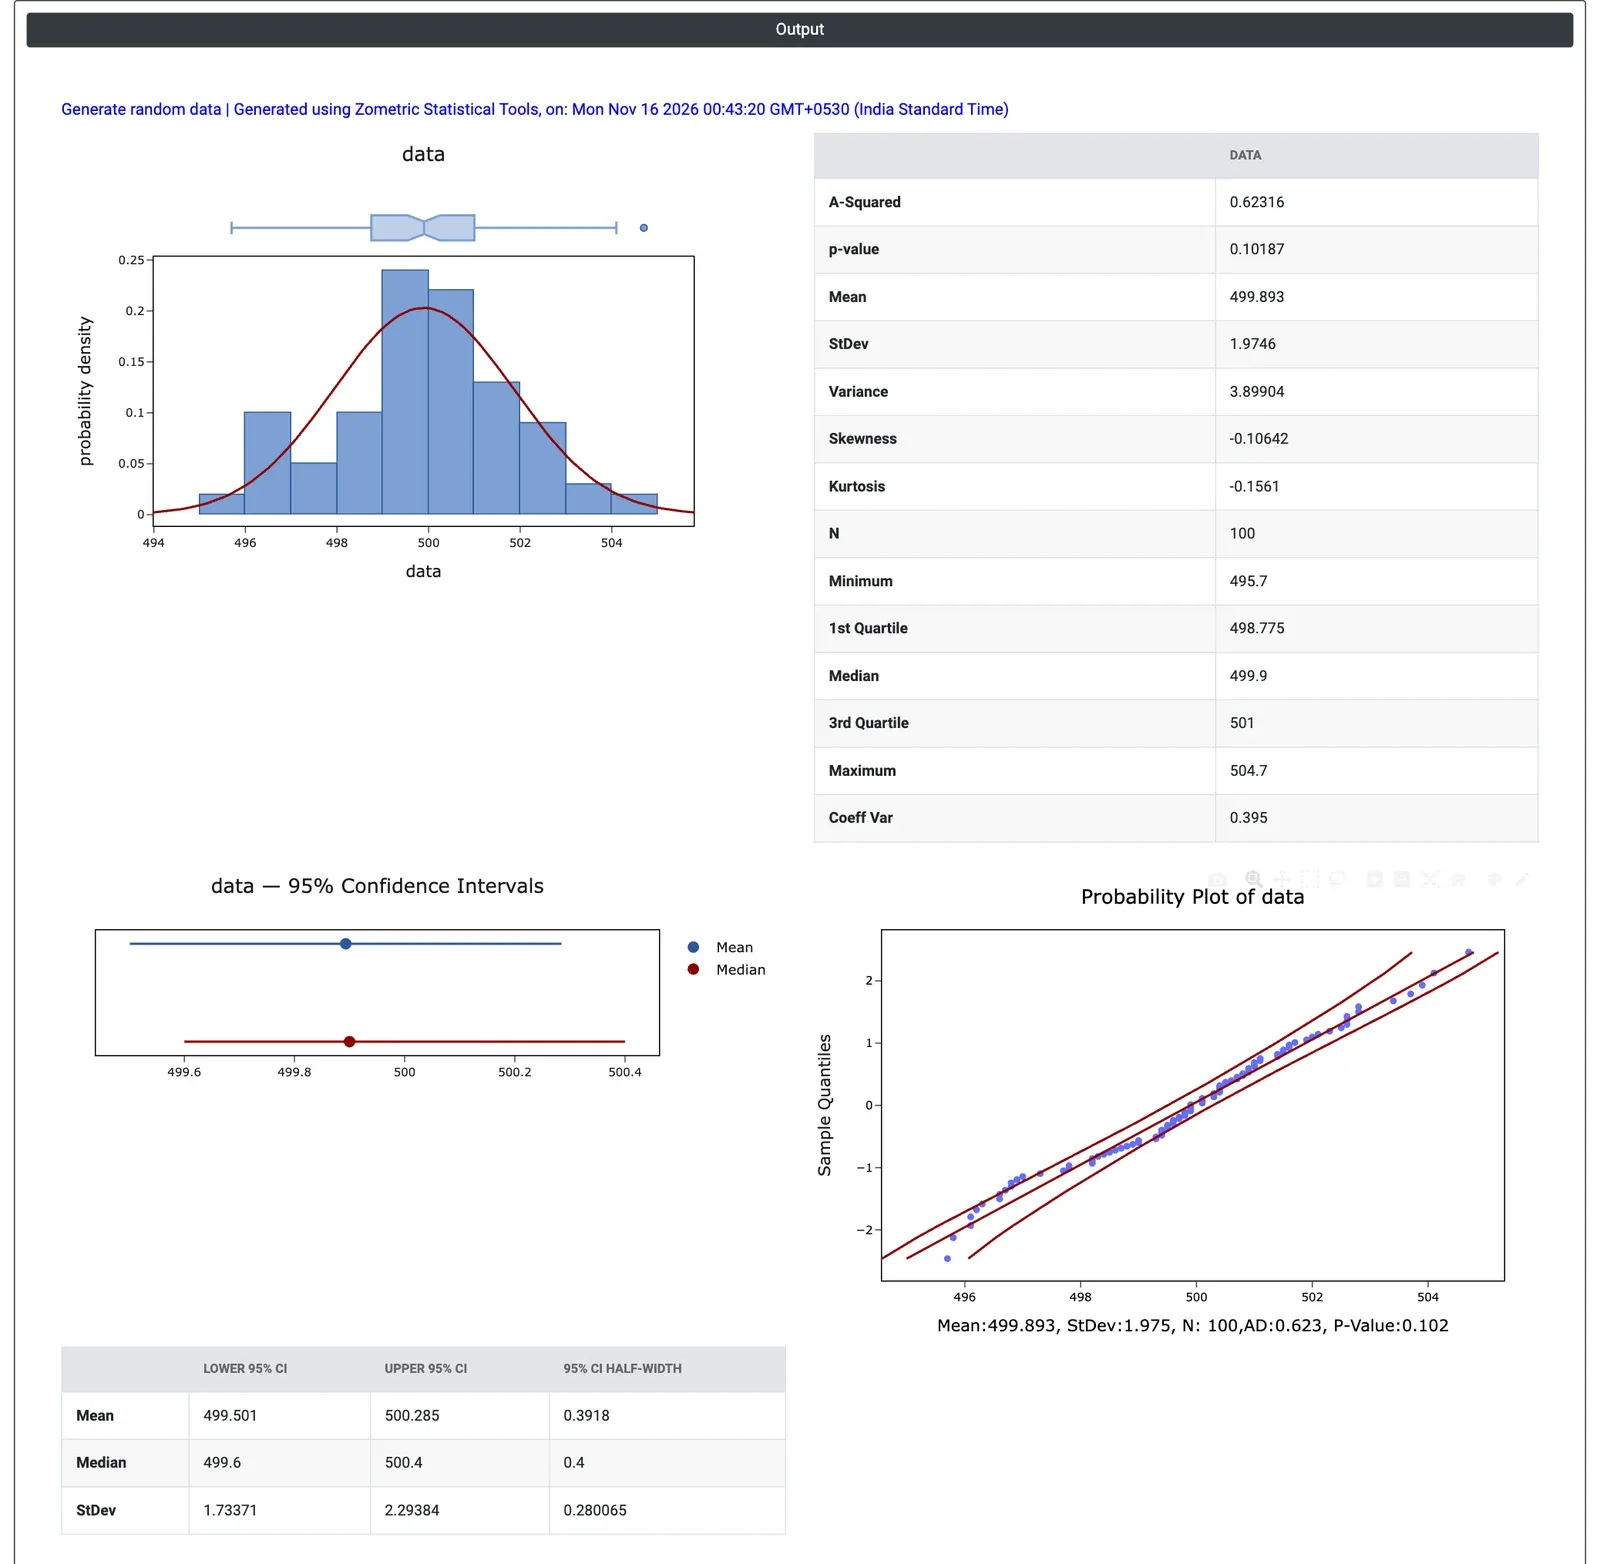
Abbildung 2 — Grafische Zusammenfassung der 100 erzeugten Werte: Mittelwert 499.89, StDev 1.97, Anderson-Darling-p-Wert 0.102.
Beispiel
Ein Qualitätstrainer bereitet eine Schulung zur Prozessstreuung für Bediener einer Abfülllinie vor. Die Linie füllt 500-g-Flaschen mit einer Standardabweichung von etwa 2 g. Um zu zeigen, wie rein zufällige Streuung aussieht, wählt der Trainer Distribution = Normal, Number of rows = 100, Number of columns = 1, Mean = 500, Standard Deviation = 2 und Decimals = 1 und aktiviert Graphical Summary.
Die 100 simulierten Füllgewichte reichen von 495.7 bis 504.7 g, mit Mittelwert 499.89 g und Standardabweichung 1.97 g, also nicht genau 500 und 2, obwohl der Prozess exakt eingestellt war. Das Histogramm ist unregelmäßig statt einer sauberen Glockenkurve, doch der Anderson-Darling-Test ergibt p = 0.102, es gibt also keinen Hinweis gegen die Normalverteilung. Das 95%-Konfidenzintervall für den Mittelwert, 499.50 bis 500.29 g (halbe Breite 0.39 g), enthält den wahren Wert 500, und das Intervall für die Standardabweichung, 1.73 bis 2.29 g, enthält den wahren Wert 2.
Die Botschaft für die Bediener: Auch ein stabiler, zentrierter Prozess erzeugt einzelne Flaschen, die 4 g vom Zielwert abweichen, und Stichprobenkennwerte, die von den wahren Werten abweichen. Jedes Calculate zieht eine neue Stichprobe mit leicht anderen Zahlen, mit der der Trainer die Streuung von Stichprobe zu Stichprobe zeigen kann. Mit 5 Spalten zu 20 Zeilen erhalten Sie fünf kleine Stichproben zum Vergleich, oder die Daten können zur Übung in ein Werkzeug für Prozessfähigkeit oder Regelkarten kopiert werden.
Häufig gestellte Fragen
Wofür werden Zufallsdaten in der Qualitätsarbeit verwendet?
Sie dienen dazu, Übungsdaten für Schulungen zu erstellen, zu sehen, wie stark Stichproben aus einem bekannten Prozess streuen, eine Analyse vor dem Eintreffen echter Daten auszuprobieren und einen Prozess für Was-wäre-wenn-Studien zu simulieren, etwa Zykluszeiten aus einer Dreiecksschätzung oder Ausfallzeiten aus einem Weibull-Modell. Erzeugte Daten können in andere Werkzeuge kopiert werden, etwa für Prozessfähigkeit oder Regelkarten.
Aus welchen Verteilungen lassen sich Zufallsdaten erzeugen?
Es sind 26: stetige Verteilungen wie Normal, Lognormal, Weibull, Exponential, Gamma, Uniform und Triangular; diskrete Verteilungen wie Binomial, Poisson, Geometric, Hypergeometric, Integer und Discrete; sowie Multivariate Normal, die korrelierte Spalten aus einem Mittelwertvektor und einer Kovarianzmatrix erzeugt. Es werden nur die Parameterfelder der gewählten Verteilung angezeigt.
Warum stimmt eine Zufallsstichprobe nicht genau mit Mittelwert und Standardabweichung der Grundgesamtheit überein?
Jede Stichprobe streut zufällig. In einem Beispiel hatten 100 Werte aus einem normalverteilten Prozess mit Mittelwert 500 und Standardabweichung 2 einen Stichprobenmittelwert von 499.89 und eine Standardabweichung von 1.97, und das Histogramm war unregelmäßig statt glockenförmig, doch der Anderson-Darling-Test ergab p = 0.102, also keinen Hinweis gegen die Normalverteilung.
Wie geben Sie beim Erzeugen von Zufallsdaten die Parameter der Lognormalverteilung ein?
Bei der Lognormalverteilung geben Sie Mittelwert und Standardabweichung der Daten selbst ein, nicht der Logarithmen. Das Werkzeug rechnet sie in Parameter der logarithmischen Skala um: Sigma ist die Quadratwurzel aus ln(1 + (s/m) zum Quadrat), und Mu ist ln(m) minus Sigma zum Quadrat geteilt durch 2.