
Exponentialverteilte Zufallsdaten (Random Exponential Data)
Random Exponential Data simuliert Wartezeiten zwischen unabhängigen Ereignissen, etwa Maschinenausfällen oder Kundenankünften, unter der Annahme einer konstanten Ausfallrate (Gedächtnislosigkeit). Sie legen die Anzahl der Zeilen und Spalten fest, den Skalenparameter, also die mittlere Zeit zwischen Ereignissen (1/Rate), und optional einen Schwellenwert, der die Werte nach oben verschiebt. Ändert sich die Ausfallrate im Zeitverlauf, verwenden Sie stattdessen Random Weibull Data.
Zuletzt geprüft
Kernaussage
Random Exponential Data erzeugt streng positive Werte aus der Exponentialverteilung mit vorgegebener mittlerer Zeit zwischen Ereignissen, um Zeiten zwischen Ausfällen, Ankünften oder Serviceabschlüssen bei konstanter Rate zu simulieren.
Auf dieser Seite
- Was ist Random Exponential Data?
- Wann werden exponentialverteilte Zufallsdaten eingesetzt?
- Hinweise zur richtigen Anwendung von Random Exponential Data
- Alternativen: Wann Sie Random Exponential Data nicht verwenden sollten
- Beispiel für exponentialverteilte Zufallsdaten
- Anleitung: Exponentialverteilte Zufallsdaten erzeugen
Was ist Random Exponential Data?
Random Exponential Data erzeugt Werte aus der Exponentialverteilung, die die Zeit zwischen aufeinanderfolgenden unabhängigen Ereignissen modelliert, etwa die Zeit zwischen Maschinenausfällen, Kundenankünften oder Serviceabschlüssen. Sie geben den Mittelwert (die mittlere Zeit zwischen Ereignissen) an, und das Werkzeug erzeugt zufällige Zeitspannen zwischen den Ereignissen.
Einfache Definition: Erzeugt zufällige Wartezeiten zwischen Ereignissen; wird in der Zuverlässigkeitstechnik und der Warteschlangenanalyse häufig eingesetzt, um zu simulieren, wie lange es bis zum nächsten Ausfall oder zur nächsten Ankunft dauert.
Wann werden exponentialverteilte Zufallsdaten eingesetzt?
- Zur Simulation von Zeiten zwischen Ausfällen, Ankünften oder Serviceabschlüssen.
- Zum Testen von Zuverlässigkeitsanalysen , die eine konstante Ausfallrate voraussetzen (exponentielles Ausfallmodell).
Hinweise zur richtigen Anwendung von Random Exponential Data
- Die Exponentialverteilung setzt eine konstante Ausfallrate (Gedächtnislosigkeit) voraus; ändert sich die Ausfallrate im Zeitverlauf, verwenden Sie stattdessen die Weibull-Verteilung.
- Alle erzeugten Werte sind streng positiv.
- Setzen Sie den Mittelwert gleich der bekannten mittleren Zeit zwischen Ereignissen aus historischen Daten.
Alternativen: Wann Sie Random Exponential Data nicht verwenden sollten
- Wenn sich die Ausfallrate im Zeitverlauf ändert, verwenden Sie Random Weibull Data
- Für schiefe, positive, stetige Messwerte (nicht zeitbasiert) verwenden Sie Random Lognormal Data
Beispiel für exponentialverteilte Zufallsdaten
So erzeugen Sie exponentialverteilte Zufallsdaten:
- Um exponentialverteilte Zufallsdaten zu erzeugen, füllen Sie die erforderlichen Optionen aus.
- Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
- Um Random Exponential Data aufzurufen, wählen Sie Statistical module> Random Data > Random Exponential Data
4. Nach Ausführung des oben genannten Werkzeugs erhalten Sie folgende Ausgabe:
Anleitung: Exponentialverteilte Zufallsdaten erzeugen
So gehen Sie vor:
- Melden Sie sich bei Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Random Data>Random Exponential Data.
- Füllen Sie anschließend die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
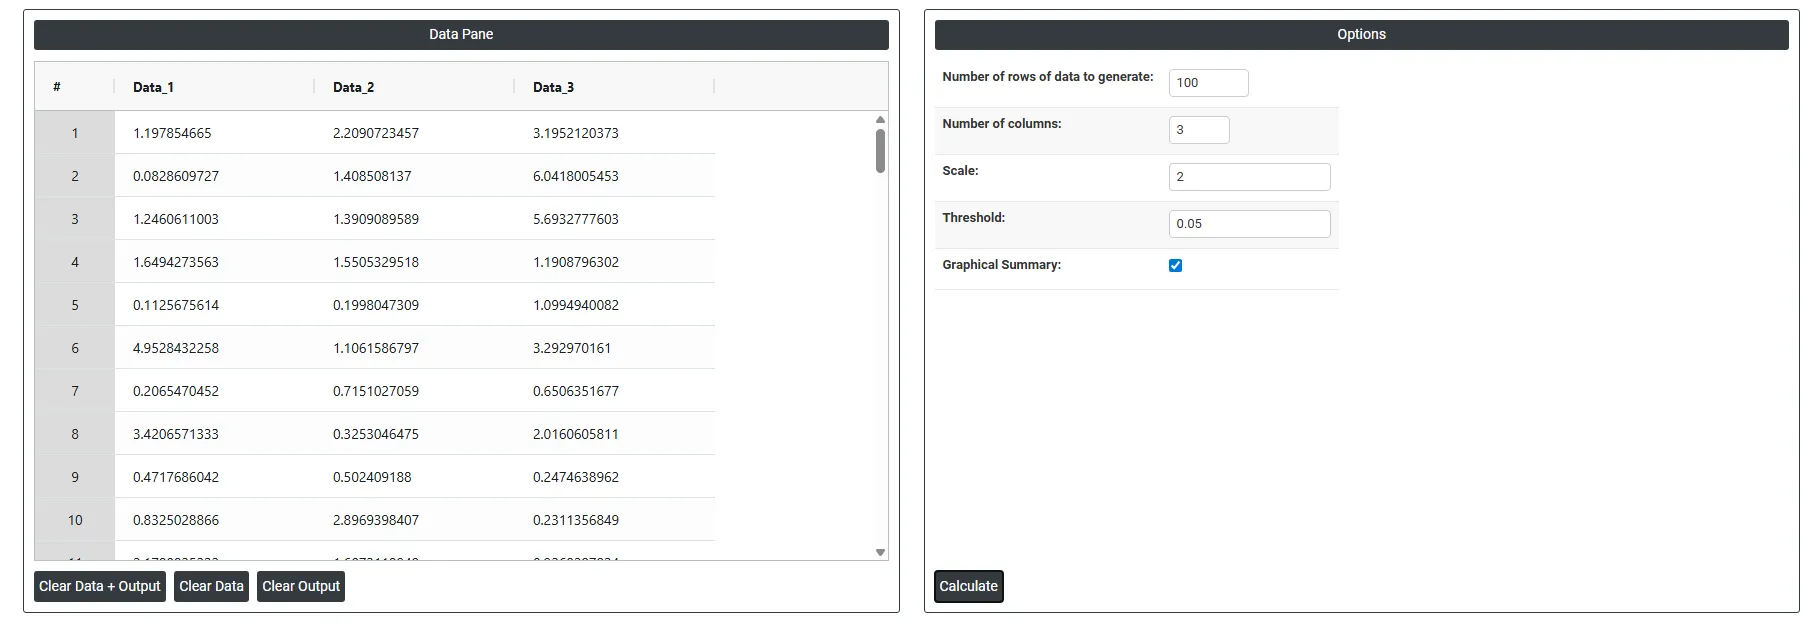
Das Dashboard von Random Exponential Data ist in zwei Bereiche unterteilt.
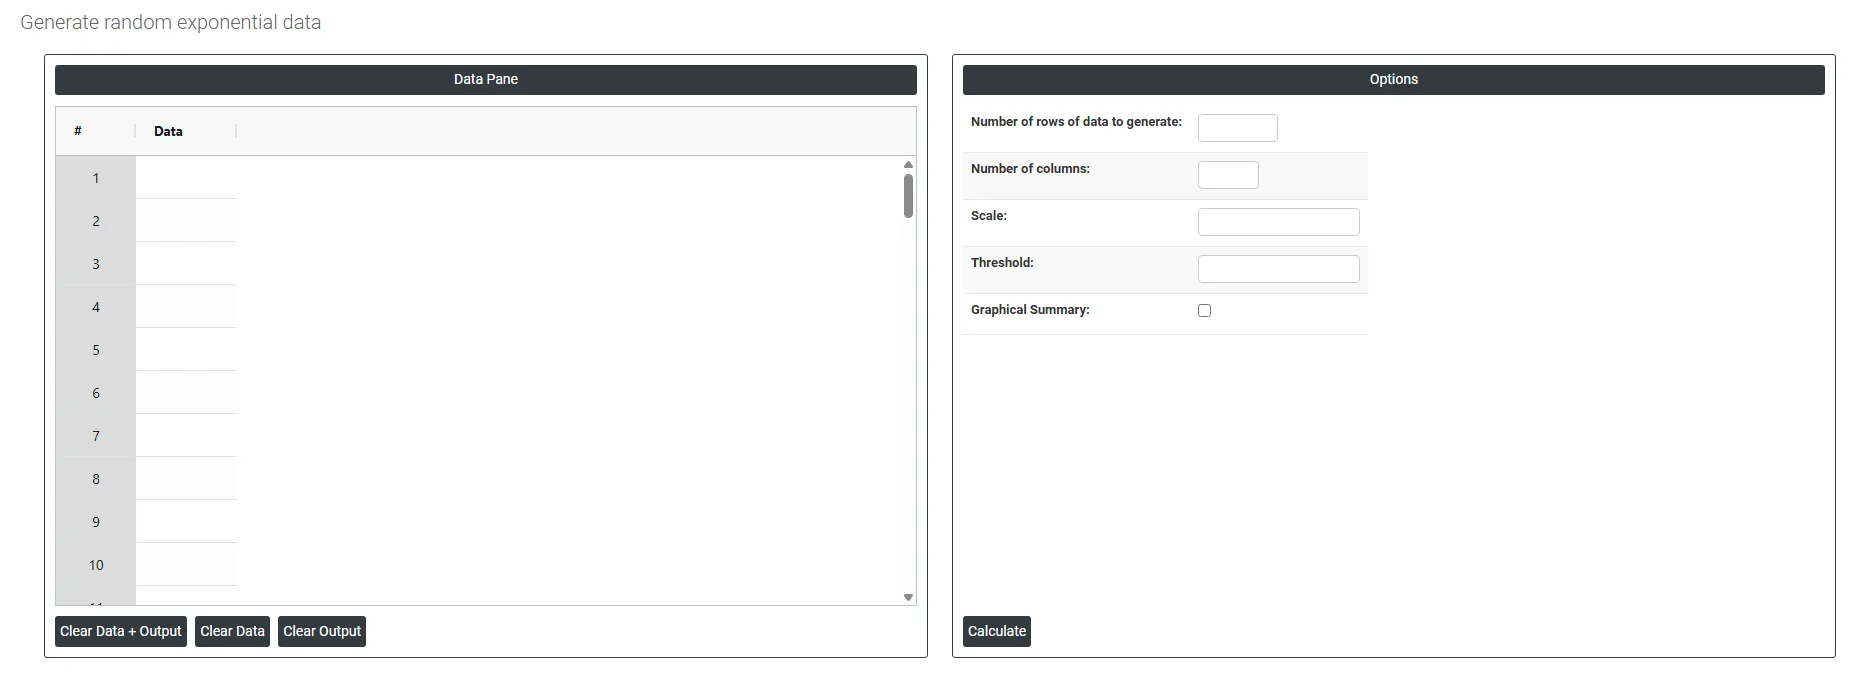
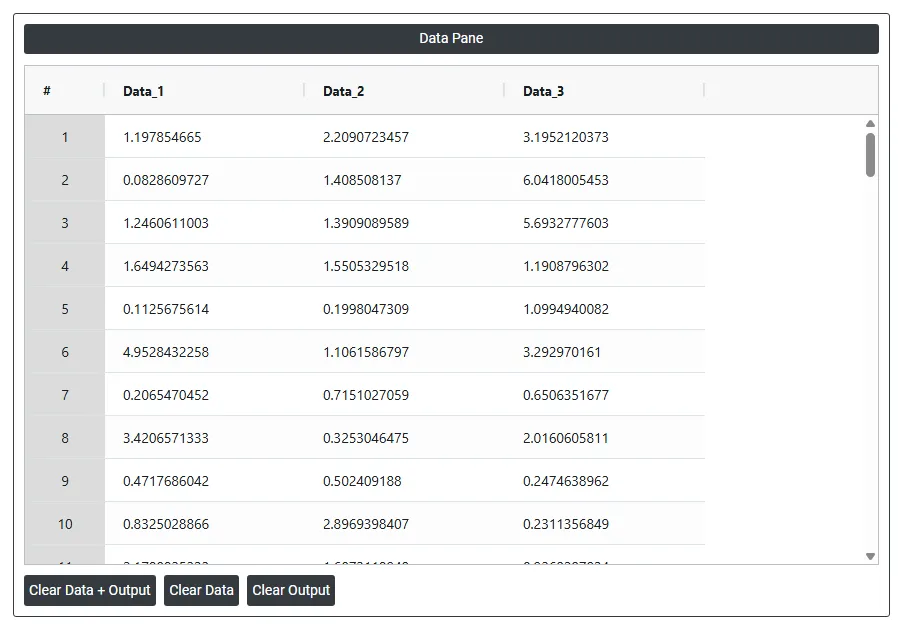
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile erzeugte Zufallsdaten. Die Daten werden erzeugt, nachdem die erforderlichen Optionen ausgefüllt sind.
Im rechten Bereich stehen folgende Optionen zur Verfügung:
- Number of rows of data to generate: Legt fest, wie viele zufällige Datenpunkte erzeugt werden. Die Eingabe 10 erzeugt zum Beispiel genau 10 Zeilen mit Zufallswerten, die alle im Data Pane sichtbar sind.
- Number of columns: Legt fest, wie viele Variablen (Spalten) jede Zeile hat. Die Eingabe 3 erzeugt zum Beispiel 3 Spalten mit Zufallsdaten nebeneinander im Data Pane.
- Scale: Der Mittelwert der Exponentialverteilung, also die mittlere Zeit zwischen Ereignissen (gleich 1/Rate). Ein größerer Skalenwert erzeugt größere, stärker gestreute Zahlen, ein kleinerer Skalenwert Werte, die sich näher bei null häufen. Alle im Data Pane erzeugten Datenpunkte spiegeln diese Streuung wider.
- Threshold: Legt einen Mindestausgangswert für die erzeugten Daten fest. Statt bei null zu beginnen, werden die erzeugten Zahlen um diesen Betrag nach oben verschoben. Ein Schwellenwert von 10 bedeutet zum Beispiel, dass alle erzeugten Werte bei 10 statt bei 0 beginnen und darüber liegen.
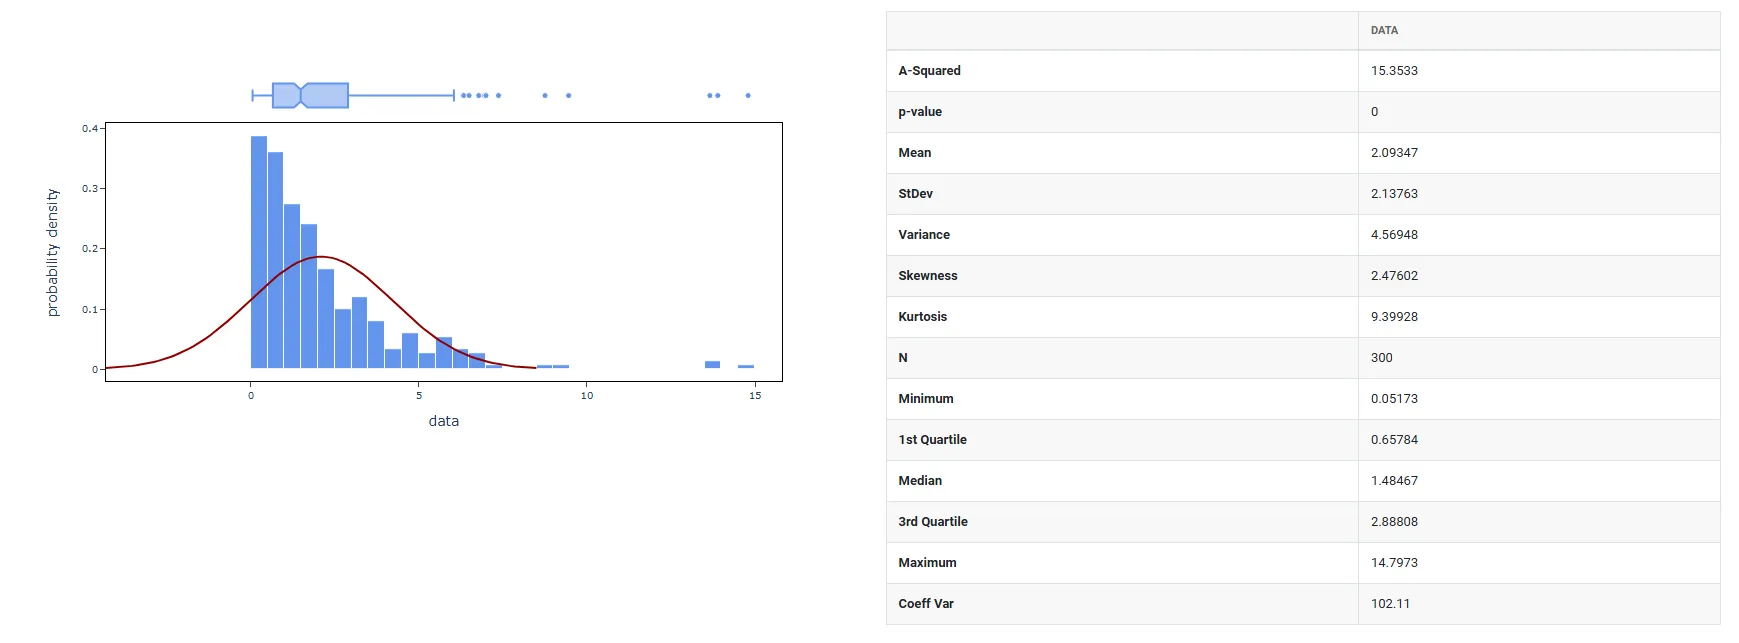
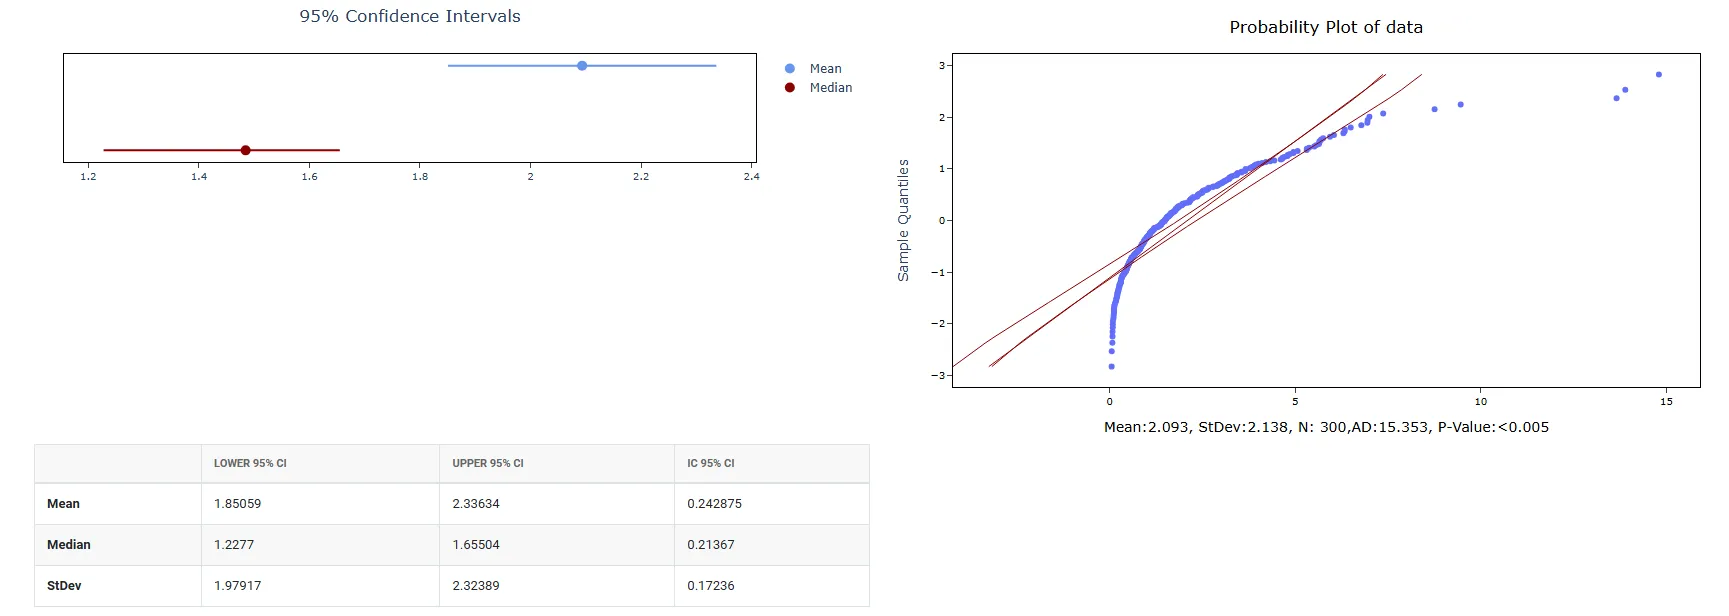
- Graphical summary: Ist die Option gewählt, werden alle erzeugten Werte zusammengefasst und ausgewertet: ein Histogramm mit angepasster Normalverteilungskurve und Boxplot, statistische Kennzahlen, ein Anderson-Darling-Test auf Normalverteilung, ein Wahrscheinlichkeitsnetz und 95%-Konfidenzintervalle für Mittelwert, Median und Standardabweichung. Es ist ein grafisches Ergebnis auf Grundlage der soeben erzeugten Daten.
Häufig gestellte Fragen
Was simulieren exponentialverteilte Zufallsdaten?
Exponentialverteilte Zufallsdaten simulieren die Zeit zwischen aufeinanderfolgenden unabhängigen Ereignissen, etwa die Zeit zwischen Maschinenausfällen, Kundenankünften oder Serviceabschlüssen. Sie werden in der Zuverlässigkeitstechnik und der Warteschlangenanalyse häufig eingesetzt, um zu modellieren, wie lange es bis zum nächsten Ausfall oder zur nächsten Ankunft dauert, und um Zuverlässigkeitsanalysen zu testen, die eine konstante Ausfallrate voraussetzen.
Wann sollte man die Weibull- statt der Exponentialverteilung verwenden?
Die Exponentialverteilung setzt eine konstante Ausfallrate voraus (Gedächtnislosigkeit). Ändert sich die Ausfallrate im Zeitverlauf, steigt sie also oder fällt sie, verwenden Sie stattdessen Random Weibull Data. Für schiefe, positive Messwerte, die nicht zeitbasiert sind, ist Random Lognormal Data die bessere Wahl.
Was bewirken die Einstellungen Scale und Threshold bei exponentialverteilten Zufallsdaten?
Scale ist der Mittelwert der Exponentialverteilung, die mittlere Zeit zwischen Ereignissen, gleich 1/Rate. Ein größerer Skalenwert ergibt größere, stärker gestreute Zahlen, ein kleinerer Werte, die sich näher bei null häufen; legen Sie ihn anhand der bekannten mittleren Zeit zwischen Ereignissen aus historischen Daten fest. Threshold verschiebt alle Werte nach oben, sodass ein Schwellenwert von 10 bedeutet, dass die Werte bei 10 statt bei 0 beginnen.