
Lognormalverteilte Zufallsdaten (Random Lognormal Data)
Random Lognormal Data simuliert stets positive, rechtsschiefe stetige Messwerte. Sie legen die Anzahl der Zeilen und Spalten fest, Mittelwert und Standardabweichung der Daten selbst (nicht ihres Logarithmus) sowie optional einen Schwellenwert, der die Werte nach oben verschiebt. Das Werkzeug rechnet Mittelwert und Standardabweichung in Parameter auf der logarithmischen Skala um. Es wird kein fester Startwert (Seed) verwendet; kopieren Sie die Daten daher, um sie wiederzuverwenden. Eine optionale grafische Zusammenfassung zeigt die Verteilung.
Zuletzt geprüft
Kernaussage
Random Lognormal Data erzeugt streng positive, rechtsschiefe Werte, deren natürlicher Logarithmus normalverteilt ist – zur Simulation von Messgrößen wie Partikelgrößen, Antwortzeiten oder Konzentrationen.
Auf dieser Seite
Was ist Random Lognormal Data?
Random Lognormal Data erzeugt Werte aus der Lognormalverteilung – einer rechtsschiefen Verteilung, bei der der natürliche Logarithmus der Daten einer Normalverteilung folgt. Das Ergebnis ist eine Menge stets positiver, rechtsschiefer Werte, wie sie häufig bei Messgrößen wie Partikelgrößen, Einkommensverteilungen und biologischen Konzentrationen vorkommen.
Einfache Definition: Erzeugt zufällige positive Werte mit einer rechtsschiefen Verteilung – naheliegend für Messgrößen wie Partikelgrößen, Antwortzeiten und Stoffkonzentrationen, die weder null noch negativ sein können.
Wann wird Random Lognormal Data eingesetzt?
- Zur Simulation rechtsschiefer stetiger Messwerte , die stets positiv sind.
- Wenn Ihre Daten nach einer Logarithmustransformation annähernd normalverteilt sindund Sie realistische Rohwerte für eine Simulation erzeugen möchten.
- Bei Simulationen in Umwelt-, Pharma- und Finanzbereich.
Hinweise zur richtigen Anwendung von Random Lognormal Data
- Die Parameter werden auf der Datenskala eingegeben: Mittelwert und Standardabweichung beziehen sich auf x selbst, nicht auf log(x); das Werkzeug rechnet sie in die Parameter auf der logarithmischen Skala um.
- Alle erzeugten Werte sind streng positiv.
- Es wird kein fester Startwert (Seed) verwendet, sodass jeder Klick auf Calculate neue Werte liefert; kopieren Sie die erzeugten Daten, wenn Sie denselben Datensatz wiederverwenden möchten.
Alternativen: Wann Random Lognormal Data nicht geeignet ist
- Sind die Daten symmetrisch und glockenförmig, verwenden Sie normalverteilte Zufallsdaten
- Für Ausfallzeiten mit sich ändernder Ausfallrateverwenden Sie Weibull-verteilte Zufallsdaten
Beispiel für Random Lognormal Data
Folgende Schritte dienen zum Erzeugen lognormalverteilter Zufallsdaten:
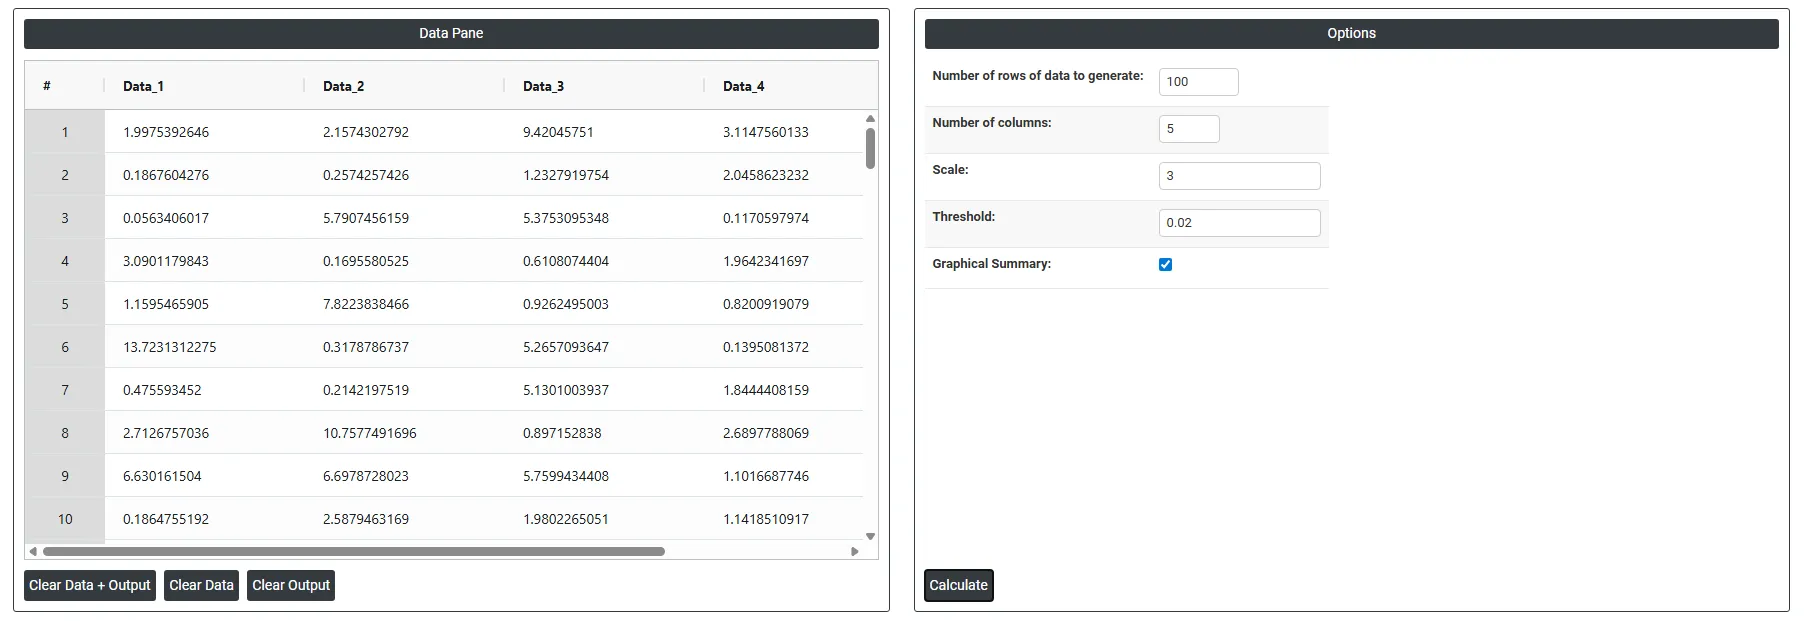
- Um lognormalverteilte Zufallsdaten zu erzeugen, müssen die erforderlichen Optionen ausgefüllt werden.
- Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
- Random Lognormal Data finden Sie unter Statistical module> Random Data > Random Lognormal Data
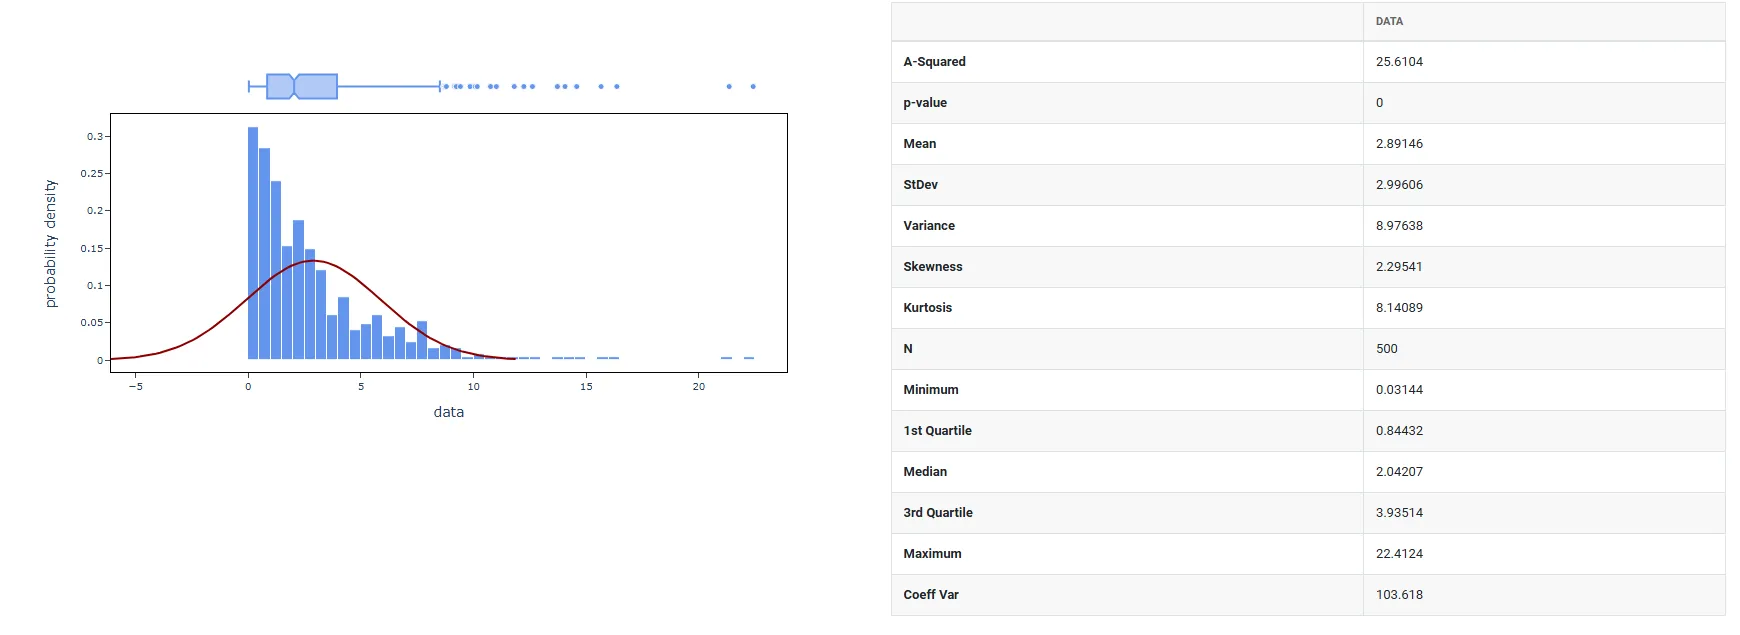
4. Nach Ausführung des oben genannten Werkzeugs erhalten Sie folgende Ausgabe:
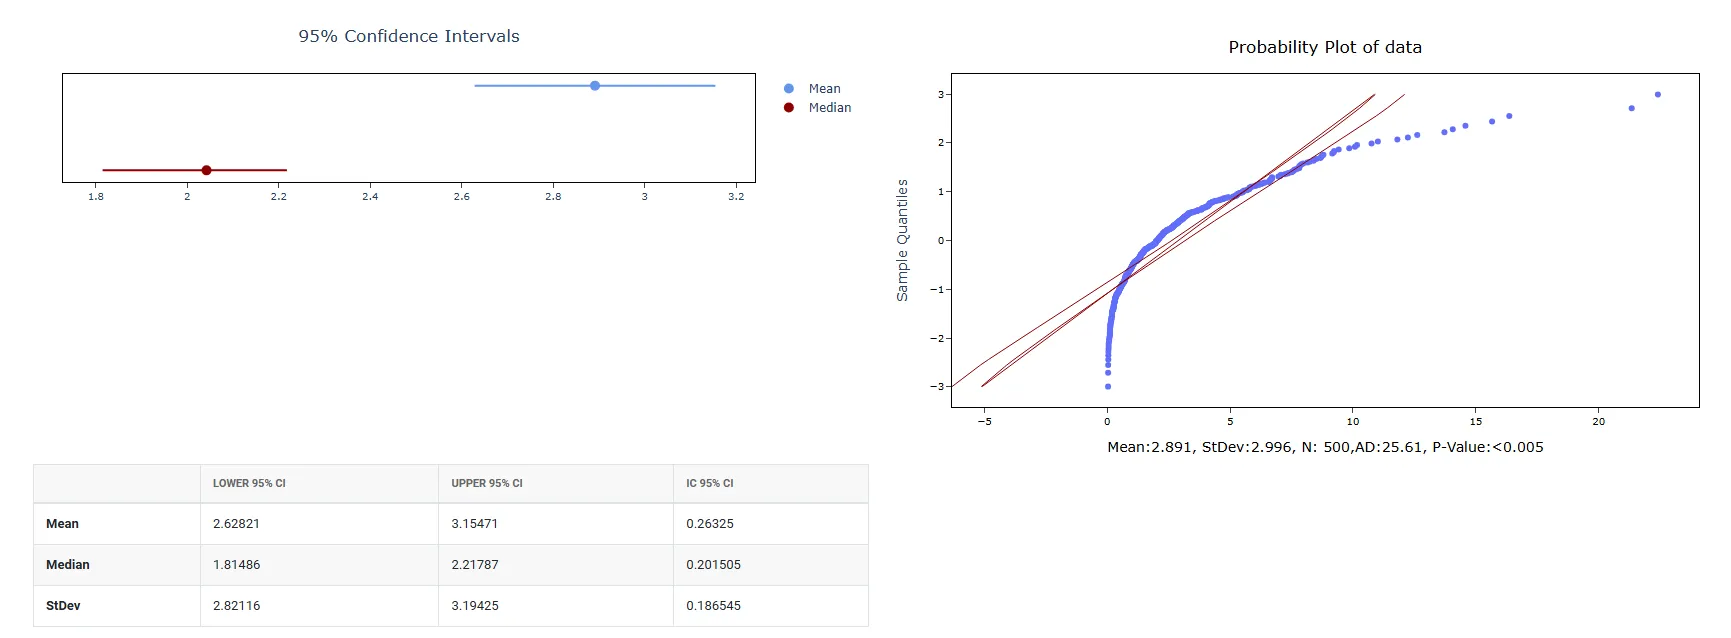
Anleitung: Random Lognormal Data verwenden
Die Anleitung lautet wie folgt:
- Melden Sie sich bei Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Random Data>Random Lognormal Data.
- Füllen Sie anschließend die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Das Dashboard von Random Lognormal Data ist in zwei Bereiche unterteilt.
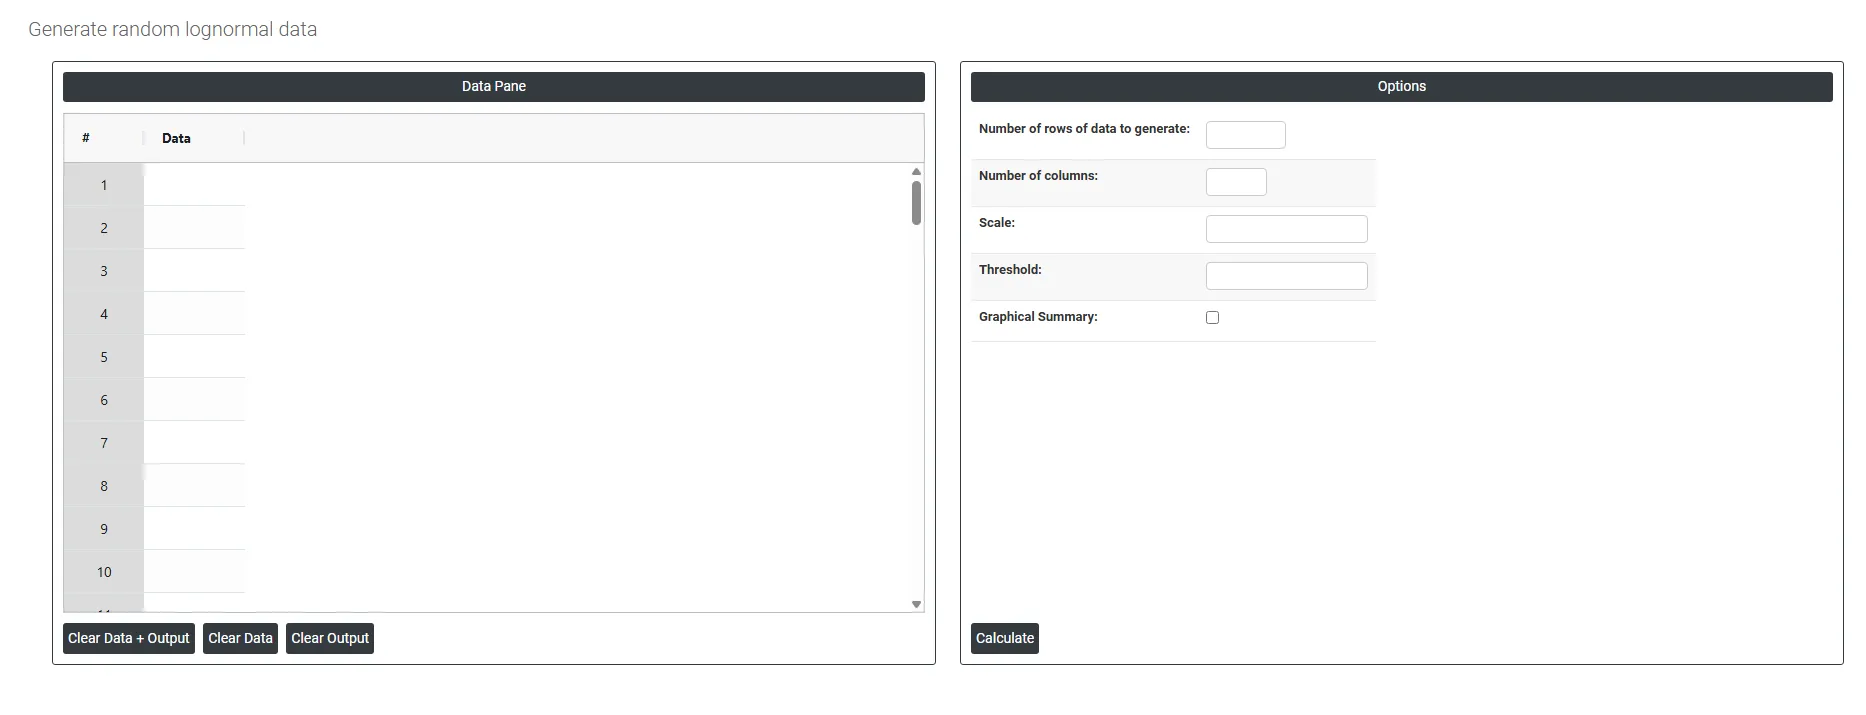
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane enthält jede Zeile erzeugte Zufallsdaten. Die Daten werden erzeugt, nachdem die erforderlichen Optionen ausgefüllt wurden.
Im rechten Bereich stehen folgende Optionen zur Verfügung:
- Number of rows of data to generate: Legt fest, wie viele zufällige Datenpunkte erzeugt werden. Bei Eingabe von 100 entstehen zum Beispiel genau 100 Zeilen mit Zufallswerten, die alle im Data Pane sichtbar sind.
- Number of columns: Legt fest, wie viele Variablen (Spalten) jede Zeile enthält. Bei Eingabe von 5 entstehen zum Beispiel 5 Spalten mit zufällig erzeugten Daten nebeneinander im Data Pane.
- Mean and Standard Deviation: Mittelwert und Standardabweichung der erzeugten Daten selbst (nicht ihrer Logarithmen). Das Werkzeug rechnet sie in die Parameter auf der logarithmischen Skala σ = √ln(1 + (s/m)²) und μ = ln(m) − σ²/2 um. Eine im Verhältnis zum Mittelwert größere Standardabweichung erzeugt stärker rechtsschiefe Werte.
- Threshold: Legt einen Mindestausgangspunkt für die erzeugten Daten fest. Statt bei null zu beginnen, werden die erzeugten Zahlen um diesen Betrag nach oben verschoben. Ein Schwellenwert von 10 bedeutet zum Beispiel, dass alle erzeugten Werte bei 10 beginnen und nach oben reichen, statt bei 0.
- Graphical summary: Nachdem die Zufallsdaten mit dem angegebenen Mittelwert und der angegebenen Standardabweichung erzeugt wurden, erstellt diese Option eine grafische Analyse dieser Daten – etwa ein Histogramm, das zeigt, wie die erzeugten Werte verteilt sind. Es ist ein visuelles Ergebnis auf Basis der soeben erzeugten Daten.
Häufig gestellte Fragen
Was ist eine Lognormalverteilung?
Eine Lognormalverteilung ist eine rechtsschiefe Verteilung, bei der der natürliche Logarithmus der Daten einer Normalverteilung folgt. Ihre Werte sind stets positiv; sie eignet sich daher für Messgrößen wie Partikelgrößen, Antwortzeiten, Einkommen sowie biologische oder Stoffkonzentrationen, die weder null noch negativ sein können.
Wann sollte man lognormalverteilte Zufallsdaten erzeugen?
Verwenden Sie sie, um rechtsschiefe, stets positive stetige Messwerte zu simulieren, oder wenn Ihre Daten nach einer Logarithmustransformation annähernd normalverteilt sind und Sie realistische Rohwerte für eine Simulation benötigen. Üblich ist dies bei Simulationen in Umwelt-, Pharma- und Finanzbereich. Sind die Daten symmetrisch und glockenförmig, verwenden Sie Random Normal Data, und für Ausfallzeiten mit sich ändernder Ausfallrate Random Weibull Data.
Werden Mittelwert und Standardabweichung der Lognormalverteilung auf der logarithmischen Skala eingegeben?
Nein. In diesem Werkzeug beziehen sich Mittelwert und Standardabweichung auf die erzeugten Daten selbst, nicht auf ihre Logarithmen. Das Werkzeug rechnet sie in die Parameter auf der logarithmischen Skala σ = √ln(1 + (s/m)²) und μ = ln(m) − σ²/2 um. Eine im Verhältnis zum Mittelwert größere Standardabweichung erzeugt stärker rechtsschiefe Werte, und ein optionaler Schwellenwert verschiebt alle Werte nach oben.
Lässt sich derselbe lognormalverteilte Zufallsdatensatz erneut erzeugen?
Es wird kein fester Startwert (Seed) verwendet, sodass jeder Klick auf Calculate neue Zufallswerte liefert. Wenn Sie denselben Datensatz wiederverwenden möchten, etwa um eine Analyse zu wiederholen oder sie mit Kollegen zu teilen, kopieren Sie die erzeugten Daten aus dem Data Pane, bevor Sie erneut berechnen. Alle erzeugten Werte sind streng positiv.