
t-verteilte Zufallsdaten (Random T Data)
Random T Data simuliert Werte aus der t-Verteilung, um t-Tests und Konfidenzintervalle zu validieren, Trennschärfeanalysen durchzuführen und zu lehren. Sie legen Anzahl der Zeilen und Spalten, die Freiheitsgrade (typischerweise n - 1) und die Anzahl der Dezimalstellen fest. Wenige Freiheitsgrade ergeben schwerere Enden und extremere Werte; über 30 ist die t-Verteilung nahezu identisch mit der Normalverteilung. Eine grafische Zusammenfassung ist optional verfügbar.
Zuletzt geprüft
Kernaussage
Random T Data erzeugt Werte aus der t-Verteilung, einer symmetrischen Glockenkurve mit schwereren Enden als die Normalverteilung, festgelegt durch ihre Freiheitsgrade, um t-Statistiken und Studien mit kleinen Stichproben zu simulieren.
Auf dieser Seite
Was ist Random T Data?
Random T Data erzeugt Werte aus der t-Verteilung, einer symmetrischen, glockenförmigen Verteilung, die der Normalverteilung ähnelt, aber schwerere Enden hat und über den Parameter Freiheitsgrade gesteuert wird. Mit zunehmenden Freiheitsgraden nähert sich die t-Verteilung der Standardnormalverteilung an. Sie wird häufig verwendet, um t-Teststatistiken zu simulieren und die Unsicherheit in Studien mit kleinen Stichproben zu modellieren.
Einfache Definition:Erzeugt Zufallswerte aus der t-Verteilung, einer Glockenkurve mit schwereren Enden als die Normalverteilung, ideal für Simulationen mit kleinen Stichproben und die Validierung von t-Tests.
Wann wird Random T Data eingesetzt?
- Zum Validieren von t-Tests und Konfidenzintervall-Berechnungen mit bekannten Verteilungseigenschaften.
- Für Simulationen zur Trennschärfeanalyse , um angemessene Stichprobenumfänge für t-Test-Studien zu bestimmen.
- In Lehrdemonstrationen , die zeigen, wie sich die t-Verteilung mit wachsendem Stichprobenumfang der Normalverteilung annähert.
Hinweise zur richtigen Anwendung von Random T Data
- Legen Sie die Freiheitsgrade anhand des Stichprobenumfangs Ihrer Studie fest (typischerweise n − 1).
- Bei vielen Freiheitsgraden (> 30)ist die t-Verteilung nahezu identisch mit der Normalverteilung.
Alternativen: Wann Sie Random T Data nicht verwenden sollten
- Für Simulationen mit großen Stichproben , bei denen eine Normalverteilung angemessen ist, verwenden Sie normalverteilte Zufallsdaten (Random Normal Data)
- Für Simulationen zum Varianzvergleichverwenden Sie F-verteilte Zufallsdaten (Random F Data)
Beispiel für Random T Data
So erzeugen Sie t-verteilte Zufallsdaten:
- Füllen Sie zum Erzeugen t-verteilter Zufallsdaten die erforderlichen Optionen aus.
- Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
- Random T Data finden Sie unter Statistical module> Random Data > Random T Data
4. Nach Ausführung des oben genannten Werkzeugs erhalten Sie folgende Ausgabe:
Anleitung: Random T Data durchführen
So gehen Sie vor:
- Melden Sie sich bei Zometric Statistical Software an unter https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Random Data>Random T Data.
- Füllen Sie anschließend die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
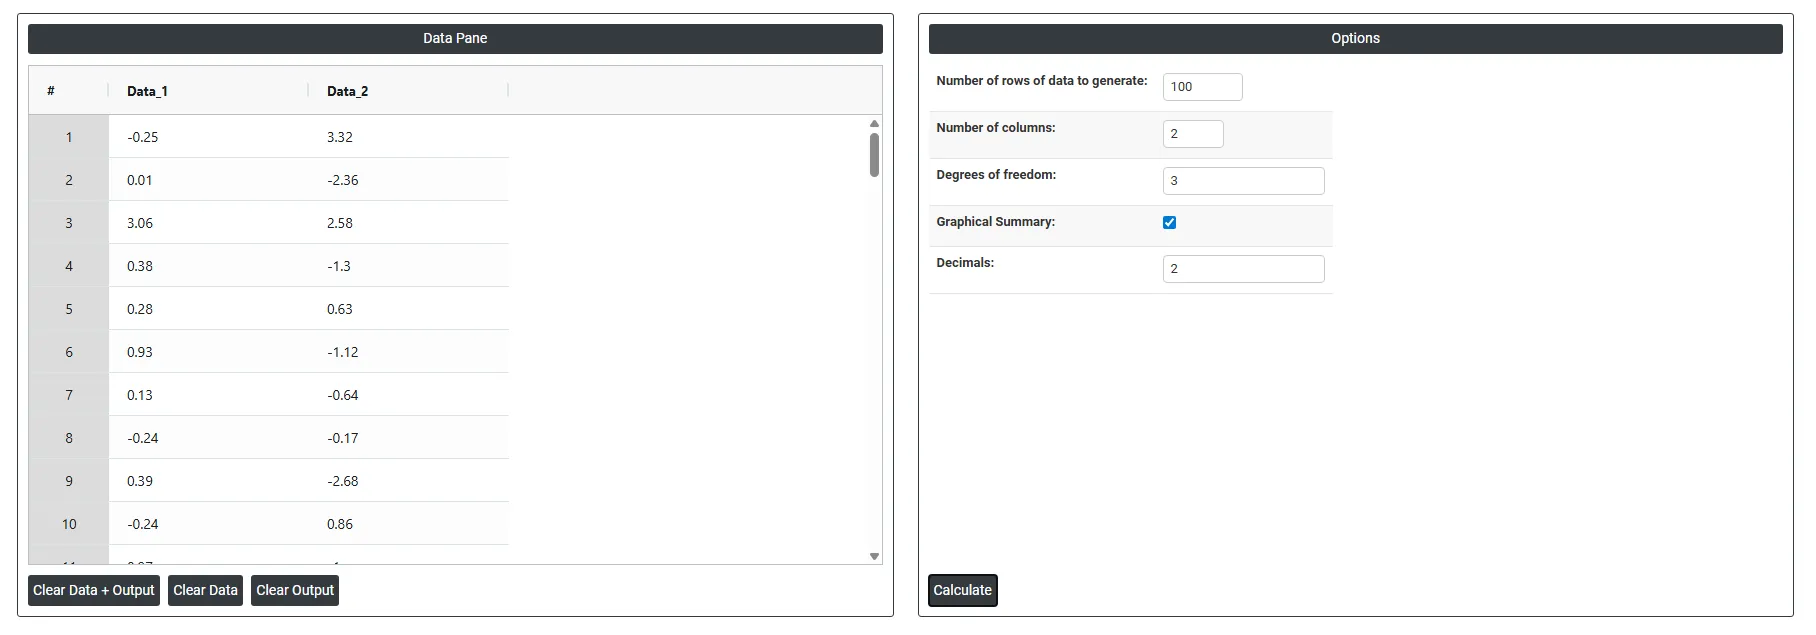
Das Dashboard von Random T Data ist in zwei Bereiche unterteilt.
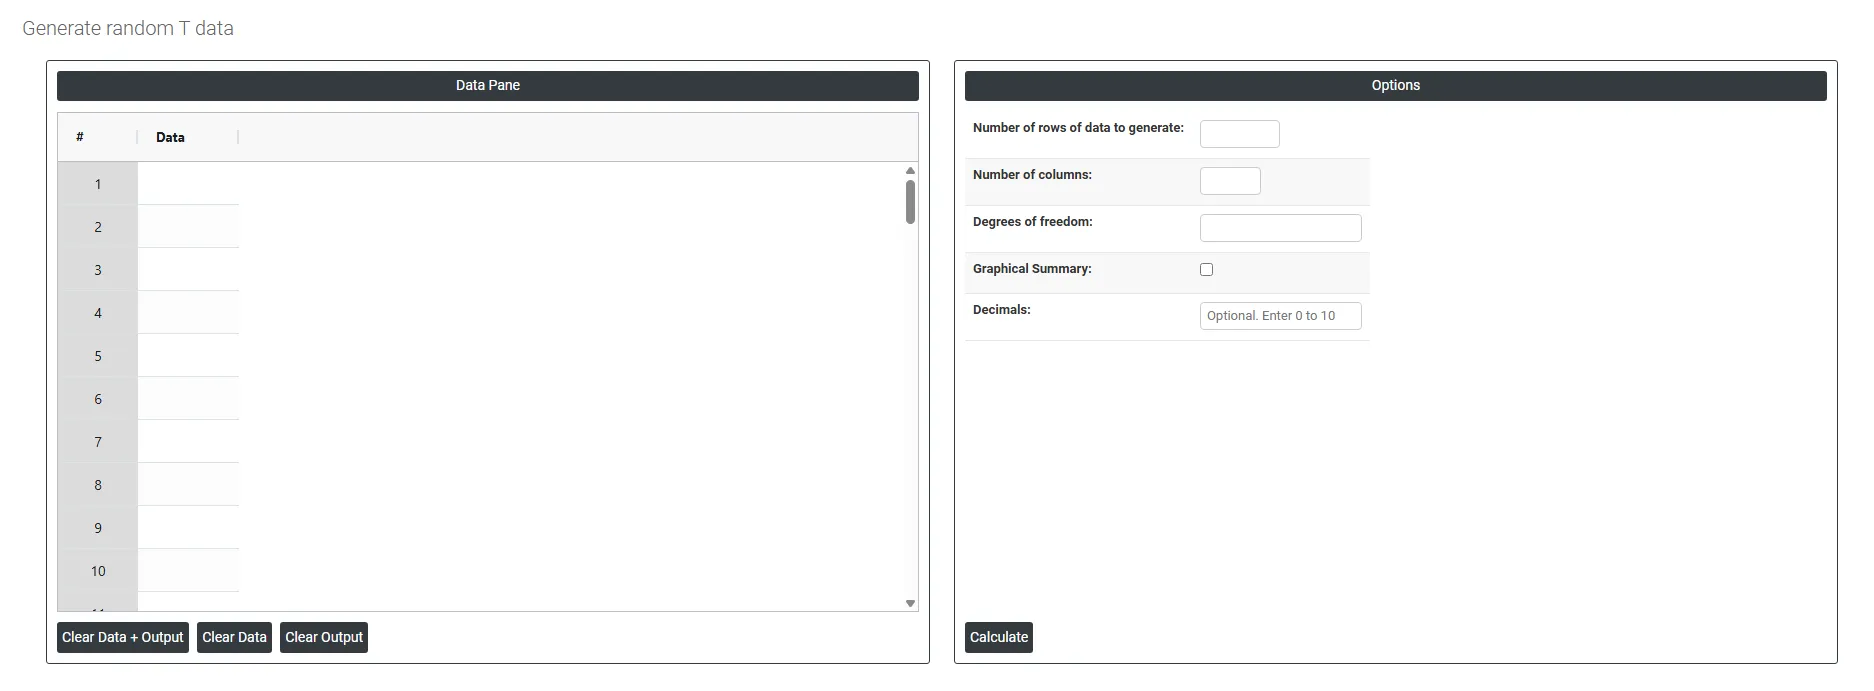
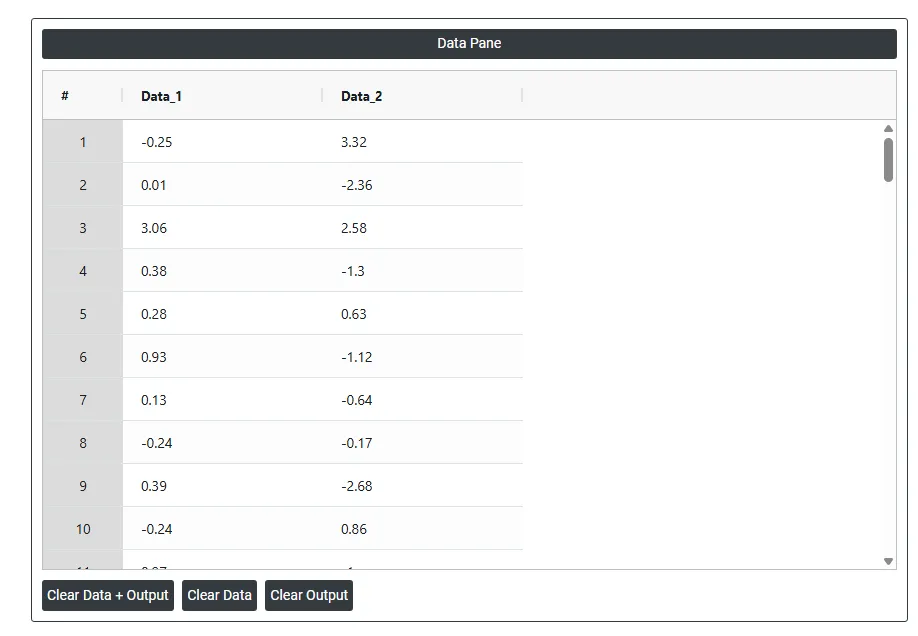
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane enthält jede Zeile erzeugte Zufallsdaten. Die Daten werden erzeugt, nachdem die erforderlichen Optionen ausgefüllt sind.
Im rechten Bereich stehen folgende Optionen zur Verfügung:
- Number of rows of data to generate: Legt fest, wie viele zufällige Datenpunkte erzeugt werden. Bei der Eingabe 10 entstehen beispielsweise genau 10 Zeilen mit Zufallswerten, die alle im Data Pane sichtbar sind.
- Number of columns: Legt fest, wie viele Variablen (Spalten) jede Zeile hat. Bei der Eingabe 3 entstehen beispielsweise 3 nebeneinanderliegende Spalten mit Zufallsdaten im Data Pane.
- Degrees of freedom: Bestimmt die Form der t-Verteilung, aus der die Zufallsdaten erzeugt werden. Bei wenigen Freiheitsgraden (etwa 1 oder 2) hat die Verteilung schwerere Enden, das heißt, in den erzeugten Daten treten mehr Extremwerte auf. Mit zunehmenden Freiheitsgraden nähert sich die t-Verteilung allmählich der Form einer Normalverteilung an. Bei der Eingabe 30 werden beispielsweise Zufallsdaten aus einer t-Verteilung mit 30 Freiheitsgraden erzeugt, deren Werte normalverteilten Daten sehr ähnlich sind.
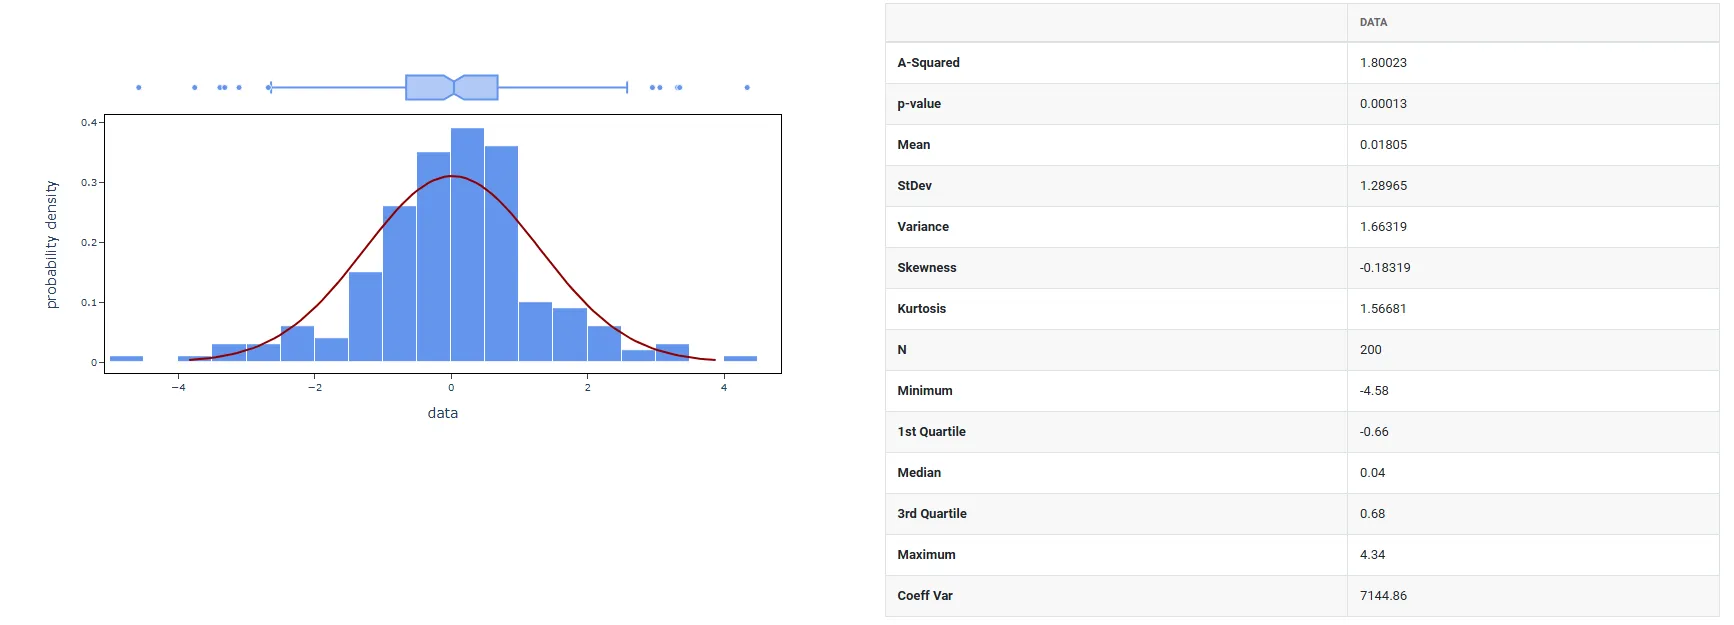
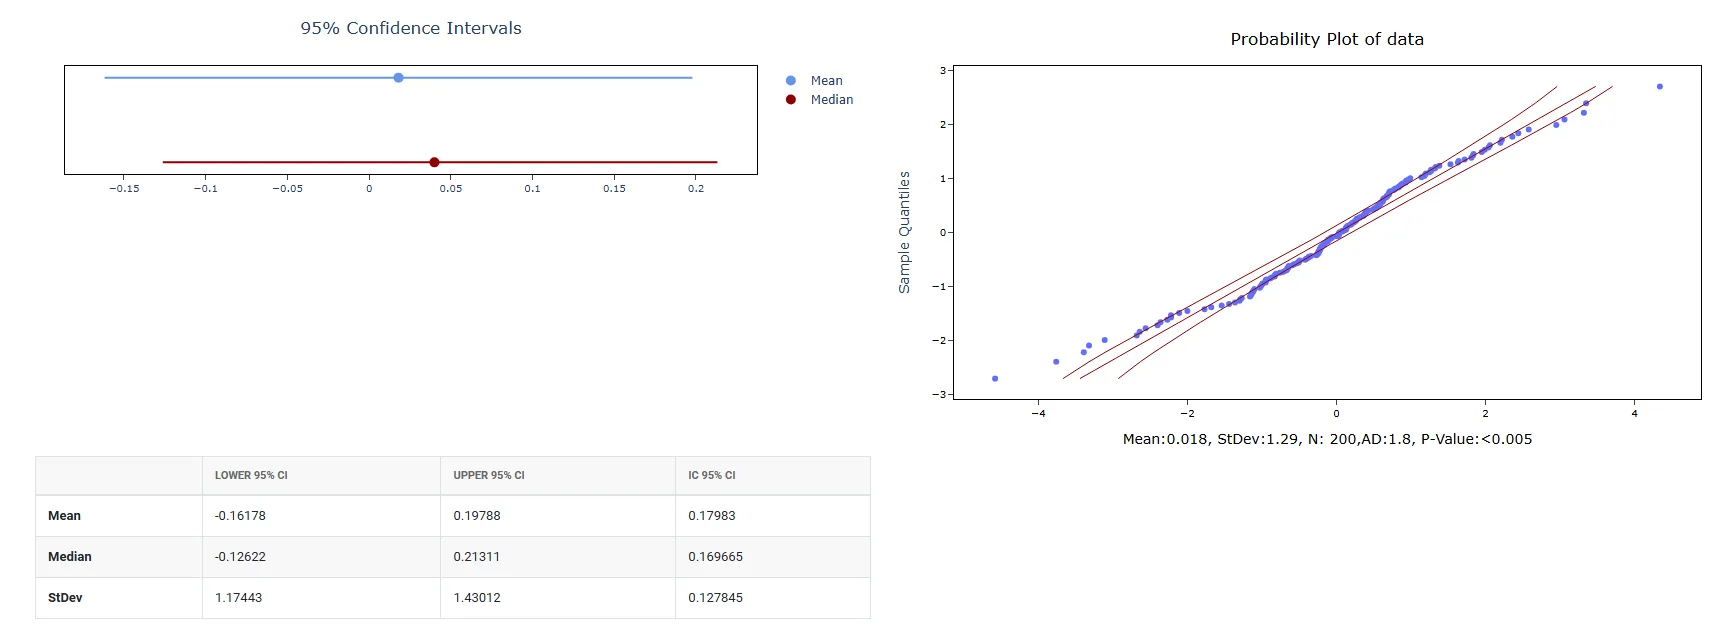
- Graphical summary: Wenn diese Option ausgewählt ist, werden alle erzeugten Werte zusammengefasst und ausgewertet: ein Histogramm mit angepasster Normalverteilungskurve und Boxplot, zusammenfassende Statistiken, ein Anderson-Darling-Test auf Normalverteilung, ein Wahrscheinlichkeitsnetz und 95%-Konfidenzintervalle für Mittelwert, Median und Standardabweichung. Es ist ein visuelles Ergebnis auf Basis der soeben erzeugten Daten.
- Decimals: Steuert die Anzahl der Dezimalstellen der erzeugten Zufallswerte selbst. Bei der Einstellung 2 wird beispielsweise jede erzeugte Zahl auf 2 Dezimalstellen gerundet, etwa 47.83 oder 52.16. Bei der Einstellung 0 entstehen nur ganze Zahlen.
Häufig gestellte Fragen
Was ist die t-Verteilung?
Die t-Verteilung ist eine symmetrische, glockenförmige Verteilung, die der Normalverteilung ähnelt, aber schwerere Enden hat und über den Parameter Freiheitsgrade gesteuert wird. Mit zunehmenden Freiheitsgraden nähert sie sich der Standardnormalverteilung an. Sie wird häufig verwendet, um t-Teststatistiken zu simulieren und die Unsicherheit in Studien mit kleinen Stichproben zu modellieren.
Welche Freiheitsgrade sollten Sie für t-verteilte Zufallsdaten verwenden?
Legen Sie die Freiheitsgrade anhand des Stichprobenumfangs Ihrer Studie fest, typischerweise n - 1. Niedrige Werte wie 1 oder 2 ergeben schwerere Enden und extremere Werte. Bei vielen Freiheitsgraden, über 30, ist die t-Verteilung nahezu identisch mit der Normalverteilung; für Simulationen mit großen Stichproben können Sie dann stattdessen Random Normal Data verwenden.
Wann sollten Sie t-verteilte Zufallsdaten erzeugen?
Verwenden Sie sie, um t-Tests und Konfidenzintervall-Berechnungen mit bekannten Verteilungseigenschaften zu validieren, in Simulationen zur Trennschärfeanalyse, um angemessene Stichprobenumfänge für t-Test-Studien zu ermitteln, und im Unterricht, um zu zeigen, wie sich die t-Verteilung mit wachsendem Stichprobenumfang der Normalverteilung annähert. Für Simulationen zum Varianzvergleich verwenden Sie stattdessen Random F Data.