
S-Karte (Standardabweichungskarte)
Die S-Karte stellt die Standardabweichung jeder Teilgruppe dar, um zu prüfen, ob die Prozessstreuung stabil bleibt, und wird vor der Xbar-Karte gelesen. Verwenden Sie sie bei Teilgruppen über 8 oder wenn Sie Änderungen der Streuung empfindlicher erkennen müssen. Halten Sie die Teilgruppengrößen konstant, erheben Sie mindestens 25 Teilgruppen und verwenden Sie unabhängige, normalverteilte Daten. Testregeln melden Verschiebungen, Trends und andere nicht zufällige Muster.
Zuletzt geprüft
Kernaussage
Eine S-Karte überwacht die Standardabweichung von Teilgruppen über die Zeit zusammen mit einer Xbar-Karte und ersetzt bei Teilgruppen über 8 die R-Karte, da die Standardabweichung jeden Datenpunkt der Teilgruppe nutzt.
Auf dieser Seite
Was ist eine S-Karte?
Eine S-Karte überwacht die Standardabweichung (Streuung) von Teilgruppen über die Zeit. Sie wird zusammen mit der Xbar-Karte verwendet und ersetzt bei größeren Teilgruppen die R-Karte, da die Standardabweichung bei größeren Stichproben ein genaueres und empfindlicheres Streuungsmaß ist als die Spannweite.
Während die R-Karte nur den Abstand zwischen dem größten und dem kleinsten Wert betrachtet, berücksichtigt die S-Karte jeden einzelnen Datenpunkt der Teilgruppe — und liefert so ein genaueres Bild davon, wie stark der Prozess streut.
Einfache Definition: Eine Karte, die verfolgt, wie viel Streuung innerhalb jeder Stichprobe über die Zeit besteht, und dafür die Standardabweichung für eine genauere Sicht verwendet — besonders nützlich bei größeren Teilgruppen.
Wann wird eine S-Karte eingesetzt?
- Verwenden Sie sie, wenn die Teilgruppengröße größer als 8 ist — bei dieser Größe ist die Standardabweichung ein zuverlässigeres Maß als die Spannweite.
- Verwenden Sie sie zusammen mit einer Xbar-Karte , um Prozesslage und Prozessstreuung gleichzeitig zu überwachen.
- Verwenden Sie sie, wenn Sie kleine Änderungen der Prozessstreuung empfindlicher erkennen müssen.
- Bei Teilgruppengrößen von 2 bis 8genügt die Xbar-R-Karte, die zudem einfacher zu interpretieren ist.
Hinweise zur richtigen Anwendung der S-Karte
- Prüfen Sie immer die S-Karte, bevor Sie die Xbar-Karte interpretieren — instabile Streuung macht die Grenzen der Xbar-Karte unzuverlässig.
- Halten Sie die Teilgruppengrößen konstant über alle Zeitpunkte, damit die Eingriffsgrenzen korrekt berechnet werden.
- Erheben Sie mindestens 25 Teilgruppen , um zuverlässige Ausgangs-Eingriffsgrenzen festzulegen.
- Die Daten innerhalb der Teilgruppen sollten unabhängig und normalverteilt sein, damit die S-Karte zuverlässig arbeitet.
Alternativen: Wann Sie keine S-Karte verwenden sollten
- Beträgt die Teilgruppengröße 8 oder weniger, verwenden Sie stattdessen die Xbar-R-Karte — sie ist einfacher und bei kleinen Teilgruppen ebenso wirksam.
- Werden die Daten als Einzelmessungen ohne Teilgruppenbildungerhoben, verwenden Sie die I-MR-Karte
- Besteht die Zielgröße aus attributiven Daten (Anzahl oder Anteil fehlerhafter Einheiten), verwenden Sie P-, NP-, C- oder U-Karten
- Haben Sie kurze Fertigungsläufe oder wechselnde Produkte auf demselben Prozess, verwenden Sie die Z-MR-Karte
Beispiel für eine S-Karte
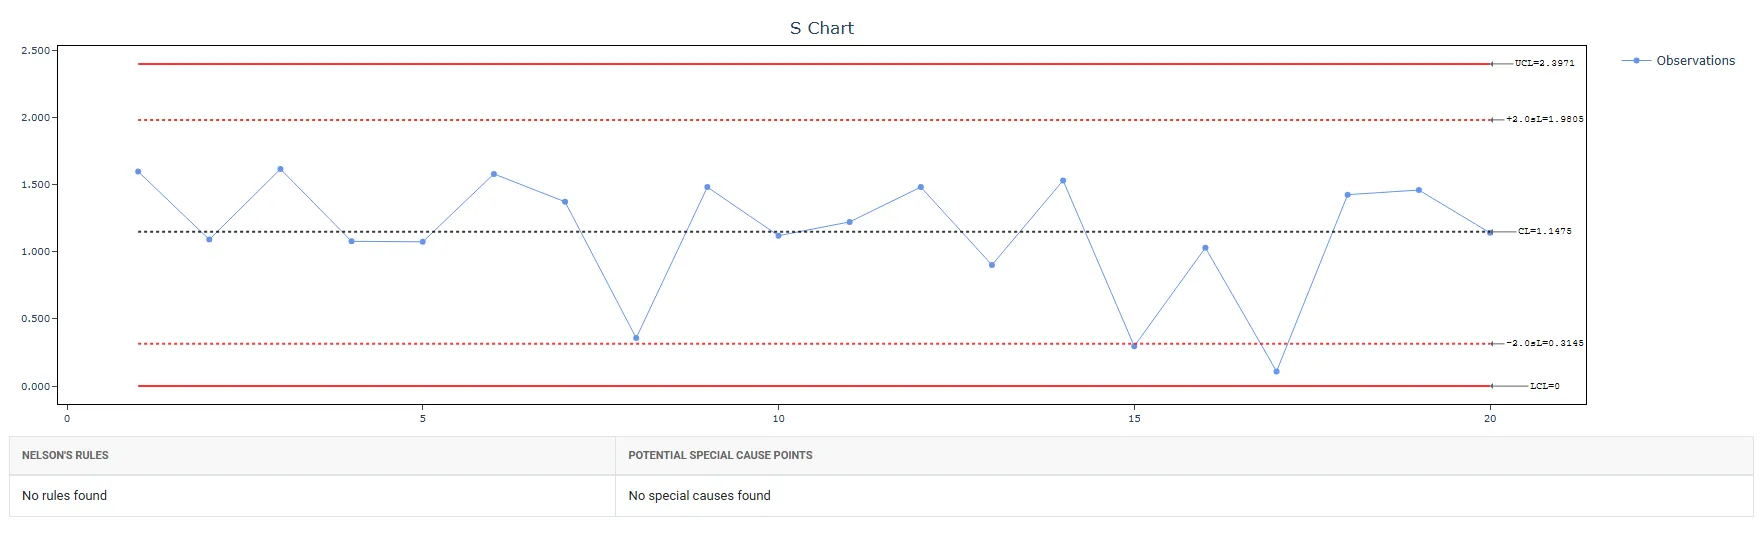
Ein Qualitätsingenieur in einem Automobilzulieferwerk überwacht die Länge von Nockenwellen. Er erhebt alle 30 Minuten Daten in Teilgruppen der Größe 5. Er möchte in der Regelkarte nach systematischen (besonderen) Ursachen suchen, falls vorhanden. 1. Lassen Sie Prozessmittelwert und Prozess-Standardabweichung leer, da sie derzeit unbekannt sind. 2. Aktivieren Sie alle 8 Nelson-Regeln.
Dazu wendet der Ingenieur die S-Karte an und führt die folgenden Schritte aus:
- Die erforderlichen Daten wurden erhoben.
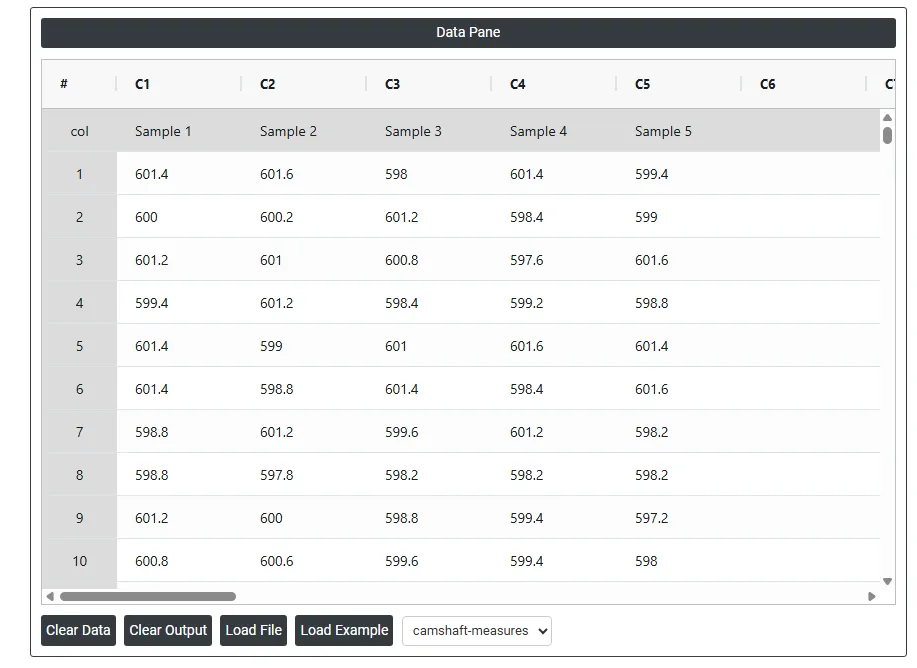
- Analysieren Sie die Daten nun in Zometric Statistical Software unter https://statsai.zometric.com/.
- Um die S-Karte aufzurufen, wählen Sie Statistical module> Control Charts>S Chart.
- Geben Sie im Werkzeug die Daten und weitere Eingaben wie folgt ein:
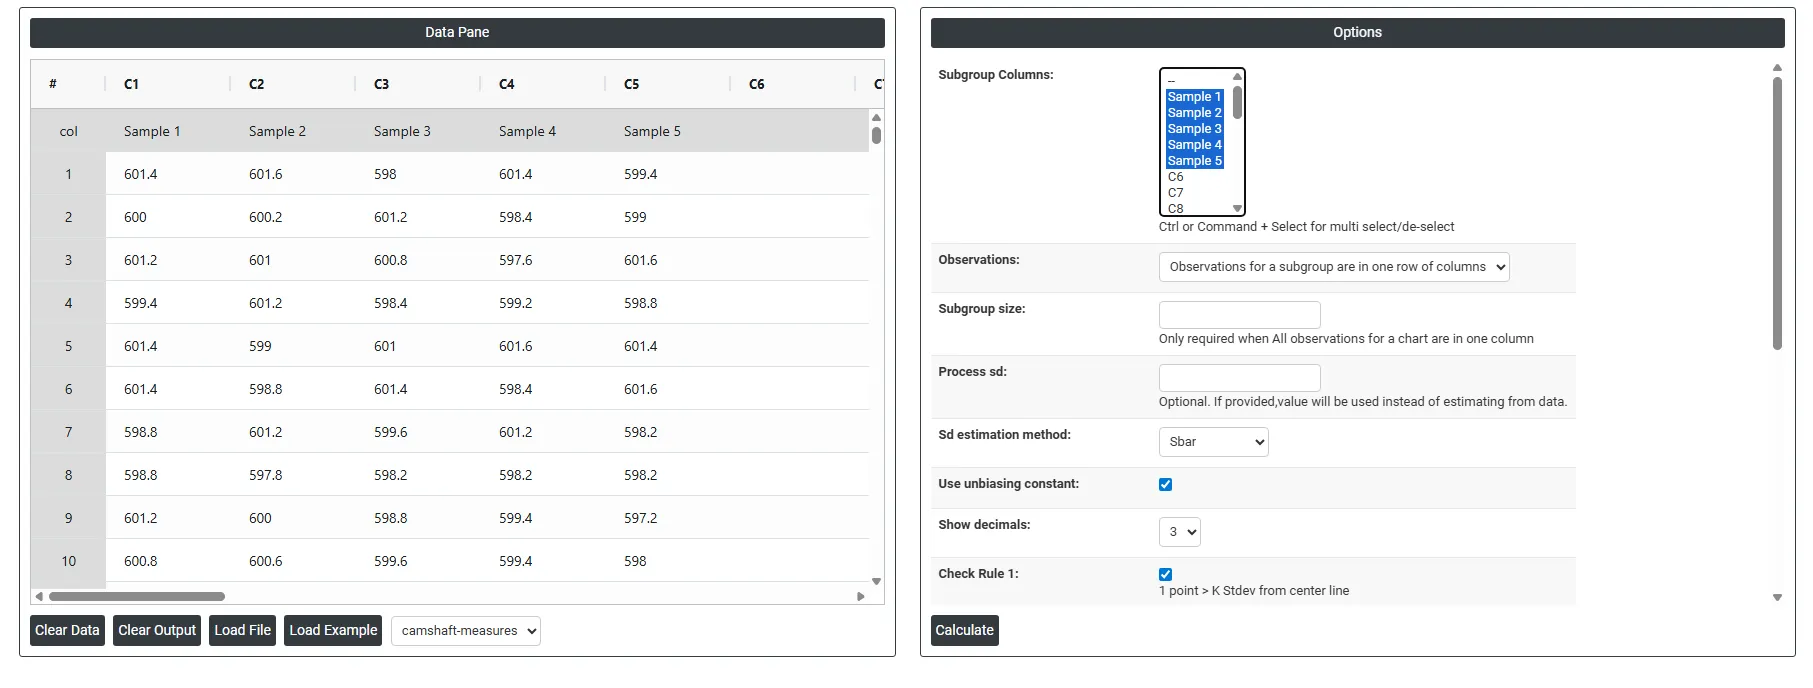
5. Nach Anwendung des oben genannten Werkzeugs erhalten Sie folgende Ausgabe:
Anleitung: S-Karte
Die Anleitung lautet wie folgt:
- Melden Sie sich bei Zometric Statistical Software an: https://statsai.zometric.com/
- Wählen Sie auf der Startseite Statistical Tool> Control Charts >S Chart.
- Klicken Sie auf S Chart, um zum Dashboard zu gelangen.
- Geben Sie die Daten anschließend manuell ein, oder kopieren Sie sie vollständig (Ctrl+C) aus einer Excel-Tabelle und fügen Sie sie hier ein (Ctrl+V).
- Füllen Sie anschließend die erforderlichen Optionen aus.
- Klicken Sie abschließend unten auf der Seite auf calculate, um die gewünschten Ergebnisse zu erhalten.
Im Dashboard von S Chart ist das Fenster in zwei Bereiche geteilt.
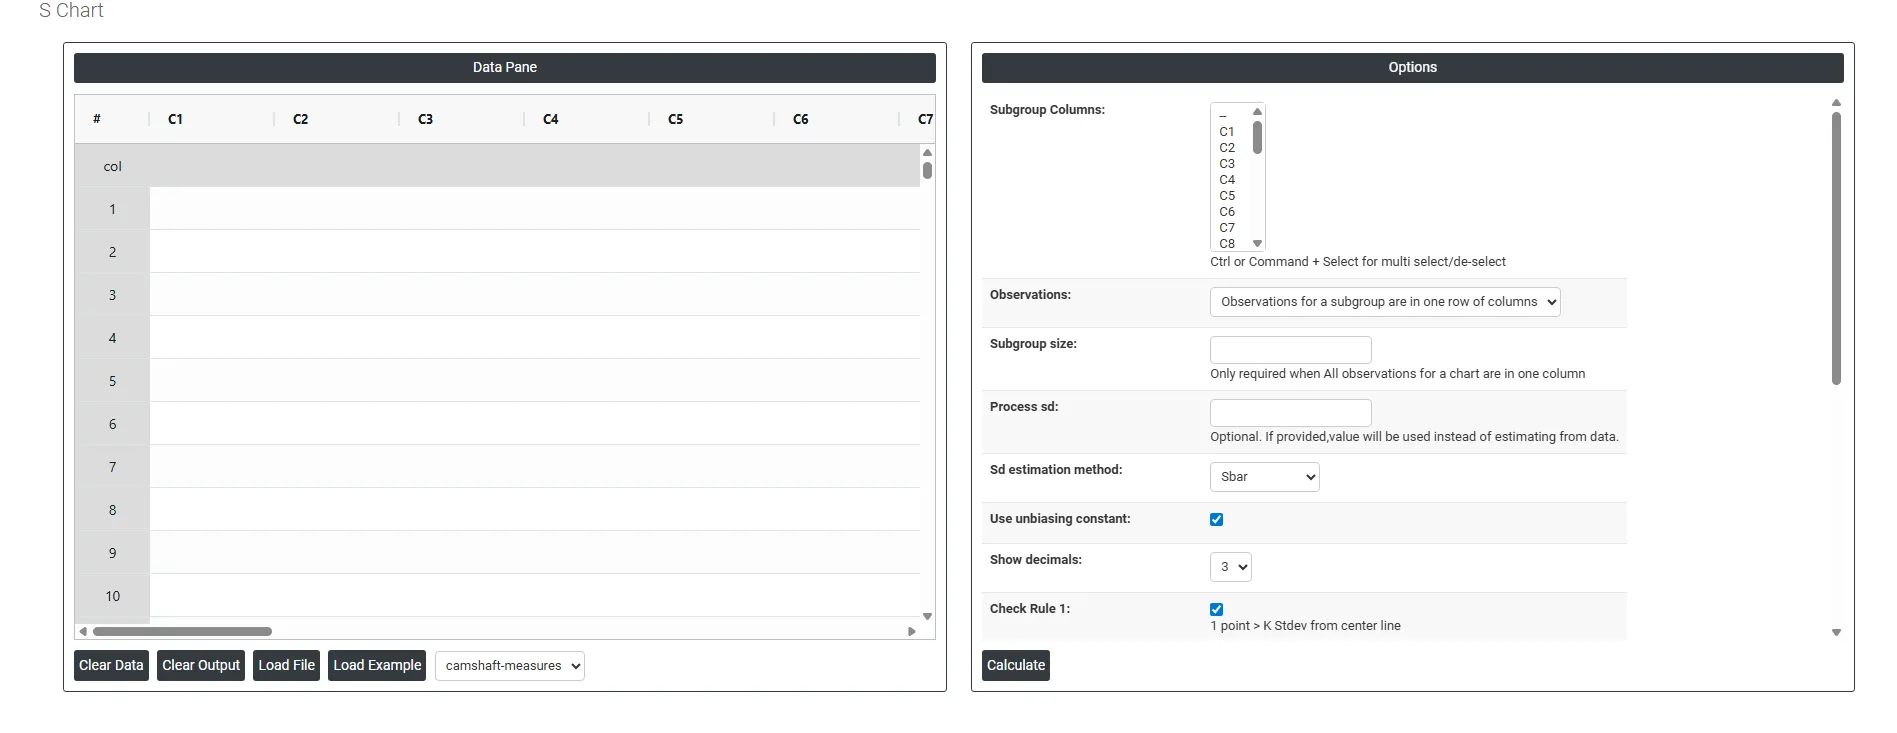
Im linken Bereich befindet sich der Datenbereich (Data Pane). Im Data Pane bildet jede Zeile eine Teilgruppe. Die Daten können manuell eingegeben oder vollständig aus einer Excel-Tabelle kopiert (Ctrl+C) und hier eingefügt (Ctrl+V) werden.
Load example: Beispieldaten werden geladen.
Load File: Damit laden Sie Excel-Daten direkt.
Im rechten Bereich stehen folgende Optionen zur Verfügung:
- Subgroup Columns Hier können Sie je nach Aufbau Ihrer Daten eine oder mehrere Spalten auswählen. Ist jede Teilgruppe auf mehrere Spalten verteilt (eine Spalte je Messposition), wählen Sie alle diese Spalten aus. Stehen alle Messwerte untereinander in einer Spalte, wählen Sie diese eine Spalte und legen die Teilgruppengröße separat fest. Die Auswahl bestimmt unmittelbar, wie die Karte Ihre Daten zur Berechnung der Teilgruppenmittelwerte gruppiert.
- Observations: Diese Einstellung legt fest, wie Ihre Daten im Arbeitsblatt angeordnet sind. Wählen Sie die Option, die Ihrem Datenaufbau entspricht:
- Observations for a subgroup are in one row of columns — jede Zeile enthält alle Messwerte einer Teilgruppe, verteilt auf mehrere Spalten. Beispiel: Zeile 1 enthält in fünf Spalten fünf Messwerte, die Teilgruppe 1 bilden.
- All observations for a chart are in one column — alle Messwerte stehen untereinander in einer einzigen Spalte, und mit dem Feld für die Teilgruppengröße wird festgelegt, wie viele Zeilen zu jeder Teilgruppe gehören.
Wird hier der falsche Aufbau gewählt, gruppiert die Karte die Daten falsch und liefert ungültige Eingriffsgrenzen.
- Subgroup Size Nur erforderlich, wenn alle Messwerte in einer einzigen Spalte stehen. Gibt an, wie viele aufeinanderfolgende Zeilen eine Teilgruppe bilden. Bei einer Teilgruppengröße von 5 behandelt die Karte z. B. die Zeilen 1–5 als Teilgruppe 1, die Zeilen 6–10 als Teilgruppe 2 usw. Sind Ihre Daten bereits auf mehrere Spalten verteilt (eine je Messung), wird dieses Feld nicht benötigt, da die Teilgruppengröße durch die Anzahl der ausgewählten Spalten festgelegt ist.
- Process mean: Der Mittelwert einer Reihe von Messungen oder Beobachtungen aus einem Prozess. Er stellt die zentrale Tendenz der Prozessdaten über die Zeit dar und ist ein wichtiger Indikator für die Prozessleistung. Wird er nicht angegeben, berechnet Zometric Statistical Software die Mittellinie aus den vorhandenen Daten.
- Process sd: Ein Maß für die Streuung der Prozessdaten um den Mittelwert. Sie zeigt an, wie stark einzelne Datenpunkte des Prozesses vom Prozessmittelwert abweichen. Wird sie nicht angegeben, berechnet Zometric Statistical Software sie aus den vorhandenen Daten.
- Sd estimation method: Hier stehen zwei Berechnungsmöglichkeiten zur Wahl. Ob Rbar oder die gepoolte Standardabweichung als Schätzmethode gewählt wird, verändert das Ergebnis.
- Schätzmethode Rbar: Schätzt die Prozess-Standardabweichung aus dem Mittelwert der Spannweiten der Teilgruppen geteilt durch die Korrekturkonstante d2 (Rbar/d2). Diese Methode wird für Teilgruppengrößen von 8 oder weniger empfohlen; bei größeren Teilgruppen nutzt die gepoolte Standardabweichung jeden Datenpunkt und liefert eine genauere Schätzung. Schätzmethode Pooled: Die gepoolte Standardabweichung ist der gewichtete Mittelwert der Varianzen der Teilgruppen, wobei größere Teilgruppen stärker in die Gesamtschätzung eingehen. Diese Methode liefert eine genauere Schätzung der Standardabweichung, wenn der Prozess stabil ist.
- Use unbiasing constants for pooled sd: Diese Option gilt nur, wenn die Standardabweichung mit der Methode der gepoolten Standardabweichung geschätzt wird.
- Show Decimals Legt fest, wie viele Nachkommastellen für die dargestellten Werte, die Eingriffsgrenzen und die Mittellinie in der Karte angezeigt werden. Mehr Nachkommastellen ermöglichen ein genaueres Ablesen; weniger halten die Karte übersichtlich und präsentationsfreundlich. Wählen Sie die Stufe, die Genauigkeit und Lesbarkeit für Ihre Zielgruppe ausgewogen verbindet.
- Check Rule 1: 1 point > K Stdev from center line: Test 1 ist grundlegend, um Teilgruppen zu erkennen, die deutlich von den übrigen abweichen, und gilt daher allgemein als Werkzeug zur Erkennung von Zuständen außer Kontrolle. Um die Empfindlichkeit zu erhöhen und kleinere Prozessverschiebungen zu erkennen, kann Test 2 zusammen mit Test 1 verwendet werden, was die Wirksamkeit der Regelkarte steigert.
- Check Rule 2: K points in a row on same side of center line: Test 2 erkennt Änderungen der Prozesslage oder der Streuung. Bei der Überwachung auf kleine Prozessverschiebungen kann Test 2 zusammen mit Test 1 verwendet werden, um die Empfindlichkeit der Regelkarte zu erhöhen.
- Check Rule 3: K points in a row, all increasing or all decreasing: Test 3 dient dazu, Trends in einem Prozess zu erkennen. Er sucht gezielt nach einer längeren Folge aufeinanderfolgender Datenpunkte, deren Werte durchgehend steigen oder fallen, was auf einen möglichen zugrunde liegenden Trend im Prozessverhalten hinweist.
- Check Rule 4: K points in a row, alternating up and down: Test 4 dient dazu, systematische Schwankungen in einem Prozess zu erkennen. Idealerweise sollte das Streuungsmuster eines Prozesses zufällig sein. Verletzt ein Punkt Test 4, kann das darauf hindeuten, dass die Streuung nicht zufällig ist, sondern einem vorhersagbaren Muster folgt.
- Check Rule 5: K out of K + 1 points > 2 standard deviation from center line (same side): Test 5 erkennt kleine Verschiebungen im Prozess.
- Check Rule 6: K out of K + 1 points > 1 standard deviation from center line (same side):Test 6 erkennt kleine Verschiebungen im Prozess.
- Check Rule 7: K points in a row within 1 standard deviation of center line (either side):Test 7 erkennt Streuungsmuster, die fälschlich als Beleg für eine gute Prozessbeherrschung gedeutet werden können. Er erkennt zu weite Eingriffsgrenzen, die häufig auf geschichtete Daten zurückgehen. Geschichtete Daten entstehen, wenn innerhalb jeder Teilgruppe eine systematische Streuungsquelle besteht, wodurch die Eingriffsgrenzen breiter erscheinen, als sie sein sollten.
- Check Rule 8: K points in a row > 1 standard deviation from center line (either side):Test 8 erkennt ein Mischungsmuster. Bei einem Mischungsmuster liegen die Punkte eher abseits der Mittellinie und stattdessen nahe den Eingriffsgrenzen.
- Additional CLs at Multiples of SD 1 Fügt eine zusätzliche Grenzlinie bei ±1 Standardabweichung um die Mittellinie hinzu. Dadurch entsteht eine innere Zone in der Karte, die für die Anwendung von Western-Electric- oder Nelson-Regeln nützlich ist, die nach ungewöhnlichen Mustern innerhalb der Eingriffsgrenzen suchen — etwa einer Folge von Punkten, die durchgehend auf einer Seite der Mittellinie liegen.
- Additional CLs at Multiples of SD 2 Fügt eine zusätzliche Grenzlinie bei ±2 Standardabweichungen um die Mittellinie hinzu. Dadurch entsteht eine mittlere Warnzone zwischen der Mittellinie und den üblichen ±3-Sigma-Eingriffsgrenzen. Punkte zwischen der 2-Sigma- und der 3-Sigma-Linie können frühzeitig vor einer Prozessverschiebung warnen, bevor ein Punkt tatsächlich außer Kontrolle gerät.
- Define Stages (Historical Groups) with This Variable Ermöglicht es, die Karte mithilfe einer Gruppierungsvariablen in getrennte Phasen oder Stufen zu unterteilen. Jede Stufe erhält eigene, unabhängig berechnete Eingriffsgrenzen. Das ist nützlich, wenn eine bekannte Prozessänderung stattgefunden hat — etwa eine neue Maschine, eine Prozessverbesserung oder ein Rohstoffwechsel — und Sie die Prozessleistung vor und nach dieser Änderung in derselben Karte vergleichen möchten.
- X Scale Legt fest, wie die horizontale Achse der Karte angezeigt wird. Sie können die Skala so anpassen, dass sie zeitbezogene Beschriftungen, Teilgruppennummern oder eigene Werte zeigt. Das ist nützlich, wenn Ihre Teilgruppen bestimmten Daten, Schichten oder Chargen entsprechen und die Achse diesen Kontext statt bloßer fortlaufender Nummern widerspiegeln soll; so ist die Karte leichter zu lesen und zu präsentieren.
Häufig gestellte Fragen
Was ist eine S-Karte?
Eine S-Karte überwacht die Standardabweichung, also die Streuung, von Teilgruppen über die Zeit. Sie wird zusammen mit der Xbar-Karte verwendet und ersetzt bei größeren Teilgruppen die R-Karte, da die Standardabweichung jeden Datenpunkt der Teilgruppe statt nur des größten und kleinsten Werts nutzt und so ein genaueres und empfindlicheres Streuungsmaß liefert.
Wann sollten Sie eine S-Karte statt einer R-Karte verwenden?
Verwenden Sie eine S-Karte, wenn die Teilgruppengröße größer als 8 ist, da die Standardabweichung dann ein zuverlässigeres Maß als die Spannweite ist, oder wenn Sie kleine Änderungen der Streuung empfindlicher erkennen müssen. Bei Teilgruppengrößen von 2 bis 8 genügt die Xbar-R-Karte, die zudem einfacher zu interpretieren ist.
Welche Voraussetzungen gelten für eine gültige S-Karte?
Halten Sie die Teilgruppengrößen über alle Zeitpunkte konstant, erheben Sie mindestens 25 Teilgruppen, um zuverlässige Ausgangs-Eingriffsgrenzen festzulegen, und stellen Sie sicher, dass die Daten innerhalb der Teilgruppen unabhängig und normalverteilt sind. Prüfen Sie immer die S-Karte, bevor Sie die Xbar-Karte interpretieren, da instabile Streuung die Grenzen der Xbar-Karte unzuverlässig macht.
Welche Methode zur Schätzung der Standardabweichung sollten Sie für eine S-Karte verwenden?
Es stehen zwei Methoden zur Verfügung. Rbar schätzt die Prozess-Standardabweichung als mittlere Spannweite der Teilgruppen geteilt durch die Korrekturkonstante d2 (Rbar/d2) und wird für Teilgruppengrößen von 8 oder weniger empfohlen. Bei größeren Teilgruppen nutzt die gepoolte Standardabweichung, ein gewichteter Mittelwert der Varianzen der Teilgruppen, jeden Datenpunkt und liefert eine genauere Schätzung.