
Stichprobenumfang für die Schätzung (Sample Size for Estimation)
Sample Size for Estimation plant eine Untersuchung, deren Ziel die genaue Messung eines Mittelwerts oder Anteils ist, nicht der Test auf einen Unterschied. Geben Sie Ziel-Fehlermargen ein, um Stichprobenumfänge zu erhalten, oder Stichprobenumfänge, um Margen zu erhalten. Ein Mittelwert benötigt eine angenommene Standardabweichung und verwendet die t-Verteilung; ein Anteil benötigt einen Planungswert, standardmäßig 0.5, und verwendet die Normalapproximation.
Zuletzt geprüft
Kernaussage
Sample Size for Estimation berechnet, wie viele Beobachtungen nötig sind, um einen Mittelwert oder Anteil mit gewählter Fehlermarge (halbe Breite des Konfidenzintervalls) zu schätzen, oder welche Marge eine Stichprobe erreicht.
Auf dieser Seite
Zweck
Sample Size for Estimation ermittelt, wie viele Beobachtungen nötig sind, um einen Mittelwert oder einen Anteil mit einer gewählten Genauigkeit zu schätzen, oder wie genau die Schätzung mit einer gegebenen Stichprobe ist. Die Genauigkeit wird als Fehlermarge (Margin of Error) angegeben: die halbe Breite des Konfidenzintervalls, sodass die Schätzung „Wert ± Marge“ lautet. Verwenden Sie es, wenn das Ziel ist, etwas gut zu messen, etwa die mittlere Zykluszeit, das mittlere Beschichtungsgewicht oder den Anteil verspäteter Aufträge, und nicht, einen Unterschied zu testen (dafür verwenden Sie die Werkzeuge für Trennschärfe und Stichprobenumfang bei Hypothesentests).
Wichtigste Funktionen
- Schätzt einen Mittelwert (Mean, mit angenommener Standardabweichung) oder einen Anteil (Proportion, mit Planungswert).
- Berechnet den Stichprobenumfang aus Ziel-Fehlermargen oder die Fehlermarge aus geplanten Stichprobenumfängen: Lassen Sie die gesuchte Größe leer.
- Mehrere Werte gleichzeitig, z. B. Margen „0.5 1“, ergeben je eine Zeile.
- Bei der Berechnung des Stichprobenumfangs werden die ganzzahlige Anzahl der Beobachtungen und die damit tatsächlich erreichte Fehlermarge ausgegeben.
- Beliebiges Konfidenzniveau von 75 bis 100%.
Statistische Methoden
Für einen Mittelwert ist die eingegebene Standardabweichung ein Planungswert und kein bekannter Wert; daher verwendet die Fehlermarge die t-Verteilung, ebenso wie das Konfidenzintervall, das Sie später aus den Daten berechnen (Minitab verfährt ebenso, wenn σ nicht bekannt ist). Für einen Anteil verwendet das Werkzeug die Normalapproximation. Bei Konfidenzniveau C gilt α = 1 − C/100; z = z₁₋α/₂ (1.960 für 95%) und t = t₁₋α/₂ mit n − 1 Freiheitsgraden.
Für einen Mittelwert mit angenommener Standardabweichung σ beträgt die Fehlermarge bei n Beobachtungen E = t·σ/√n. Da t von n abhängt, ist der Stichprobenumfang für eine Zielmarge E das kleinste n, dessen Marge höchstens E beträgt: Das Werkzeug beginnt mit der Lösung für die Normalverteilung (z·σ/E)², aufgerundet, und erhöht n schrittweise um eins. Für einen Anteil mit Planungswert p beträgt die Marge E = z·√(p(1 − p)/n), also n = z²·p(1 − p)/E², aufgerundet auf die nächste ganze Zahl. In beiden Fällen wird die Marge beim ausgegebenen n als tatsächliche Fehlermarge angezeigt; sie ist höchstens so groß wie die Zielmarge.
Die Marge sinkt mit der Quadratwurzel von n: Eine Halbierung der Marge erfordert etwa viermal so viele Beobachtungen. Für einen Mittelwert setzt die Marge voraus, dass die Stichprobenstandardabweichung nahe am Planungswert liegt; streuen die Daten stärker, wird das Intervall breiter. Für einen Anteil ergibt ein Planungswert von 0.5 den größten (sichersten) Stichprobenumfang; verwenden Sie einen kleineren Wert nur, wenn Sie sicher sind, dass der Anteil weit von 0.5 entfernt liegt. Das Ergebnis setzt eine Zufallsstichprobe aus einem stabilen Prozess voraus.
Eingabefelder und Optionen
Feld | Beschreibung |
Parameter to estimate | Mean (Standard) oder Proportion. |
Sample sizes | Durch Leerzeichen oder Komma getrennt, z. B. „10 20 30“. Leer lassen, um den Stichprobenumfang zu berechnen. |
Margins of error | Durch Leerzeichen oder Komma getrennt, z. B. „1 2“. Die halbe Breite des Konfidenzintervalls, bei einem Mittelwert in Messeinheiten, bei einem Anteil als Bruchteil (z. B. 0.03). Leer lassen, um die Fehlermarge zu berechnen. |
Assumed standard deviation | Erforderlich bei Parameter = Mean. Historischer Schätzwert oder Schätzwert aus einer Vorstudie für die Standardabweichung, als Planungswert verwendet (die Marge verwendet die t-Verteilung). |
Planning value for the proportion | Erforderlich bei Parameter = Proportion; Standard 0.5, zwischen 0.0001 und 0.9999. 0.5 ist die konservativste Wahl (größter Stichprobenumfang). |
Confidence level | Standard 95; 75 bis 100. |
Title | In der Ausgabe angezeigter Titel. |
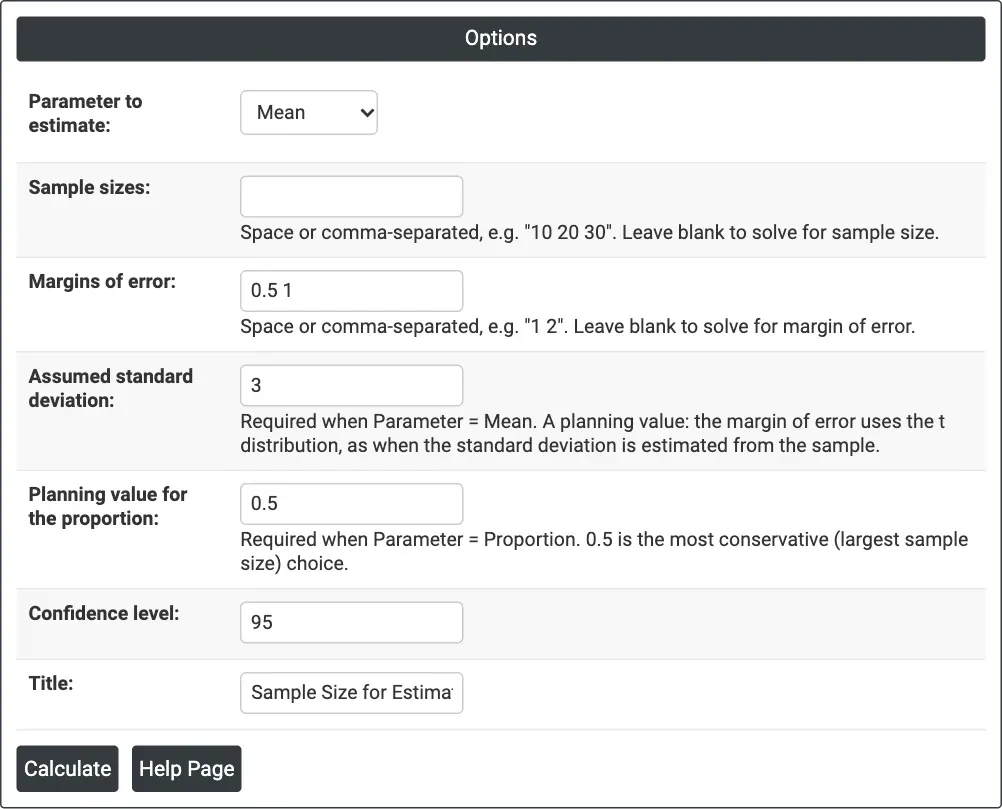
Abbildung 1 – Berechnung des Stichprobenumfangs für einen Mittelwert: Margins of error = 0.5 1, Assumed standard deviation = 3, bei 95% Konfidenz.
Beschreibung der Ausgabe
- Settings – was berechnet wurde, der Parameter, das Konfidenzniveau und die angenommene Standardabweichung (bei einem Mittelwert) bzw. der Planungswert (bei einem Anteil).
- Results – eine Zeile je Wert: Fehlermarge, Stichprobenumfang und tatsächliche Fehlermarge bei Berechnung des Stichprobenumfangs bzw. Stichprobenumfang und Fehlermarge bei Berechnung der Fehlermarge.
- PDF-Export über Download.
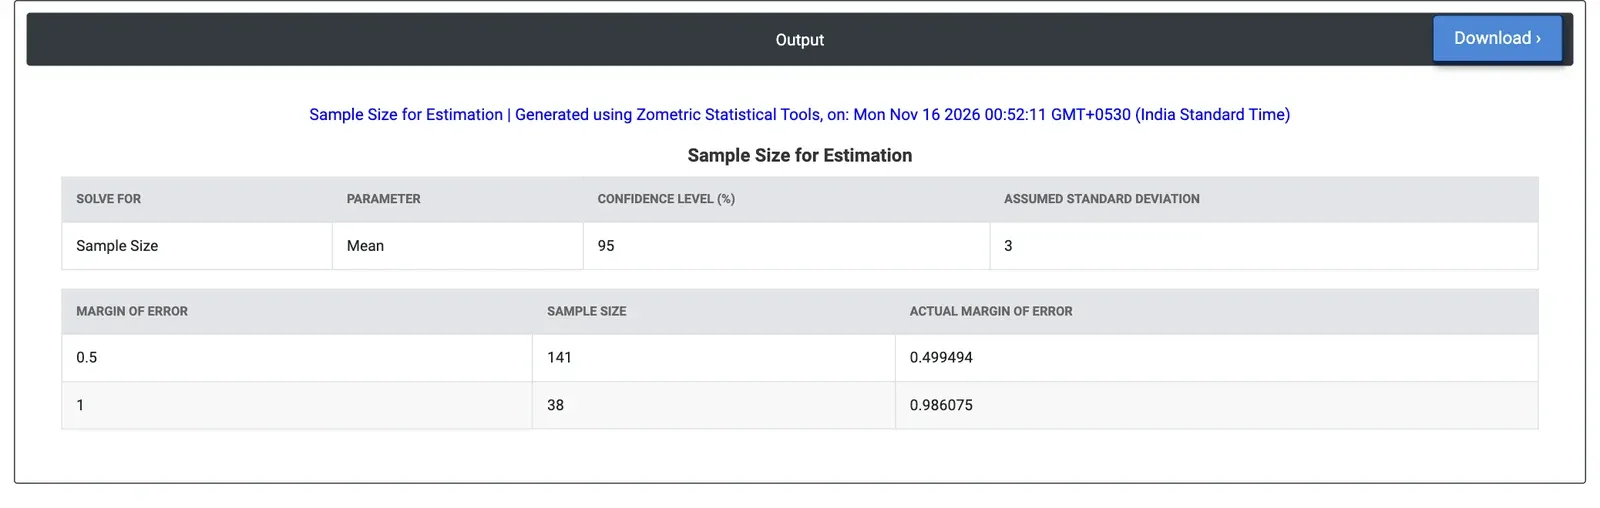
Abbildung 2 – Ergebnisse für das Beispiel: 141 Zyklen für eine Marge von ±0.5 s und 38 Zyklen für eine Marge von ±1 s bei 95% Konfidenz.
Beispiel
Eine Arbeitsvorbereiterin benötigt für eine Austaktungsstudie die mittlere Zykluszeit eines manuellen Montageplatzes. Eine kurze Vorstudie zeigt eine Standardabweichung von etwa 3 Sekunden. Sie möchte den Mittelwert auf ±0.5 s genau kennen, könnte aber ±1 s akzeptieren. Mit Parameter to estimate = Mean lässt sie Sample sizes leer, gibt Margins of error = 0.5 1 und Assumed standard deviation = 3 ein, bei 95% Konfidenz.
Das Werkzeug benötigt 141 gemessene Zyklen für eine Marge von ±0.5 s (tatsächliche Marge 0.499 s) und 38 Zyklen für ±1 s (tatsächliche Marge 0.986 s): Eine Halbierung der Marge vervielfacht den Aufwand etwa um den Faktor vier. Gibt man stattdessen Sample sizes = 20 50 ein, zeigt sich, dass 20 Zyklen eine Marge von ±1.40 s und 50 eine von ±0.85 s ergeben. Bei 99% Konfidenz steigen die Anforderungen auf 243 und 64 Zyklen. Für einen Anteil, zum Beispiel den Anteil der Zyklen mit Nacharbeitsschritt, erfordert eine Marge von ±0.03 mit dem konservativen Planungswert 0.5 1068 Beobachtungen, aber nur 385, wenn der Anteil bekanntermaßen bei etwa 0.1 liegt.
Häufig gestellte Fragen
Wie berechnet man den Stichprobenumfang zur Schätzung eines Anteils?
Für einen Anteil mit Planungswert p beträgt die Fehlermarge E = z mal die Quadratwurzel aus p(1 - p)/n, also n = z zum Quadrat mal p(1 - p) geteilt durch E zum Quadrat, aufgerundet. Ein Planungswert von 0.5 ergibt den größten, sichersten Stichprobenumfang; in einem Beispiel erfordert eine Marge von 0.03 bei 95% Konfidenz 1068 Beobachtungen mit 0.5, aber 385 mit 0.1.
Wie berechnet man den Stichprobenumfang zur Schätzung eines Mittelwerts?
Für einen Mittelwert mit angenommener Standardabweichung Sigma beträgt die Fehlermarge bei n Beobachtungen E = t mal Sigma geteilt durch die Quadratwurzel von n. Da t von n abhängt, beginnt das Werkzeug mit der Lösung für die Normalverteilung (z mal Sigma / E) zum Quadrat und erhöht n, bis die Marge höchstens die Zielmarge beträgt. Die tatsächliche Marge bei diesem n wird ausgegeben.
Wie ändert sich die Fehlermarge mit dem Stichprobenumfang?
Die Fehlermarge sinkt mit der Quadratwurzel von n; eine Halbierung der Marge erfordert also etwa viermal so viele Beobachtungen. In einem Beispiel mit einer Standardabweichung von 3 Sekunden bei 95% Konfidenz erfordert eine Marge von 1 Sekunde 38 Zyklen, eine Marge von 0.5 Sekunden dagegen 141 Zyklen.
Wann sollte man den Stichprobenumfang für die Schätzung statt Trennschärfe und Stichprobenumfang verwenden?
Verwenden Sie den Stichprobenumfang für die Schätzung, wenn das Ziel ist, etwas gut zu messen, etwa eine mittlere Zykluszeit, ein mittleres Beschichtungsgewicht oder den Anteil verspäteter Aufträge. Ist das Ziel, einen Unterschied zu testen, verwenden Sie stattdessen die Werkzeuge für Trennschärfe und Stichprobenumfang bei Hypothesentests. Das Ergebnis setzt eine Zufallsstichprobe aus einem stabilen Prozess voraus.