
Einfache exponentielle Glättung
Die einfache exponentielle Glättung (Single Exponential Smoothing) glättet eine Zeitreihe mit St = alpha·yt + (1 - alpha)·St-1 und prognostiziert für jede künftige Periode das letzte geglättete Niveau. Verwenden Sie sie für Reihen, die ohne Trend oder Saison um einen gleichbleibenden Wert schwanken. Die Reihe darf keine Lücken haben und muss mindestens 4 Werte enthalten. Die Ausgabe umfasst angepasste Werte, Prognosen mit Prognosegrenzen sowie MAPE, MAD und MSD.
Zuletzt geprüft
Kernaussage
Die einfache exponentielle Glättung glättet eine Zeitreihe mit einem Niveau, das je Periode um einen Anteil (Alpha) des letzten Fehlers angepasst wird, und prognostiziert es für künftige Perioden; für Reihen ohne Trend oder Saison.
Auf dieser Seite
Zweck
Die einfache exponentielle Glättung (Single Exponential Smoothing) glättet eine Zeitreihe mit einem laufenden Niveau, das in jeder Periode um einen Anteil des letzten Fehlers angepasst wird, und prognostiziert dieses Niveau für jede künftige Periode. Sie eignet sich für eine Reihe, die ohne klaren Trend oder Saison um einen recht gleichbleibenden Wert schwankt, etwa der wöchentliche Bedarf an einem etablierten Ersatzteil, eine tägliche Ausschussquote oder das Füllgewicht einer stabilen Linie. Für Daten mit Trend verwenden Sie die doppelte exponentielle Glättung, für Daten mit Saison die Winters-Methode oder die Zerlegung (Decomposition).
Wichtigste Funktionen
- Glättungsgewicht (Alpha), das Sie vorgeben, oder bei leerem Feld das optimale Gewicht aus einer ARIMA(0,1,1)-Anpassung.
- Startwert aus den Daten oder von Ihnen eingegeben.
- Prognosen mit Prognosegrenzen zum gewählten Konfidenzniveau, ab dem Ende der Reihe oder ab einer früheren Zeile, um die Methode an bekannten Daten zu testen.
- Genauigkeitsmaße MAPE, MAD und MSD sowie ein Diagramm der Daten, angepassten Werte und Prognosen.
- Optionale Ergebnistabelle (geglätteter Wert, Vorhersage und Fehler für jede Periode) und Vier-in-einem-Residuendiagramme.
Statistische Methoden
Der geglättete Wert ist Sₜ = α·yₜ + (1 − α)·Sₜ₋₁. Der angepasste Wert (Ein-Schritt-Vorhersage) für Periode t ist Sₜ₋₁, der geglättete Wert am Ende der vorherigen Periode, und der Fehler ist yₜ minus diesem angepassten Wert. Ein kleines α (z. B. 0.1–0.3) ergibt eine glatte Linie, die langsam reagiert; ein großes α folgt den jüngsten Werten eng.
Bei vorgegebenem Gewicht ist der Startwert S₀ der Mittelwert der ersten K Beobachtungen (standardmäßig K = 6). Bleibt das Gewicht leer, passt das Werkzeug ein ARIMA(0,1,1)-Modell nach der Methode der kleinsten Quadrate an die ersten Differenzen an und setzt α = 1 − θ, wobei θ der MA-Koeffizient ist; der Startwert ergibt sich dann aus dieser Anpassung. Dieses optimale α kann größer als 1 ausfallen, was bedeutet, dass das Niveau auf jeden neuen Wert überreagiert; werten Sie das als Hinweis darauf, dass die Reihe einen Trend hat. Mit Starting values = User-specified wird das eingegebene Initial level als S₀ verwendet.
Alle Prognosen sind gleich dem letzten geglätteten Wert am Prognoseursprung. Die Prognosegrenzen sind Prognose ± z × 1.25 × MAD, wobei z das Quantil der Normalverteilung zum Konfidenzniveau und MAD der mittlere absolute Fehler der angepassten Werte ist; sie haben für jede künftige Periode dieselbe Breite. Genauigkeit: MAPE = Mittelwert |Fehler / Daten| × 100, MAD = Mittelwert |Fehler|, MSD = Mittelwert Fehler². Die Reihe darf keine Lücken haben und muss mindestens 4 Werte enthalten.
Eingabefelder und Optionen
Feld | Beschreibung |
Variable (Y) | Pflichtfeld. Die numerische Reihe in zeitlicher Reihenfolge. |
Weight to use in smoothing (alpha) | 0.0001 bis 1. Leer lassen, um das optimale ARIMA(0,1,1)-Gewicht zu verwenden. |
Starting values | From the data (Standard): Das optimale Gewicht startet aus der ARIMA-Anpassung, ein vorgegebenes Gewicht aus dem Mittelwert der ersten K Beobachtungen. Oder User-specified. |
Initial level | Wird verwendet, wenn Starting values auf User-specified steht (dann Pflichtfeld). |
Initial smoothed value: average of first K observations, K = | Standard 6. Aktiv, wenn ein Gewicht eingegeben ist. |
Number of forecasts | Standard 0 (keine), bis zu 1000. |
Confidence level (%) for forecast interval | Standard 95. Aktiv, wenn Prognosen angefordert werden. |
Forecast origin (row) | Optional, aktiv, wenn Prognosen angefordert werden. Die Prognosen beginnen nach dieser Zeile und nutzen die Daten bis dorthin; leer = Ende der Reihe. |
Results to display | Summary table (Standard) oder Summary table and results table. |
Residual plots (four in one) | Standardmäßig deaktiviert. Normalverteilungs-Wahrscheinlichkeitsnetz, Residuen gegen angepasste Werte, Histogramm und Residuen gegen Reihenfolge. |
Title | Titel der Ausgabe. Standard Single Exponential Smoothing. |
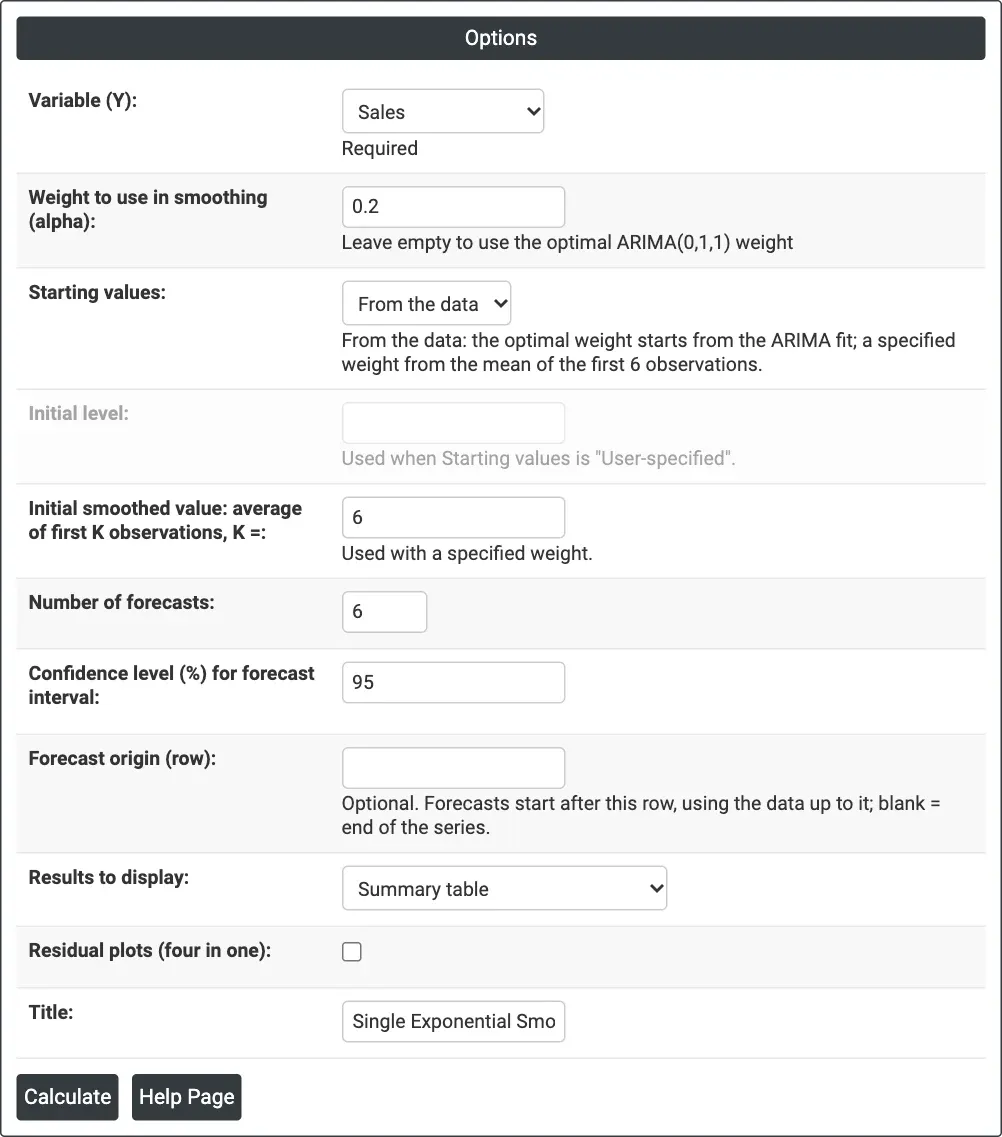
Abbildung 1: Monatlicher Absatz, geglättet mit alpha = 0.2, und sechs Prognosen.
Beschreibung der Ausgabe
- Single Exponential Smoothing (Grafik): tatsächliche Daten, angepasste Werte, Prognosen und das Prognoseband, mit MAPE, MAD und MSD im Titel und dem verwendeten Gewicht über dem Diagramm.
- Method: Datenspalte, Länge und ob das Gewicht vorgegeben oder optimal war (sowie der Prognoseursprung, falls gesetzt).
- Smoothing Constants: der verwendete Wert von α.
- Accuracy Measures: MAPE, MAD und MSD.
- Forecasts: Periode, Prognose, untere und obere Grenze.
- Results: sofern gewählt: Period, Daten, Smooth, Predict und Error für jede Periode.
- Residual Plots: sofern aktiviert.
- PDF-Export über Download.
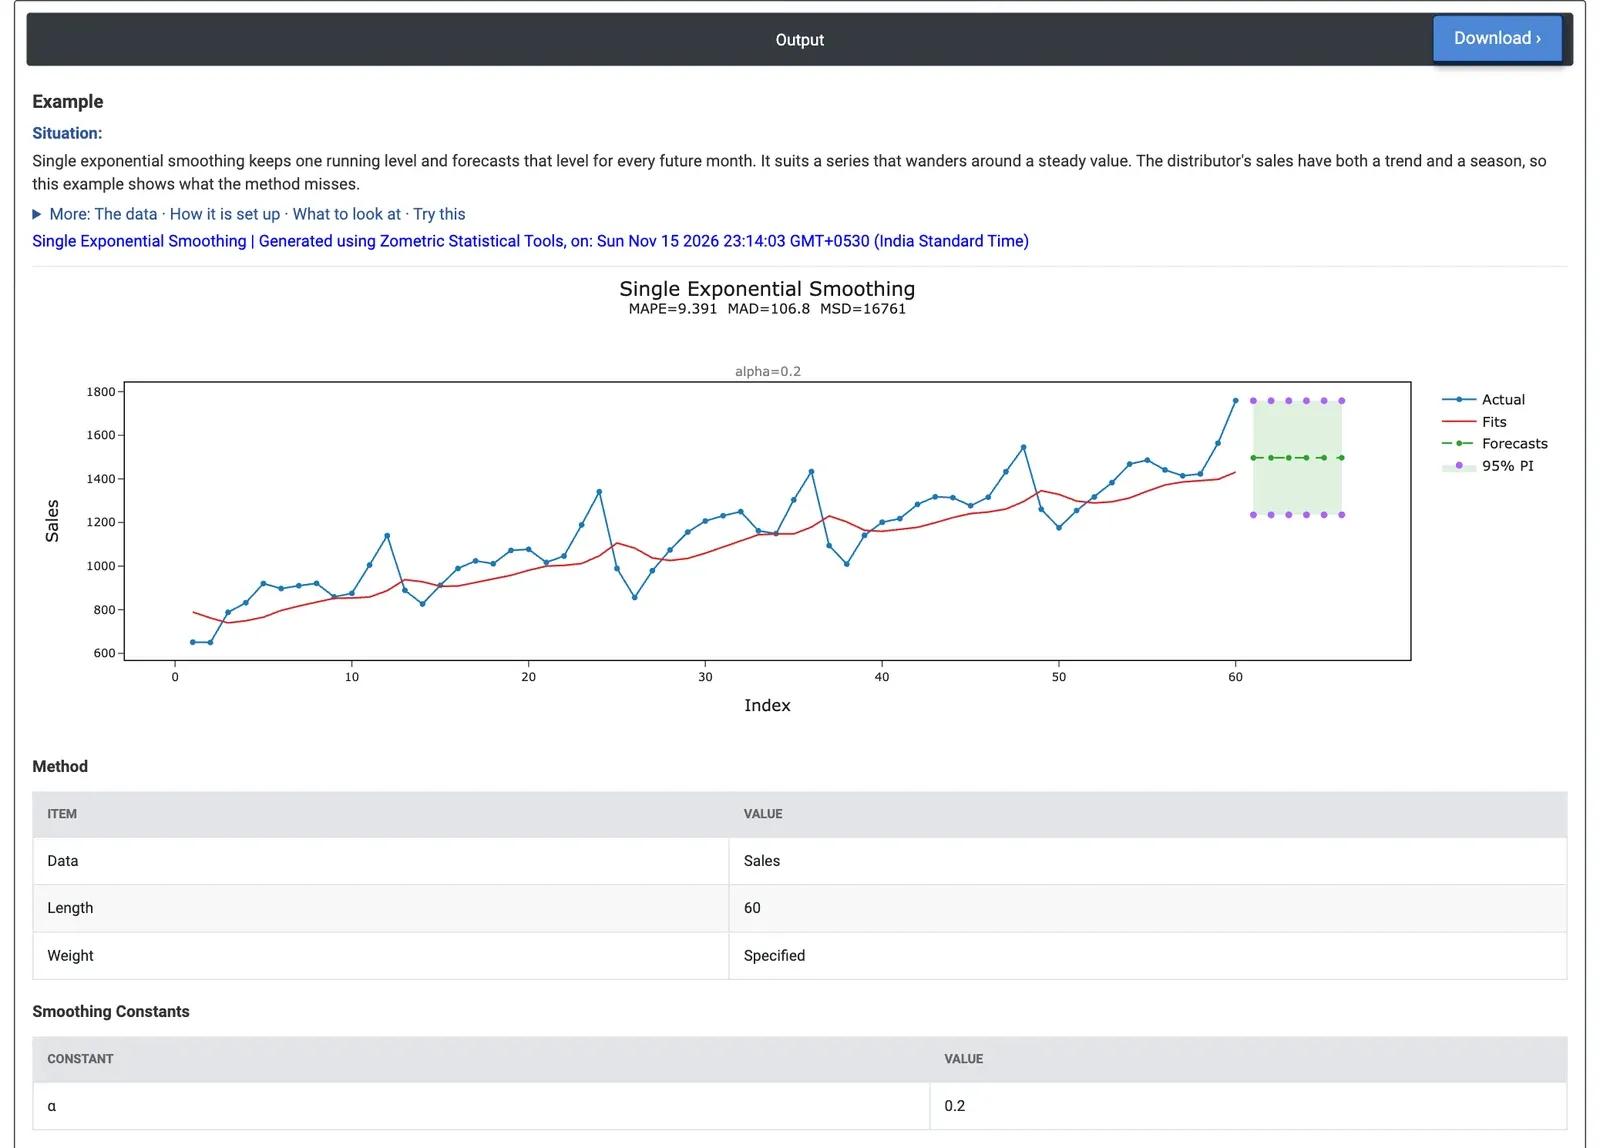
Abbildung 2: Die geglättete Linie hinkt dem wachsenden Absatz hinterher, und alle sechs Prognosen sind gleich, 1,496.7.
Beispiel
Ein Distributor für Unterhaltungselektronik hat die Absatzmengen von 60 Monaten (Januar 2020 bis Dezember 2024). Der Vertriebsanalyst probiert zuerst die einfachste Prognosemethode aus, um zu sehen, was ihr entgeht. Er wählt Variable (Y) = Sales, gibt Weight to use in smoothing (alpha) = 0.2 ein, behält Starting values = From the data und K = 6 bei und setzt Number of forecasts = 6 für Januar bis Juni 2025.
Alle sechs Prognosen sind gleich: 1,496.7 Einheiten, mit einem 95-%-Intervall von 1,234.9 bis 1,758.4. Die Methode kennt weder Trend noch Saison und kann daher nicht erkennen, dass der Absatz wächst und Januar und Februar stets schwach sind. Im Diagramm hinkt die geglättete Linie den steigenden Daten hinterher und schneidet durch Spitzen und Täler. MAPE beträgt 9.4% (MAD 106.8 Einheiten), die schwächste Anpassung der Prognosewerkzeuge an diese Daten: Die Winters-Methode erreicht 4.2% und die Zerlegung 2.2%.
Bleibt Alpha leer, beträgt das optimale ARIMA-Gewicht 1.43, also mehr als 1: Das Niveau überreagiert auf jeden Monat, um mit dem Wachstum Schritt zu halten. MAPE sinkt auf 6.7%, doch dann wird jeder Monat 2025 mit 1,817 prognostiziert, dem Niveau nach der Dezemberspitze. Beide Ergebnisse besagen für die Entscheidung dasselbe: Diese Reihe braucht eine Methode mit Trend und Saison. Die einfache Glättung ist nur dann das richtige Werkzeug, wenn die Daten weder das eine noch das andere aufweisen.
Häufig gestellte Fragen
Wann sollte man die einfache exponentielle Glättung verwenden?
Verwenden Sie die einfache exponentielle Glättung für eine Reihe, die ohne klaren Trend oder Saison um einen recht gleichbleibenden Wert schwankt, etwa den wöchentlichen Bedarf an einem etablierten Ersatzteil, eine tägliche Ausschussquote oder das Füllgewicht einer stabilen Linie. Für Daten mit Trend verwenden Sie die doppelte exponentielle Glättung, für Daten mit Saison die Winters-Methode oder die Zerlegung.
Wie wählt man das Glättungsgewicht Alpha?
Ein kleines Alpha, etwa 0.1 bis 0.3, ergibt eine glatte Linie, die langsam reagiert, während ein großes Alpha den jüngsten Werten eng folgt. Bleibt Alpha leer, stammt das optimale Gewicht aus einer ARIMA(0,1,1)-Anpassung, mit Alpha = 1 minus dem MA-Koeffizienten. Ein optimales Alpha über 1 ist ein Hinweis darauf, dass die Reihe einen Trend hat.
Warum sind alle Prognosen der einfachen exponentiellen Glättung gleich?
Alle Prognosen sind gleich dem letzten geglätteten Wert am Prognoseursprung, weil die Methode nur ein Niveau und keine Trend- oder Saisonkomponente hat. Die Prognosegrenzen sind die Prognose plus oder minus z mal 1.25 mal MAD und haben daher ebenfalls für jede künftige Periode dieselbe Breite.
Wie wird die Prognosegenauigkeit gemessen?
Die Genauigkeit wird mit drei Maßen angegeben, die auf den Fehlern zwischen den Daten und den Ein-Schritt-Vorhersagen beruhen: MAPE, der mittlere absolute prozentuale Fehler; MAD, der mittlere absolute Fehler; und MSD, die mittlere quadratische Abweichung. Niedrigere Werte zeigen eine bessere Anpassung an, und mit ihnen lassen sich Prognosemethoden an denselben Daten vergleichen.