
Häufigkeitstabelle einzelner Variablen (Tally Individual Variables)
Tally Individual Variables erstellt für jede ausgewählte Spalte eine Häufigkeitstabelle, für kategoriale Daten wie Fehlerarten, Schichten oder Lieferanten oder für diskrete Zählwerte. Ausgegeben werden Anzahlen, Prozentsätze, kumulierte Anzahlen und kumulierte Prozentsätze in beliebiger Kombination, ohne leere Zellen. Die Zeilen sind nach Wert sortiert, nicht nach Häufigkeit, und jede Spalte wird unabhängig ausgezählt.
Zuletzt geprüft
Kernaussage
Tally Individual Variables zählt, wie oft jeder einzelne Wert in einer oder mehreren Spalten vorkommt, und zeigt je Spalte eine Häufigkeitstabelle mit Anzahlen, Prozentsätzen und kumulierten Anzahlen oder Prozentsätzen.
Auf dieser Seite
Zweck
Tally Individual Variables (Häufigkeitstabelle einzelner Variablen) zählt, wie oft jeder einzelne Wert in einer oder mehreren Spalten vorkommt, und zeigt das Ergebnis als Häufigkeitstabelle je Spalte. Verwenden Sie es für kategoriale Daten wie Fehlerarten, Schichten, Linien, Lieferanten oder Gut/Schlecht-Ergebnisse sowie für diskrete Zählwerte, um zu sehen, welche Kategorien am häufigsten sind und welchen Anteil jede hat, bevor Sie ein Pareto-Diagramm zeichnen oder zwei Variablen kreuztabellieren.
Wichtigste Funktionen
- Eine Tabelle je ausgewählter Spalte; jede Spalte wird für sich ausgezählt.
- Anzahlen, Prozentsätze, kumulierte Anzahlen und kumulierte Prozentsätze in beliebiger Kombination.
- Funktioniert mit Textkategorien und mit Zahlen (jeder einzelne Wert ist eine Kategorie).
- Leere Zellen werden bei der Zählung nicht berücksichtigt.
Statistische Methoden
Für jede ausgewählte Spalte werden die nicht leeren Werte nach ihrem jeweiligen Wert gruppiert, und die Anzahl der Zeilen mit jedem Wert ist dessen Anzahl nⱼ. Die Summe N = Σnⱼ ist die Anzahl der nicht leeren Zellen in dieser Spalte; verschiedene Spalten können daher unterschiedliche Summen haben. Die Zeilen der Tabelle sind nach Wert sortiert: alphabetisch bei Text, aufsteigend bei Zahlen.
Prozent = 100 × nⱼ / N, gerundet auf zwei Dezimalstellen. Die kumulierte Anzahl ist die laufende Summe der Anzahlen in der Tabelle von oben nach unten, und der kumulierte Prozentsatz ist 100 × (laufende Summe) / N; er erreicht in der letzten Zeile 100. Da die Zeilen nach Wert und nicht nach Häufigkeit geordnet sind, sind die kumulierten Spalten vor allem bei geordneten Werten nützlich (zum Beispiel einer Anzahl von Fehlern je Einheit oder Bewertungen von 1 bis 5): Sie geben dann den Anteil bis einschließlich jedes Werts an. Um Kategorien nach Häufigkeit zu ordnen und den Anteil der häufigsten abzulesen, verwenden Sie das Pareto Chart.
Jede Spalte wird unabhängig ausgezählt; die Tabellen zeigen daher nicht, wie die Variablen zusammenhängen (zum Beispiel welche Linie welchen Fehler verursacht). Dafür verwenden Sie Cross Tabulation and Chi-Square.
Eingabefelder & Optionen
Feld | Beschreibung |
Variables | Pflichtfeld. Eine oder mehrere Spalten (Ctrl oder Cmd, um mehrere auszuwählen). Für jede wird eine eigene Tabelle erzeugt. |
Counts | Standardmäßig aktiviert. Anzahl der Zeilen mit jedem Wert. |
Percents | Standardmäßig deaktiviert. Anteil jedes Werts an den nicht leeren Zeilen der Spalte. |
Cumulative counts | Standardmäßig deaktiviert. Laufende Summe der Anzahlen in der Reihenfolge der Tabelle. |
Cumulative percents | Standardmäßig deaktiviert. Laufende Summe als Prozentsatz in der Reihenfolge der Tabelle. Mindestens eine der vier Statistiken muss aktiviert sein. |
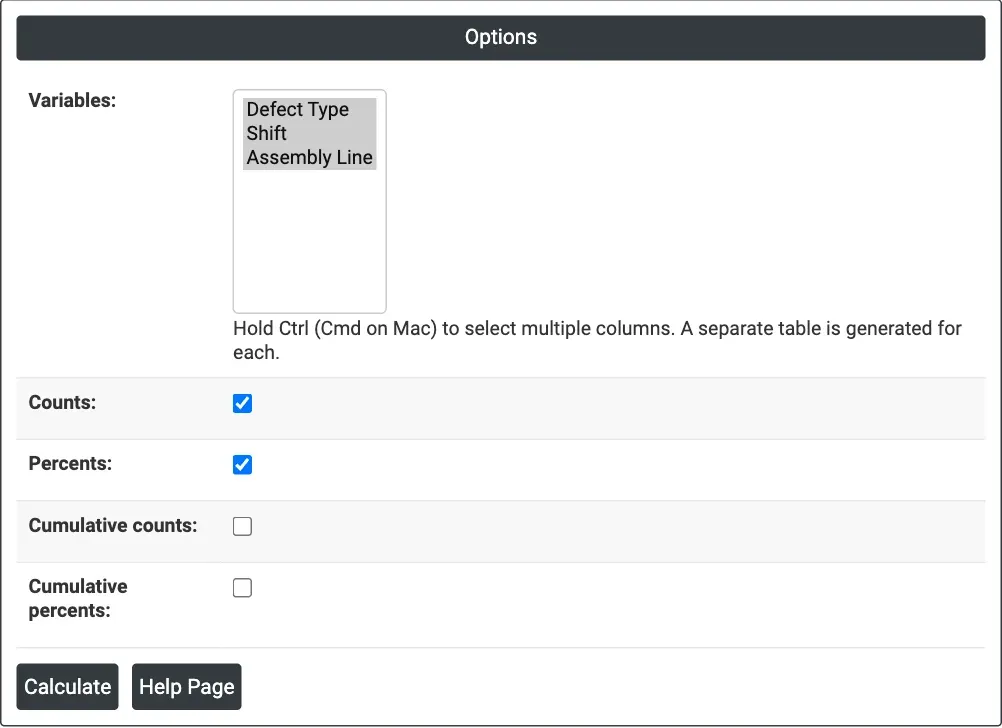
Abbildung 1 – Optionen für das Beispiel: Defect Type, Shift und Assembly Line, mit Counts und Percents.
Beschreibung der Ausgabe
- Tally for <column> – eine Tabelle je ausgewählter Spalte mit den einzelnen Werten und den gewählten Spalten: Count, Percent, CumCount und CumPercent.
- PDF-Export über Download.
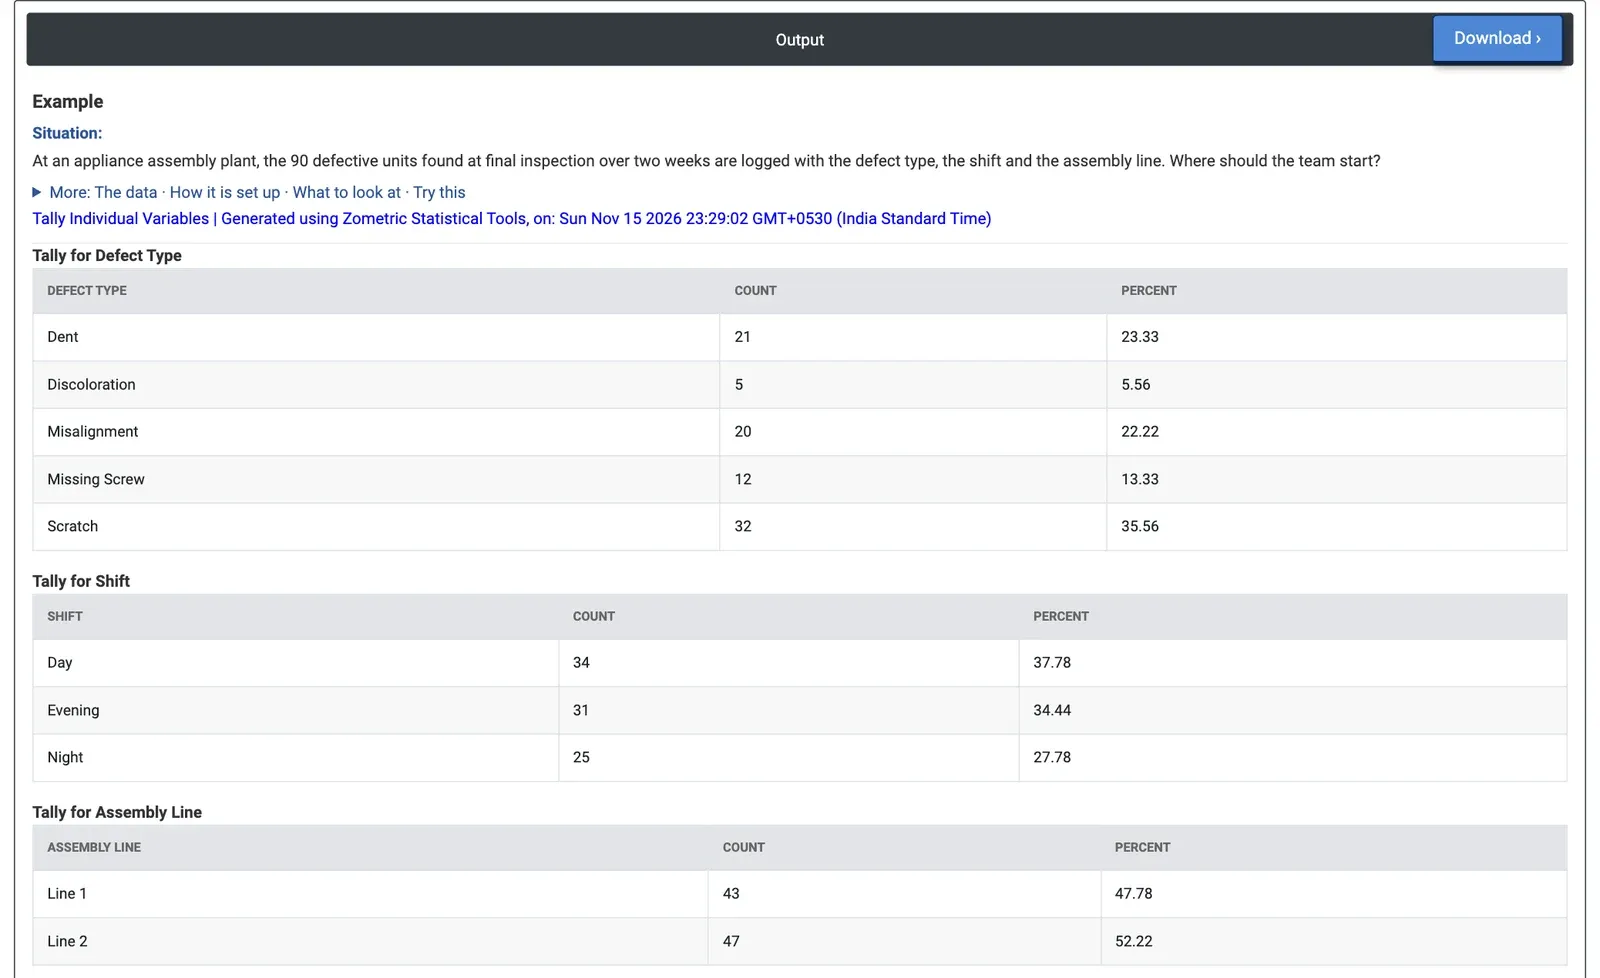
Abbildung 2 – Anzahlen und Prozentsätze von 90 fehlerhaften Einheiten nach Fehlerart, Schicht und Montagelinie.
Beispiel
In einem Montagewerk für Haushaltsgeräte werden die 90 fehlerhaften Einheiten, die über zwei Wochen bei der Endprüfung gefunden wurden, mit Fehlerart, Schicht und Montagelinie erfasst. Das Qualitätsteam möchte eine schnelle Zusammenfassung, um zu entscheiden, wo es ansetzen soll. Variables = Defect Type, Shift und Assembly Line, mit aktivierten Counts und Percents.
Scratch (Kratzer) ist der häufigste Fehler (32 Einheiten, 35.56%), gefolgt von Dent (Delle; 21, 23.33%) und Misalignment (Fehlausrichtung; 20, 22.22%); zusammen machen diese drei 73 der 90 Fehler aus, etwa 81%. Missing Screw (12) und Discoloration (5) sind seltener. Nach Schicht verteilen sich die Fehler recht gleichmäßig: Day 34, Evening 31 und Night 25. Nach Linie sind sie etwa gleich: Line 1 hat 43 und Line 2 47.
Das Team sollte mit den Kratzern beginnen, dann die Dellen und die Fehlausrichtung angehen. Da weder Schicht noch Linie für sich auffällt, ist der nächste Schritt, die Kombinationen zu betrachten: Eine Kreuztabelle von Defect Type nach Assembly Line zeigt, dass Line 2 21 der 32 Kratzer verursacht, während Line 1 14 der 20 Fehlausrichtungen verursacht; die beiden Linien haben also unterschiedliche Probleme, obwohl ihre Summen ähnlich sind. Würde man hier Cumulative percents aktivieren, käme eine laufende Summe in alphabetischer Reihenfolge hinzu (Dent, Discoloration, Misalignment usw.), die keine Rangfolge darstellt; ein Pareto Chart von Defect Type liefert die geordnete Ansicht.
Häufig gestellte Fragen
Was leistet Tally Individual Variables?
Es zählt, wie oft jeder einzelne Wert in einer oder mehreren Spalten vorkommt, und liefert für jede Spalte eine eigene Häufigkeitstabelle. Es funktioniert mit Textkategorien und Zahlen, lässt leere Zellen unberücksichtigt und kann Anzahlen, Prozentsätze, kumulierte Anzahlen und kumulierte Prozentsätze anzeigen. Der Prozentsatz ist der Anteil jedes Werts an den nicht leeren Zeilen der Spalte.
Wann sollten Sie statt einer Häufigkeitstabelle ein Pareto-Diagramm verwenden?
Die Häufigkeitstabelle sortiert die Zeilen nach Wert, alphabetisch bei Text oder aufsteigend bei Zahlen, nicht nach Häufigkeit. Um Kategorien nach Häufigkeit zu ordnen und den Anteil der häufigsten abzulesen, verwenden Sie ein Pareto-Diagramm. Kumulierte Prozentsätze in einer Häufigkeitstabelle sind vor allem bei geordneten Werten nützlich, etwa Bewertungen oder Fehlern je Einheit.
Kann eine Häufigkeitstabelle zeigen, wie zwei Variablen zusammenhängen?
Nein. Jede Spalte wird unabhängig ausgezählt; die Tabellen zeigen daher nicht, wie die Variablen zusammenhängen, etwa welche Linie welchen Fehler verursacht. Dafür verwenden Sie Cross Tabulation and Chi-Square, das die Kombinationen zweier Variablen auszählt.