
Toleranzintervall (nicht normalverteilte Daten)
Tolerance Interval (Nonnormal Distribution) gibt mit gewählter Konfidenz einen Bereich oder eine Grenze an, die mindestens einen gewählten Prozentsatz der Grundgesamtheit enthält, für schiefe Daten wie Lebensdauern oder Festigkeiten. Es passt eine von acht Verteilungen an und liefert stets auch ein verteilungsfreies nichtparametrisches Intervall mit seiner erreichten Konfidenz. Prüfen Sie die Anderson-Darling-Anpassung, bevor Sie sich auf ein Verteilungsintervall stützen. Einsatz für Spezifikations-, Garantie- oder Freigabegrenzen.
Zuletzt geprüft
Kernaussage
Ein Toleranzintervall für nicht normalverteilte Daten gibt den Bereich an, der mit angegebener Konfidenz mindestens einen angegebenen Prozentsatz der Grundgesamtheit enthält – aus einer angepassten Verteilung und nichtparametrisch.
Auf dieser Seite
Zweck
Ein Toleranzintervall gibt den Bereich an, der mit einer angegebenen Konfidenz mindestens einen angegebenen Prozentsatz aller Einheiten der Grundgesamtheit enthält, zum Beispiel: Mit 95% Konfidenz halten mindestens 95% der Glühlampen länger als 1,093 Stunden. Tolerance Interval (Nonnormal Distribution) leistet dies für Daten, die nicht normalverteilt sind, etwa Lebensdauern, Festigkeiten oder Verunreinigungsgehalte. Es passt eine gewählte Verteilung an und liefert zusätzlich ein nichtparametrisches Intervall, das überhaupt keine Verteilung benötigt, sodass Sie beide vergleichen können. Setzen Sie es ein, um anhand einer Stichprobe Spezifikationsgrenzen, Garantiezeiträume oder Freigabegrenzen festzulegen oder zu prüfen.
Wichtige Funktionen
- Acht Verteilungen: Weibull, Lognormal, Gamma, Exponential, Smallest extreme value, Largest extreme value, Logistic und Loglogistic, oder Assume none für ausschließlich das nichtparametrische Intervall.
- Nichtparametrisches (verteilungsfreies) Intervall aus den geordneten Daten, mit seiner erreichten Konfidenz, in jedem Fall angezeigt.
- Zweiseitiges Intervall, untere Grenze oder obere Grenze.
- Anderson-Darling-Anpassungstest und die angepassten Parameter, um die gewählte Verteilung zu prüfen.
- Mehrere Spalten gleichzeitig, jede mit eigenem Intervall und eigenem Histogramm mit markierten Toleranzgrenzen.
Statistische Methoden
Nichtparametrisches Verfahren: Die Grenzen sind Ordnungsstatistiken der Stichprobe. Für ein zweiseitiges Intervall verwendet das Werkzeug (x₍ᵣ₎, x₍ₙ₋ᵣ₊₁₎), wobei r der größte Wert ist, für den die erreichte Konfidenz P(Beta(n − 2r + 1, 2r) > P) noch mindestens dem Konfidenzniveau entspricht; P ist der Mindestanteil der Grundgesamtheit. Für eine einseitige Grenze verwendet es x₍ₖ₎ (unten) bzw. x₍ₙ₋ₖ₊₁₎ (oben), wobei k auf dieselbe Weise aus der Binomialverteilung gewählt wird. Da nur ganze Ordnungsstatistiken verwendet werden können, liegt die erreichte Konfidenz meist über dem geforderten Niveau; bei kleiner Stichprobe kann sie selbst mit Minimum und Maximum darunter liegen, und die Tabelle zeigt dann den niedrigeren Wert.
Verteilungsbasierte Verfahren mit Parametern aus der Maximum-Likelihood-Schätzung: Lognormal verwendet das Toleranzintervall der Normalverteilung für die logarithmierten Daten, zurücktransformiert; Gamma verwendet das Normalverteilungsintervall der Kubikwurzel der Daten (Wilson-Hilferty); Exponential verwendet exakte Chi-Quadrat-Grenzen für einseitige Grenzen und das Fernandez-Verfahren für zweiseitige; Weibull (auf der logarithmischen Skala), Smallest und Largest extreme value verwenden das exakte Verfahren nach Lawless; Logistic und Loglogistic verwenden das Verfahren nach Bain und Engelhardt für große Stichproben. Ein zweiseitiges Intervall wird aus einseitigen Grenzen bei α/2 und (1 + P)/2 gebildet. Lognormal, Gamma, Exponential, Weibull und Loglogistic erfordern positive Daten.
Ein Verteilungsintervall ist nur so gut wie die Anpassung: Prüfen Sie, dass der Anderson-Darling-p-Wert nicht klein ist (etwa über 0.05), bevor Sie sich darauf stützen. Passt keine Verteilung, verwenden Sie das nichtparametrische Intervall, das einen größeren Stichprobenumfang benötigt, um dieselbe Konfidenz zu erreichen. Die erreichte Konfidenz gilt nur für das nichtparametrische Verfahren.
Eingabefelder und Optionen
Feld | Beschreibung |
Sample data | Pflichtfeld. Eine oder mehrere numerische Spalten; jede erhält ein eigenes Intervall. |
Distribution | Weibull (Standard), Lognormal, Gamma, Exponential, Smallest extreme value, Largest extreme value, Logistic, Loglogistic oder Assume none, wobei nur das nichtparametrische Intervall angezeigt wird. |
Confidence level | Standard 95; 50 bis 99.99. |
Minimum percentage of population in interval | Standard 95; 50 bis 99.99. Der Anteil der Grundgesamtheit, den das Intervall enthalten muss. |
Tolerance Interval | Two-sided (Standard), Lower bound oder Upper bound. |
Tolerance Interval Plot | Standardmäßig aktiviert: ein Histogramm jeder Spalte mit den Toleranzgrenzen. |
Data Options: Subset (optional) | Exclude matching rows (Standard) oder Include only matching rows, nach Zeilennummern (z. B. 3,7,12-15) und/oder einer Bedingung. |
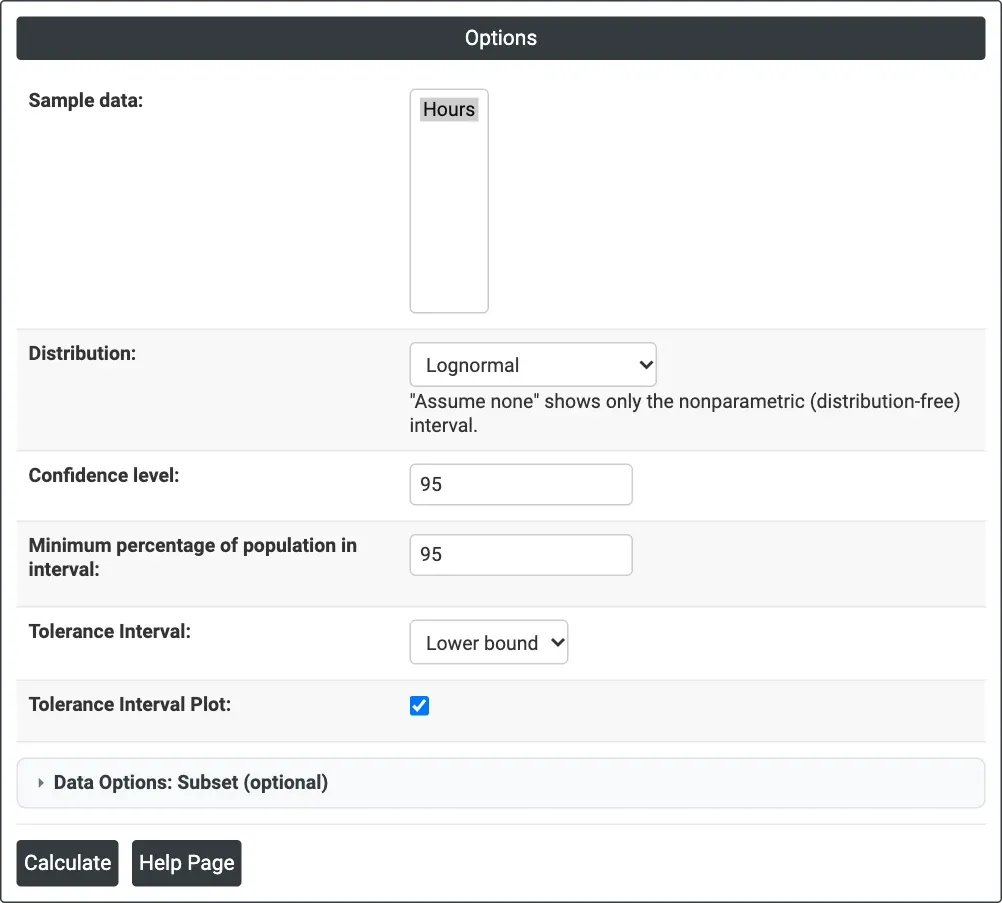
Abbildung 1 – Optionen für das Beispiel: Hours, Lognormal, 95% Konfidenz, mindestens 95% der Grundgesamtheit, untere Grenze.
Beschreibung der Ausgabe
- Settings – Verteilung, Konfidenzniveau und Prozentsatz der Grundgesamtheit im Intervall.
- Statistics – Variable, N, Mean und StDev für jede Spalte.
- Toleranztabelle – für jede Spalte das Intervall bzw. die Grenze aus dem Verfahren der gewählten Verteilung, die Nonparametric Method und ihre Achieved Confidence (bei Assume none: Lower Bound, Upper Bound und Achieved Confidence).
- Tolerance Interval for <column> – Histogramm mit den Grenzen als gestrichelte Linien (bei gewählter Verteilung die Grenzen des Verteilungsverfahrens).
- Distribution Parameters – die angepassten Parameter, z. B. Location und Scale oder Shape und Scale.
- Goodness-of-Fit Test (Anderson-Darling) – AD-Statistik und p-Wert für die gewählte Verteilung.
- PDF-Export über Download.
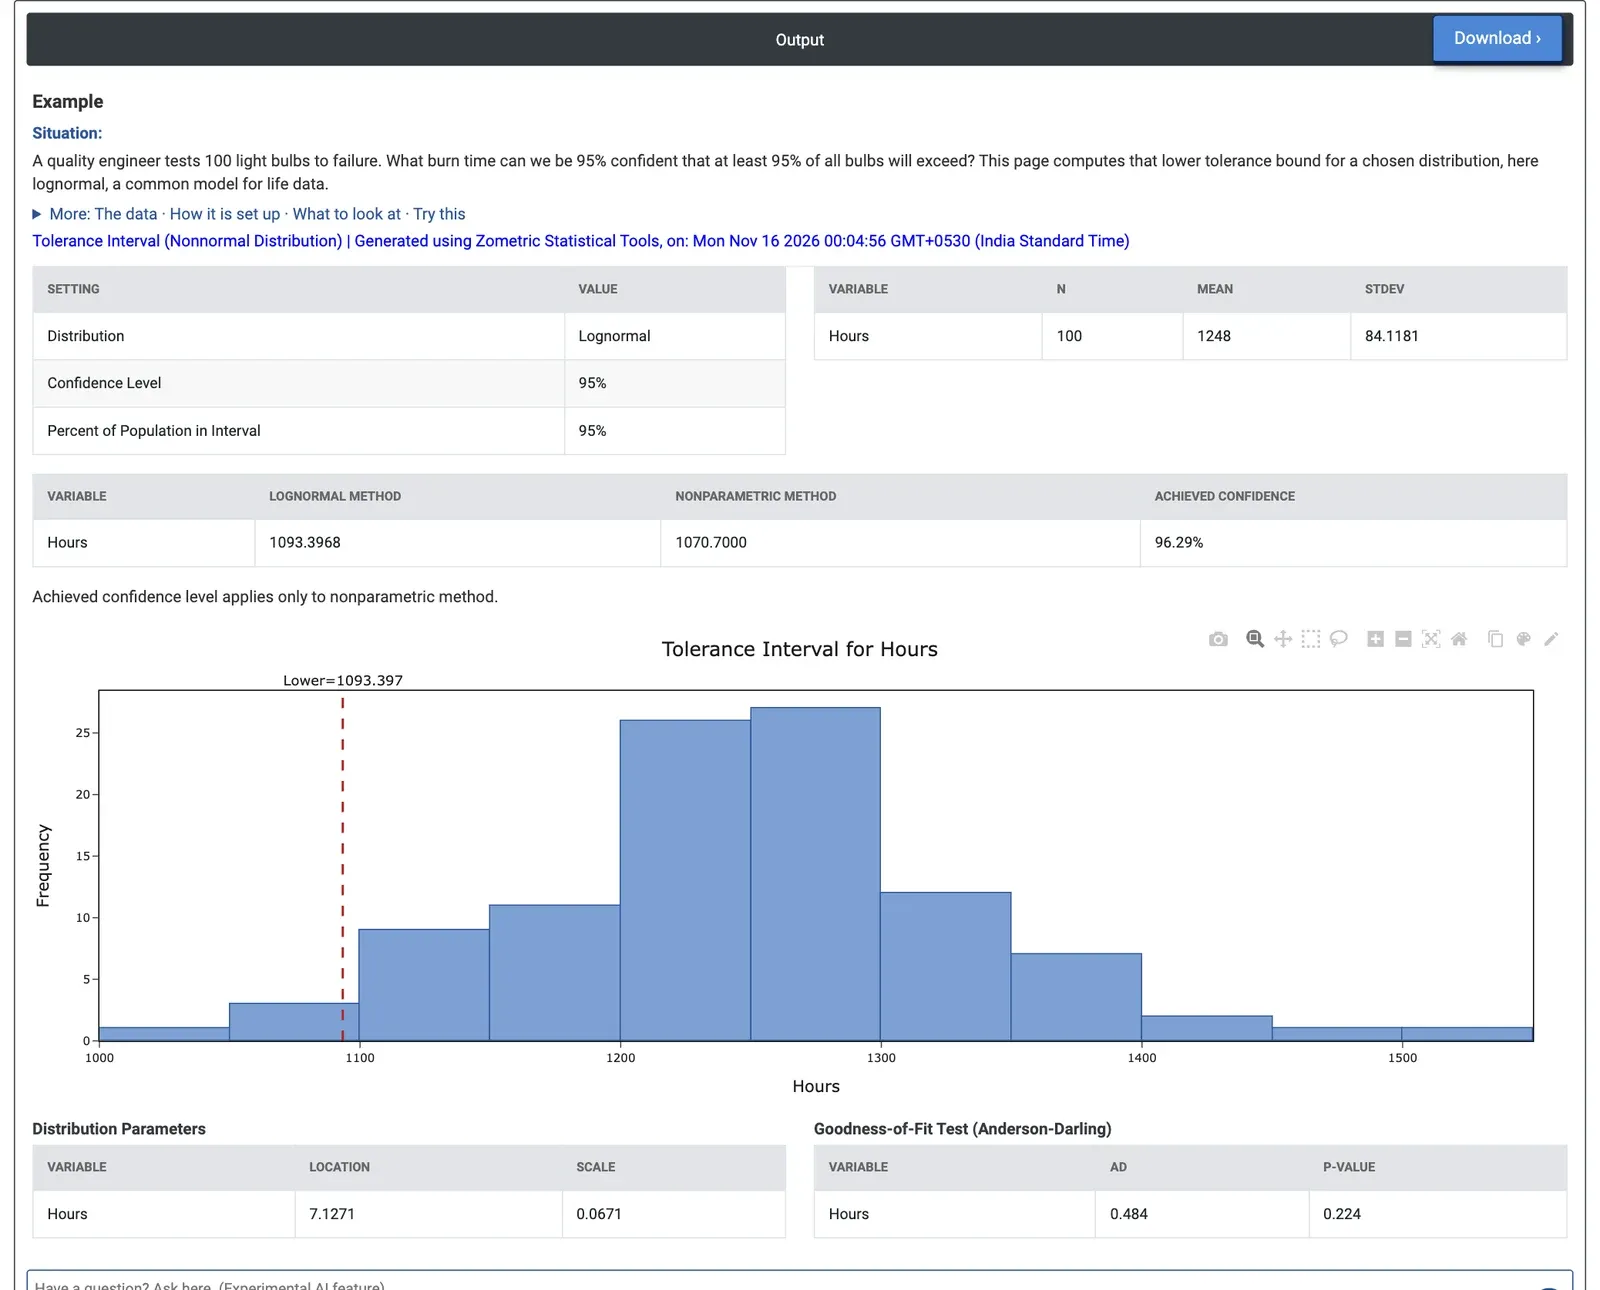
Abbildung 2 – Lognormale untere Grenze von 1,093.40 Stunden und nichtparametrische Grenze von 1,070.70 Stunden (erreichte Konfidenz 96.29%); die Lognormalverteilung passt (AD 0.484, p = 0.224).
Beispiel
Ein Qualitätsingenieur prüft 100 Glühlampen bis zum Ausfall und möchte eine Brenndauer angeben, die mit 95% Konfidenz von mindestens 95% aller Glühlampen überschritten wird. Lebensdauern sind oft schief verteilt, daher passt der Ingenieur eine Lognormalverteilung an. Sample data = Hours, Distribution = Lognormal, Confidence level = 95, Minimum percentage of population in interval = 95, Tolerance Interval = Lower bound.
Die 100 Glühlampen haben einen Mittelwert von 1,248 Stunden und eine Standardabweichung von 84.1 Stunden. Die Lognormalverteilung passt gut (Location 7.1271, Scale 0.0671; AD 0.484, p = 0.224). Die lognormale untere Grenze beträgt 1,093.40 Stunden: Mit 95% Konfidenz halten mindestens 95% der Glühlampen länger. Die nichtparametrische Grenze, die zweitkürzeste Lebensdauer in der Stichprobe, beträgt 1,070.70 Stunden bei einer erreichten Konfidenz von 96.29%. Sie ist niedriger, weil sie kein Modell verwendet, stützt aber eine Aussage derselben Größenordnung.
Die Wahl der Verteilung ist entscheidend. Eine Weibull-Verteilung passt nicht zu diesen Glühlampen (AD 1.558, p < 0.010) und ergäbe eine untere Grenze von nur 1,017.99 Stunden; eine Gammaverteilung passt (AD 0.442, p > 0.250) und ergibt 1,091.16 Stunden, nahe am lognormalen Wert. Der Ingenieur kann mit Konfidenz etwa 1,090 Stunden angeben und sollte den Weibull-Wert nicht verwenden. Für ein zweiseitiges Intervall mit der Lognormalverteilung liegen 95% der Glühlampen zwischen 1,070.95 und 1,447.79 Stunden (nichtparametrisch: 1,044.33 bis 1,510.35, die kürzeste und längste Lebensdauer).
Häufig gestellte Fragen
Was ist ein Toleranzintervall für nicht normalverteilte Daten?
Es ist ein Bereich, der mit einer angegebenen Konfidenz mindestens einen angegebenen Prozentsatz aller Einheiten der Grundgesamtheit enthält, für Daten, die nicht normalverteilt sind, etwa Lebensdauern, Festigkeiten oder Verunreinigungsgehalte. Es wird aus einer angepassten Verteilung und zusätzlich mit einem nichtparametrischen Verfahren berechnet, das keine Verteilung benötigt.
Welche Verteilungen können für ein Toleranzintervall bei nicht normalverteilten Daten verwendet werden?
Weibull, Lognormal, Gamma, Exponential, Smallest extreme value, Largest extreme value, Logistic und Loglogistic, oder Assume none für ausschließlich das nichtparametrische Intervall. Lognormal, Gamma, Exponential, Weibull und Loglogistic erfordern positive Daten. Die Wahl ist entscheidend: Eine Verteilung, die nicht passt, kann eine stark abweichende Grenze liefern.
Wann sollte man das nichtparametrische Toleranzintervall verwenden?
Verwenden Sie es, wenn keine Verteilung zu den Daten passt. Bevor Sie sich auf ein Verteilungsintervall stützen, prüfen Sie, dass der Anderson-Darling-p-Wert nicht klein ist, zum Beispiel über 0.05. Das nichtparametrische Intervall verwendet Ordnungsstatistiken der Stichprobe und benötigt einen größeren Stichprobenumfang, um dieselbe Konfidenz zu erreichen; seine erreichte Konfidenz wird in der Tabelle angezeigt.
Was ist die erreichte Konfidenz eines nichtparametrischen Toleranzintervalls?
Da die nichtparametrischen Grenzen ganze Ordnungsstatistiken der Stichprobe sein müssen, liegt die tatsächlich erreichte Konfidenz meist über dem geforderten Niveau. Bei kleiner Stichprobe kann sie selbst mit Minimum und Maximum darunter liegen, und die Tabelle zeigt dann diesen niedrigeren Wert. Die erreichte Konfidenz gilt nur für das nichtparametrische Verfahren.