
4-모수 로지스틱 생물검정의 추가 기능
이 추가 기능은 4-모수 로지스틱 방법에 ANOVA / CI error term 설정을 더합니다. Sequential(기본값)은 각 F 검정에 해당 중첩 모형의 잔차를 사용하고, Pure Error는 EP 5.3 소프트웨어처럼 세 가지 타당성 F 검정(Regression, Non-parallelism, Lack of Fit)과 역가 CI 모두에 포화 모형의 잔차를 사용합니다. Pure Error에는 어느 정도의 반복 측정이 필요합니다. 곡선 모수와 역가 추정값은 바뀌지 않습니다.
최종 검토
핵심 요점
4-모수 로지스틱 생물검정의 오차항 옵션은 타당성 F 검정과 역가 신뢰구간에 순차적 중첩 잔차를 사용할지, EP 5.3과 같이 단일 순수 오차항을 사용할지 선택합니다.
이 페이지 내용
생물검정 — 4-모수 로지스틱 방법
추가된 기능: 선택적 ANOVA / 신뢰구간 오차항("Sequential" 대 "Pure Error")
추가된 내용
4-모수 로지스틱 방법에는 평행선 방법과 기울기 비 방법에 이미 추가된 것과 같은 종류의 선택적 오차항 규칙이 추가되며, 이 방법 고유의 모형 구조에 맞게 조정되어 있습니다. 이 옵션은 (두 선형 방법처럼 신뢰구간에만 적용되는 것이 아니라) 세 가지 타당성 F 검정과 역가 신뢰구간 모두에 어떤 분산 추정값을 사용할지를 한꺼번에 제어하며, 이는 이 방법의 ANOVA가 구성된 방식을 반영한 것입니다. 적합된 곡선 모수와 역가 점추정값은 어느 쪽을 선택해도 영향을 받지 않습니다.
규제 및 통계적 배경
4-모수 로지스틱(4PL) 검정은 상한 점근선, 하한 점근선, 기울기 인자, 변곡점으로 정해지는 S자형 곡선을 각 제제의 로그 용량 대비 반응에 적합합니다. 타당성 검정을 구성하기 위해 세 가지 중첩 모형을 비교합니다. 귀무(평평한 직선) 모형, 모든 제제가 하나의 공통 곡선 형태를 공유하는 모형(변곡점만 다를 수 있으며, 이것이 역가 추정값을 만듭니다), 그리고 각 제제에 독립적으로 적합한 완전 분리 곡선입니다.
다른 생물검정 방법과 마찬가지로, 유럽 약전(Ph. Eur.) 5.3장 "Statistical Analysis of Results of Biological Assays and Tests"를 준수하는 상용 소프트웨어는 일반적으로 세 가지 타당성 F 검정과 역가 신뢰구간을 모두 하나의 공통 오차 분산항으로 구성하며, 이를 "Pure-error ANOVA" 규칙이라고 합니다. 이 도구의 기존 기본값은 대신 각 F 검정에 국소적으로 더 적절한 고유의 오차항을 부여합니다.
수학적 설명
규칙 A — "Sequential"(이 도구의 기존 기본값). 세 가지 F 검정은 각각 검정 대상이 되는 특정 중첩 모형 쌍으로 구성되며, 해당 비교의 잔차 분산을 분모로 사용합니다.
F(Regression) = MS(공통 곡선이 평평한 직선 대비 설명하는 부분) / MS(공통 곡선 적합의 잔차)
F(Non-parallelism) = MS(분리 곡선이 공통 곡선 대비 설명하는 부분) / MS(분리 곡선 적합의 잔차)
F(Lack of Fit) = MS(포화 적합이 분리 곡선 대비 설명하는 부분) / MS(포화 적합의 잔차, 즉 순수 오차)
역가 신뢰구간도 마찬가지로 공통 곡선 모형 자체의 잔차를 사용하며, 이 경우 유의하지 않은 소량의 비평행성이 함께 합쳐집니다.
규칙 B — "Pure Error"(새로운 옵션, EP 5.3의 "Pure-error ANOVA"). 세 가지 F 검정과 역가 신뢰구간 모두 대신 전체에 걸쳐 하나의 동일한 분모를 공유하며, 이는 제제/용량군마다 곡선 하나씩을 적합한 완전 포화 적합의 잔차입니다.
F(모든 검정) = MS(해당 검정의 비교가 설명하는 부분) / MS(포화 적합에서 얻은 순수 오차) — 매번 동일한 분모
근거: 두 가지 규칙이 있는 이유와 각각의 사용 시기
두 규칙은 두 선형 방법의 경우와 똑같이 약간 다른 질문에 답합니다. Sequential 규칙은 각 검정의 유의성을 해당 비교와 관련된 고유한 변동에 비추어 판단하게 하는 반면, Pure Error 규칙은 모든 검정에 "다른 것을 합치지 않은 순수 반복 잡음과 비교할 때 이 편차는 어떠한가?"라는 동일한 근본 질문을 던지고, 추가로 역가 신뢰구간도 가능한 한 가장 좁은 그 오차 추정값에 연결합니다.
잘 적합되는 타당한 검정에서는 두 규칙의 차이가 보통 작습니다. 유의하지 않은 소량의 비평행성이나 적합성 결여가 있을 때 차이가 더 두드러지는데, Sequential 규칙은 그 추가 변동을 해당 검정(및 역가 구간)의 오차항에 포함시키는 반면 Pure Error 규칙은 이를 모든 곳에서 의도적으로 제외하기 때문입니다.
다른 방법과 마찬가지로 "Pure Error" 선택은 주로 EP 5.3을 준수하는 상용 소프트웨어, 또는 Pure-error ANOVA 규칙에 기반한 기존 검증 방법과 결과를 대조하기 위한 것입니다. 이러한 외부 비교가 필요하지 않은 경우 이 도구의 기존 Sequential 기본값도 완전히 타당한 선택입니다.
출력에서 달라지는 것과 달라지지 않는 것
영향을 받는 항목:
- 세 가지 타당성 검정(Regression, Non-parallelism, Lack of Fit) 모두의 F-값과 P-값
- 어느 규칙과 자유도가 사용되었는지 나타내는 ANOVA 표의 새로운 "Error Term" 열
- 역가 신뢰구간의 Lower CL과 Upper CL, 그리고 새로운 "CI Error Term" 열
영향을 받지 않는 항목:
- 모든 제제의 적합된 곡선 모수(상한/하한 점근선, 기울기 인자, 변곡점)
- 추정된 상대 역가 비
- 각 제제에 표시되는 적합 모형 방정식
이 기능을 찾을 수 있는 위치
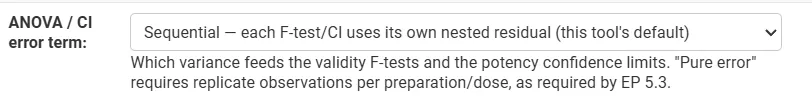
4-모수 로지스틱 방법 도구의 입력 양식에 "ANOVA / CI error term"이라는 항목이 있으며, "Sequential — each F-test/CI uses its own nested residual (this tool's default)"와 "Pure error — single saturated-model residual for all F-tests and the CI (EP 5.3 default)" 중에서 선택할 수 있습니다. Pure error 옵션을 사용하려면 포화 모형(제제/용량군마다 하나씩 적합)에 잔차 자유도가 1 이상 있어야 하며, 이는 데이터에 어느 정도의 반복 측정이 있어야 한다는 뜻입니다.
공개된 참조 데이터를 통한 검증
이 옵션은 파상풍 항독소의 공개된 혈청학적 검정으로 검증되었으며, 표준 제제와 시험 혈청 제제 하나를 용량당 2회 반복으로 10단계 2배 희석에 걸쳐 비교했습니다.
출처: European Pharmacopoeia, 5th Edition (2005), Chapter 5.3, worked example 5.4.1.a — as reproduced in Stegmann Systems' PLA 3.0 published example report (Document-3567, "PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf")
지표 | 공개값(PLA/EP 5.3) | 계산값(Pure Error 옵션) |
Regression F (df=3) | 9785.4821 | 9788.5262 |
Non-parallelism F (df=3) | 0.48912 | 0.4884 |
Lack of Fit F (df=12) | 0.62266 | 0.6216 |
역가 비 | 1.45886 | 1.45880 (반올림: 1.4588) |
추정 시료 역가 (IU/ml) | 0.58354 | 0.5835 |
95% CI (시료 역가, IU/ml) | 0.55511 – 0.61343 | 0.5544 – 0.6127 |
곡선 형태 모수(상한/하한 점근선, 기울기 인자, 변곡점)와 역가 점추정값은 두 규칙 모두에서 공개된 보고서와 거의 정확히 일치하여, 의도한 대로 이 옵션이 적합 자체에는 영향을 주지 않음을 확인했습니다. Pure Error 옵션으로 계산한 F-값과 신뢰구간은 공개된 수치에 가까우며, 주로 신뢰구간에서 나타나는 작은 잔여 차이는 공개된 보고서가 최종 계산 전에 중간값을 소수점 셋째 자리로 반올림한 데서 비롯된 것으로 보입니다. 이 도구의 기존 Sequential 기본값은 예상대로 이 "Pure-error ANOVA" 보고서와 일치하도록 설계된 것이 아니며, 내부적으로 일관성을 유지함을 별도로 검증했습니다.
참고 문헌
- European Pharmacopoeia (Ph. Eur.), Chapter 5.3 — "Statistical Analysis of Results of Biological Assays and Tests" (5th Edition, 2005, and successive editions).
- United States Pharmacopeia, General Chapter <111> — "Design and Analysis of Biological Assays".
- Stegmann Systems GmbH, PLA 3.0 published worked example: "PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf" — https://www.bioassay.de/fileadmin/user_upload/Webseiten-Landingpages/Bioassay.de/Analytical_methodes/Experiments/Parallel_logistic_potency_assays__3PL__4PL__5PL_/PLA_3.0.7_Example_Parallel-Logistic_Quantitative_Response_Assay_Standard_Report.pdf
자주 묻는 질문
4-모수 로지스틱(4PL) 생물검정이란 무엇입니까?
4PL 검정은 상한 점근선, 하한 점근선, 기울기 인자, 변곡점으로 정해지는 S자형 곡선을 각 제제의 로그 용량 대비 반응에 적합합니다. 타당성 검정은 평평한 직선 모형, 변곡점만 다르며 역가 추정값을 제공하는 공유 형태 모형, 그리고 각 제제의 완전 분리 곡선을 비교합니다.
4PL 검정에서 순차 ANOVA와 순수 오차 ANOVA의 차이는 무엇입니까?
Sequential 규칙에서는 각 F 검정이 비교 대상인 특정 중첩 모형의 잔차를 사용하고, 역가 구간은 공통 곡선의 잔차를 사용합니다. Pure Error 규칙에서는 세 가지 F 검정과 역가 구간 모두 완전 포화 적합의 잔차라는 하나의 분모를 공유합니다. 적합된 곡선과 역가 추정값은 두 규칙에서 동일합니다.
4PL 검정에서 순수 오차 옵션은 언제 사용합니까?
순수 오차는 주로 EP 5.3을 준수하는 소프트웨어, 또는 순수 오차 ANOVA 규칙에 기반한 기존 검증 방법과 결과를 대조할 때 사용하십시오. 잘 적합되는 타당한 검정에서는 두 규칙의 차이가 보통 작습니다. 유의하지 않은 소량의 비평행성이나 적합성 결여가 있으면 차이가 커집니다. 그 외에는 Sequential 기본값도 여전히 타당합니다.
Zometric Statistical Software에서 오차항은 어떻게 선택합니까?
4-모수 로지스틱 방법 입력 양식에서 ANOVA / CI error term 항목을 사용하여 Sequential(기본값) 또는 Pure error를 선택합니다. Pure error 옵션을 사용하려면 포화 모형에 잔차 자유도가 1 이상 있어야 하며, 이는 데이터에 어느 정도의 반복 측정이 있어야 한다는 뜻입니다.