
ARIMA(Box-Jenkins 예측)
ARIMA는 자기회귀(p), 차분(d), 이동평균(q) 항과 선택적 계절 항(P, D, Q, s), 상수를 사용해 등간격으로 측정한 시계열을 모형화합니다. 값이 이전 값에 의존하거나 시계열에 추세나 계절성이 있을 때 사용합니다. ACF와 PACF 그림이 차수 결정에 도움이 됩니다. 출력에는 모수 추정값, Ljung-Box 검정, 잔차 ACF/PACF, MAPE, MAD, MSD와 예측 한계가 포함된 예측값이 있습니다.
최종 검토
핵심 요점
ARIMA는 등간격 시계열에 Box-Jenkins 자기회귀 누적 이동평균 모형을 적합하고, 이월 효과, 추세, 계절성을 반영하여 미래 값을 예측 구간과 함께 예측합니다.
목적
ARIMA는 일, 주, 월 등 일정한 시간 간격으로 측정한 시계열에 Box-Jenkins 자기회귀 누적 이동평균 모형을 적합하고, 다음 값들을 예측 구간과 함께 예측합니다. 각 값이 이전 값에 의존하거나, 이동평균이나 지수평활과 같은 단순한 방법으로는 잘 포착되지 않는 추세나 반복되는 계절성이 시계열에 있을 때 사용합니다. 시계열의 자기상관(ACF) 및 편자기상관(PACF) 그림은 실행 전에 모형 차수를 정하는 데 도움이 됩니다.
주요 기능
- 비계절 자기회귀(p), 차분(d), 이동평균(q) 항과 임의의 계절 주기에 대한 계절 항(P, D, Q). 예: 연간 패턴이 있는 월별 데이터는 12, 주간 패턴이 있는 일별 데이터는 7.
- 선택적 상수항: 차분하지 않은 시계열의 평균 수준 또는 차분한 시계열의 평균 드리프트(추세).
- 표준오차, T-값, p-값이 포함된 모수 추정값으로, 필요하지 않은 항을 제거할 수 있습니다.
- 잔차 점검: 잔차 제곱합과 평균제곱, 시차 12, 24, 36, 48에서의 수정 Box-Pierce(Ljung-Box) 카이제곱 검정, 잔차의 ACF 및 PACF 그림.
- 선택한 신뢰수준에서의 예측 하한 및 상한이 포함된 예측값. 예측 시작점을 지정하면 이전 행에서부터 예측하여 예측값을 실제 결과와 비교할 수 있습니다.
- 적합 정확도 측도 MAPE, MAD, MSD로, 다른 시계열 도구와 비교할 수 있습니다.
- 선택적 추가 출력: 반복마다의 추정값, 추정 모수의 상관 행렬, 역예측값, 4-in-1 잔차 그림.
통계적 방법
모형은 φ(B)Φ(Bˢ)(1−B)ᵈ(1−Bˢ)ᴰ yₜ = C + θ(B)Θ(Bˢ) aₜ입니다. 여기서 B는 후진 연산자, φ와 θ는 차수가 p와 q인 비계절 AR 및 MA 다항식, Φ와 Θ는 Bˢ에 대한 차수가 P와 Q인 계절 AR 및 MA 다항식, s는 계절 주기, C는 상수, aₜ는 잔차(확률적 충격)입니다. 차분 (1−B)ᵈ(1−Bˢ)ᴰ은 AR 및 MA 항을 적합하기 전에 추세와 계절성을 제거하므로, 시계열 시작 부분에서 d + D·s개의 관측값이 줄어듭니다.
모수는 역예측을 포함한 Box-Jenkins 최소제곱법으로 추정합니다. 초기값을 반복적으로 개선하여 잔차 제곱합을 최소화하며, 표본 이전의 값을 얻기 위해 시계열을 거꾸로 예측합니다. 잔차 평균제곱 MS = SS / DF이며, DF = 차분된 관측값 수 − 추정 모수 수입니다. 각 계수의 T-값은 계수를 표준오차로 나눈 값이며, p-값은 잔차 DF를 갖는 t 분포에서 구합니다. 상수가 있는 차분하지 않은 모형에서는 공정 평균 C / (φ(1)Φ(1))도 보고됩니다.
Ljung-Box 통계량 Q = n(n+2) Σ rₖ² / (n−k)는 각 시차까지의 잔차 자기상관 rₖ로 계산하며, 자유도가 시차에서 추정 모수 수를 뺀 값인 카이제곱 분포와 비교합니다. p-값이 0.05보다 크면 잔차에 자기상관이 남아 있다는 증거가 없음을 의미합니다. 예측값은 적합된 식에서 재귀적으로 구합니다. h기 앞의 예측 구간은 예측값 ± z·√(MS·Σψⱼ²)이며, 모형의 처음 h개 ψ 가중치를 합하므로 예측 기간이 길어질수록 구간이 넓어집니다.
입력 항목 및 옵션
항목 | 설명 |
Variable (Y) | 필수. 등간격으로 시간순으로 정렬된 시계열이 들어 있는 열입니다. |
Autoregressive order (p) | 비계절 AR 항의 수(0~10, 기본값 1): 이전 값 중 몇 개가 현재 값으로 이월되는지를 나타냅니다. |
Difference order (d) | 비계절 차분 횟수(0~3, 기본값 0). 이동하거나 증가하는 추세가 있는 시계열에는 1을 사용합니다. |
Moving average order (q) | 비계절 MA 항의 수(0~10, 기본값 0): 이전 확률적 충격 중 몇 개가 이월되는지를 나타냅니다. |
Include seasonal terms | 아래의 계절 차수를 추가하려면 선택합니다. 모형에는 전체적으로 AR 또는 MA 항이 하나 이상 필요합니다. |
Seasonal AR order (P) / Seasonal difference order (D) / Seasonal MA order (Q) | 계절 차수(P와 Q는 0~5, D는 0~2). s = 12인 월별 데이터에서 D = 1은 전년 대비 변화를 모형화합니다. |
Seasonal period (s) | 계절 항 사용 시 필수: 한 계절의 관측값 수(연간 주기의 월별 데이터는 12, 분기별 데이터는 4, 주간 주기의 일별 데이터는 7). |
Include constant term | 기본적으로 선택되어 있습니다. 드리프트가 없는 차분 시계열에서는 선택을 해제합니다. |
Number of forecasts | 예측 시작점 이후 몇 기를 예측할지 지정합니다(0~1000, 0 = 예측 없음). |
Confidence level (%) for forecast interval | 기본값은 95입니다. |
Forecast origin (row) | 선택 사항. 이 행까지의 데이터를 사용하여 이 행 이후부터 예측하며, 비워 두면 시계열의 끝입니다. 이미 가지고 있는 데이터로 모형을 시험할 때 사용합니다. |
Results to display | 최종 추정값, 차분 정보, 잔차 제곱합, 관측값 수 또는 이에 더해 반복마다의 추정값, 추정 모수의 상관 행렬, 역예측값. |
Residual plots (four in one) | 정규 확률도, 잔차 대 적합값, 히스토그램, 잔차 대 순서를 추가합니다. |
Title | 출력에 표시되는 제목입니다. |
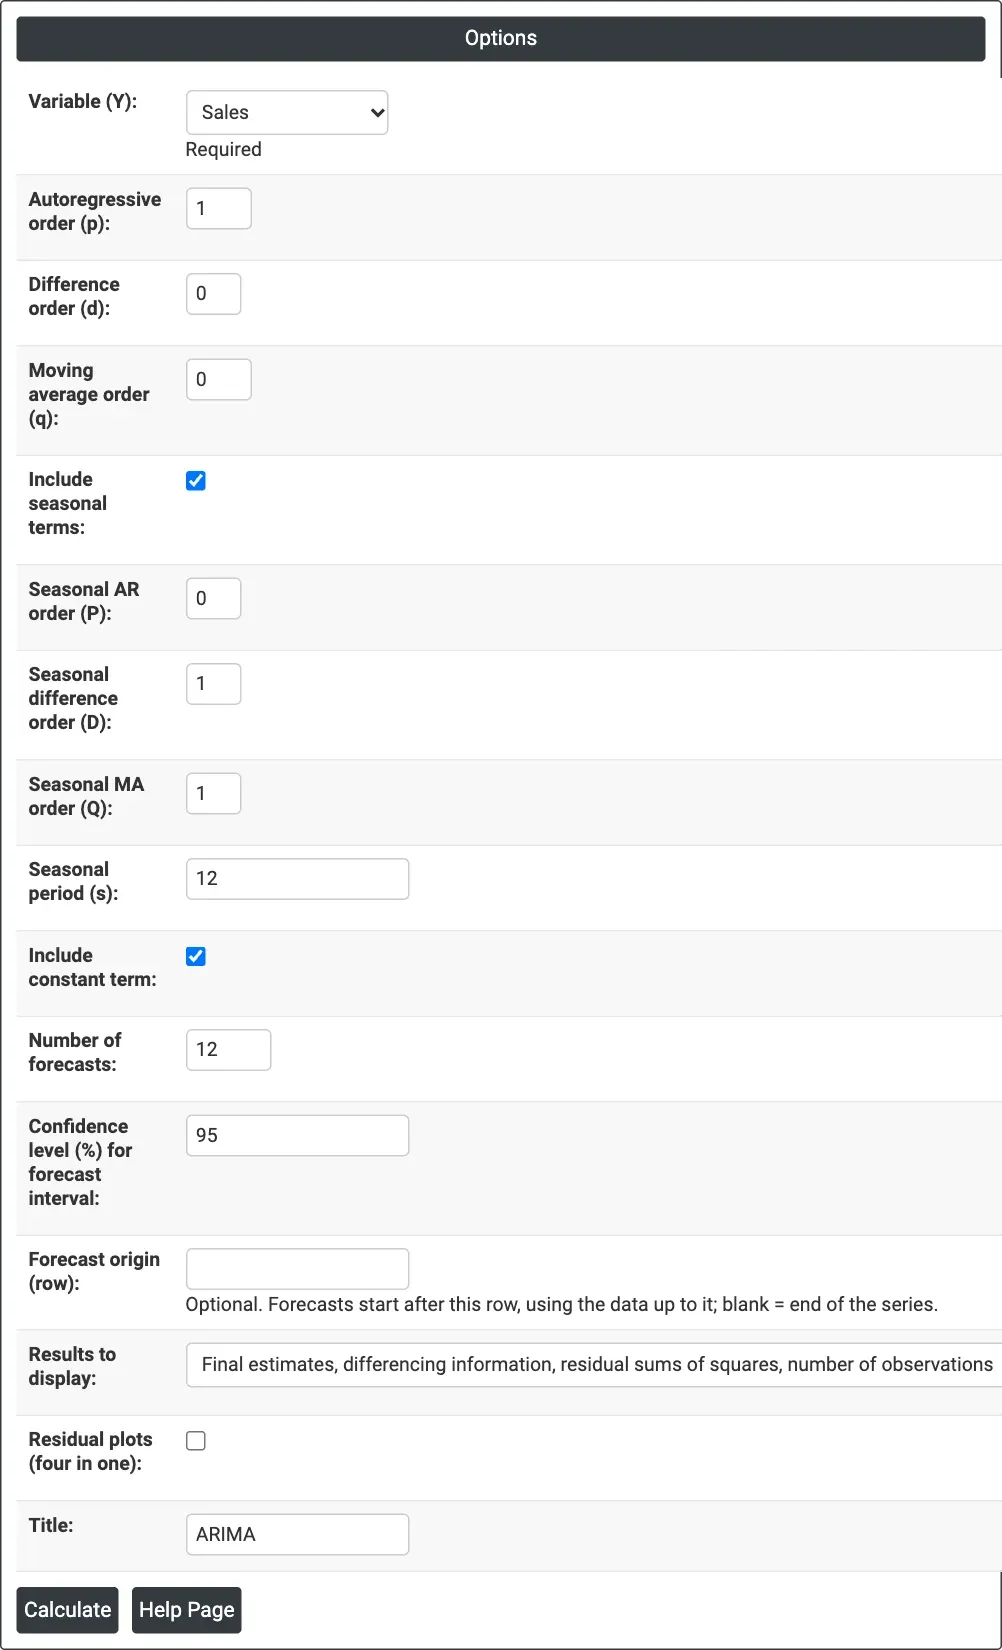
그림 1 — 월별 판매 예제: Variable (Y) = Sales, 상수가 있는 계절형 ARIMA(1, 0, 0)(0, 1, 1)12 모형과 12기 예측.
출력 설명
- ARIMA plot — 적합값, 예측값과 예측 구간 대역이 포함된 시계열이며, MAPE, MAD, MSD가 제목 아래에 표시됩니다.
- Final Estimates of Parameters — 각 AR, SAR, MA, SMA 항과 상수의 coefficient, SE Coef, T-Value, P-Value(상수가 있는 차분하지 않은 모형에서는 Mean도 포함).
- Residual Sums of Squares — 잔차의 DF, SS, MS.
- Modified Box-Pierce (Ljung-Box) Chi-Square statistic — 시차 12, 24, 36, 48에서의 Chi-Square, DF, P-Value(시계열보다 긴 시차는 제외됩니다).
- Forecasts — 기간, 예측값, 예측 하한 및 상한.
- ACF and PACF of Residuals — 점선 한계 안에 있는 막대는 자기상관이 남아 있지 않음을 의미합니다.
- Results to display 및 Residual plots에서 선택한 선택적 표와 그림, 그리고 Download를 통한 PDF 내보내기.
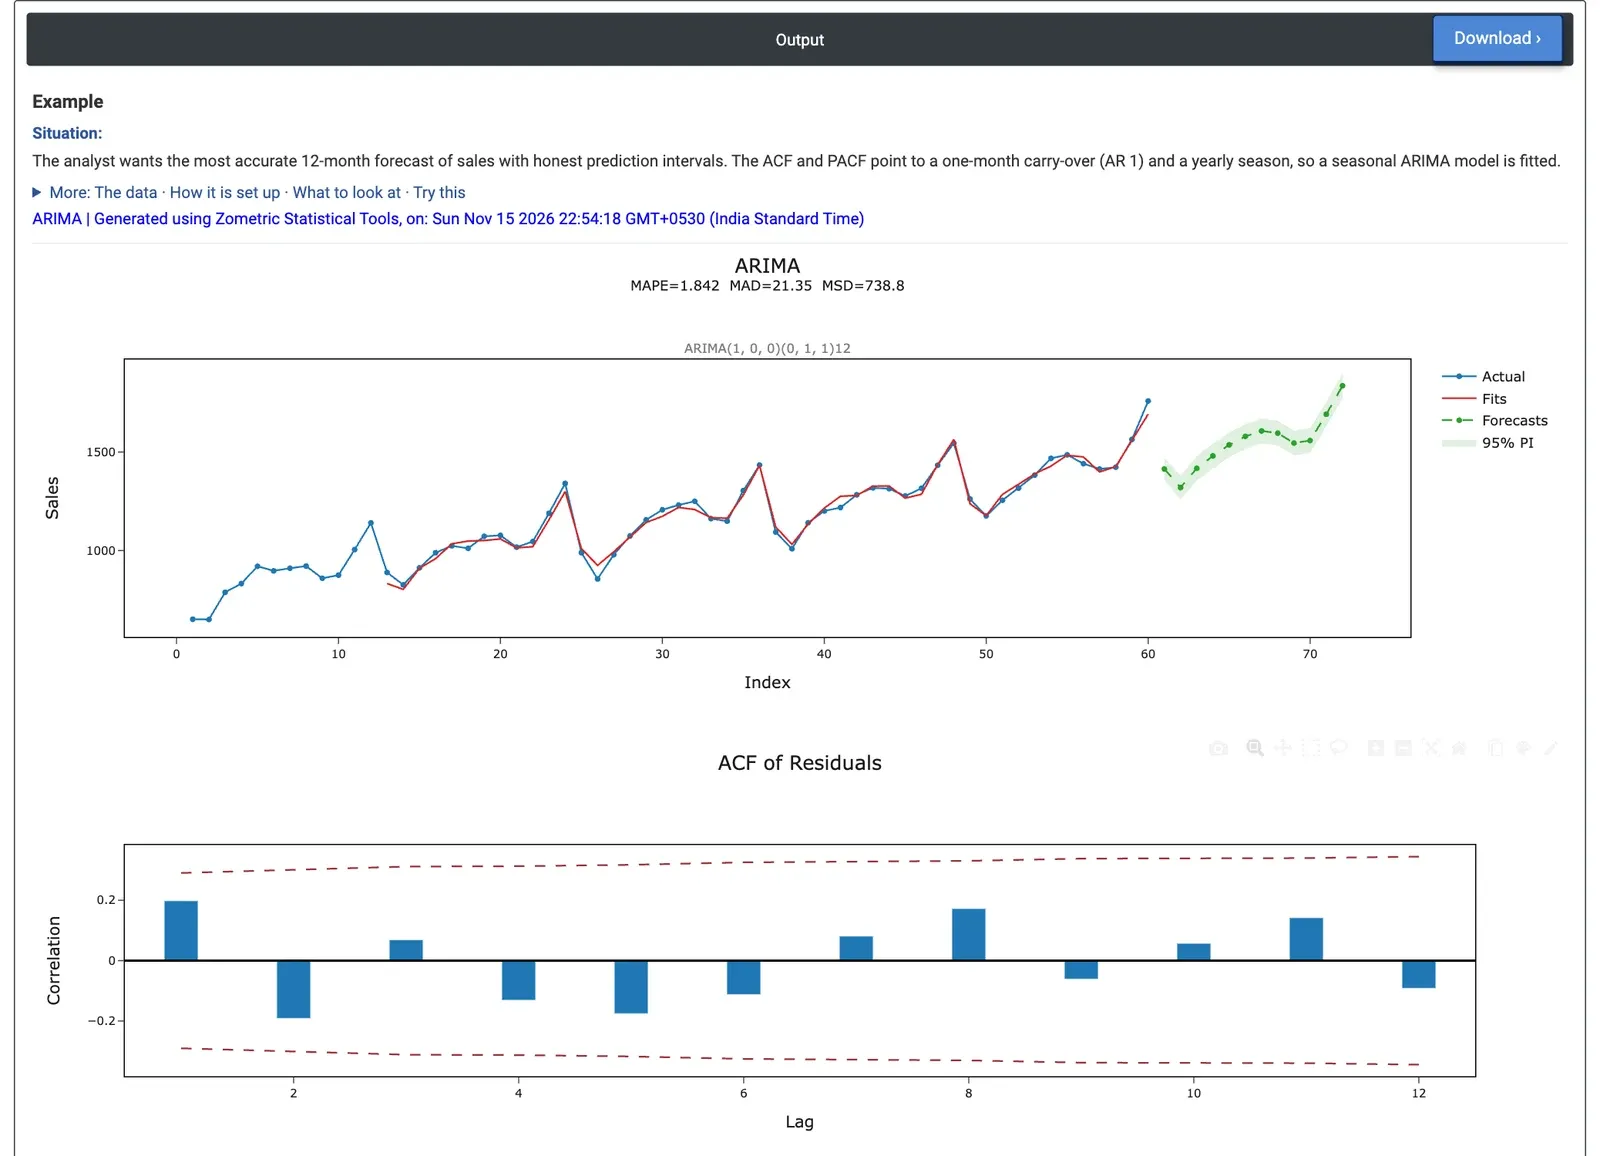
그림 2 — 월별 판매 예제의 ARIMA 출력: 적합 결과와 95% 예측 대역이 있는 12개월 예측, 그리고 잔차의 ACF.
계산 예제
한 분석가가 60개월의 판매 데이터(2020년 1월~2024년 12월)를 가지고 있으며, 신뢰할 수 있는 예측 구간이 포함된 12개월 예측을 원합니다. ACF와 PACF는 1개월 이월과 연간 계절성을 나타내므로, 모형은 상수가 있는 ARIMA(1, 0, 0)(0, 1, 1)12이며, Autoregressive order (p) = 1, Seasonal difference order (D) = 1, Seasonal MA order (Q) = 1, Seasonal period (s) = 12, Number of forecasts = 12로 설정합니다.
두 항 모두 분명히 필요합니다. AR 1 = 0.481(SE 0.104, T = 4.63, p < 0.001), SMA 12 = 0.805(SE 0.144, T = 5.59, p < 0.001)이며, 상수는 69.34(평균 전년 대비 증가량)입니다. 잔차 MS는 DF 45에서 788.1입니다(60개월 − 계절 차분으로 손실된 12개월 − 모수 3개). Ljung-Box p-값은 시차 12, 24, 36에서 0.214, 0.319, 0.254로 모두 0.05보다 크므로 잔차는 무작위 잡음으로 보이며 모형이 패턴을 잘 포착했습니다. 적합도 가깝습니다: MAPE 1.84%, MAD 21.35, MSD 738.8.
2025년 1월(61기)의 예측값은 1,414개이며 95% 예측 구간은 1,359~1,469입니다. 2025년 12월(72기)에는 1,837로 증가하며 구간은 1,774~1,899입니다. 모형을 신뢰하기 전에 시험하려면 Forecast origin (row) = 48로 설정하여 2023년 12월까지의 데이터로 2024년을 예측하고, 그 예측값을 실제 2024년 판매량과 비교합니다.
자주 묻는 질문
ARIMA 모형이란 무엇입니까?
ARIMA는 등간격으로 측정한 시계열에 대한 Box-Jenkins 자기회귀 누적 이동평균 모형입니다. 자기회귀 항은 이전 값을 이월하고, 차분은 추세를 제거하며, 이동평균 항은 이전 확률적 충격을 이월합니다. 반복되는 계절성에는 계절 항을 추가할 수 있으며, 예를 들어 연간 패턴이 있는 월별 데이터에는 주기 12를 사용합니다.
지수평활 대신 ARIMA는 언제 사용합니까?
각 값이 이전 값에 의존하거나, 이동평균이나 지수평활과 같은 단순한 방법으로는 잘 포착되지 않는 추세나 반복되는 계절성이 시계열에 있을 때 ARIMA를 사용하십시오. 시계열의 자기상관(ACF) 및 편자기상관(PACF) 그림은 적합 전에 모형 차수를 정하는 데 도움이 됩니다.
ARIMA 모형이 잘 적합되는지 어떻게 확인합니까?
각 항의 p-값이 그 항이 필요함을 보이는지 확인하고, 시차 12, 24, 36, 48에서의 Ljung-Box 카이제곱 검정을 살펴봅니다. p-값이 0.05보다 크면 잔차에 자기상관이 남아 있다는 증거가 없음을 의미합니다. 잔차 ACF와 PACF 막대는 점선 한계 안에 있어야 합니다. MAPE, MAD, MSD는 적합 정확도를 요약합니다.
ARIMA 예측을 신뢰하기 전에 어떻게 시험합니까?
예측 시작점을 이전 행으로 설정하면 그 시점까지의 데이터로 모형이 예측하며, 그 예측값을 실제 결과와 비교합니다. 계산 예제에서 시작점을 48행으로 설정하면 2023년 12월까지의 데이터로 2024년을 예측하여 실제 2024년 판매량과 비교할 수 있습니다. 예측 구간은 예측 기간이 길어질수록 넓어집니다.