
확장 Dickey-Fuller 검정(ADF Test)
확장 Dickey-Fuller 검정은 시계열에 단위근(비정상성)이 있다는 가설을 정상 시계열이라는 대립가설에 대해 검정합니다. 정상성을 가정하는 ARIMA 등의 모형을 적합하기 전에 사용합니다. 상수, 상수와 추세, 2차 추세 또는 항 없음 중에서 선택하고, 시차는 AIC, BIC, t-stat 또는 고정값으로 정합니다. 시계열에는 결측이 없어야 하며 값이 6개 이상 필요합니다. 출력에는 통계량, p-값, 시차, 임계값이 표시됩니다.
최종 검토
핵심 요점
확장 Dickey-Fuller(ADF) 검정은 시계열이 정상(stationary)인지 단위근을 갖는지 확인하여, ARIMA 이전에 원 데이터를 모형화할지, 추세를 모형화할지, 시계열을 차분할지 결정하는 데 도움을 줍니다.
목적
확장 Dickey-Fuller(ADF) 검정은 시계열이 정상인지, 즉 고정된 평균(또는 고정된 추세) 주위에서 변동하는지 아니면 되돌아오지 않고 떠도는지를 확인합니다. 많은 예측 모형, 특히 ARIMA는 정상 시계열을 가정합니다. 이러한 모형을 적합하기 전에 이 검정을 실행하면 원 데이터를 모형화할지, 추세를 모형화할지, 먼저 시계열을 차분할지 결정할 수 있습니다.
주요 기능
- 단위근이 있다(비정상 시계열)는 귀무가설을 정상 시계열이라는 대립가설에 대해 검정합니다.
- 검정 회귀식의 네 가지 형태를 제공합니다: 상수 주위, 상수와 선형 추세, 상수와 선형 및 2차 추세, 또는 둘 다 없음.
- AIC, BIC 또는 마지막 시차의 t-통계량으로 차분 시차의 수를 자동 선택하거나, 사용자가 입력한 고정 개수를 사용합니다.
- 검정 통계량, p-값, 사용된 시차, 1%, 5%, 10% 임계값을 보고하며, 지정한 유의수준에서의 결론을 알기 쉬운 문장으로 제공합니다.
통계적 방법
이 검정은 회귀식 Δyₜ = α + βt + γ·yₜ₋₁ + δ₁Δyₜ₋₁ + … + δₖΔyₜ₋ₖ + εₜ를 적합합니다. 여기서 Δyₜ = yₜ − yₜ₋₁입니다. 상수 α와 추세 βt는 Regression type에 따라 포함하거나 제외합니다(2차 옵션은 t² 항을 추가합니다). 검정 통계량은 γ의 t-비입니다. 시계열에 단위근이 있으면 γ = 0이며, 통계량이 크게 음수이면 시계열이 평균 또는 추세로 되돌아오는 것이므로 정상입니다. 이 통계량은 일반적인 t 분포를 따르지 않습니다. p-값은 MacKinnon의 근사 분포를 사용하고 임계값은 MacKinnon의 표에서 가져오며, 둘 다 선택한 회귀 유형에 대한 값입니다.
차분 시차 Δyₜ₋ᵢ는 단기 자기상관을 흡수합니다. Maximum lag의 기본값은 min(n/2 − 3, 12·(n/100)^¼)을 내림한 값입니다. AIC 또는 BIC에서는 0부터 최대값까지 모든 시차를 적합하여 기준값이 가장 낮은 시차를 선택하고, t-stat에서는 최대 시차에서 시작하여 마지막 시차의 |t| ≥ 1.645가 될 때까지 시차를 줄이며, Fixed에서는 최대 시차를 그대로 사용합니다. N Observations는 회귀식에 남은 행의 수로, n − 사용된 시차 − 1입니다. 계산에는 statsmodels의 adfuller를 사용합니다. 시계열에는 결측이 없어야 하며 값이 6개 이상 있어야 합니다.
p-값이 유의수준보다 작으면 단위근이 있다는 귀무가설을 기각하고 시계열을 정상으로 봅니다. 그렇지 않으면 비정상일 가능성이 높으며 차분(또는 추세 항)이 필요합니다. 유의수준은 이 결론 문장에만 영향을 주며, 임계값은 항상 1%, 5%, 10%로 표시됩니다.
입력 항목 및 옵션
항목 | 설명 |
Variable | 필수 항목입니다. 시간 순서대로 시계열이 담긴 수치형 열입니다. |
Regression type | Constant(평균 주위의 정상성 검정), 기본값; Constant and trend(추세 주위의 정상성 검정); Constant, linear, and quadratic trend; 또는 None(상수 없음, 추세 없음). |
Lag selection method | AIC(Akaike 정보 기준 최소화), 기본값; BIC(Bayes 정보 기준 최소화); t-stat(마지막 시차의 t-통계량이 유의하지 않은 동안 시차 제거); 또는 Fixed(Maximum lag를 그대로 사용). |
Maximum lag | 선택 항목입니다. AIC, BIC, t-stat에서 탐색하는 상한이며, Fixed에서는 그대로 사용하는 시차입니다. 비워 두면 min(n/2 − 3, 12·(n/100)^¼)을 사용합니다. |
Significance level | 기본값 0.05(0.001~0.5)입니다. 결론을 내릴 때 p-값과 비교합니다. |
Title | 출력에 표시되는 제목입니다. |
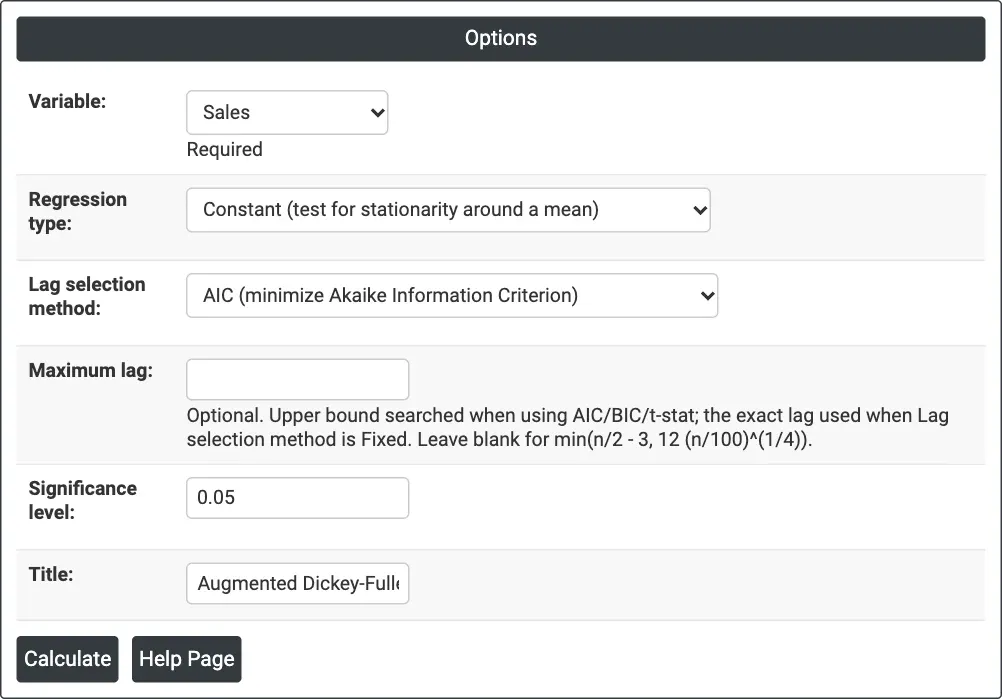
그림 1 — 월별 Sales를 상수만 포함하여 검정한 결과(시차는 AIC로 선택, 유의수준 0.05).
출력 설명
- Test — 변수, 검정 통계량, p-값, 사용된 차분 시차 수, 탐색한 최대 시차, 검정 회귀식의 관측값 수입니다.
- Critical Values — 선택한 회귀 유형에 대한 검정 통계량의 1%, 5%, 10% 임계값입니다. 통계량이 임계값보다 작으면(더 음수이면) 해당 수준에서 시계열은 정상입니다.
- Conclusion — p-값을 유의수준과 비교하여 시계열이 정상일 가능성이 높은지 비정상일 가능성이 높은지 알려 주는 문장입니다.
- Download를 통한 PDF 내보내기.
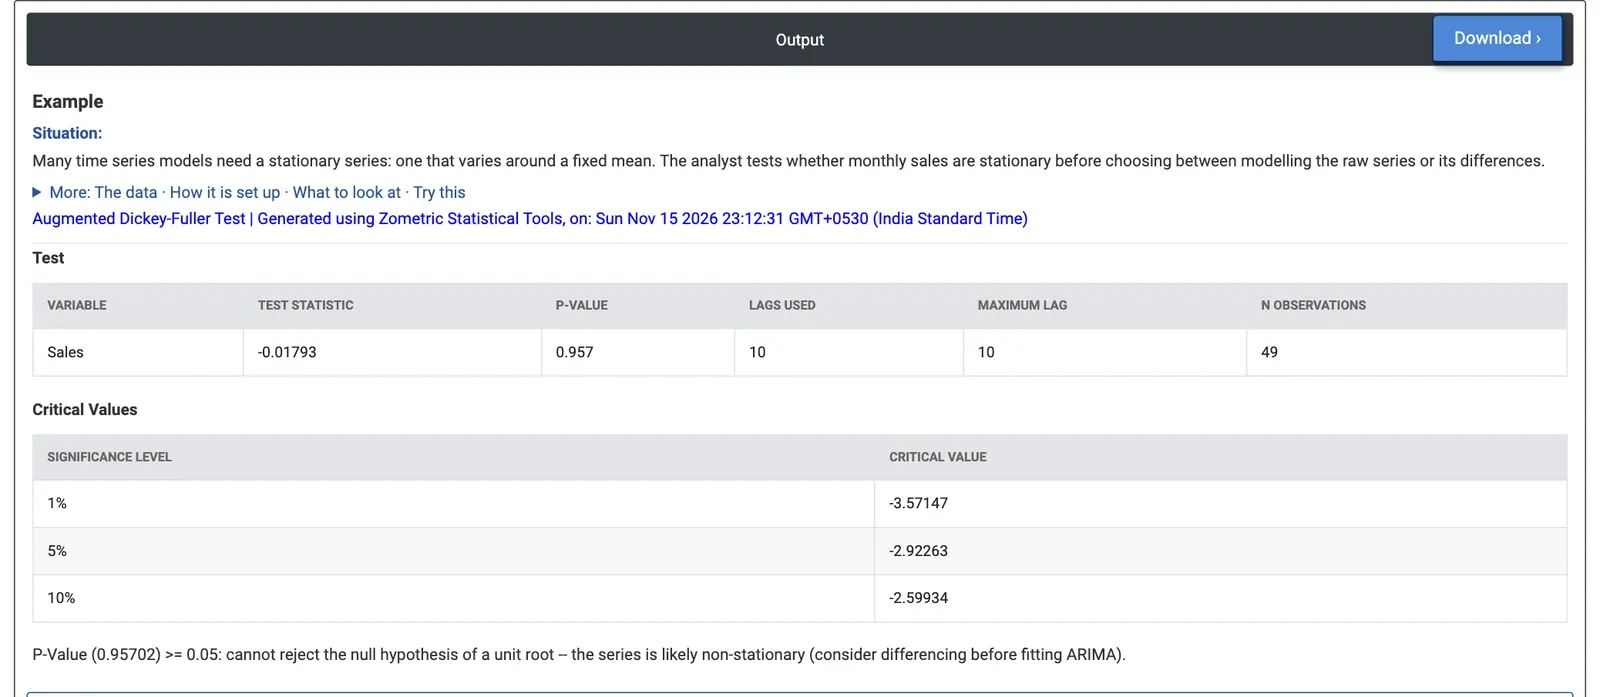
그림 2 — 고정 평균 주위에서 검정한 월별 판매량: 통계량 −0.018, p-값 0.957이므로 시계열은 정상이 아닙니다.
계산 예제
한 소비자 가전 유통업체의 판매 분석가가 60개월간(2020년 1월~2024년 12월)의 단위 판매량 데이터를 가지고 ARIMA 예측을 계획하고 있습니다. 먼저 분석가는 판매량이 정상인지 검정합니다. 분석가는 Variable = Sales를 선택하고 Regression type = Constant, Lag selection method = AIC, Significance level = 0.05를 유지합니다.
탐색한 최대 시차는 10이고 AIC는 10개를 모두 유지하여, 검정 회귀식에는 49개의 관측값이 남습니다. 검정 통계량은 −0.018이고 p-값은 0.957이며, 5% 임계값은 −2.92로 통계량은 이 값에 전혀 근접하지 않습니다. 단위근을 기각할 수 없으므로 판매량은 고정 평균 주위에서 변동하지 않으며, 이는 매년 판매량이 증가하는 데이터 그림과 일치합니다.
Regression type = Constant and trend로 하면 통계량은 −7.78이고 5% 임계값은 −3.50(p-값 0.001 미만)이며 사용된 시차는 9개입니다. 직선 추세 주위에서는 시계열이 정상이므로 증가세가 일정합니다. 모형 측면에서는 추세 항을 사용하거나 차분해야 한다는 뜻이며, ARIMA 페이지와 같이 12개월 차분과 상수를 포함한 계절 ARIMA는 증가세와 연간 패턴을 모두 처리합니다. Advertising Spend에 대해 상수만 포함하여 검정해도 같은 결과가 나옵니다(통계량 0.13, p-값 0.968).
자주 묻는 질문
확장 Dickey-Fuller 검정으로 무엇을 알 수 있습니까?
ADF 검정은 시계열이 정상인지, 즉 고정된 평균이나 추세 주위에서 변동하는지, 아니면 단위근이 있어 되돌아오지 않고 떠도는지를 알려 줍니다. 귀무가설은 단위근이 있다는 것입니다. 많은 예측 모형, 특히 ARIMA는 정상 시계열을 가정하므로, 이 검정은 데이터를 차분할지 추세를 모형화할지 결정하는 기준이 됩니다.
ADF 검정의 p-값은 어떻게 해석합니까?
p-값이 유의수준보다 작으면 단위근 귀무가설을 기각하고 시계열을 정상으로 봅니다. 그렇지 않으면 비정상일 가능성이 높으며 차분이나 추세 항이 필요합니다. 같은 의미로, 검정 통계량이 해당 수준의 임계값보다 작으면(더 음수이면) 그 수준에서 시계열은 정상입니다.
ADF 검정에서 어떤 회귀 유형을 선택해야 합니까?
고정 평균 주위의 정상성을 검정하려면 Constant, 직선 추세 주위의 정상성을 검정하려면 Constant and trend, 2차 추세 옵션, 또는 상수와 추세가 없는 None 중에서 선택합니다. 판매량 예제에서 시계열은 평균 주위에서는 정상이 아니었지만(p = 0.957) 추세 주위에서는 정상이었습니다(통계량 -7.78, p-값 0.001 미만).
ADF 검정에서 시차의 수는 어떻게 선택합니까?
차분 시차는 단기 자기상관을 흡수합니다. AIC 또는 BIC에서는 0부터 최대값까지 모든 시차를 적합하여 기준값이 가장 낮은 시차를 선택하고, t-stat에서는 마지막 시차의 t 절댓값이 1.645 이상이 될 때까지 시차를 줄이며, Fixed에서는 최대 시차를 그대로 사용합니다. 기본 최대값은 min(n/2 - 3, 12 x (n/100)^0.25)입니다.