
자기상관 함수(ACF)
자기상관 함수는 각 시차에서 시계열과 그 자신의 상관을 계산하고, 유의 한계가 있는 상관도(correlogram)와 T 및 Ljung-Box Q 통계량을 함께 제공합니다. 예측 전에는 차분과 ARIMA 항을 결정하는 데, 적합 후에는 잔차에 시간 패턴이 없는지 확인하는 데 사용합니다. 시계열은 수치형이며 시간 순서대로 있고 결측이 없어야 합니다.
최종 검토
핵심 요점
자기상관 함수(ACF)는 시계열이 1, 2, 3기 이상 이전의 자기 자신과 얼마나 강하게 상관되어 있는지를 측정하여, 예측 모형을 선택하기 전에 추세, 계절성 또는 이월 효과를 드러냅니다.
목적
자기상관 함수(ACF)는 시계열이 1, 2, 3 … 기 이전의 자기 자신과 얼마나 강하게 상관되어 있는지를 측정합니다. 이 상관의 패턴은 추세, 계절성 또는 한 기간에서 다음 기간으로의 단순한 이월 효과를 보여 줍니다. 예측 모형을 선택하기 전에 시계열을 차분해야 하는지, 어떤 ARIMA 항을 시도할지 결정하는 데 사용하고, 모형을 적합한 후에는 잔차에 더 이상 시간 패턴이 없는지 확인하는 데 사용합니다.
주요 기능
- 시차 1부터 사용자가 선택한 시차 수까지(또는 시계열 길이에 따른 기본값까지) 모든 시차의 자기상관을 계산합니다.
- 시차가 커질수록 넓어지는 점선 유의 한계가 있는 상관도(막대 그래프)를 제공합니다.
- 각 시차의 T 통계량과 누적 Ljung-Box Q(LBQ) 통계량을 하나의 표로 제공합니다.
- 시간 순서대로 정렬된 모든 수치형 열에 사용할 수 있으며, 시계열에는 결측이 없어야 합니다.
통계적 방법
평균이 ȳ인 시계열 y₁ … yₙ에 대해 시차 k의 자기상관은 표준 표본 ACF인 rₖ = Σₜ (yₜ − ȳ)(yₜ₊ₖ − ȳ) / Σₜ (yₜ − ȳ)²입니다. 표준오차는 Bartlett 공식 SEₖ = √((1 + 2·(r₁² + … + rₖ₋₁²)) / n)을 사용하므로, 앞선 자기상관이 크면 시차가 커질수록 표준오차도 커집니다. T 열은 rₖ / SEₖ이고, 그래프의 유의 한계는 ± t₀.₉₇₅,ₙ₋₁ × SEₖ입니다(표준오차의 약 ±2배). 한계를 벗어난 막대는 5% 수준에서 우연일 가능성이 낮은 상관입니다.
Ljung-Box 통계량 LBQₖ = n(n + 2)·Σⱼ≤ₖ rⱼ² / (n − j)는 처음 k개의 자기상관이 모두 동시에 0인지 검정합니다. 무작위 시계열에서는 대략 자유도 k의 카이제곱 분포를 따르므로, 카이제곱 임계값보다 훨씬 큰 값은 시계열에 모형화해야 할 시간 패턴이 있다는 뜻입니다. Number of lags를 비워 두면 도구는 n/4개의 시차를 사용하며(n > 240이면 √n + 45), n − 1을 넘지 않습니다.
패턴을 읽는 방법: 상관이 여러 시차에 걸쳐 천천히 줄어들면 추세가 있다는 뜻이며(시계열이 정상이 아니므로 차분이 필요합니다), 계절 시차(월별 데이터는 12)에서 정점이 나타나면 계절성이 있다는 뜻이고, 시차 q 이후에 급격히 끊기면 q차 이동평균 항을 시사합니다.
입력 항목 및 옵션
항목 | 설명 |
Variable | 필수 항목입니다. 시간 순서대로 시계열이 담긴 수치형 열입니다. |
Number of lags | 선택 항목이며 1~1000입니다. 표시할 가장 큰 시차입니다. 비워 두면 n/4를 사용합니다(n > 240이면 √n + 45). 계절 데이터는 최소 두 개의 전체 계절을 선택하십시오. 예를 들어 월별 데이터는 24입니다. |
Title | 그래프에 표시되는 제목입니다. 기본값은 Autocorrelation Function입니다. |
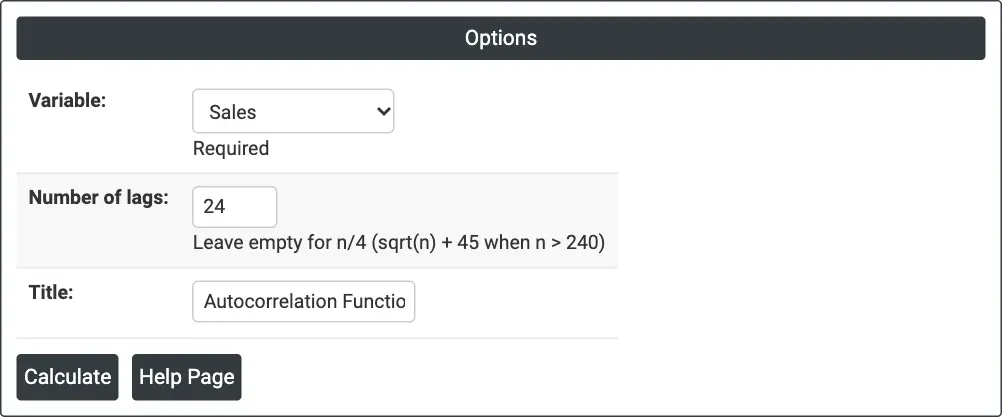
그림 1 — 월별 Sales의 24개 시차(2년)에 대한 자기상관.
출력 설명
- Autocorrelation Function (graph) — 점선 유의 한계와 함께 각 시차를 나타내는 막대입니다.
- Autocorrelation Function: <variable> (table) — 각 시차의 Lag, ACF, T, LBQ입니다.
- Download를 통한 PDF 내보내기.
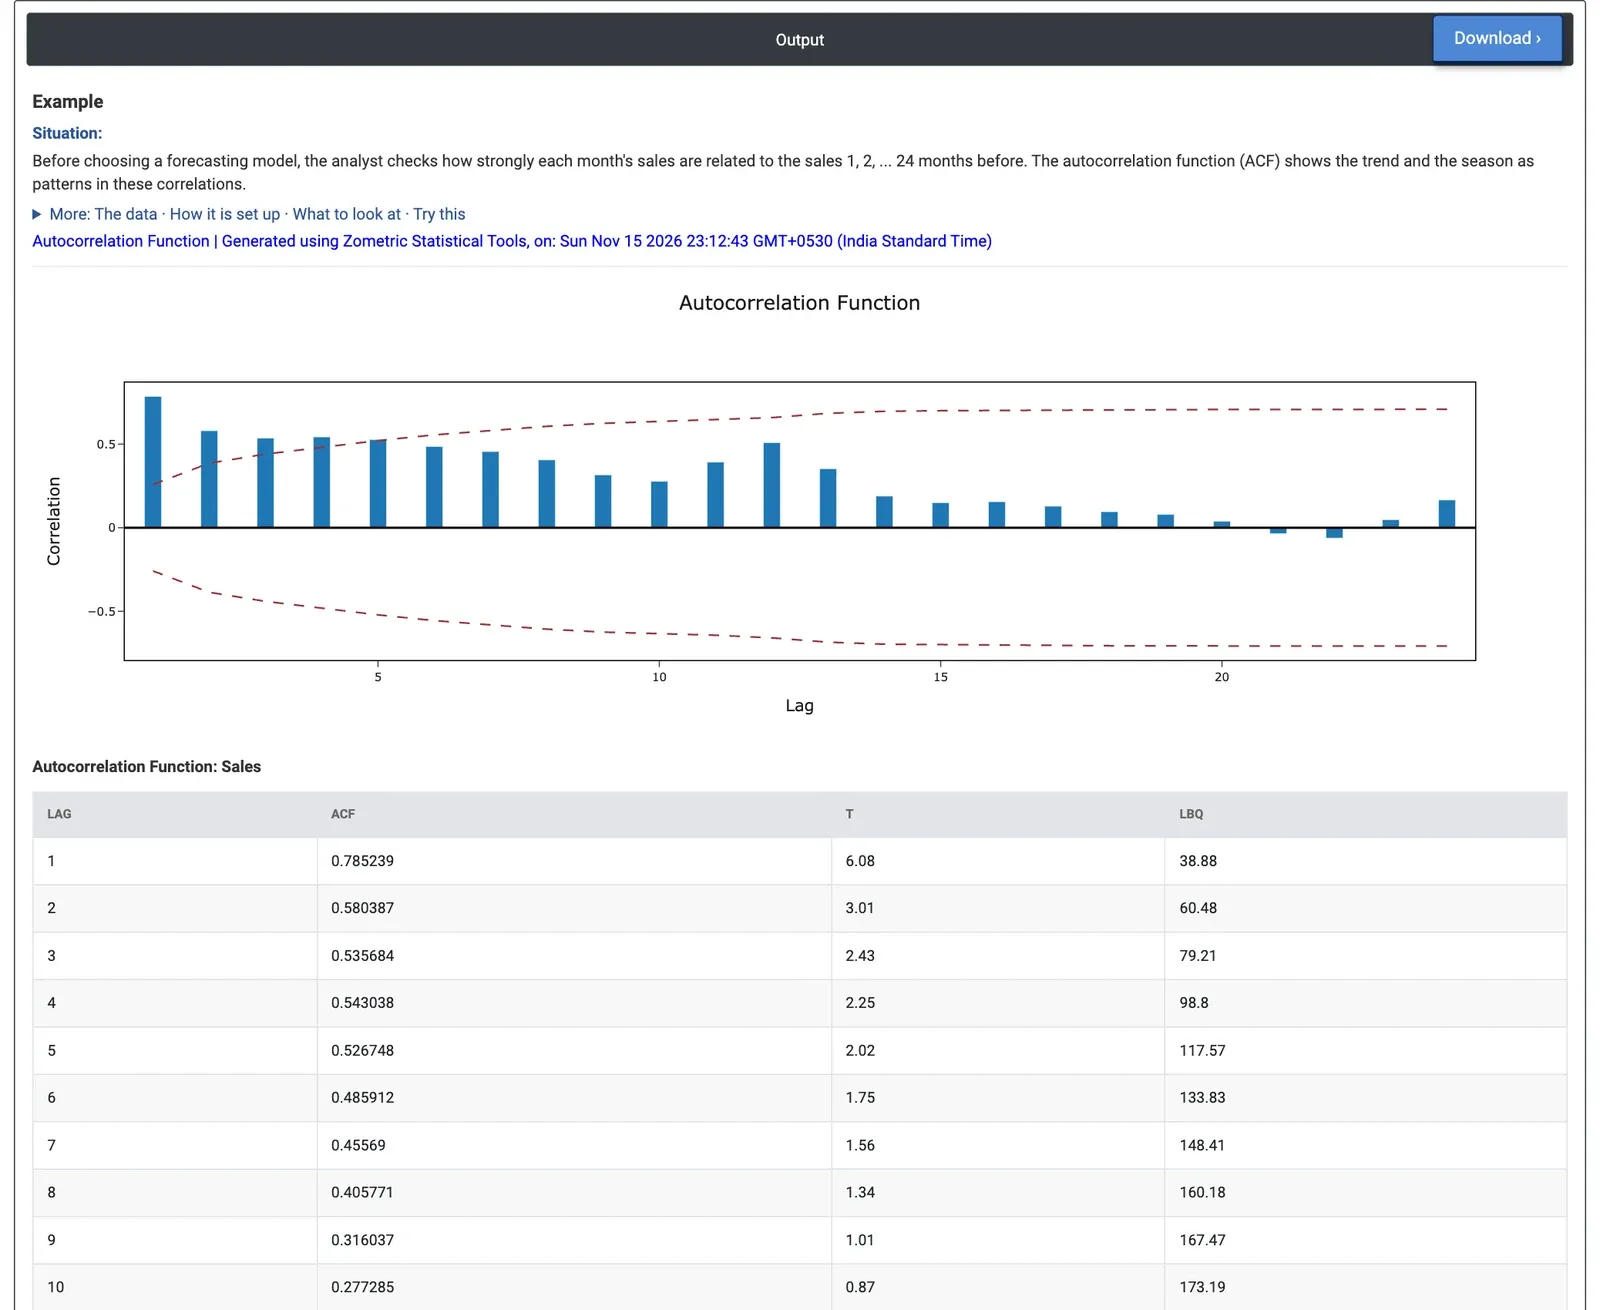
그림 2 — 월별 판매량의 ACF: 시차 1의 상관이 0.79로 크고 천천히 감소하며, 시차 12에서 다시 상승합니다.
계산 예제
한 소비자 가전 유통업체가 2020년 1월부터 2024년 12월까지 매달(60개월) 단위 판매량을 기록합니다. 예측 모형을 만들기 전에 판매 분석가는 각 달이 이전 24개월과 어떤 관계인지 확인합니다. 분석가는 Variable = Sales, Number of lags = 24를 선택합니다.
시차 1의 자기상관은 0.79(T 6.08)입니다. 인접한 달끼리 매우 비슷하다는 뜻입니다. 상관은 시차 2의 0.58에서 시차 6의 0.49까지 천천히만 감소하며, 시차 1~5는 유의 한계 밖에 있습니다. 이렇게 천천히 감소하는 것은 추세의 특징으로, 판매량은 정상이 아닙니다. 시차 10의 0.28로 낮아진 뒤 ACF는 다시 올라 시차 12에서 0.51이 되는데, 이것이 연간 계절성입니다. 이 막대는 한계 안에 있는데, 앞선 큰 상관 때문에 그 시점의 한계가 ±0.66으로 넓기 때문입니다. LBQ는 시차 24에서 228.1에 도달하며, 이는 자유도 24의 5% 카이제곱 임계값인 36.4를 크게 넘으므로 모형화해야 할 강한 시간 패턴이 있습니다.
예측을 위해서는 시계열을 차분하거나(여기서는 12개월 계절 차분) 추세를 직접 모형화해야 합니다. Sales의 12개월 차분에서는 천천히 감소하는 현상이 사라져, ACF는 시차 1에서 0.47이고 시차 11까지 다른 어떤 시차도 한계 밖에 있지 않으며, 이 때문에 ARIMA 예제에서는 계절 차분한 시계열에 AR(1) 항을 사용합니다. Advertising Spend의 ACF는 연간 정점이 훨씬 강합니다: 시차 12에서 0.59(T 2.52)입니다.
자주 묻는 질문
자기상관 함수(ACF)란 무엇입니까?
자기상관 함수는 시계열이 1, 2, 3기 이상 이전의 자기 자신과 얼마나 강하게 상관되어 있는지를 측정합니다. 시차 k의 자기상관은 시계열 평균을 기준으로 각 값을 k기 이후의 값과 비교합니다. 이 상관의 패턴은 추세, 계절성 또는 한 기간에서 다음 기간으로의 단순한 이월 효과를 보여 줍니다.
ACF 그림은 어떻게 읽습니까?
점선 유의 한계 밖의 막대는 5% 수준에서 우연일 가능성이 낮은 상관입니다. 상관이 여러 시차에 걸쳐 천천히 줄어들면 추세가 있다는 뜻이며, 시계열이 정상이 아니므로 차분이 필요합니다. 월별 데이터의 12처럼 계절 시차에서 정점이 나타나면 계절성이 있다는 뜻입니다. 시차 q 이후에 급격히 끊기면 q차 이동평균 항을 시사합니다.
Ljung-Box Q(LBQ) 통계량은 무엇을 검정합니까?
Ljung-Box 통계량은 처음 k개의 자기상관이 모두 동시에 0인지 검정합니다. 무작위 시계열에서는 대략 자유도 k의 카이제곱 분포를 따르므로, 카이제곱 임계값보다 훨씬 큰 값은 시계열에 모형화해야 할 시간 패턴이 있다는 뜻입니다. 판매량 예제에서 LBQ는 시차 24에서 228.1로, 36.4를 크게 넘었습니다.
ACF에는 몇 개의 시차를 사용해야 합니까?
비워 두면 도구는 n/4개의 시차를 사용하며, n이 240을 넘으면 n의 제곱근에 45를 더한 값을 사용하고, n - 1을 넘지 않습니다. 계절 데이터는 계절 정점과 그 반복을 볼 수 있도록 최소 두 개의 전체 계절을 선택하십시오. 예를 들어 월별 데이터는 24개 시차입니다.