
자동 공정능력분석(Automated Process Capability)
자동 공정능력분석은 수동 정규성 확인 단계를 없애 줍니다. Anderson-Darling 검정을 실행하여, p-값이 기준(기본값 0.1) 이상이면 정규 Pp, Ppl, Ppu, Ppk를 계산하고, 미만이면 후보 비정규 분포를 최대우도법으로 적합하여 가장 잘 맞는 분포를 고른 뒤 z-점수 방법을 사용합니다. 출력에는 선택한 경로, 적합 히스토그램, 지수, 기대 PPM과 관측 PPM이 표시됩니다.
최종 검토
핵심 요점
자동 공정능력분석은 Anderson-Darling 검정으로 정규성을 검정하고, 정규 모형 또는 가장 적합한 비정규 분포에서 Pp와 Ppk를 자동으로 계산하며 어느 경로를 택했는지 기록합니다.
목적
자동 공정능력분석은 먼저 정규성을 검정한 다음 정규 또는 비정규 공정능력 모형 중 하나를 따로 선택하는 수동 단계를 없애 줍니다. 이 도구는 Anderson-Darling 정규성 검정을 직접 실행하여, 데이터가 통과하면 표준 정규 공정능력 지수로, 통과하지 못하면 앱의 후보 분포 라이브러리에서 선택한 최적 적합 비정규 분포로 계산을 자동으로 보냅니다. 그 결과 상단에 경로 결정이 기록된 하나의 보고서가 만들어집니다.
주요 기능
- Anderson-Darling 정규성 검정을 자동으로 실행하므로 별도의 정규성 확인 단계가 필요 없습니다.
- 정규 가정이 기각되면, 앱의 다른 비정규 공정능력 도구와 동일한 분포 적합 라이브러리를 사용하여 가장 잘 맞는 비정규 후보 분포를 자동으로 선택합니다.
- 정규성 p-값 기준을 설정할 수 있어, 도구가 정규 경로를 기본으로 택하는 보수성의 정도를 조정할 수 있습니다.
- 어느 경로를 택했는지(정규 또는 비정규, 그리고 어떤 분포인지)를 출력에 바로 보고하므로 경로 결정이 투명하고 추적 가능합니다.
- 앱의 다른 공정능력 도구와 마찬가지로 선택 사항인 Factor 열과 “Compare selected columns as separate groups” 모드를 지원합니다.
통계적 방법
정규성은 Anderson-Darling 검정(정규 기준에 대한 scipy의 anderson())으로 평가하며, 표준 소표본 보정 AD = A²·(1 + 0.75/n + 2.25/n²)을 사용합니다. p-값은 보정된 AD 통계량에 대한 D'Agostino–Stephens의 구간별 경험적 근사식에서 구합니다.
선택 규칙은 다음과 같습니다. Anderson-Darling p-값이 정규성 p-값 기준(기본값 0.1) 이상이면 도구는 데이터를 정규로 간주하여, 이동 범위 방법(MRbar/d2 또는 이동 범위 중앙값 변형)으로 σ_overall을 추정하고 이를 이용해 z 기반의 표준 성능 지수 Pp, Ppl, Ppu, Ppk를 계산합니다. p-값이 기준 미만이면 앱이 지원하는 각 후보 비정규 분포(Weibull, 3-모수 Weibull, 지수, 2-모수 지수, 감마, 로지스틱, 로그 로지스틱, 로그 정규, 최소/최대 극값 분포)를 최대우도법으로 적합하고, 적합도 순으로 순위를 매겨 가장 잘 맞는 분포를 자동으로 선택합니다.
비정규 경로에서는 선택한 분포의 CDF를 LSL과 USL에서 계산하여 꼬리 확률 p_lsl과 p_usl을 구하고, 이를 역정규 CDF(norm.ppf)로 등가의 표준 정규 z-점수로 변환합니다. 이것이 “z-점수 방법”입니다. 이후 이 z-점수를 사용하여 익숙한 Cpk 척도로 공정능력을 보고합니다. Pp = (z_usl − z_lsl) / 6, PPL = −norm.ppf(p_lsl) / 3, PPU = norm.ppf(p_usl) / 3, Ppk = min(PPL, PPU)입니다. 따라서 비정규 데이터에 원래의 정규 Z-점수를 잘못 적용하는 대신, 치우친 분포의 실제 꼬리 위험을 반영한 뒤 앱 전반에서 사용하는 Cpk와 유사한 단위로 나타냅니다.
PPM(백만 개당 부적합 수) 수치는 두 가지로 보고합니다. “expected” PPM은 적합 분포에서 각 규격 한계 밖의 꼬리 확률로 구하고, “observed” PPM은 원 표본에서 규격 한계 밖에 실제로 놓인 비율을 단순히 세어 구합니다.
입력 항목 및 옵션
항목 | 설명 |
Choose columns | 분석할 반응 열입니다. |
Factor | 선택 사항입니다. 데이터가 하나의 Response 열과 하나의 Factor 열로 구성된 경우 집단 간 공정능력을 비교합니다. |
Compare selected columns as separate groups | 2개 이상의 열을 선택하면 각 열에 대해 공정능력을 따로 실행하고 나란히 비교합니다. |
LSL / USL | 선택한 모든 열에 적용되는 규격 하한과 규격 상한입니다. |
Normality p-value threshold | 기본값은 0.1입니다. Anderson-Darling p-값이 이 값 이상이면 정규를 가정하여 공정능력을 계산하고, 미만이면 가장 잘 맞는 비정규 분포를 자동으로 선택하여 대신 사용합니다. |
Download as Excel | 선택 사항입니다. 보고서를 Excel 통합 문서로 내보냅니다. |
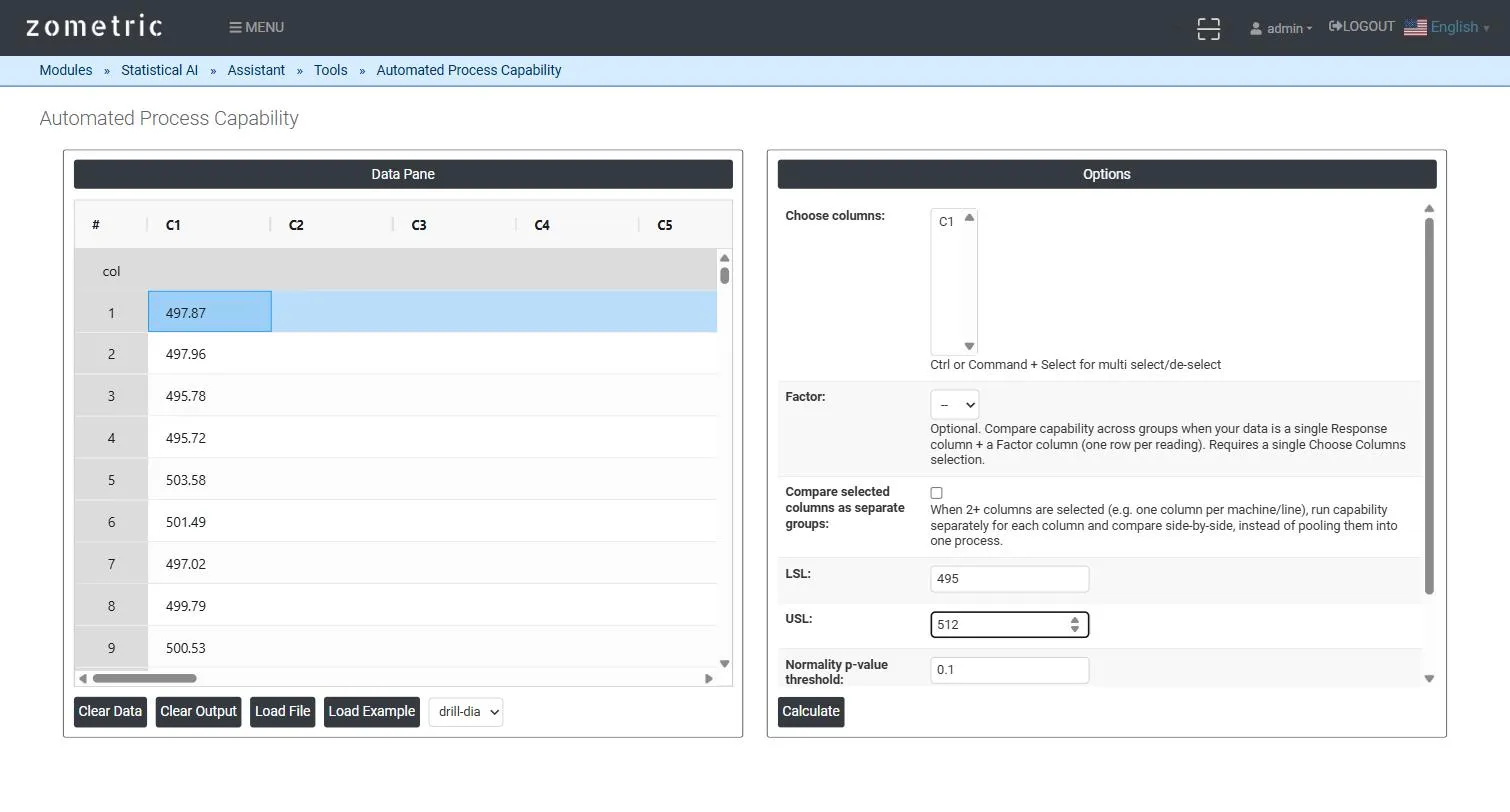
그림 1 — C1에 붙여넣은 충전 중량 측정값 60개와, Options 패널에 입력한 LSL/USL 및 Normality p-value threshold.
출력 설명
- 정규성 검정 결과 — Anderson-Darling 통계량과 p-값, 그리고 선택한 경로(정규 또는 자동으로 선택된 특정 비정규 분포).
- 적합 분포의 히스토그램 — 표본 히스토그램 위에 적합 밀도 곡선과 LSL/USL 기준선을 겹쳐 표시합니다.
- 분포 모수 표 — LSL, USL, 표본 평균, 표본 크기, 그리고 적합 분포의 형상/척도(또는 이에 상응하는) 모수.
- 공정능력 지수 — 선택된 분포로부터 계산한 Pp, Ppl, Ppu, Ppk.
- PPM 표 — 기대 PPM(적합 분포의 꼬리에서 구함)과 관측 PPM(원 표본에서 구함)이며, 각각 PPM < LSL, PPM > USL, PPM Total로 나뉩니다.
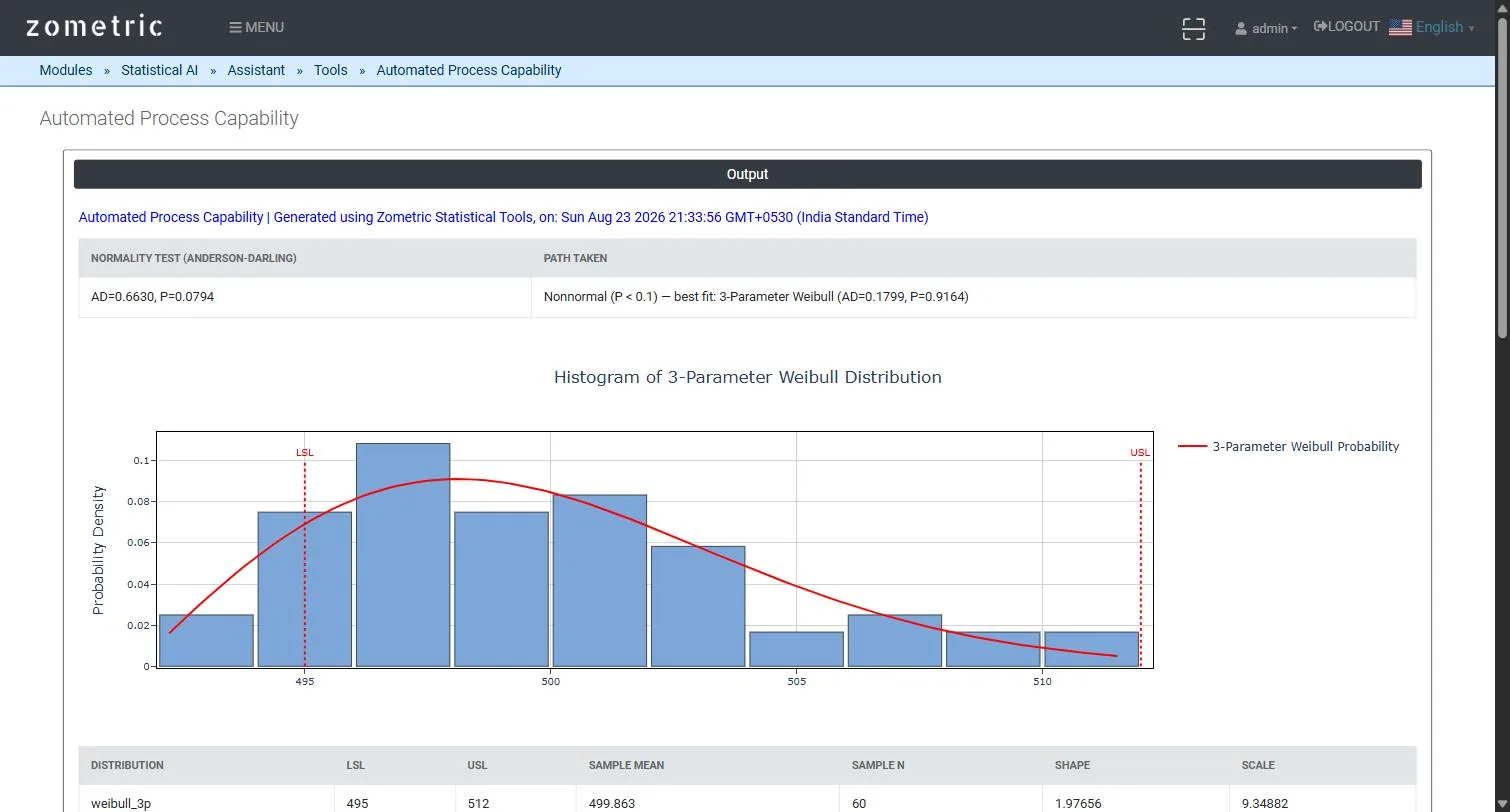
그림 2 — 분포 모수와 그에 따른 Pp/Ppl/Ppu/Ppk 지수, 그리고 기대 PPM과 관측 PPM 표.
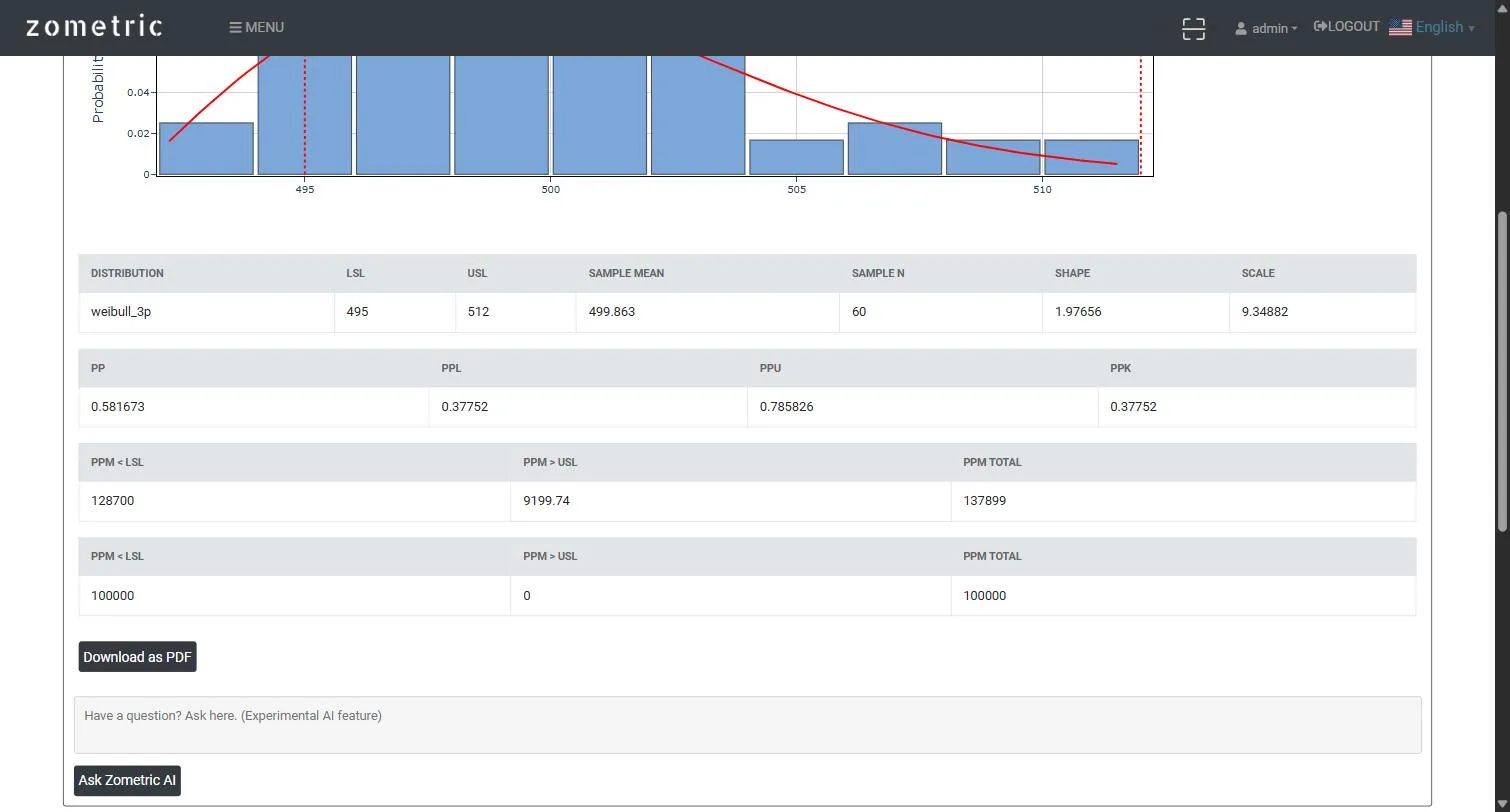
그림 3 — 자동 경로 결정(Anderson-Darling 결과와 선택한 경로)과 적합 분포 히스토그램.
계산 예제
충전 라인에서 점성이 있는 세정액을 병에 채우며, 한 교대 동안 뽑은 병 60개의 충전 중량(g)을 측정합니다(열 C1). LSL = 495 g, USL = 512 g입니다. 기본 기준 0.1에서 Anderson-Darling 검정 결과는 AD = 0.6630, P = 0.0794로 기준 미만이므로, 도구는 자동으로 비정규 경로를 택하여 3-모수 Weibull 적합(AD = 0.1799, P = 0.9164)을 가장 잘 맞는 분포로 선택합니다. 그리고 (오해를 부를 수 있는) 정규분포 가정이 아니라 적합된 Weibull의 꼬리 확률로부터 Ppk = 0.378을 보고합니다.
자주 묻는 질문
자동 공정능력분석은 무엇을 합니까?
데이터에 Anderson-Darling 정규성 검정을 실행한 다음 공정능력 계산을 자동으로 보냅니다. 데이터가 통과하면 표준 정규 공정능력 지수로, 통과하지 못하면 가장 잘 맞는 비정규 분포로 보냅니다. 하나의 보고서에 정규성 결과, 선택한 경로, 사용한 분포가 표시되므로 경로 결정이 투명하고 추적 가능합니다.
도구는 정규와 비정규 공정능력 중 무엇을 어떻게 결정합니까?
Anderson-Darling p-값이 정규성 p-값 기준(기본값 0.1) 이상이면 데이터를 정규로 간주합니다. 기준 미만이면 Weibull, 3-모수 Weibull, 감마, 로그 정규 등의 후보 분포를 최대우도법으로 적합하고, 적합도 순으로 순위를 매겨 가장 잘 맞는 분포를 선택합니다.
비정규 데이터의 Ppk는 어떻게 계산합니까?
선택한 분포의 CDF로 LSL과 USL 밖의 꼬리 확률을 구하고, 이를 등가의 표준 정규 z-점수로 변환합니다. 그런 다음 PPL = -z(p_lsl)/3, PPU = z(p_usl)/3, Ppk = min(PPL, PPU)로 계산합니다. 이렇게 하면 치우친 분포의 실제 꼬리 위험을 반영하면서도 결과를 익숙한 Cpk와 유사한 척도로 유지할 수 있습니다.
Zometric Statistical Software에서 자동 공정능력분석은 어떻게 실행합니까?
데이터를 붙여넣고, 반응 열을 선택하며, 필요하면 Factor 또는 열을 별도 집단으로 비교하는 옵션을 선택한 뒤 LSL과 USL을 입력합니다. Normality p-value threshold(기본값 0.1)를 설정합니다. 보고서에는 경로 결정, 적합 히스토그램, 분포 모수, 공정능력 지수, PPM 표가 표시되며 Excel로 내보낼 수 있습니다.