
최적 부분집합 회귀분석(Best Subsets Regression)
최적 부분집합 회귀분석(Best Subsets Regression)은 자유 예측변수의 모든 부분집합에 대해 보통 최소제곱 모형을 적합하며, 일부를 모든 모형에 강제로 포함할 수도 있고, 크기별로 최적 모형을 1개에서 5개까지 보여 줍니다. 각 행은 R-Sq, R-Sq(adj), R-Sq(pred), Mallows' Cp, S를 보고하며, PRESS, AICc, BIC, VIF는 선택 사항입니다. 연구 초기에 예측변수를 추리는 데 사용한 뒤, 선택한 모형은 Fit Regression Model로 적합합니다.
최종 검토
핵심 요점
최적 부분집합 회귀분석은 후보 예측변수의 모든 조합에 대해 선형 회귀를 적합하고 크기별 최적 모형을 나열하여, 반응 변동 대부분을 설명하는 가장 작은 집합을 찾도록 돕습니다.
목적
최적 부분집합 회귀분석(Best Subsets Regression)은 후보 예측변수의 모든 조합에 대해 선형 회귀를 적합하고 크기별 최적 모형을 나란히 나열합니다. 연구 초기에 공정 설정 후보가 여러 개 있고 반응 변동 대부분을 설명하는 가장 작은 집합을 찾고자 할 때, 선택한 모형을 Fit Regression Model로 자세히 적합하기 전에 사용합니다.
주요 기능
- 자유 예측변수의 모든 부분집합을, 설정한 최소 개수부터 최대 개수까지 적합합니다.
- 크기별로 R-Sq 기준 최적 모형을 1개에서 5개까지 보여 줍니다.
- 모든 모형에 대해 R-Sq, R-Sq(adj), R-Sq(pred), Mallows' Cp, S를 보고하며, 요청 시 PRESS, AICc, BIC도 제공합니다.
- Predictors in all models: 중요하다고 알고 있는 변수를 모든 부분집합에 강제로 포함합니다.
- Enhanced tables는 각 모형에서 각 예측변수의 분산 팽창 계수(VIF)를 추가하여, 서로 상관된 예측변수를 찾아냅니다.
- 절편이 있는 모형과 없는 모형을 모두 지원합니다.
통계적 방법
반응 또는 선택한 예측변수에 결측값이나 숫자가 아닌 값이 있는 행은 제외됩니다. 최소 크기부터 최대 크기까지 각 부분집합 크기에 대해, 도구는 그 개수만큼의 자유 예측변수(강제 포함 예측변수 추가)의 모든 조합에 대해 보통 최소제곱 모형을 적합하고, R-Sq 기준으로 정렬하여 크기별 상위 모형을 유지합니다. 자유 예측변수가 p개이면 부분집합은 2ᵖ − 1개이므로, 후보가 하나 늘 때마다 적합 횟수가 두 배가 됩니다.
n개 행에 적합한 k개 계수(상수항 포함)의 모형에서: S = √MSE이고, R-Sq(adj)는 항의 개수에 대해 R-Sq를 보정한 값입니다. PRESS = Σ (eᵢ / (1 − hᵢ))²는 레버리지 hᵢ를 사용한 하나씩 제외(leave-one-out) 예측 오차의 제곱합이며, R-Sq(pred) = 1 − PRESS / SS Total입니다. Mallows' Cp = SSE / MSE(full) − (n − 2k)이며, MSE(full)은 모든 예측변수를 포함한 모형의 오차 평균 제곱입니다. 치우침이 작은 모형은 Cp가 k에 가깝고, 전체 모형은 항상 Cp = k입니다. AICc = −2 log L + 2(k+1) + 2(k+1)(k+2)/(n − k − 2), BIC = −2 log L + (k+1) ln n이며 σ를 모수로 계산합니다. PRESS, AICc, BIC는 작을수록 좋습니다.
R-Sq(adj)와 R-Sq(pred)가 더 이상 오르지 않고, Cp가 계수의 개수에 가까우며, S가 작은 모형을 찾습니다. R-Sq와 R-Sq(pred) 사이의 큰 차이는 과적합을 경고합니다. 최적 부분집합은 적합도만 비교합니다. 선택한 모형의 잔차와 계수는 Fit Regression Model에서 확인하십시오.
입력 항목 및 옵션
항목 | 설명 |
Response (Y) | 설명 대상인 숫자 열입니다. 필수입니다. |
Free predictors | 숫자형 후보 예측변수이며, 모든 조합을 시도합니다. 필수입니다. Ctrl 또는 Command + 클릭으로 여러 개를 선택합니다. |
Predictors in all models (optional) | 모든 모형에 포함되는 숫자형 예측변수입니다. 자유 예측변수와 중복될 수 없습니다. |
Models of each size to display | 크기별로 나열할 최적 모형의 개수이며 1에서 5까지입니다. 기본값은 2입니다. |
Display PRESS / Display AICc / Display BIC | 표에 이 열들을 추가합니다. 기본값은 꺼짐입니다. |
Free Predictors: Minimum / Maximum | 모형에 포함되는 자유 예측변수의 최소 및 최대 개수입니다. 기본값은 1부터 전체까지입니다. |
Fit intercept | 기본값은 선택됨입니다. 선택을 해제하면 원점을 지나는 모형을 적합합니다(이때 R-Sq는 중심화되지 않음). |
Display of results | Simple tables(기본값) 또는 각 예측변수의 VIF 열을 추가하는 Enhanced tables입니다. |
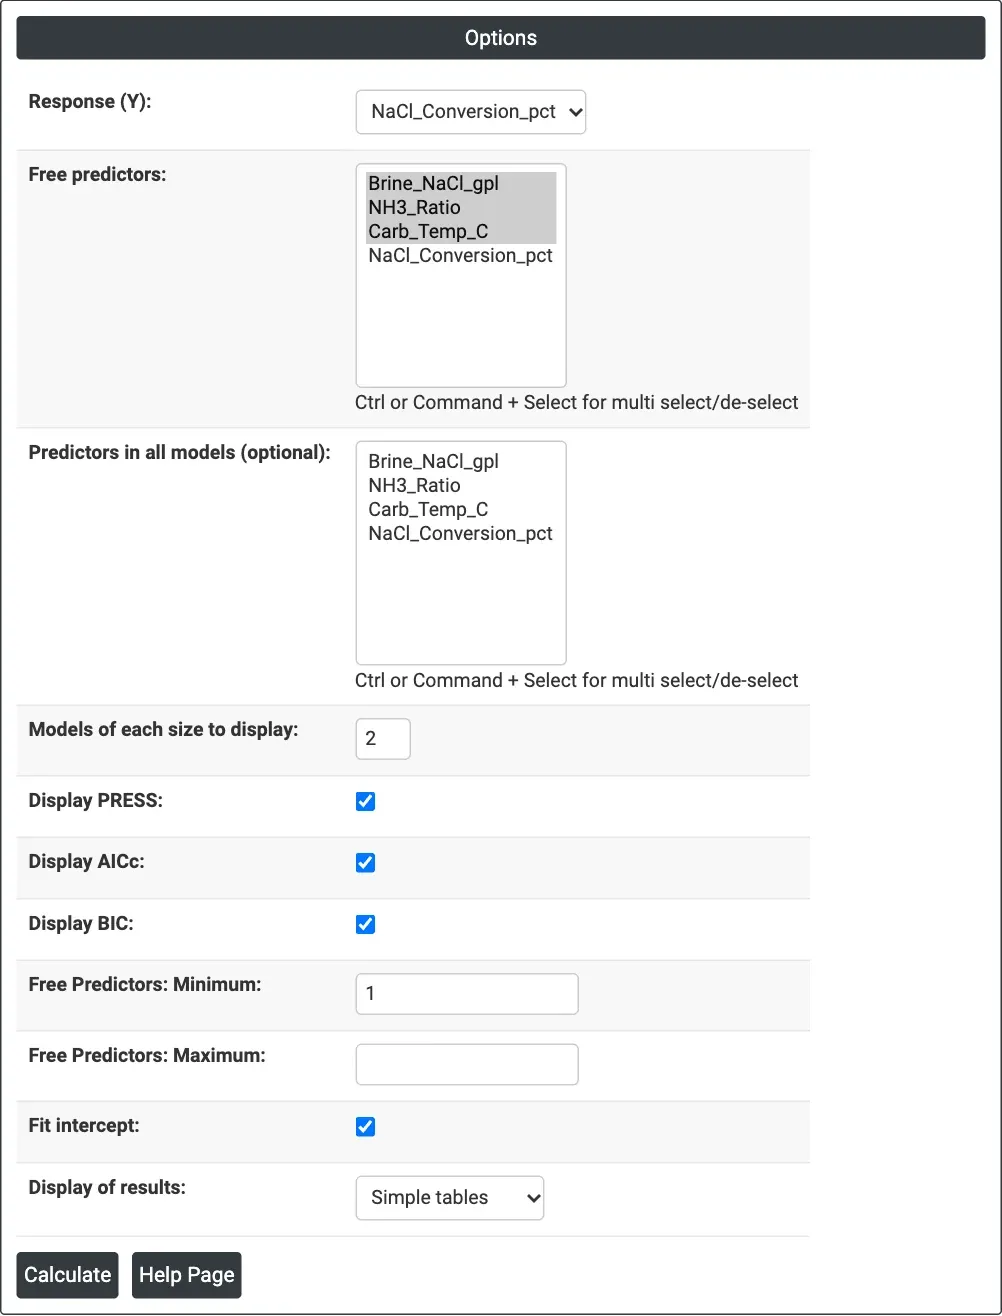
그림 1 — 소다회 예제의 옵션: NaCl_Conversion_pct를 반응으로, 세 가지 공정 설정을 자유 예측변수로 지정하고 PRESS, AICc, BIC를 표시합니다.
출력 설명
- Response line — 반응과 모든 모형에 강제로 포함된 예측변수의 이름을 표시합니다.
- Best Subsets Results table — 모형당 한 행입니다. Vars(자유 예측변수의 개수), R-Sq, R-Sq(adj), R-Sq(pred), Mallows' Cp, S, 선택 사항인 PRESS, AICc, BIC, 그리고 모형에 포함된 각 예측변수 아래의 X를 표시하며, Enhanced tables에서는 모형에 포함된 각 예측변수의 VIF를 표시합니다.
- Download를 통한 PDF 내보내기.
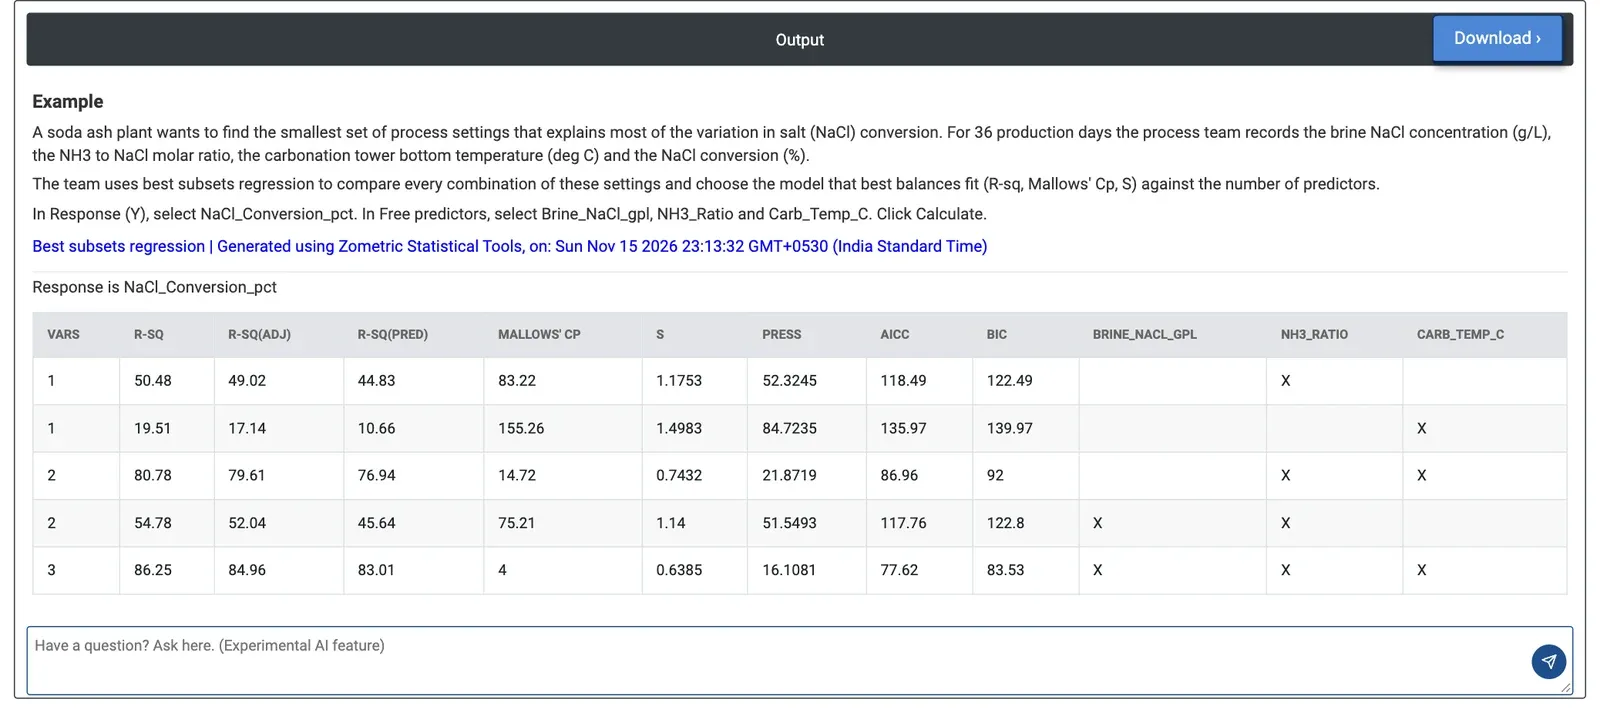
그림 2 — NaCl 전환율의 최적 부분집합 결과: 예측변수 3개 모형은 R-Sq 86.25%, R-Sq(pred) 83.01%, Cp 4, S 0.6385입니다.
계산 예제
한 소다회 공장은 어떤 공정 설정이 일별 NaCl 전환율(%)을 설명하는지 알고자 합니다. 팀은 36일의 생산 기간 동안 브라인 NaCl 농도(Brine_NaCl_gpl), NH3 대 NaCl 몰비(NH3_Ratio), 탄산화 탑 하부 온도(Carb_Temp_C)를 기록합니다. NaCl_Conversion_pct를 반응으로, 세 가지 설정을 자유 예측변수로 선택하고, 크기별로 모형 2개를 유지하며 Display PRESS, AICc, BIC를 선택합니다.
단독으로는 NH3 비율이 가장 좋은 단일 예측변수이지만 변동의 50.48%만 설명합니다(Cp 83.22). 탄산화 온도를 추가하면 R-Sq가 80.78%로 올라가고 S가 1.1753에서 0.7432 퍼센트포인트로 줄지만, Cp는 여전히 14.72로 이 모형의 계수 3개보다 훨씬 크므로 무언가 빠져 있습니다. 세 설정을 모두 포함하면 R-Sq는 86.25%, R-Sq(pred)는 83.01%, S는 0.6385이며 PRESS, AICc, BIC는 표에서 가장 낮습니다(16.1081, 77.62, 83.53). R-Sq와 R-Sq(pred)의 차이가 작아 모형이 과적합되지 않았음을 보여 줍니다.
팀은 세 설정을 모두 유지하고 Fit Regression Model로 적합합니다. Enhanced tables를 선택하면 VIF가 1.01에서 1.03으로 나타나므로, 세 설정은 함께 변하지 않았으며 각 효과를 독립적으로 해석할 수 있습니다.
자주 묻는 질문
최적 부분집합 회귀분석이란 무엇입니까?
최적 부분집합 회귀분석은 후보 예측변수의 모든 조합에 대해 선형 회귀를 적합하고 크기별 최적 모형을 R-Sq 순으로 나란히 나열합니다. 연구 초기에 반응 변동 대부분을 설명하는 가장 작은 예측변수 집합(예: 공정 설정)을 찾는 데 사용합니다.
최적 부분집합 출력에서 최선의 모형은 어떻게 선택합니까?
R-Sq(adj)와 R-Sq(pred)가 더 이상 오르지 않고, Mallows' Cp가 계수의 개수에 가까우며, S가 작은 모형을 찾습니다. PRESS, AICc, BIC는 작을수록 좋습니다. R-Sq와 R-Sq(pred) 사이의 큰 차이는 과적합을 경고합니다. 그다음 선택한 모형의 잔차와 계수를 Fit Regression Model에서 확인합니다.
최적 부분집합 회귀분석에서 Mallows' Cp는 무엇을 의미합니까?
Mallows' Cp는 모형의 오차를 모든 예측변수를 포함한 전체 모형의 오차와 비교합니다. 치우침이 작은 모형은 Cp가 k, 즉 상수항을 포함한 계수의 개수에 가깝고, 전체 모형은 항상 Cp가 k와 같습니다. 예제에서 계수 3개 모형의 Cp 14.72처럼 Cp가 k보다 훨씬 크면 중요한 예측변수가 빠져 있음을 시사합니다.
최적 부분집합 회귀분석은 모형을 몇 개 적합합니까?
자유 예측변수가 p개이면 부분집합은 2의 p제곱 빼기 1개이므로, 후보 예측변수가 하나 늘 때마다 적합 횟수가 두 배가 됩니다. 모형당 자유 예측변수의 최소 및 최대 개수를 제한하고, 알려진 예측변수를 모든 모형에 강제로 포함하며, 크기별로 표시할 최적 모형의 개수를 1에서 5까지 선택할 수 있습니다.