
카이제곱 적합도 검정(Chi Square Goodness Of Fit)
카이제곱 적합도 검정은 범주형 변수의 관측 도수 분포가 특정 기대 분포와 일치하는지를 판정합니다. 데이터에서 각 범주가 실제로 나타나는 횟수를, 이론적 모형이나 사전 가정에 따라 각 범주가 나타날 것으로 기대되는 횟수와 비교합니다.
최종 검토
핵심 요점
카이제곱 적합도 검정은 범주형 변수의 관측 도수 분포가 특정 기대 분포와 일치하는지를 판정합니다.
이 페이지 내용
카이제곱 적합도 검정이란?
카이제곱 적합도 검정은 범주형 변수의 관측 도수 분포가 특정 기대 분포와 일치하는지를 판정합니다. 데이터에서 각 범주가 실제로 나타나는 횟수를, 이론적 모형이나 사전 가정에 따라 각 범주가 나타날 것으로 기대되는 횟수와 비교합니다.
예를 들어 생산 라인이 모든 교대조에서 결점을 동일하게 발생시키는지, 또는 고객 불만이 모형이 예측한 비율대로 범주에 분포하는지를 검정할 수 있습니다.
쉬운 정의: 범주별로 관측한 실제 도수가 기대한 도수와 일치하는지 확인하여, 데이터가 예측한 패턴에 맞는지 알려 주는 검정입니다.
카이제곱 적합도 검정은 언제 사용합니까?
- 반응 변수가 범주형 이고 그 관측 분포가 기대 분포 또는 이론적 분포와 일치하는지 검정하려는 경우에 사용합니다.
- 교대조, 기계, 제품 유형 같은 범주 전반에 걸쳐 공정이 기대한 비율로 결점이나 결과를 발생시키는지 를 확인할 때 사용합니다.
- 다음의 경우에 사용합니다: 이론적 모형 또는 사전 분포 가 있고 실제 데이터가 이에 얼마나 잘 부합하는지 검정하려는 경우.
- 기대 도수를 규격이나 과거 데이터로 알고 있는 샘플링 감사, 적합성 점검, 품질 검토 에 사용합니다.
카이제곱 적합도 검정의 올바른 사용 지침
- 각 범주의 기대 도수는 5 이상 이어야 합니다. 기대 도수가 매우 작은 범주가 있으면 검정을 신뢰할 수 없습니다. 필요하면 범주를 합치십시오.
- 관측값은 독립 이어야 합니다. 한 범주의 도수가 다른 범주의 도수에 영향을 주어서는 안 됩니다.
- 기대 비율 또는 기대 도수는 데이터를 보기 전에 지정 해야 합니다. 검정하는 같은 데이터 집합에서 도출하면 순환 논리가 되어 타당하지 않습니다.
- 관측 분포가 기대 분포와 유의하게 다르다는 뜻이므로, p-값이 0.05 미만 이면 어느 범주에서 편차가 가장 큰지 조사하십시오.
- 모든 기대 셀 도수가 최소 기준인 5를 충족하도록 충분히 큰 전체 표본 을 수집하십시오.
대안: 카이제곱 적합도 검정을 사용하지 않아야 할 때
- 검정하려는 대상이 두 범주형 변수 간의 관계인 경우에는 다음을 사용하십시오: 카이제곱 독립성 검정
- 반응 변수가 연속형인 경우에는 다음을 사용하십시오: 정규성 검정 또는 개별 분포 식별
- 계수 데이터가 포아송 과정 (시간 또는 영역에 걸친 희소 사건)을 따르는 경우에는 다음을 사용하십시오: 포아송 적합도 검정
카이제곱 적합도 검정 예제
한 구매 관리자가 판매된 티셔츠 사이즈별 비율을 주문한 비율과 비교하려고 합니다. 관리자는 일주일 동안 판매된 사이즈별 티셔츠 수를 셉니다. 구매 담당자는 카이제곱 적합도 검정을 수행하여 판매된 티셔츠 사이즈 비율이 주문한 사이즈 비율과 일치하는지 판정합니다. 검정은 다음 단계로 수행합니다.
- 필요한 데이터를 수집했습니다.
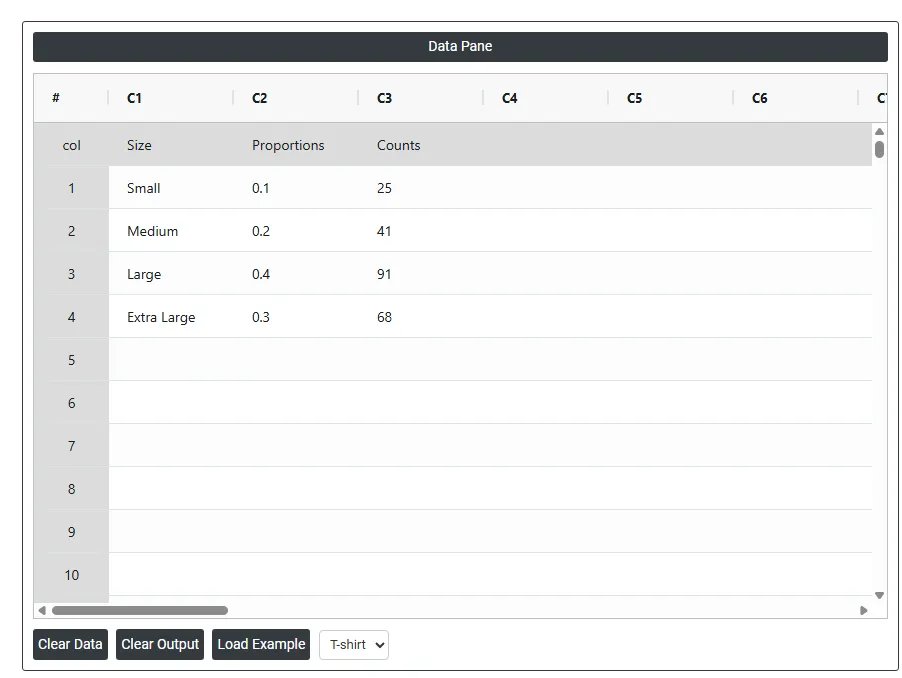
- 이제 Zometric Statistical Software에서 데이터를 분석합니다: https://statsai.zometric.com/.
- 카이제곱 적합도 검정을 찾으려면 다음을 선택합니다: Statistical module> Hypothesis Test> Chi Square Goodness Of Fit.
- 도구 안에서 데이터와 기타 입력값을 다음과 같이 입력합니다.
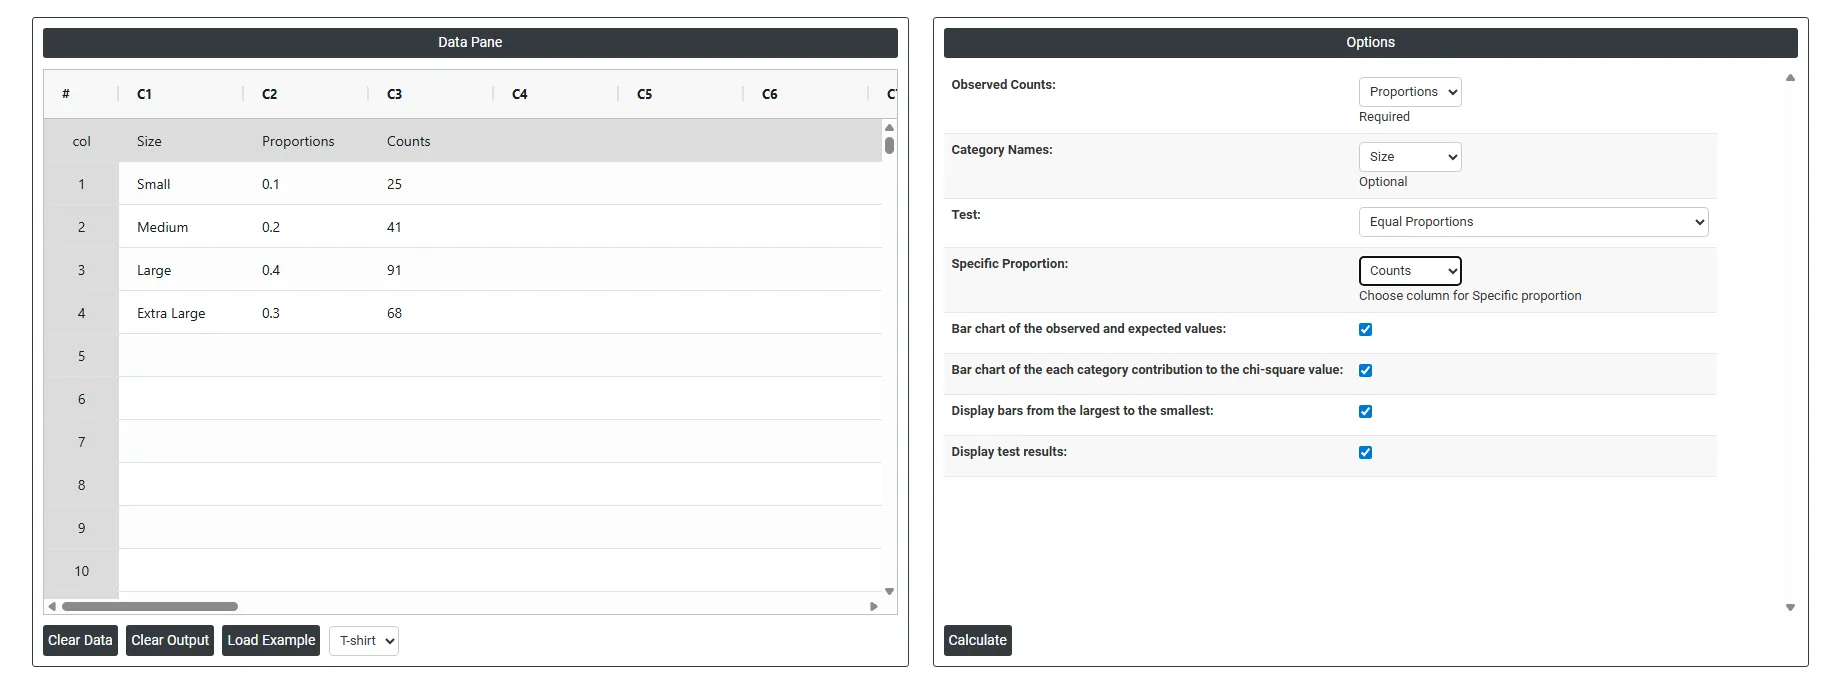
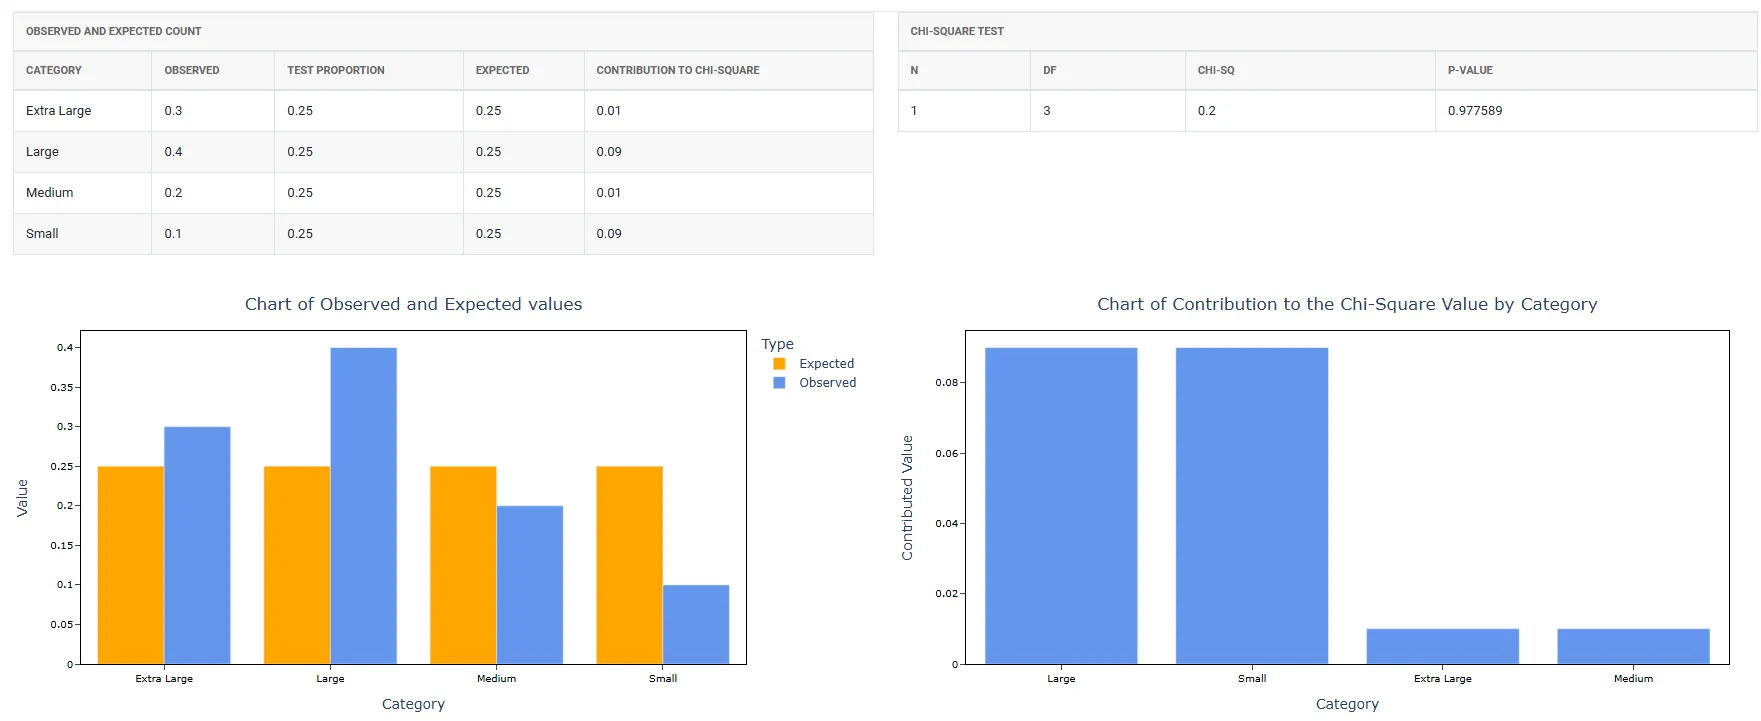
5. 위 도구를 사용하면 다음과 같은 출력을 얻습니다.
카이제곱 적합도 검정 방법
절차는 다음과 같습니다.
- Zometric Statistical Software에 로그인합니다: https://statsai.zometric.com/
- 홈 페이지에서 Statistical Tool> Hypothesis Test >Chi Square Goodness Of Fit를 선택합니다.
- 다음으로, 데이터를 직접 입력하거나 Excel 시트에서 데이터 전체를 복사(Ctrl+C)하여 붙여넣습니다(Ctrl+V).
- 필요한 옵션을 입력합니다.
- 마지막으로, 페이지 하단의 calculate를 클릭하면 원하는 결과를 얻을 수 있습니다.
카이제곱 적합도 검정 도구 화면은 두 부분으로 나뉩니다.
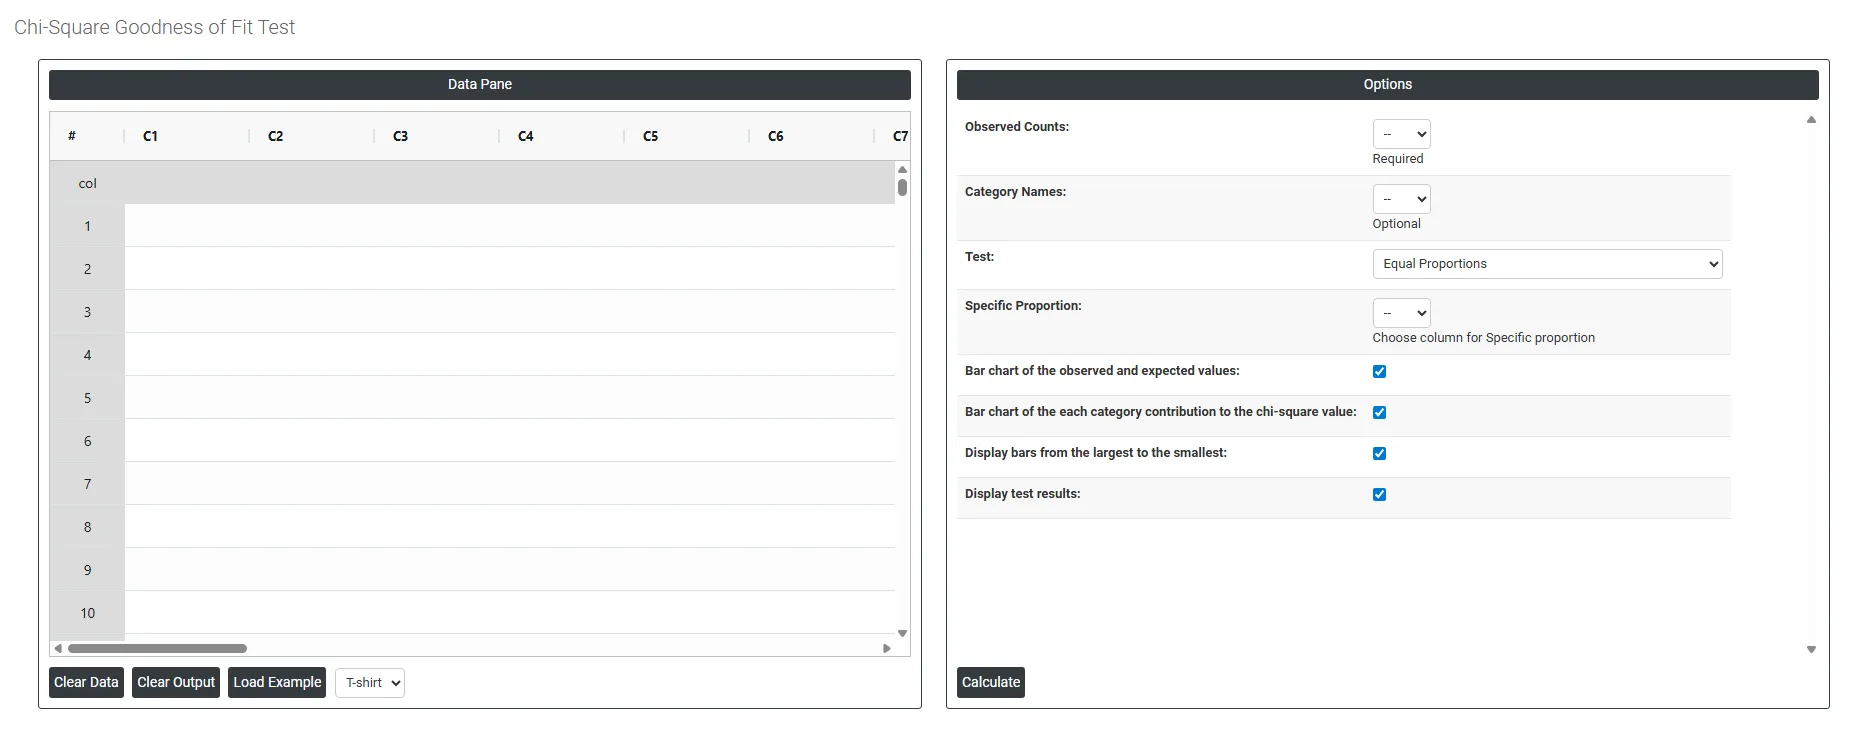
왼쪽 부분에는 데이터 창(Data Pane)이 있습니다. Data Pane에서는 각 행이 하나의 부분군이 됩니다. 데이터를 직접 입력하거나 Excel 시트에서 데이터 전체를 복사(Ctrl+C)하여 여기에 붙여넣을(Ctrl+V) 수 있습니다.
Load example: 예제 데이터가 로드됩니다.
Load File: Excel 데이터를 직접 로드하는 데 사용합니다.
오른쪽 부분에는 다음과 같은 여러 옵션이 있습니다.
- Observed Counts 데이터의 각 범주에 대해 기록된 실제 도수 가 들어 있는 열을 선택합니다. 예를 들어 교대조별로 관측된 결점 수, 범주별 고객 불만 수, 집단별 발생 횟수 등입니다. 이것은 실제로 일어난 일과 기대한 일을 비교하는 데 검정이 사용하는 핵심 입력값입니다. 이 필드는 필수입니다.
- Category Names; 각 범주의 레이블 또는 이름 이 들어 있는 열을 선택합니다. 예를 들어 Shift 1, Shift 2, Shift 3 또는 Scratch, Dent, Tear입니다. 선택 사항이지만, 출력 그래프와 결과 표에 레이블이 분명히 붙어 해석하고 보고서에 제시하기 쉬워지므로 권장합니다.
- Test: 관측 도수를 어떤 기대 분포와 비교할지 정의합니다. 세 가지 옵션이 있습니다.
- Equal Proportions — 모든 범주가 같은 빈도로 나타나는지 검정합니다. 귀무가설이 각 범주가 같은 횟수로 나타나야 한다는 것일 때 사용합니다. 예를 들어 결점이 요일 전반에 고르게 분포하는지 검정하는 경우입니다.
- Specific Proportions — 직접 입력한 특정한 사전 정의 비율로 범주가 나타나는지 검정합니다. 이론, 과거 데이터 또는 규격에 근거한 기대 분포가 있을 때 사용합니다. 예를 들어 결과의 60%가 범주 A, 30%가 범주 B, 10%가 범주 C에 속하는지 검정하는 경우입니다.
- Properties Specified by Historical Counts (Input Column) — 직접 입력한 값이 아니라 과거 도수의 기준 열에서 도출한 기대 비율에 대해 검정합니다. 현재 데이터의 분포를 비교하려는 이전 데이터 집합이나 기준 기간이 있을 때 사용합니다.
- Specific Proportion: Specific Proportions 또는 Historical Counts 검정 옵션을 사용할 때 각 범주의 기대 비율 또는 기준 도수 가 들어 있는 열을 선택합니다. 이 열의 값은 귀무가설 하에서 분포가 어떠해야 하는지를 정의하며, 각 범주의 기대 비율은 Observed Counts 열의 범주와 순서대로 대응해야 합니다.
- Bar Chart of Observed and Expected Values: 사용하면 각 범주의 관측 도수와 기대 도수 를 나란히 비교하는 막대 그래프를 표시합니다. 가장 유용한 시각적 출력 중 하나로, 관측값과 기대값의 차이가 가장 큰 범주가 즉시 분명해져 분포가 가장 크게 벗어나는 곳을 짚어 내는 데 도움이 됩니다.
- Bar Chart of Each Category Contribution to the Chi-Square Value: 사용하면 각 개별 범주가 전체 카이제곱 통계량에 기여하는정도를 보여 주는 막대 그래프를 표시합니다. 막대가 가장 높은 범주가 유의한 결과를 이끄는 범주이며, 전체적으로 차이가 있다는 사실만이 아니라 기대 분포에서 벗어나는 데 가장 큰 책임이 있는 범주를 정확히 파악하는 데 도움이 됩니다.
- Display Bars from Largest to Smallest: 사용하면 그래프의 막대를 가장 큰 기여도 또는 도수에서 가장 작은 것까지 내림차순 으로 정렬합니다. 어느 범주가 가장 중요한지 우선순위를 정하고 가장 큰 편차에 먼저 주의를 기울이기 쉬워지며, 범주가 많고 가장 유의한 범주를 빠르게 찾으려는 경우에 특히 유용합니다.
- Display Test Results: 사용하면 전체 통계 검정 출력을 그래프 위나 옆에 바로 표시하며, 카이제곱 통계량, 자유도, p-값이 포함됩니다. 별도의 출력 표를 참조하지 않고도 시각적 결과와 통계적 결과를 한곳에서 함께 볼 수 있습니다.
자주 묻는 질문
카이제곱 적합도 검정은 무엇을 알려 줍니까?
범주형 변수의 관측 도수 분포가 특정 기대 분포와 일치하는지를, 각 범주가 실제로 나타나는 횟수를 이론적 모형이나 사전 가정에 따라 나타나야 하는 횟수와 비교하여 알려 줍니다. p-값이 0.05 미만이면 유의한 차이가 있다는 뜻이며, 이 경우 어느 범주에서 편차가 가장 큰지 조사합니다.
카이제곱 적합도 검정의 가정은 무엇입니까?
각 범주의 기대 도수는 5 이상이어야 하며, 필요하면 범주를 합치고 충분히 큰 전체 표본을 수집합니다. 관측값은 독립이어야 하므로 한 범주의 도수가 다른 범주에 영향을 주어서는 안 됩니다. 같은 데이터 집합에서 도출하면 순환 논리가 되어 타당하지 않으므로, 기대 비율은 데이터를 보기 전에 지정해야 합니다.
어떤 기대 분포에 대해 검정할 수 있습니까?
Zometric Statistical Software의 Test 옵션은 세 가지를 제공합니다. 모든 범주가 같은 빈도로 나타나야 하는 Equal Proportions, 이론, 과거 데이터 또는 규격에 근거하여 직접 입력하는 Specific Proportions, 그리고 현재 데이터를 이전 데이터 집합이나 기준 기간과 비교하기 위해 기준 열의 과거 도수로 지정하는 비율입니다.
카이제곱 독립성 검정은 언제 대신 사용해야 합니까?
하나의 범주형 변수를 기대 분포와 비교할 때는 적합도 검정을 사용합니다. 두 범주형 변수 간의 관계를 검정하려면 카이제곱 독립성 검정을 사용하십시오. 반응이 연속형이면 정규성 검정 또는 개별 분포 식별을 사용하고, 도수가 포아송 과정을 따르면 포아송 적합도 검정을 사용하십시오.