
카이제곱 독립성 검정(교차 분류)
카이제곱 독립성 검정은 요약된 이원 도수표 또는 원시 레코드로부터 두 범주형 변수가 연관되어 있는지 검정합니다. 독립일 때의 기대 도수와 관측 도수를 비교하며, 자유도 (r − 1)(c − 1)의 Pearson 카이제곱과 우도비 카이제곱을 사용합니다. 기여도와 수정 잔차는 어느 셀이 결과를 좌우하는지 보여 줍니다. 기대 도수가 너무 작아서는 안 됩니다.
최종 검토
핵심 요점
카이제곱 독립성 검정은 두 범주형 변수가 서로 관련되어 있는지, 예를 들어 결점 유형의 구성이 교대조, 공급업체 또는 라인에 따라 달라지는지 확인하고, 어느 셀이 연관성을 만드는지 보여 줍니다.
목적
카이제곱 독립성 검정은 두 범주형 변수가 서로 관련되어 있는지, 예를 들어 결점 유형의 구성이 교대조, 공급업체 또는 라인에 따라 달라지는지 확인합니다. 이미 요약한 도수표를 입력하거나 단위당 한 행으로 된 원시 레코드를 입력하면, 도구가 연관성을 검정하고 어느 셀이 연관성을 만드는지 보여 줍니다.
주요 기능
- 요약된 이원표(열 범주마다 한 열, 행 범주마다 한 행) 또는 선택적 도수가 있는 원시 범주형 데이터.
- Pearson 카이제곱 검정과 우도비 카이제곱 검정.
- 기대 도수, 카이제곱 기여도, 원시 잔차, 표준화 잔차, 수정 잔차, 행, 열, 전체 백분율의 선택적 표.
- 선택적 안내 해석: 백분율 프로파일과 % 차이 차트가 있는 요약 보고서, 진단 보고서, 보고 카드.
- Data Options: 분석 전에 행의 일부를 선택합니다.
통계적 방법
행 합계가 Rᵢ, 열 합계가 Cⱼ, 전체 합계가 N인 관측 도수 O의 r × c 표에서, 독립일 때의 기대 도수는 Eᵢⱼ = Rᵢ·Cⱼ / N입니다. Pearson 통계량은 χ² = Σ (O − E)² / E이고, 우도비 통계량은 G² = 2 Σ O·ln(O / E)입니다. 두 통계량 모두 자유도 (r − 1)(c − 1)의 카이제곱 분포와 비교합니다. p-값이 작으면 행 변수와 열 변수가 연관되어 있다는 뜻이며, 열의 구성이 모든 행에서 같지 않습니다.
각 셀의 기여도 (O − E)² / E는 연관성이 어디에서 비롯되는지 보여 줍니다. 원시 잔차는 O − E이고, 표준화 잔차는 (O − E) / √E이며, 수정 잔차는 (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N))로 대략 표준정규분포를 따릅니다. 값이 약 ±2를 넘으면 독립에서 뚜렷하게 벗어난 셀입니다. 원시 데이터의 경우 도구가 먼저 두 열을 교차 분류하며, 도수 열이 있으면 이를 합산하고 빈 셀은 제외합니다. 합계가 0인 행이나 열은 제거해야 합니다. p-값은 기대 도수가 너무 작지 않을 때 신뢰할 수 있으며, 안내 해석에서 이를 확인합니다.
입력 항목 및 옵션
항목 | 설명 |
Data | Summarized data in a two-way table(기본값) 또는 Raw data (categorical variables). |
Columns (one per column-category) | 표 레이아웃: 열 변수의 한 범주에 대한 도수가 들어 있는 두 개 이상의 숫자 열이며, 행 범주마다 한 행입니다. 필수입니다. |
Row labels | 표 레이아웃, 선택 사항: 각 행 범주의 이름이 들어 있는 열이며, 비워 두면 Row 1, Row 2, …가 됩니다. |
Rows / Columns / Frequencies (optional) | 원시 레이아웃: 두 범주형 열과, 각 레코드의 도수가 들어 있는 선택적 열입니다. |
Statistics | Expected cell counts와 Each cell's contribution to chi-square(기본적으로 선택됨), Raw residuals, Standardized residuals, Adjusted residuals, Row percents, Column percents, Total percents. |
Data Options: Subset (optional) | 행 번호 및/또는 조건을 기준으로 Exclude matching rows(기본값) 또는 Include only matching rows를 선택합니다. |
Show guided interpretation | 쉬운 말로 된 Summary, Diagnostic, Report Card를 추가합니다. Difference between the % defectives with practical value는 이를 위한 선택적 입력값입니다. |
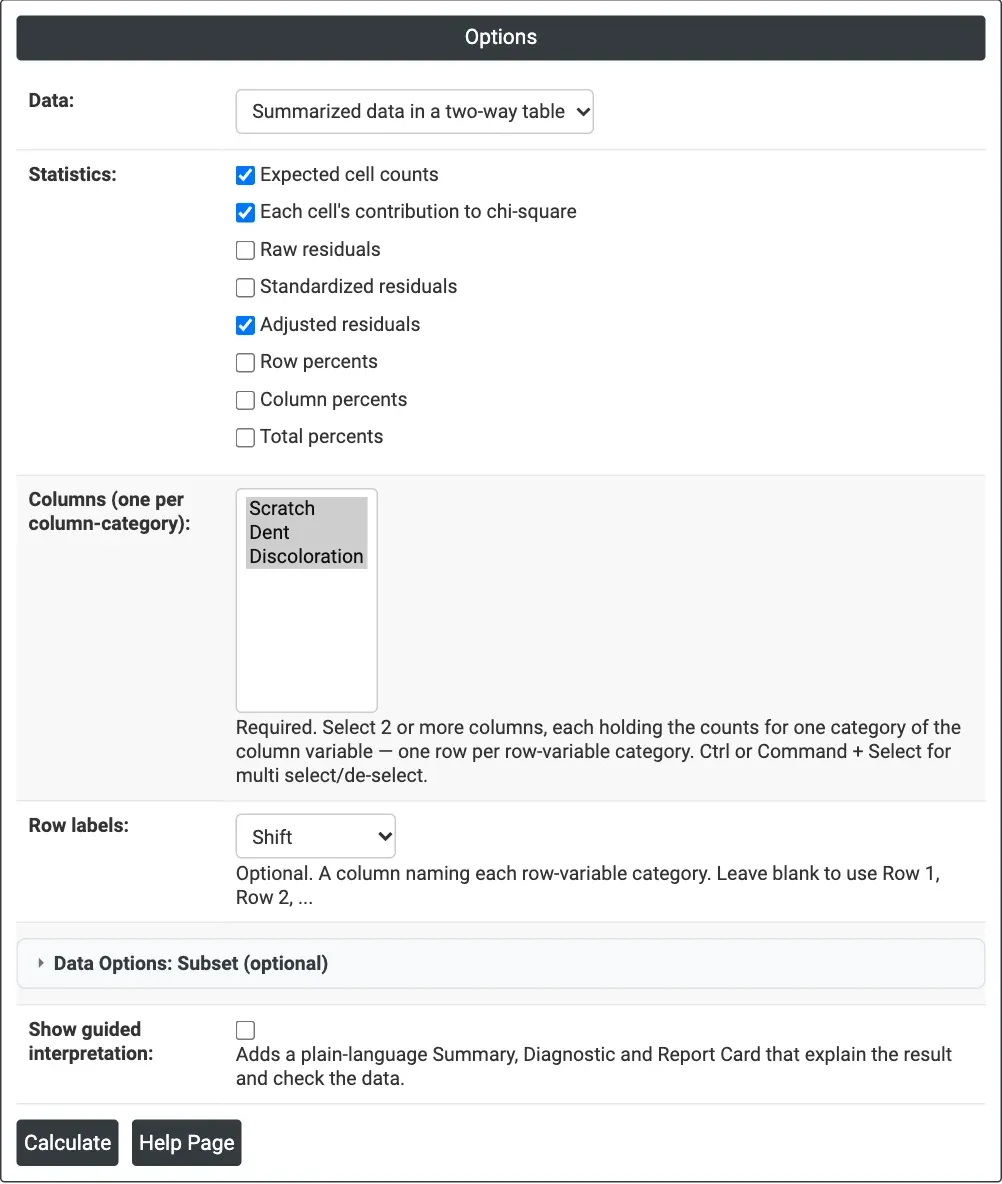
그림 1 — 결점 유형 예제의 옵션: Scratch, Dent, Discoloration 도수를 열로, Shift를 행 레이블로 하는 요약표이며 수정 잔차가 선택되어 있습니다.
출력 설명
- Observed Counts — 행 합계와 열 합계(All)가 있는 표.
- Expected Counts와 Contribution to Chi-Square — 선택한 경우.
- Chi-Square Tests — Pearson 검정과 우도비 검정의 Chi-Sq, DF, P-Value.
- Raw Residuals, Standardized Residuals, Adjusted Residuals, Row Percents, Column Percents, Total Percents — 선택한 경우.
- Summary Report, Diagnostic Report, Report Card — 안내 해석을 사용한 경우.
- Download를 통한 PDF 내보내기.
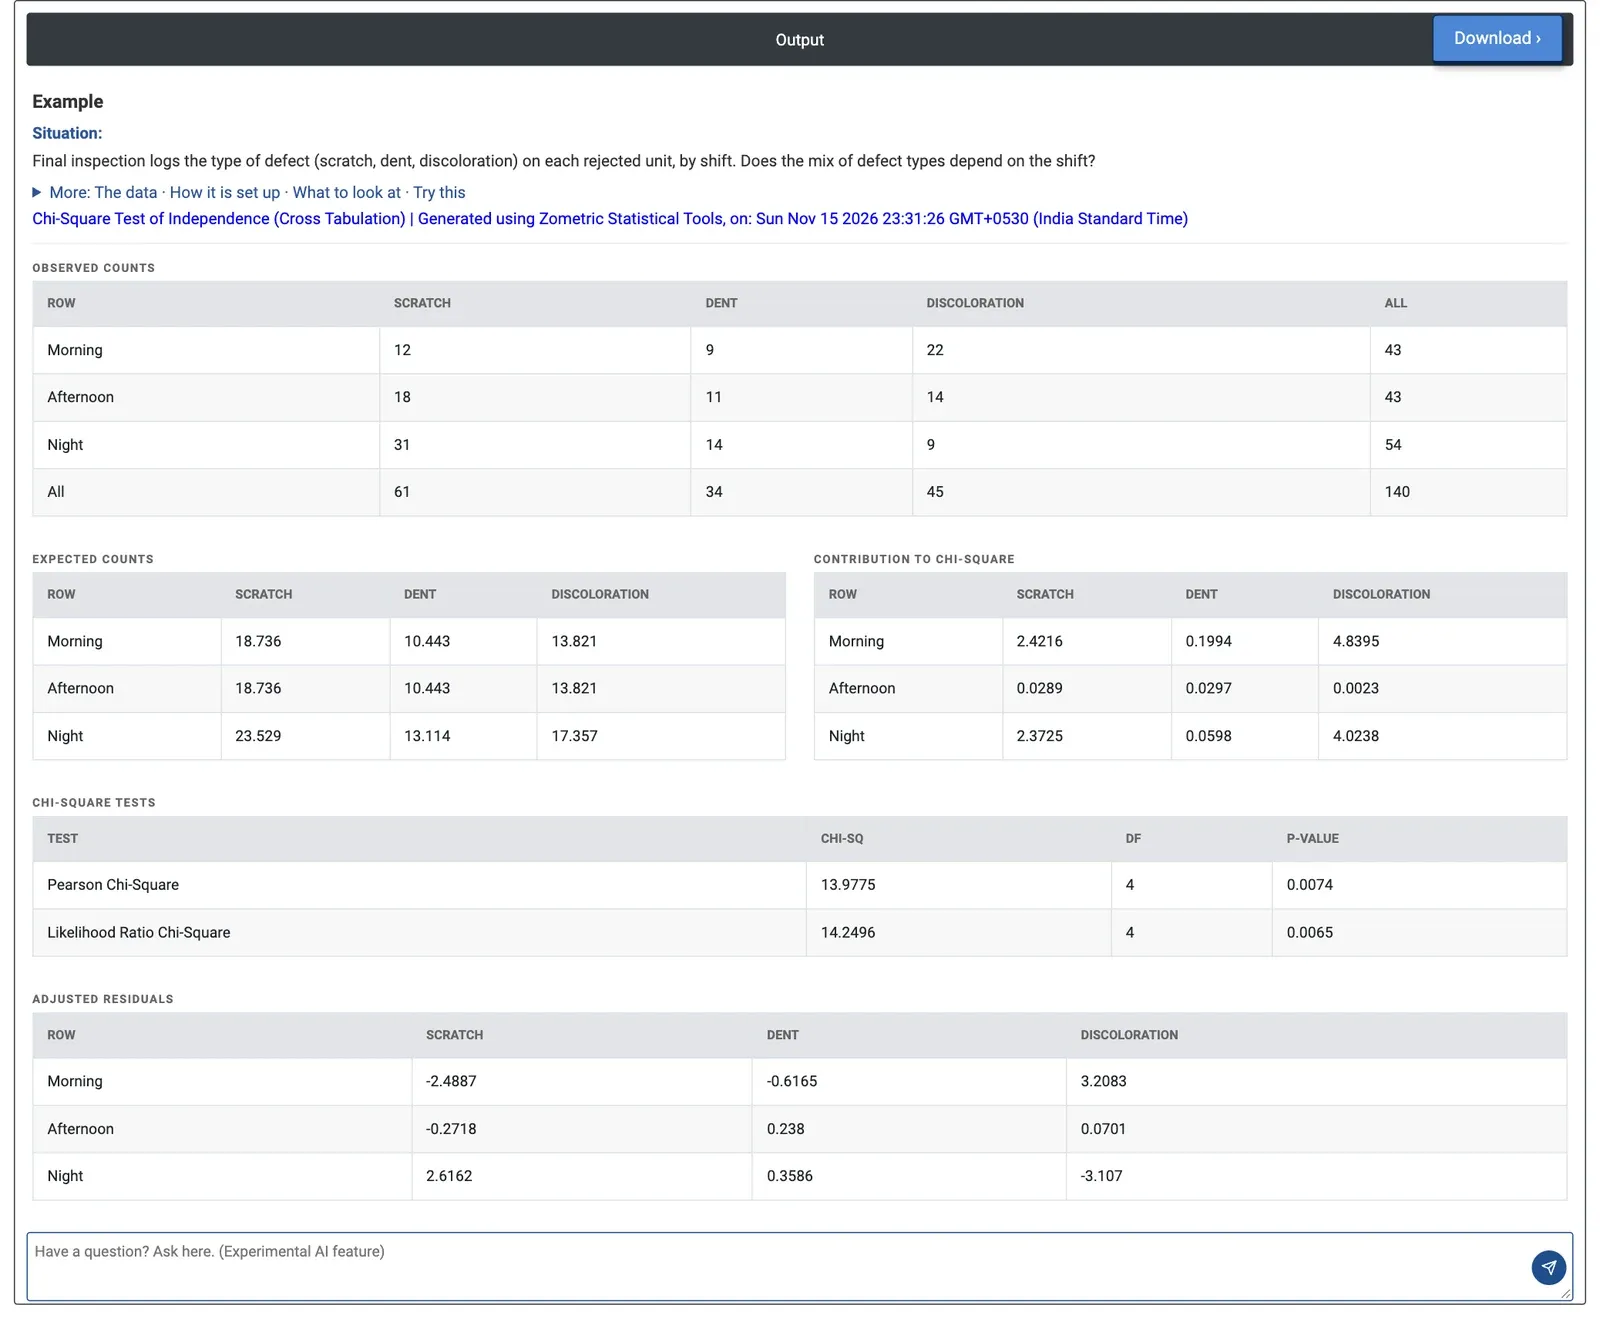
그림 2 — 교대조별 결점 유형: Pearson 카이제곱 13.98, 자유도 4, p = 0.0074이며, 수정 잔차는 아침 교대조의 변색과 야간 교대조의 긁힘을 가리킵니다.
계산 예제
최종 검사에서는 불합격 제품마다 결점 유형을 교대조별로 기록하며, 불합격품은 모두 140개입니다. 품질 팀은 결점 유형의 구성이 교대조에 따라 달라지는지 알고 싶습니다. 결점 유형(Scratch, Dent, Discoloration)마다 한 열씩, Shift를 행 레이블로 하는 표로 도수를 입력하고, 기본 통계량과 함께 Adjusted residuals를 선택합니다.
결점 구성은 교대조에 따라 달라집니다. Pearson 카이제곱은 자유도 4에서 13.98, p = 0.0074입니다(우도비 14.25, p = 0.0065). 기여도는 그 원인을 보여 줍니다. 아침 교대조의 변색(4.84, 관측 22개 대 기대 13.8개)과 야간 교대조의 변색(4.02, 9개 대 17.4개), 그다음 아침 교대조의 긁힘(2.42, 12개 대 18.7개)과 야간 교대조의 긁힘(2.37, 31개 대 23.5개)입니다. 오후 교대조는 전체 구성과 일치하며, 찌그러짐은 고르게 분포합니다.
수정 잔차도 이를 확인해 줍니다. 아침 변색의 3.21과 야간 긁힘의 2.62는 2를 크게 넘습니다. 팀은 변색에 대해서는 하루 시작 시점에 달라지는 요인(예: 예열 또는 다른 도료 배치)을, 긁힘에 대해서는 야간 교대조의 취급과 조명을 살펴봅니다. 모든 기대 도수가 10보다 크므로 p-값은 신뢰할 수 있습니다.
자주 묻는 질문
카이제곱 독립성 검정에서 기대 도수는 어떻게 계산합니까?
독립일 때 셀의 기대 도수는 그 행 합계에 열 합계를 곱하고 전체 합계로 나눈 값, 즉 E = R x C / N입니다. Pearson 통계량은 모든 셀에 대해 (O − E)² / E를 합한 값이며, 자유도 (r − 1)(c − 1)의 카이제곱 분포와 비교합니다. 여기서 r과 c는 행과 열의 수입니다.
카이제곱 독립성 검정은 어떻게 해석합니까?
p-값이 작으면 행 변수와 열 변수가 연관되어 있다는 뜻이며, 열의 구성이 모든 행에서 같지 않습니다. 연관성이 어디에서 비롯되는지 보려면 각 셀의 기여도 (O − E)² / E와 대략 표준정규분포를 따르는 수정 잔차를 살펴봅니다. 값이 약 ±2를 넘으면 독립에서 뚜렷하게 벗어난 셀입니다.
이 검정에는 어떤 데이터 형식이 필요합니까?
Zometric Statistical Software에서는 열 범주마다 숫자 열 하나, 행 범주마다 한 행으로 된 요약 이원표를 입력하거나, 두 범주형 열과 선택적 도수 열로 된 원시 데이터를 입력할 수 있습니다. 원시 데이터의 경우 도구가 먼저 두 열을 교차 분류합니다. 합계가 0인 행이나 열은 제거해야 합니다.
카이제곱 검정의 p-값은 언제 신뢰할 수 있습니까?
p-값은 기대 도수가 너무 작지 않을 때 신뢰할 수 있으며, 선택적 안내 해석에서 이를 확인합니다. 교대조별 결점 유형 계산 예제에서는 모든 기대 도수가 10보다 컸으므로 자유도 4에서 Pearson p-값 0.0074를 신뢰할 수 있었습니다.