
K-평균 군집화(Cluster K-Means)
K-평균 군집화은 둘 이상의 숫자 변수에 대한 관측값을 사용자가 지정한 K개의 군집으로 묶으며, k-means++ 초기 중심과 여러 번의 무작위 시작을 사용한 Lloyd 방법을 적용합니다. 단위가 서로 다른 변수는 표준화하십시오. 집단의 수를 알고 있을 때 사용합니다. 출력에는 최종 분할, 군집 중심, 각 관측값의 군집과 거리, 설명된 변동의 백분율이 포함됩니다.
최종 검토
핵심 요점
K-평균 군집화은 관측값을 정해진 수(K)의 집단으로 나누어, 선택한 변수에서 각 집단의 관측값이 최대한 비슷하도록 합니다. 예를 들어 배치, 부품, 공급업체를 유형별로 분류할 수 있습니다.
목적
K-평균 군집화은 관측값을 정해진 수(K)의 집단으로 나누어, 선택한 변수에서 각 집단의 관측값이 최대한 비슷하도록 합니다. 집단의 수를 알고 있을 때 사용합니다. 예를 들어 여러 측정 특성으로 자재 배치, 부품 또는 공급업체를 유형별로 분류하거나, 이미 사용 중인 레이블(등급, 라인, 교대조)이 측정값에 실제로 나타나는지 확인할 때 사용합니다.
주요 기능
- 둘 이상의 숫자 변수에 대한 관측값을 사용자가 지정한 K개의 군집으로 묶습니다.
- 선택적 표준화를 통해 큰 단위로 측정된 변수가 군집화를 좌우하지 않도록 합니다.
- 여러 번의 무작위 시작점을 사용하며, 최적 해(군집 내 산포가 가장 작은 해)를 유지합니다. 같은 데이터는 항상 같은 결과를 줍니다.
- 최종 분할(크기, 군집 내 제곱합, 중심까지의 평균 거리와 최대 거리), 원래 단위로 나타낸 각 군집의 중심, 각 관측값의 군집, 군집으로 설명되는 전체 변동의 백분율을 보고합니다.
- 선택한 처음 두 변수의 산점도이며, 군집별로 색을 구분합니다.
통계적 방법
선택한 변수 중 하나라도 값이 없거나 숫자가 아닌 행은 제외됩니다. Standardize variables를 선택하면 군집화 전에 각 변수를 표본표준편차 s를 사용하여 z = (x − 평균) / s로 변환하므로, 모든 변수의 평균은 0, 표준편차는 1이 됩니다.
K-평균 알고리즘(Lloyd 방법)은 각 관측값을 유클리드 거리로 가장 가까운 군집 중심에 할당하고, 각 중심을 소속 관측값의 평균으로 다시 계산하는 과정을 할당이 더 이상 바뀌지 않을 때까지 반복합니다. 초기 중심은 k-means++ 규칙으로 선택합니다. 결과는 시작점에 따라 달라질 수 있으므로 Number of random starts만큼 알고리즘을 실행하고 군집 내 제곱합이 가장 작은 실행을 유지합니다. 고정된 난수 시드를 사용하므로 결과는 정확히 재현됩니다.
군집으로 설명되는 변동의 백분율은 (전체 SS − 군집 내 SS) / 전체 SS × 100입니다. 여기서 전체 SS는 모든 관측값과 전체 평균 사이의 거리 제곱합이고, 군집 내 SS는 각 관측값과 해당 군집 중심 사이의 거리 제곱합입니다. 둘 다 군집화에 사용한 데이터를 기준으로 측정합니다(해당 옵션을 선택했다면 표준화된 값). 이 값이 클수록 군집이 더 뚜렷하고 조밀하다는 뜻이지만, K가 커지면 항상 증가하므로 K 간에 비교할 때는 주의해야 합니다. 중심은 보고를 위해 원래 단위로 되돌립니다. 최종 분할은 각 군집의 관측값 수, 군집 내 제곱합, 구성원과 중심 사이의 평균 거리와 최대 거리를 제공합니다. 이 거리와 군집 소속 표의 각 관측값의 거리는 Minitab과 같이 군집화에 사용한 단위(해당 옵션을 선택했다면 표준화된 값)에서의 유클리드 거리입니다.
입력 항목 및 옵션
항목 | 설명 |
Variables | 군집화에 사용할 숫자 열 둘 이상입니다. 여러 개를 선택하려면 Ctrl 또는 Command + 클릭합니다. |
Number of clusters (K) | 형성할 집단의 수입니다. 기본값은 3이며 최소 2입니다. 완전한 관측값이 최소 K개 필요합니다. |
Standardize variables | 기본적으로 선택되어 있습니다. 군집화 전에 모든 변수를 같은 척도(평균 0, 표준편차 1)로 맞춥니다. 모든 변수의 단위가 같고 산포가 큰 변수에 더 큰 가중치를 주려는 경우에만 선택을 해제하십시오. |
Number of random starts | 시도할 시작점의 수이며, 가장 좋은 결과가 유지됩니다. 기본값은 10이며 범위는 1~100입니다. |
Title | 그림과 출력에 표시되는 제목입니다. 기본값은 Cluster K-Means입니다. |
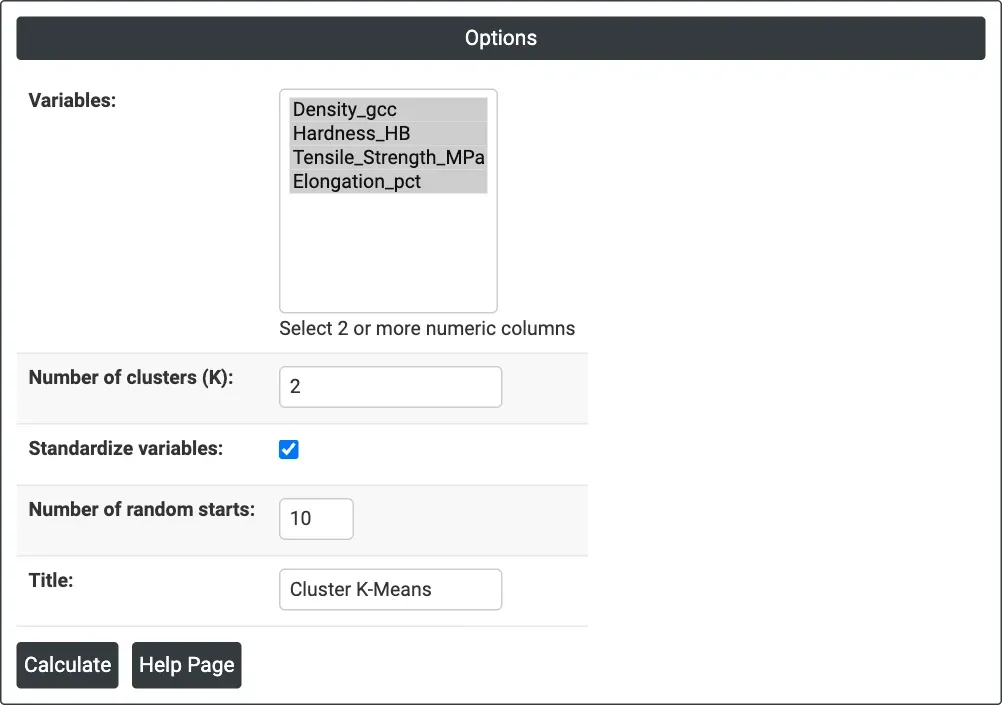
그림 1 — 예제의 옵션: 네 개의 특성 열, K = 2, 표준화, 무작위 시작 10회.
출력 설명
- Cluster K-Means plot — 선택한 첫 번째 변수(x)와 두 번째 변수(y)의 산점도이며, 각 점은 소속 군집별로 색을 구분합니다.
- % variation explained by clusters — 전체 변동 중 군집 내부가 아니라 군집 간에 있는 비율입니다.
- Final Partition — 각 군집의 Number of observations, Within cluster sum of squares, Average distance from centroid, Maximum distance from centroid입니다.
- Cluster Centroids — 각 군집의 관측값 수 N과 원래 단위로 나타낸 각 변수의 평균입니다.
- Cluster Membership — 각 관측값(워크시트 행 기준), 소속 군집, 해당 군집 중심까지의 거리입니다.
- Download를 통한 PDF 내보내기.
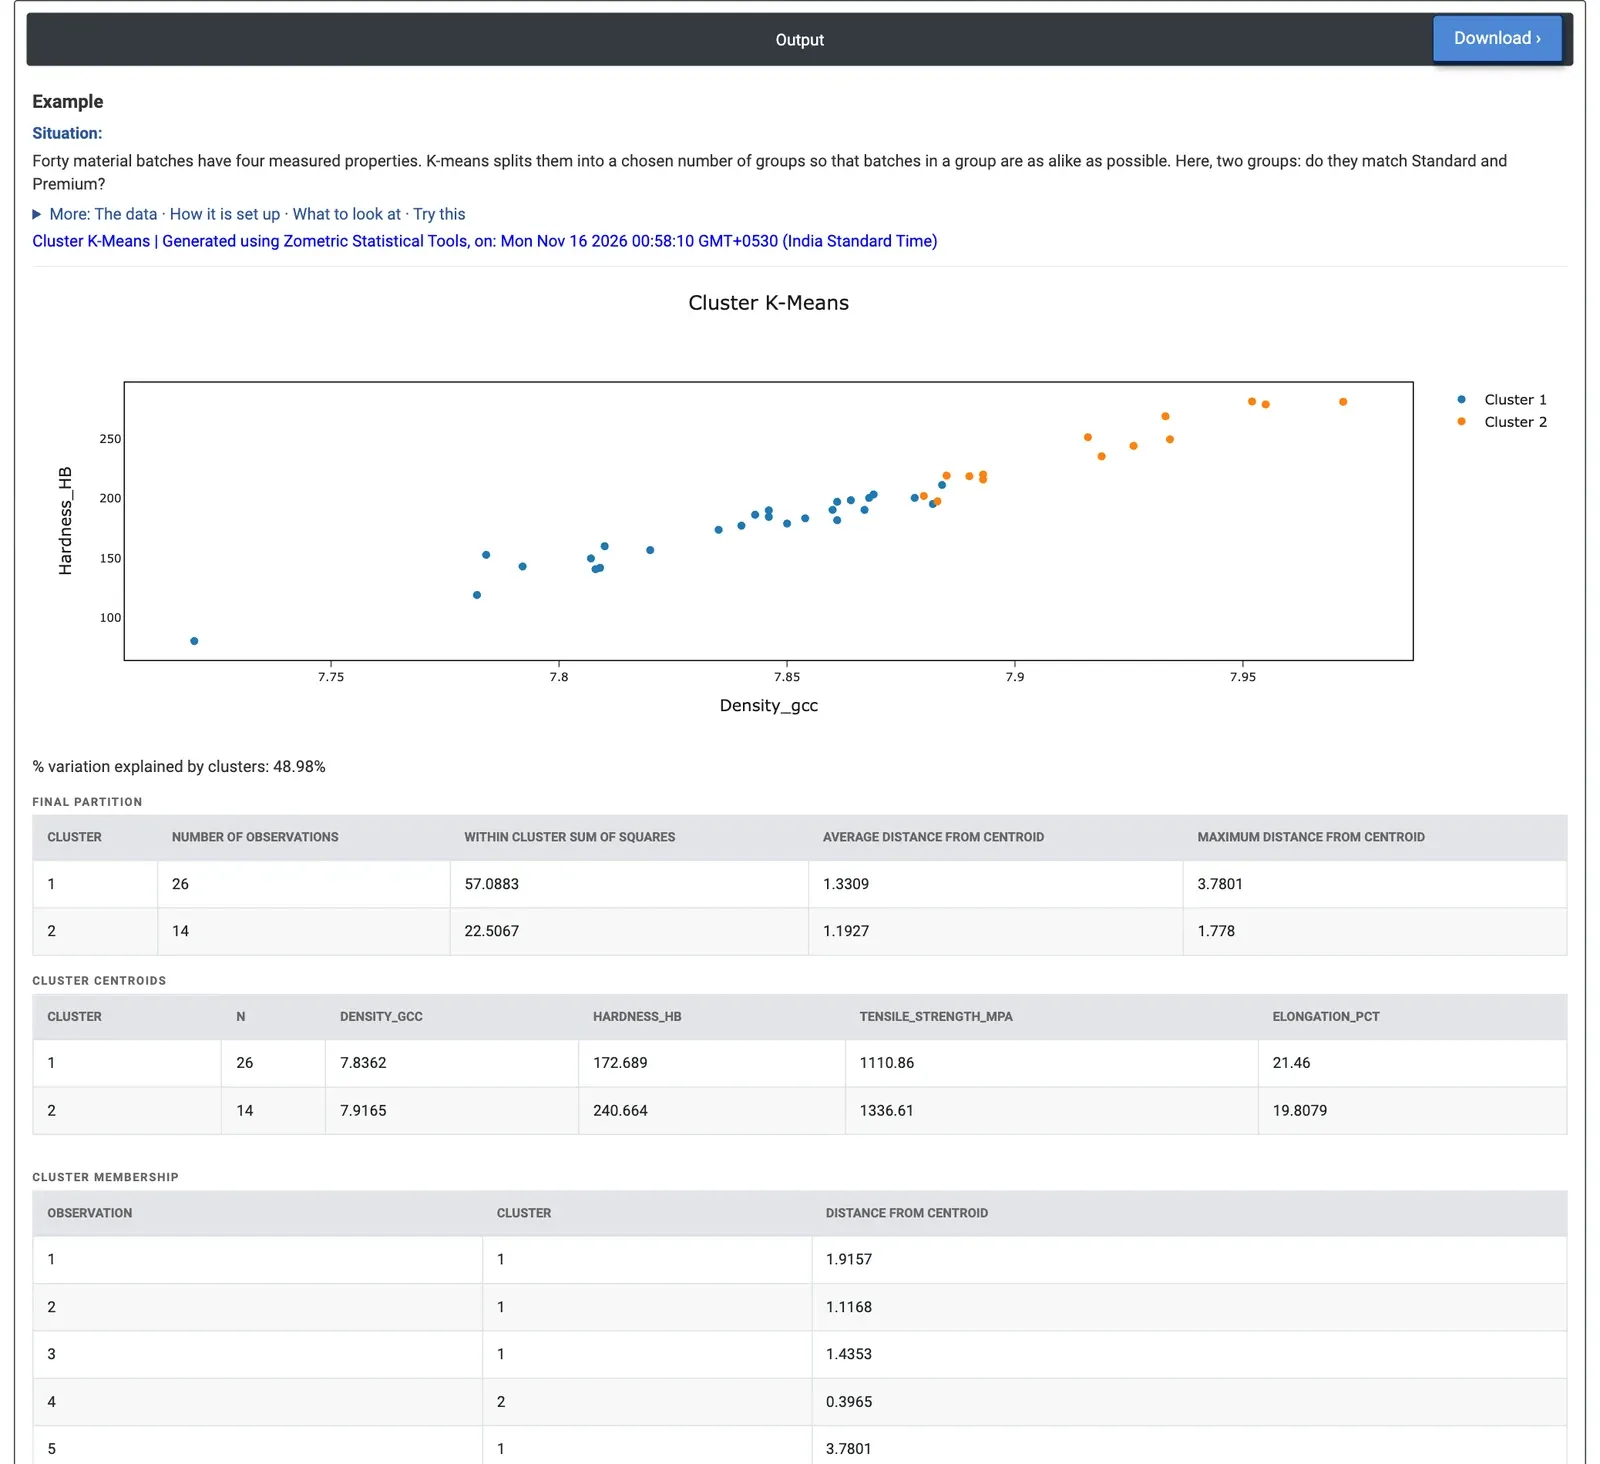
그림 2 — 자재 배치 40개의 두 군집: 군집 2(배치 14개)는 더 단단하고 더 강하며, 군집이 변동의 48.98%를 설명합니다. 최종 분할, 중심, 군집 소속 표의 시작 부분이 그림 뒤에 이어집니다.
계산 예제
한 재료 시험소에 배치가 40개 있으며, 각 배치마다 밀도(g/cc), 경도(HB), 인장 강도(MPa), 신율(%)을 측정했습니다. 배치는 Standard 또는 Premium으로 판매되며 각각 20개입니다. 시험소는 측정값만으로 두 개의 자연스러운 집단으로 나뉘는지, 그리고 그 집단이 배치 유형과 일치하는지 알고자 합니다. 네 개의 특성 열을 선택하고 Number of clusters (K) = 2로 설정하며, Standardize variables는 선택한 상태로 두고(그렇지 않으면 수백 단위인 인장 강도가 지배하게 됩니다) 무작위 시작 10회도 유지합니다.
군집은 변동의 48.98%를 설명합니다. 군집 2는 더 단단하고 더 강하며(평균 240.7 HB와 1,336.6 MPa) 연성이 약간 낮은(신율 19.8%) 배치 14개로 이루어져 있고, 군집 1은 평균이 172.7 HB, 1,110.9 MPa, 신율 21.5%인 배치 26개로 이루어져 있습니다. 밀도 중심은 약간만 다릅니다(7.92 대 7.84 g/cc). 최종 분할에서 군집 2가 더 조밀한 집단입니다(중심까지의 평균 거리 1.19 대 1.33 표준화 단위). 군집 1에서 가장 먼 구성원인 5번 행은 중심에서 3.78 단위 떨어져 있어, 확인해 볼 만한 특이한 배치입니다. 배치 유형 열과 비교하면 군집 2에는 Premium 11개와 Standard 3개가, 군집 1에는 Standard 17개와 Premium 9개가 있으므로, 40개 배치 중 28개가 자신의 유형과 일치하는 군집에 속합니다.
시험소의 입장에서 이는 가장 강한 배치가 뚜렷한 집단을 이룬다는 뜻이지만, 많은 Premium 배치가 Standard 배치보다 더 단단하거나 강하지 않다는 뜻이기도 합니다. 즉 이 레이블은 특성으로 완전히 뒷받침되지 않습니다. K = 3이면 설명되는 변동이 69.66%로 올라가며, 약하고 무른 배치 9개(138.2 HB, 995.9 MPa)가 중간 집단 23개와 상위 집단 8개로부터 분리됩니다. Standardize variables의 선택을 해제하면 인장 강도가 대부분의 가중치를 차지하게 되어 분할이 19개와 21개 배치로 바뀝니다. 알려진 유형을 사용하는 규칙을 만들려면 같은 데이터에 Discriminant Analysis를 실행하십시오.
자주 묻는 질문
K-평균 군집화은 언제 사용합니까?
집단의 수를 알고 있고, 여러 측정 특성으로 자재 배치, 부품 또는 공급업체 같은 관측값을 유형별로 분류하려는 경우에 사용합니다. 등급, 라인, 교대조처럼 이미 사용 중인 레이블이 측정값에 실제로 나타나는지 확인하는 데에도 유용합니다.
K-평균 군집화 전에 변수를 표준화해야 합니까?
표준화하면 각 변수가 평균 0, 표준편차 1로 변환되므로 큰 단위로 측정된 변수가 군집화를 좌우하지 않습니다. 기본적으로 선택되어 있습니다. 모든 변수의 단위가 같고 산포가 큰 변수에 더 큰 가중치를 주려는 경우에만 선택을 해제하십시오. 계산 예제에서는 선택을 해제하자 인장 강도가 대부분의 가중치를 차지하여 분할이 달라졌습니다.
군집 수 K는 어떻게 선택합니까?
출력은 군집으로 설명되는 전체 변동의 백분율을 보고하며, 값이 클수록 집단이 더 뚜렷하고 조밀합니다. 이 값은 K가 커지면 항상 증가하므로 K 간에 비교할 때는 주의해야 합니다. 예제에서 군집 2개는 변동의 48.98%를, 군집 3개는 69.66%를 설명했으며, 약하고 무른 배치 9개의 집단이 분리되었습니다.
K-평균 군집화과 판별분석의 차이는 무엇입니까?
K-평균 군집화은 알려진 레이블을 사용하지 않고 측정값만으로 집단을 찾습니다. 예제에서 두 군집이 Standard 또는 Premium 레이블과 일치한 배치는 40개 중 28개뿐이었습니다. 알려진 유형을 사용하여 집단을 구분하는 규칙을 만들려면 같은 데이터에 Discriminant Analysis를 실행하십시오.