
변수 군집화(Cluster Variables)
변수 군집화는 상관, 절대 상관 또는 유클리드 거리와 일곱 가지 연결 방법 중 하나를 사용하여 세 개 이상의 수치 변수에 계층적 군집화를 적용합니다. 함께 움직이는 변수가 먼저 연결되며 덴드로그램으로 표시됩니다. 긴 측정 항목이나 설문 문항 목록을 줄일 때 사용합니다. 완전한 행이 최소 3개 필요합니다. 군집 수를 입력하면 각 변수에 군집이 표시됩니다.
최종 검토
핵심 요점
변수 군집화는 비슷한 정보를 담은 변수(열)를 묶고 함께 오르내리는 변수끼리 먼저 연결하여, 긴 측정 항목이나 설문 문항 목록을 군집당 하나로 줄일 수 있게 합니다.
목적
변수 군집화는 비슷한 정보를 담은 변수(열)를 묶습니다. 관측값 전반에 걸쳐 함께 오르내리는 변수가 먼저 연결되며, 그 결과는 덴드로그램으로 그려집니다. 긴 측정 항목이나 설문 문항 목록을 줄이는 데 사용합니다. 여러 변수가 같은 군집에 속하면 모든 변수 대신 그중 하나 또는 이를 합친 점수를 추적하면 됩니다.
주요 기능
- 세 개 이상의 수치 변수에 대한 계층적 군집화.
- 상관, 절대 상관 또는 유클리드 거리에 기반한 거리.
- 일곱 가지 연결 방법: Single, Complete, Average, Centroid, Median, McQuitty, Ward.
- 변수가 연결되는 순서와 수준을 보여 주는 덴드로그램.
- 군집 수를 지정하면 각 변수에 대한 군집 배정을 선택적으로 제공.
통계적 방법
선택한 변수 중 어느 하나라도 값이 누락되었거나 숫자가 아닌 행은 제외됩니다. 변수 3개 이상과 완전한 행 3개 이상이 필요합니다. 각 변수는 행에 걸친 값을 좌표로 하는 하나의 점으로 취급되며, 모든 변수 쌍 사이의 거리는 선택한 측도로 계산합니다. 상관 거리는 1 − r이며, r은 두 변수 간의 Pearson 상관입니다. 완전한 양의 상관이면 0, 완전한 음의 상관이면 2입니다. 절대 상관 거리는 1 − |r|로, 강한 음의 관계를 강한 양의 관계와 똑같이 가까운 것으로 취급합니다. 유클리드 거리는 원래 값에 대한 √Σ(xᵢ − yᵢ)²이므로 각 변수의 단위에 따라 달라집니다.
군집화는 각 변수를 단독으로 시작하여 가장 가까운 두 군집을 반복적으로 병합합니다. 연결 방법이 군집 간 거리를 정합니다. Single은 가장 가까운 쌍, Complete는 가장 먼 쌍, Average는 모든 쌍별 거리의 평균, McQuitty는 가중 평균, Centroid와 Median은 군집 중심 간 거리, Ward는 군집 내 제곱합의 증가량이 가장 작은 쪽을 사용합니다. Ward, Centroid, Median은 유클리드 거리가 필요하며, 도구는 다른 조합을 허용하지 않습니다.
상관 거리를 사용할 때 높이 h에서의 연결은 두 가지의 변수가 평균적으로 약 1 − h의 상관을 가진다는 뜻입니다. Number of clusters를 입력하면 나무를 잘라 그만큼의 군집을 만들고 각 변수에 해당 군집을 표시합니다.
입력 항목 및 옵션
항목 | 설명 |
Variables | 묶을 수치 열 세 개 이상입니다. 여러 개를 선택하려면 Ctrl 또는 Command를 누른 채 클릭합니다. |
Linkage method | 군집 간 거리를 측정하는 방법입니다. Single, Complete, Average(기본값), Centroid, Median, McQuitty 또는 Ward. |
Distance measure | Correlation(기본값), Absolute Correlation 또는 Euclidean. |
Number of clusters | 선택 사항이며 2 이상입니다. 나무를 이 개수의 군집으로 자르고 Cluster Assignments 표를 추가합니다. 덴드로그램만 표시하려면 비워 둡니다. |
Title | 덴드로그램에 표시되는 제목입니다. 기본값은 Cluster Variables입니다. |
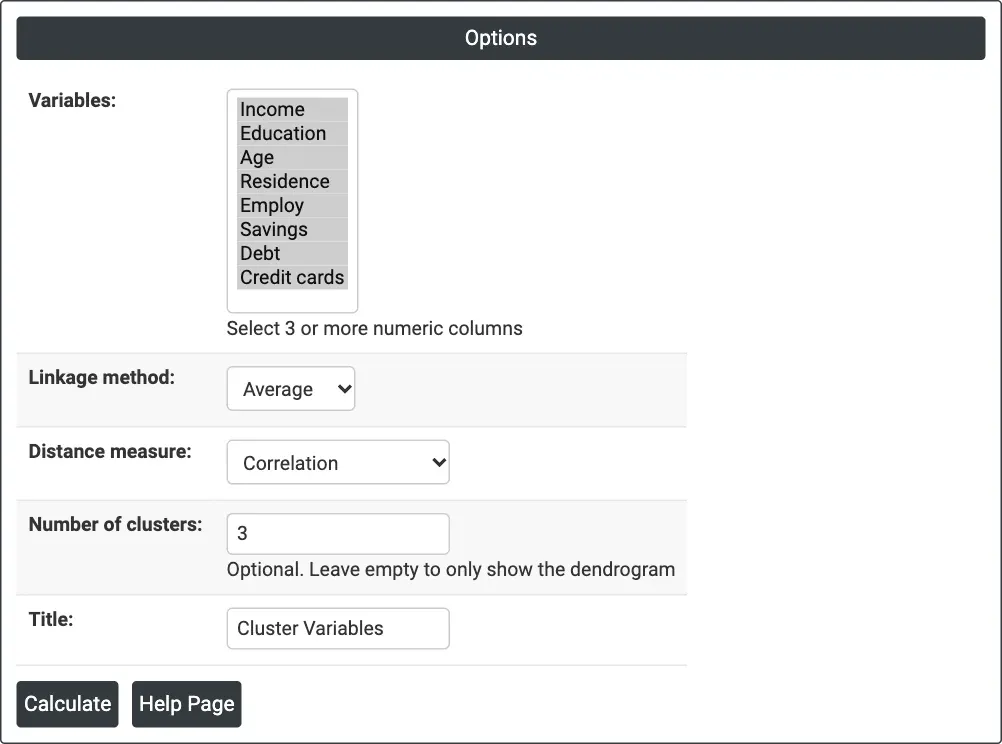
그림 1 — 예제의 옵션: 대출 신청자 변수 8개, Average 연결, Correlation 거리, 3개 군집.
출력 설명
- Dendrogram — x축에는 나무 순서대로 변수가 놓이고, y축(Distance)은 가지가 연결되는 수준을 나타냅니다. 연결이 낮을수록 변수들이 더 비슷합니다.
- Cluster Assignments — Number of clusters를 입력하면 표시되며, 각 변수와 그 군집 번호를 보여 줍니다.
- Download를 통한 PDF 내보내기.
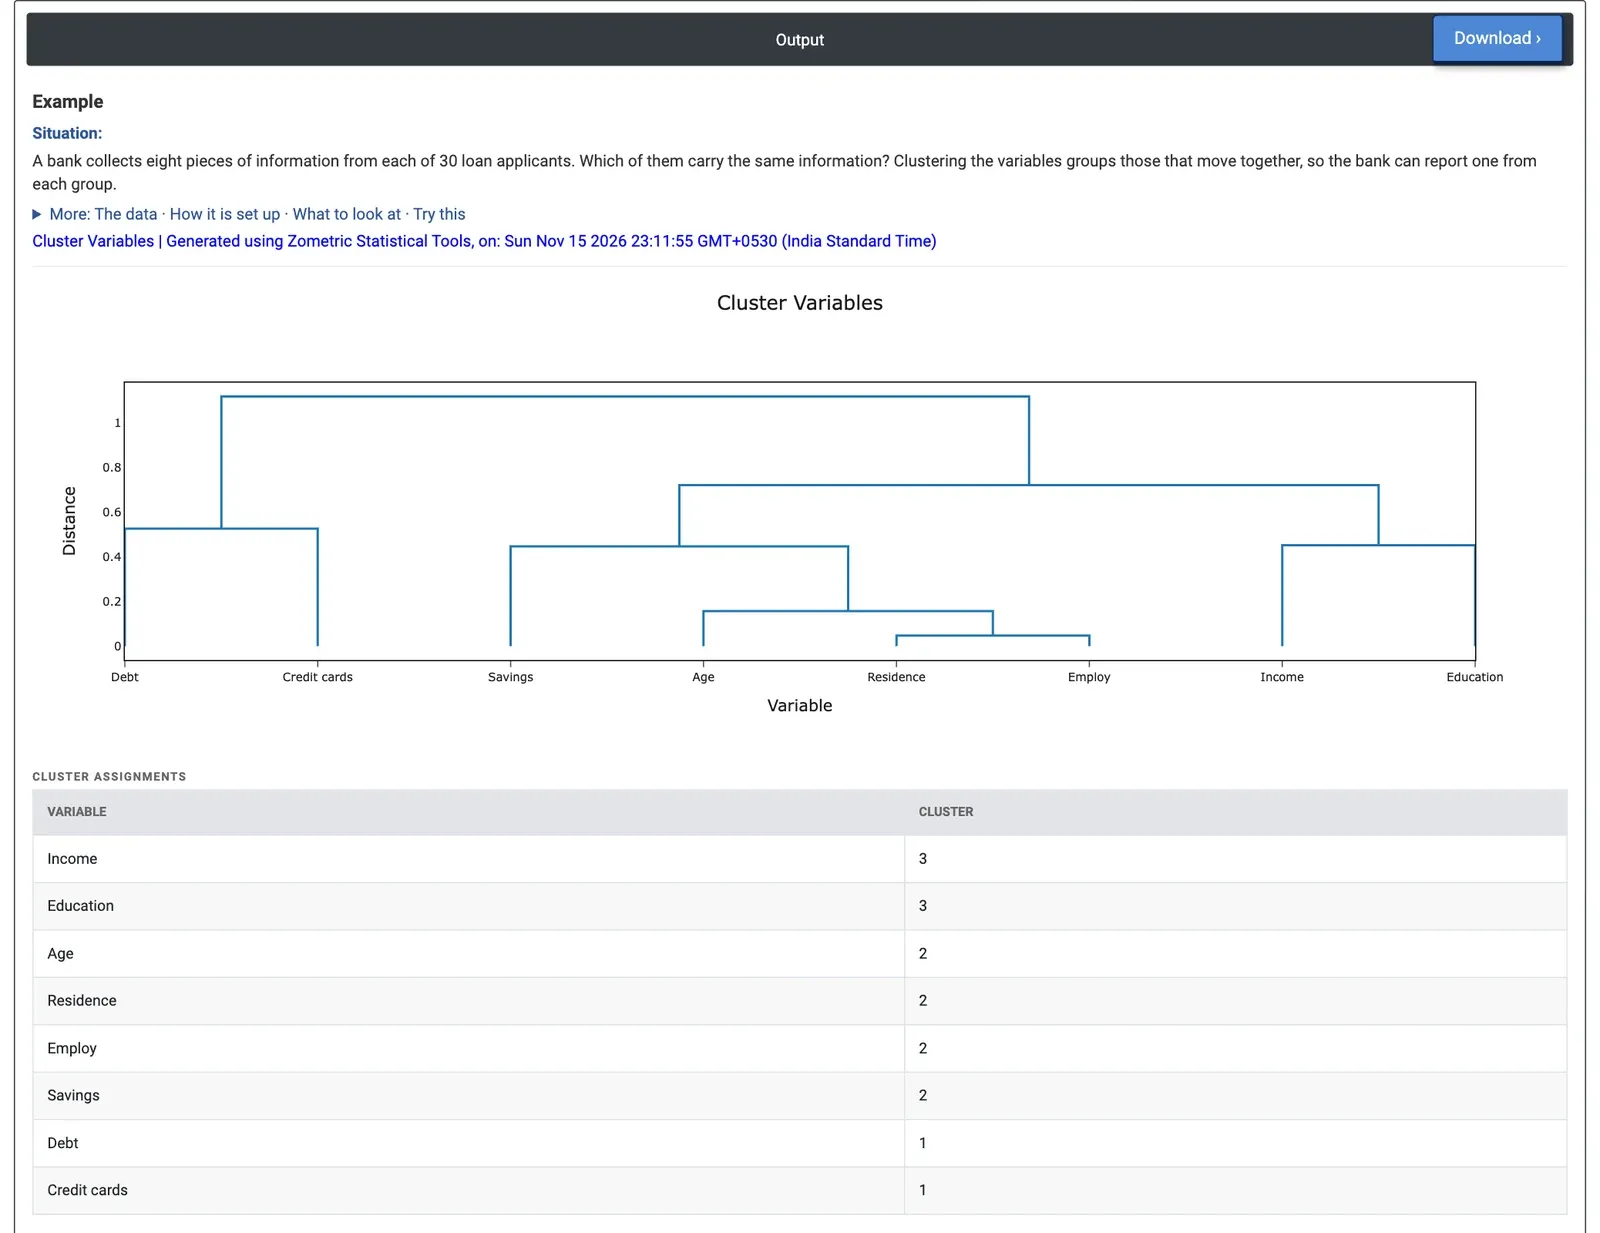
그림 2 — 대출 신청자 변수 8개의 덴드로그램과 군집 배정: 안정성, 소득, 차입 군집.
계산 예제
한 은행이 대출 신청자마다 소득, 교육 연수, 나이, 현 주소 거주 연수(Residence), 현 직장 근속 연수(Employ), 저축, 부채, 신용카드 수의 여덟 가지 정보를 기록합니다. 신용 분석가는 이 가운데 어떤 변수가 같은 정보를 담고 있는지 알고 싶어 하며, 그래야 간단한 보고서에 각 집단에서 하나씩만 제시할 수 있습니다. 분석가는 신청자 30명의 데이터에서 여덟 개 열을 모두 선택하고, Linkage method = Average와 Distance measure = Correlation을 그대로 둔 채 Number of clusters = 3을 입력합니다.
Residence와 Employ가 거리 0.048(상관 0.95)에서 가장 먼저 연결되고, Age가 0.157에서 이들에 합류합니다. Savings는 0.446에서 이 집단에 합류합니다. Income과 Education은 0.451에서, Debt와 Credit cards는 0.526에서 연결됩니다. 군집이 세 개이면 군집 2에는 신청자의 안정성을 나타내는 Age, Residence, Employ, Savings가 속하고, 군집 3에는 Income과 Education이, 군집 1에는 차입을 나타내는 Debt와 Credit cards가 속합니다. 마지막 두 연결은 0.72와 1.117에서 이루어져 나머지보다 훨씬 높으며, 이는 세 집단을 뒷받침합니다.
분석가에게는 각 군집에서 변수를 하나씩, 예를 들어 Employ, Income, Debt를 선택하면 여덟 변수가 말해 주는 내용의 대부분을 다룰 수 있습니다. Number of clusters = 2로 설정하면 안정성 군집과 소득 군집이 병합되고 Debt와 Credit cards만 따로 남습니다. 군집이 4개이면 Debt와 Credit cards가 분리됩니다. 같은 여덟 개 열에 요인 분석을 적용하면 비슷한 묶음이 나오며, 적재값이 각 변수가 자기 집단에 얼마나 강하게 속하는지 보여 줍니다.
자주 묻는 질문
변수 군집화는 무엇에 사용합니까?
긴 측정 항목이나 설문 문항 목록을 줄이는 데 사용합니다. 관측값 전반에 걸쳐 함께 오르내리는 변수가 먼저 연결되며, 그 결과는 덴드로그램으로 그려집니다. 여러 변수가 같은 군집에 속하면 모든 변수 대신 그중 하나 또는 이를 합친 점수를 추적하면 됩니다.
상관 거리란 무엇입니까?
상관 거리는 1 − r이며, r은 두 변수 간의 Pearson 상관입니다. 완전한 양의 상관이면 0, 완전한 음의 상관이면 2입니다. 절대 상관 거리 1 − |r|는 강한 음의 관계를 강한 양의 관계와 똑같이 가까운 것으로 취급합니다. 유클리드 거리는 원래 값을 사용하므로 각 변수의 단위에 따라 달라집니다.
변수 덴드로그램은 어떻게 읽습니까?
x축에는 나무 순서대로 변수가 놓이고 y축은 가지가 연결되는 거리를 나타내며, 연결이 낮을수록 변수들이 더 비슷합니다. 상관 거리를 사용할 때 높이 h에서의 연결은 두 가지의 변수가 평균적으로 약 1 − h의 상관을 가진다는 뜻입니다.
변수 군집의 수는 어떻게 정합니까?
다른 연결보다 훨씬 높은 곳에서 이루어지는 연결을 찾으십시오. 대출 신청자 예제에서는 마지막 두 연결이 0.72와 1.117에서 이루어져 나머지보다 훨씬 높았고, 이는 안정성, 소득, 차입의 세 군집을 뒷받침했습니다. 그러면 Employ, Income, Debt처럼 각 군집에서 변수 하나씩만 선택해도 여덟 변수가 말해 주는 내용의 대부분을 다룰 수 있습니다.