
단순 대응 분석(Simple Correspondence Analysis)
단순 대응 분석은 원시 범주형 데이터 또는 분할표를 받아 행 범주와 열 범주를 지도에 표시합니다. 연관성에 대한 카이제곱 검정, 각 성분이 설명하는 정도를 보여 주는 관성 표, 행과 열의 기여도 표를 제공합니다. 각 변수는 범주가 2개 이상 필요합니다. 기계별 결점 유형처럼 큰 교차표의 패턴을 읽을 때 사용합니다.
최종 검토
핵심 요점
단순 대응 분석은 도수의 이원표를 지도로 변환하여, 우연으로 기대되는 것보다 더 자주 함께 나타나는 행 범주와 열 범주가 서로 가까이 놓이게 합니다.
목적
단순 대응 분석은 도수의 이원표를 지도로 변환합니다. 행 범주와 열 범주는 점으로 그려지며, 우연으로 기대되는 것보다 더 자주 함께 나타나는 범주는 서로 가까이 놓입니다. 큰 교차표의 패턴을 한눈에 보는 데 사용하십시오. 예를 들면 어떤 결점 유형이 어떤 기계와 함께 나타나는지, 어떤 불만 범주가 어떤 제품과 함께 나타나는지, 고객이 어떤 속성을 어떤 브랜드와 연결하는지 등입니다.
주요 기능
- 원시 데이터(범주형 열 두 개로 항목당 한 행)나 이미 도수로 요약된 분할표를 받습니다.
- 행 변수와 열 변수 간 연관성에 대한 카이제곱 검정.
- 각 성분(지도의 축)이 연관성을 얼마나 설명하는지 보여 주는 관성 표.
- 행 및 열 기여도 표: 선택한 성분 수에 대한 품질, 질량, 관성, 좌표, 제곱 상관, 기여도.
- 다섯 가지 그림: 행과 열의 대칭 그림, 행만, 열만, 그리고 비대칭 행 또는 열 그림.
통계적 방법
Categorical variables 입력에서 이 도구는 행 변수와 열 변수를 교차 분류하며, 결측값이 있는 행은 무시합니다. Columns of a contingency table 입력에서는 선택한 각 열이 하나의 열 범주에 대한 도수를 담고 각 행이 하나의 행 범주이며, 합계가 0인 행이나 열은 제외됩니다. 각 변수는 범주가 2개 이상 필요합니다.
도수를 총합 n으로 나누어 비율 P를 구하며, 행 질량 r(P의 행 합계)과 열 질량 c(열 합계)를 계산합니다. 표준화 잔차 행렬 S = Dr^−½ (P − r cᵀ) Dc^−½ 을 특잇값 분해로 분해합니다. 각 특잇값 d는 관성 d²인 하나의 성분을 제공하며, 성분 수는 (행 수 − 1)과 (열 수 − 1) 중 작은 값입니다. 총 관성은 카이제곱 통계량을 n으로 나눈 값과 같으며, 도구는 카이제곱 = n × 총 관성과 자유도 (행 수 − 1)(열 수 − 1), 그리고 그 p-값을 제공합니다. p-값이 작으면 행과 열이 연관되어 있으므로 지도가 실제 패턴을 보여 줍니다.
행의 주좌표는 Dr^−½ U D이고 열의 주좌표는 Dc^−½ V D입니다. 기여도 표에서 Mass는 전체 도수에서 해당 범주가 차지하는 비중, Inert는 총 관성에서 차지하는 비중, Corr는 제곱 코사인(한 성분이 해당 점을 얼마나 잘 나타내는지), Qual은 보고된 성분에 대한 Corr의 합, Contr는 한 성분의 관성에서 해당 점이 차지하는 비중입니다. 대칭 그림은 두 점 집합 모두에 주좌표를 사용하며, 비대칭 행 그림은 행을 주좌표로, 열을 표준좌표(주좌표를 d로 나눈 값)로 나타내고, 비대칭 열 그림은 그 반대입니다.
입력 항목 및 옵션
항목 | 설명 |
Input data | Categorical variables(기본값): 항목당 한 행. Columns of a contingency table: 이미 요약된 도수. 아래 항목은 이 선택에 따라 달라집니다. |
Row variable / Column variable | Categorical variables 입력의 경우: 교차 분류할 범주형 열 두 개입니다. 둘 다 필수이며 서로 달라야 합니다. |
Contingency table columns | 분할표 입력의 경우: 열 범주 하나의 도수를 각각 담고 있는 두 개 이상의 열이며, 행 범주마다 한 행입니다. |
Row names | 분할표 입력의 경우, 선택 사항: 표의 각 행에 이름을 붙이는 열입니다. 비워 두면 Row 1, Row 2 등을 사용합니다. |
Column names | 분할표 입력의 경우, 선택 사항: 선택한 표 열마다 이름 하나를 같은 순서로 나열한 열입니다. 비워 두면 열 머리글을 사용합니다. |
Number of components | 기여도 표에서 Coord, Corr, Contr를 보고할 성분의 수입니다. 기본값은 2이며, 1~20이고 사용 가능한 성분 수로 제한됩니다. |
Symmetric plot showing rows and columns | 기본값은 선택입니다. 행과 열이 하나의 지도에 모두 주좌표로 표시됩니다. |
Symmetric plot showing rows only / columns only | 기본값은 선택 해제입니다. 한 쪽 점 집합만 있는 동일한 지도입니다. |
Asymmetric row plot / Asymmetric column plot | 기본값은 선택 해제입니다. 행은 주좌표로, 열은 표준좌표로 나타내거나 그 반대입니다. |
Title | 그림에 표시되는 제목입니다. 기본값은 Simple Correspondence Analysis입니다. |
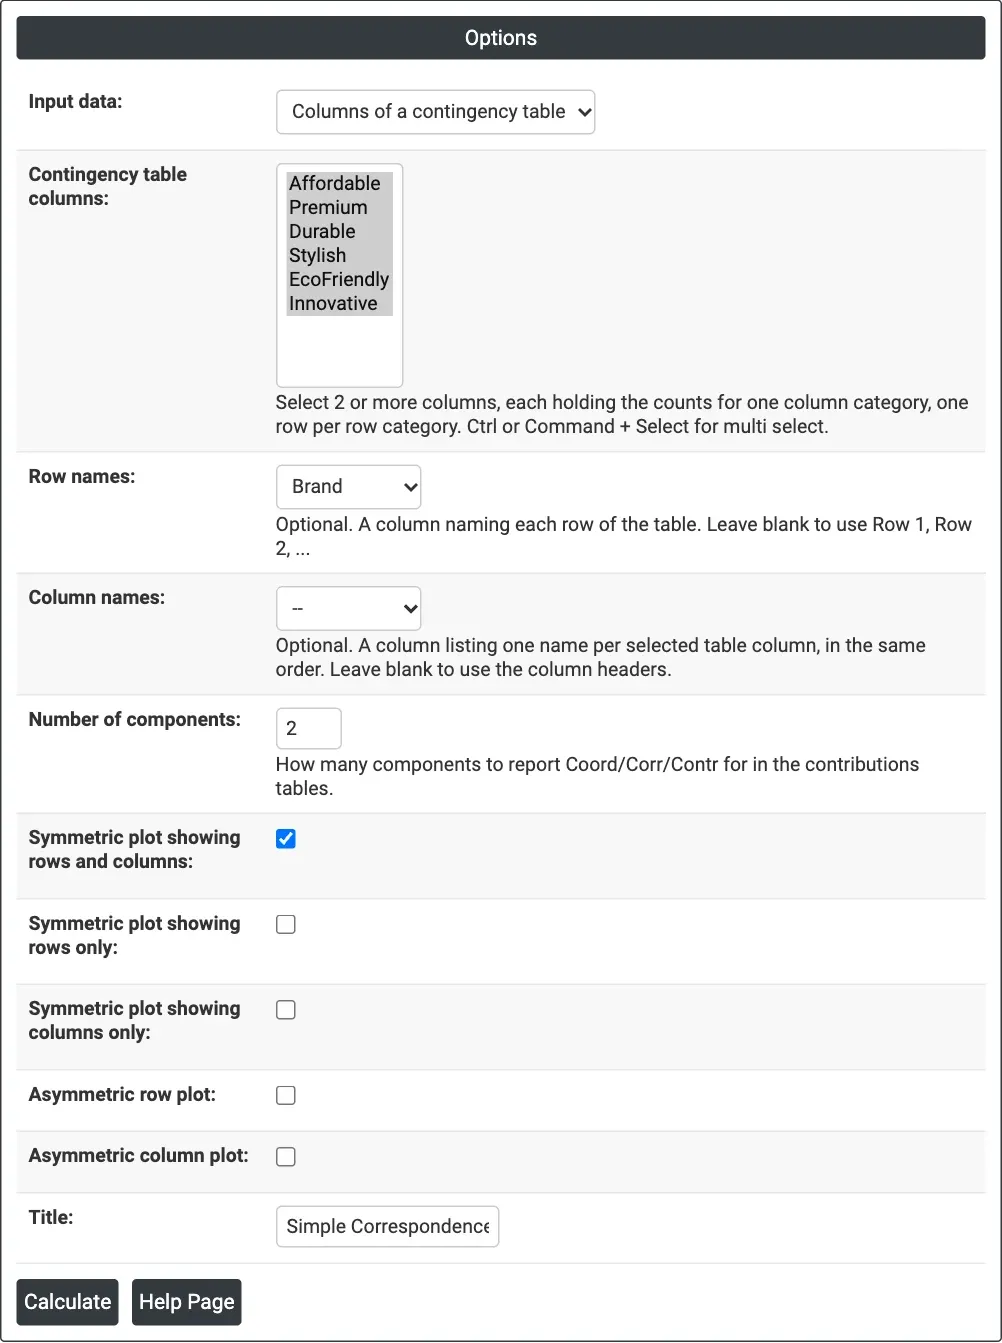
그림 1 — 브랜드 인식 예제의 옵션: 속성 열 여섯 개를 가진 분할표 입력이며 Brand를 행 이름으로 사용합니다.
출력 설명
- Symmetric Plot, Row Plot, Column Plot, Asymmetric Row Plot, Asymmetric Column Plot — 선택한 그림으로, Component 1과 Component 2가 축이며 각 성분이 설명하는 관성의 백분율이 축 제목에 표시됩니다.
- Contingency Table — 분할표 입력의 경우 표시됩니다. 분석에 사용된 표입니다.
- Chi-square, DF and P-value — 행과 열 간 연관성에 대한 검정입니다.
- Analysis of Contingency Table — 각 축의 관성, 비율, 누적 비율을 텍스트 히스토그램과 함께 보여 주며, 총 관성도 포함합니다.
- Row Contributions and Column Contributions — ID, Name, Qual, Mass, Inert, 그리고 보고된 각 성분의 Coord, Corr, Contr입니다.
- Download를 통한 PDF 내보내기.
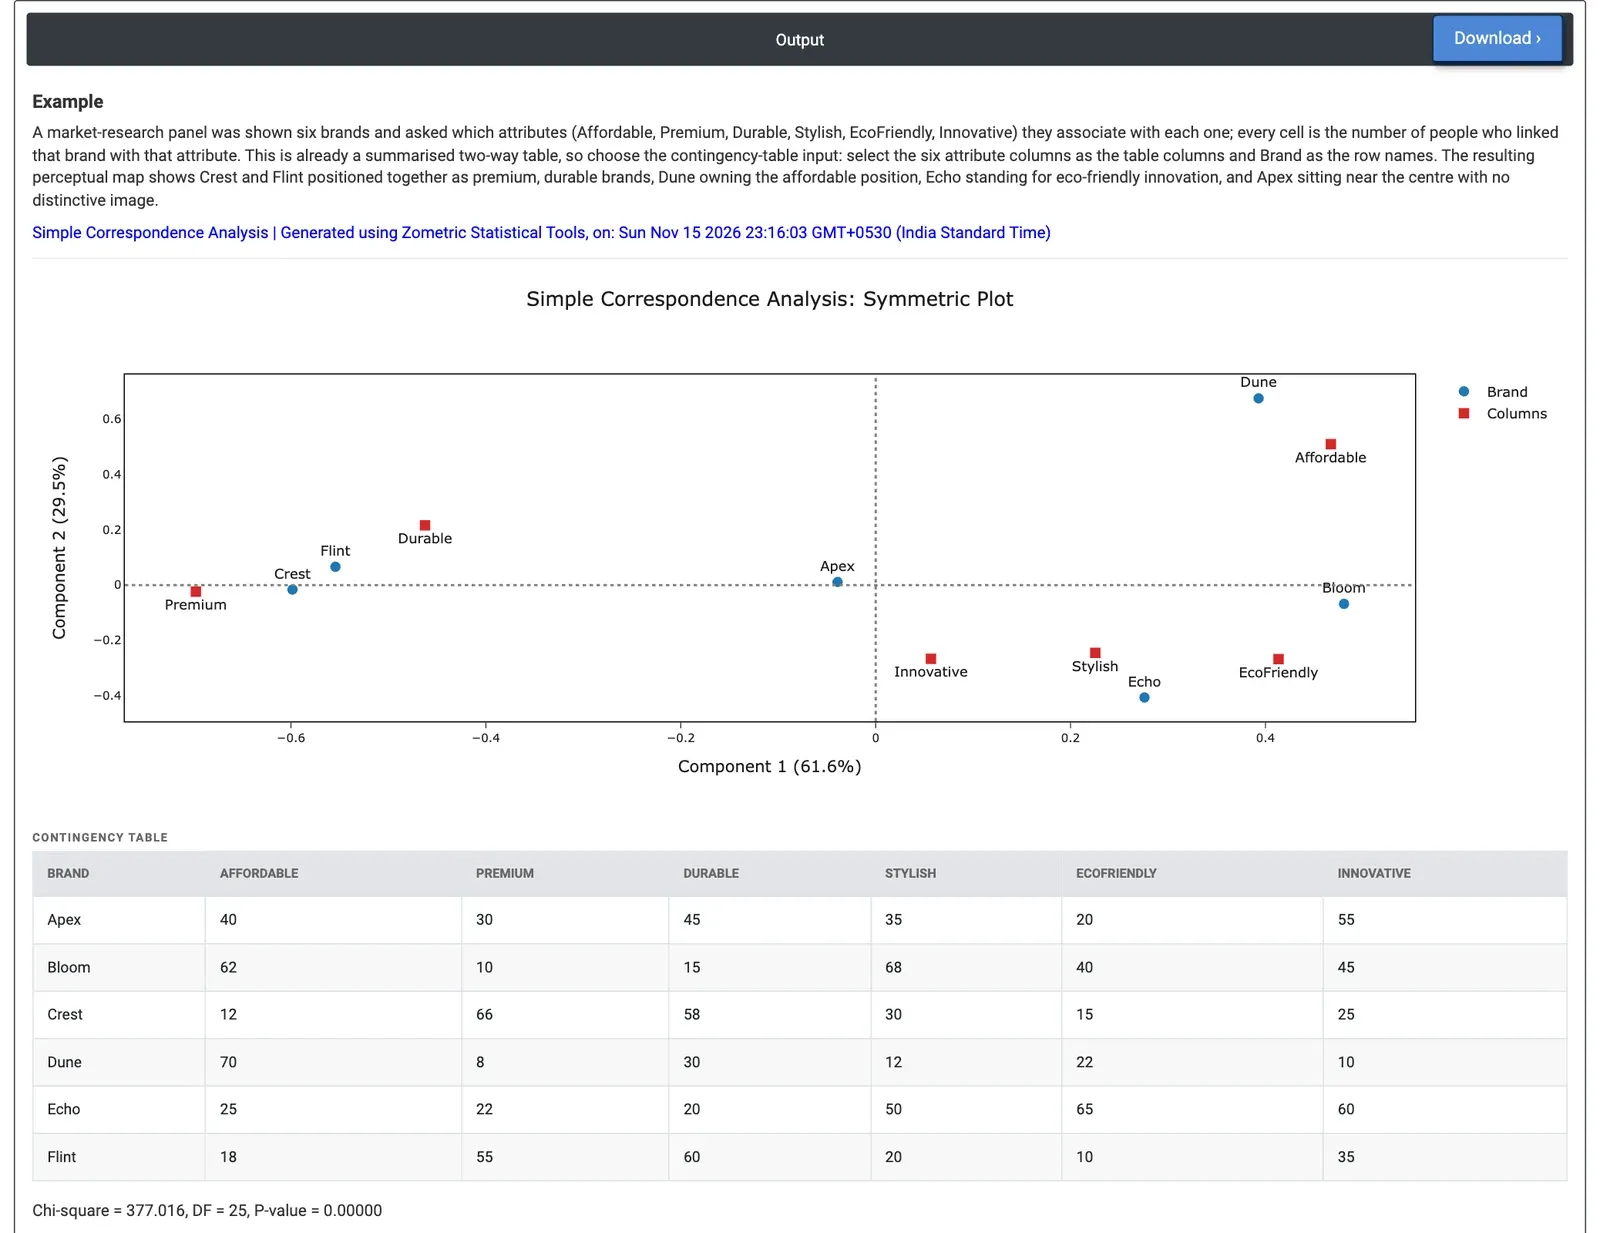
그림 2 — 브랜드 여섯 개와 속성 여섯 개의 대칭 그림: Crest와 Flint는 Premium, Durable과 가까이 있고, Dune은 Affordable과, Echo는 EcoFriendly 근처에 있습니다. 카이제곱은 377.0, 자유도 25입니다.
계산 예제
시장 조사 패널에게 브랜드 여섯 개(Apex, Bloom, Crest, Dune, Echo, Flint)를 보여 주고, 각 브랜드와 연결하는 속성을 여섯 가지(Affordable, Premium, Durable, Stylish, EcoFriendly, Innovative) 중에서 묻습니다. 각 셀에는 해당 브랜드를 해당 속성과 연결한 사람 수가 들어 있습니다. 마케팅 팀은 각 브랜드의 위치를 보고자 합니다. 데이터가 이미 도수의 표이므로, 이들은 Input data = Columns of a contingency table로 설정하고 속성 열 여섯 개를 Contingency table columns로 선택하며 Brand를 Row names로 선택하고, 행과 열의 대칭 그림은 그대로 둡니다.
카이제곱은 377.016, 자유도는 25(p < 0.00001)이므로 브랜드 이미지는 브랜드 간에 분명히 다릅니다. Component 1이 관성의 61.6%를, Component 2가 29.5%를 차지하므로 2차원 지도는 패턴의 91.1%를 보여 줍니다. Component 1은 왼쪽의 Premium(−0.698)과 Durable(−0.462)에서 오른쪽의 Affordable(0.467)과 EcoFriendly(0.414)로 이어집니다. Crest(−0.599)와 Flint(−0.554)는 프리미엄하고 내구성 있는 쪽에 있으며 이 축에서 거의 완벽하게 표현됩니다(Corr 0.94와 0.98). Dune은 Component 2에서 높은 위치(0.674)에 있어 Affordable 옆에 놓이며, 해당 성분 관성의 62.2%를 차지합니다. Echo(0.276, −0.406)는 EcoFriendly, Stylish, Innovative 근처에 있고, Bloom(0.481)은 Stylish와 Affordable 쪽으로 치우쳐 있습니다.
Apex는 중심 근처(−0.039, 0.011)에 있고 품질은 0.038에 불과합니다. 이 브랜드의 프로파일은 모든 브랜드의 평균에 가까워서 뚜렷한 이미지가 없습니다. 팀에게 의미하는 바는, Crest와 Flint는 같은 프리미엄, 내구성 포지션을 두고 경쟁하고, Dune은 저렴한 포지션을 차지하며, Apex는 더 명확한 메시지가 필요한 브랜드라는 것입니다.
자주 묻는 질문
대응 분석은 무엇에 사용합니까?
큰 교차표의 패턴을 한눈에 보는 데 사용하며, 예를 들어 어떤 결점 유형이 어떤 기계와 함께 나타나는지, 어떤 불만 범주가 어떤 제품과 함께 나타나는지, 고객이 어떤 속성을 어떤 브랜드와 연결하는지를 볼 수 있습니다. 행 범주와 열 범주는 점으로 그려지며, 우연보다 더 자주 함께 나타나는 범주는 서로 가까이 놓입니다.
대응 분석에서 관성이란 무엇입니까?
관성은 표의 연관성을 측정합니다. 각 성분, 즉 지도의 축은 특잇값의 제곱과 같은 관성을 가지며, 총 관성은 카이제곱 통계량을 총합 n으로 나눈 값과 같습니다. 관성 표는 각 성분이 설명하는 비율을 보여 주며, 브랜드 예제에서는 처음 두 성분이 패턴의 91.1%를 보여 주었습니다.
품질, 질량, 기여도는 어떻게 해석합니까?
Mass는 전체 도수에서 범주가 차지하는 비중, Inert는 총 관성에서 차지하는 비중, Corr는 한 성분이 해당 점을 얼마나 잘 나타내는지, Qual은 보고된 성분에 대한 Corr의 합, Contr는 한 성분의 관성에서 해당 점이 차지하는 비중입니다. 예제의 Apex처럼 중심 근처에 있으면서 품질이 낮은 점은 프로파일이 평균에 가깝습니다.
대칭 그림과 비대칭 그림의 차이는 무엇입니까?
대칭 그림은 행과 열을 모두 주좌표로 함께 나타내며 기본값으로 선택되어 있습니다. 비대칭 행 그림은 행을 주좌표로, 열을 표준좌표(주좌표를 특잇값으로 나눈 값)로 나타내고, 비대칭 열 그림은 그 반대입니다. 행만 또는 열만 나타내는 그림도 사용할 수 있습니다.