
교차 분류 및 카이제곱(Cross Tabulation and Chi-Square)
레코드당 한 행으로 도수의 이원표를 작성하며, 행, 열, 전체 백분율을 선택적으로 추가할 수 있습니다. Pearson 및 우도비 카이제곱으로 연관성을 검정하고, 기대 도수, 잔차, 셀 기여도를 확인하며, Cramér의 V-제곱으로 연관성의 강도를 측정합니다. Fisher의 정확 검정은 2x2 표에 사용합니다. 기대 도수가 5 미만이면 주석이 표시됩니다. 층 변수를 지정하면 수준마다 표가 하나씩 생성됩니다.
최종 검토
핵심 요점
교차 분류 및 카이제곱은 원시 레코드에서 두 범주형 변수의 각 조합이 나타나는 횟수를 세고 두 변수가 서로 관련되어 있는지 검정하며, 세 번째 변수로 층을 나누어 분석할 수도 있습니다.
목적
교차 분류 및 카이제곱은 부서와 만족도 수준, 결점 유형과 라인, 공급업체와 합격/불합격처럼 원시 레코드에서 두 범주형 변수의 각 조합이 나타나는 횟수를 세고, 두 변수가 서로 관련되어 있는지 검정합니다. 세 번째 변수로 분석을 층으로 나눌 수 있으며, 예를 들어 교대조별로 표를 하나씩 만들 수 있습니다.
주요 기능
- 레코드당 한 행으로 작성되는, 행 합계와 열 합계가 있는 도수의 이원표.
- 층 지정 시: 세 번째 변수의 값마다 별도의 표와 검정.
- 행, 열, 전체 백분율.
- Pearson 카이제곱 검정(기본으로 켜짐)과 우도비 카이제곱.
- 기대 도수, 원 잔차, 표준화 잔차, 수정 잔차, 그리고 각 셀의 카이제곱 기여도.
- Cramér의 V-제곱과 2×2 표에 대한 Fisher의 정확 검정.
- 일부 기대 도수가 5 미만일 때 경고.
통계적 방법
행, 열 또는 층 변수에 결측값이 있는 레코드는 제외됩니다. 행 합계 Rᵢ, 열 합계 Cⱼ, 전체 N이 있는 관측 도수 O의 표에서, 독립 가정 하의 기대 도수는 Eᵢⱼ = Rᵢ·Cⱼ / N입니다. Pearson 통계량 χ² = Σ (O − E)² / E(2×2 표에서도 연속성 수정을 하지 않음)와 우도비 통계량 G² = 2 Σ O·ln(O / E)는 자유도 (r − 1)(c − 1)의 카이제곱 분포와 비교됩니다. p-값이 작으면 행에 따라 열의 구성이 다르다는 뜻입니다.
어느 셀이 결과를 이끄는지 보려면 다음을 사용합니다. 셀의 기여도는 (O − E)² / E이고, 원 잔차는 O − E이며, 표준화 잔차는 (O − E) / √E입니다. 수정 잔차 (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N))는 근사적으로 표준정규분포를 따르므로, 약 ±2를 넘는 값은 독립성과 뚜렷하게 다른 셀을 나타냅니다. Cramér의 V-제곱 = χ² / (N·(min(r, c) − 1))은 연관성의 강도를 0(없음)에서 1(완전)까지로 측정하며, 표본이 크면 약한 연관성도 유의할 수 있습니다.
카이제곱 근사에는 기대 도수가 어느 정도 커야 하며, 이 페이지는 기대 도수가 5 미만인 셀이 몇 개인지 보고합니다. 2×2 표에서는 Fisher의 정확 검정이 이 근사에 의존하지 않는 정확한 p-값을 제공합니다. 범주는 정렬된 순서로 표시됩니다.
입력 항목 및 옵션
항목 | 설명 |
Rows | 표의 행에 해당하는 범주형 열입니다. 필수. |
Columns | 열에 해당하는 범주형 열입니다. 필수이며 Rows와 달라야 합니다. |
For layers | 선택. 이 변수의 값마다 별도의 표와 검정을 생성합니다. |
Row percents / Column percents / Total percents | 백분율 표를 추가합니다. 기본값은 꺼짐입니다. |
Chi-Square test | Pearson 카이제곱 검정입니다. 기본값은 선택됨입니다. |
Likelihood ratio chi-square | 우도비 검정을 추가합니다. |
Expected cell counts / Raw residuals / Standardized residuals / Adjusted residuals / Each cell's contribution to chi-square | 이 표들을 추가합니다. 기본값은 꺼짐입니다. |
Cramer's V-square statistic | 연관성의 강도입니다. |
Fisher's exact test for 2x2 tables | 정확한 p-값이며 2×2 표에 대해서만 보고됩니다. |
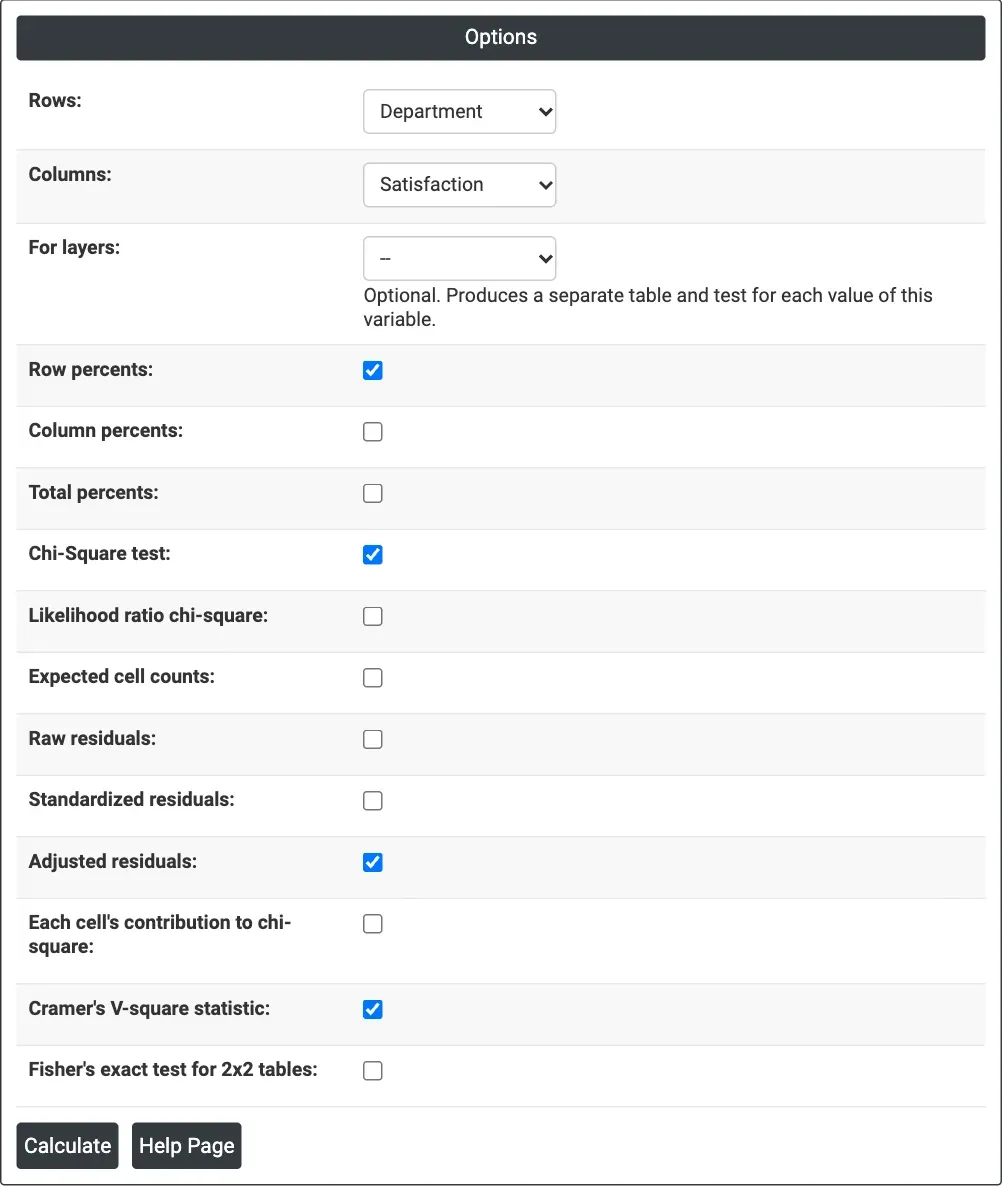
그림 1 — 설문조사 예제의 옵션: Department를 행으로, Satisfaction을 열로 하고, row percents, chi-square test, adjusted residuals, Cramer's V-square를 선택한 설정.
출력 설명
- Counts — All 합계가 있는 도수표(층마다 하나).
- Row percents, Column percents, Total percents, Expected counts, Raw, Standardized and Adjusted residuals, Contribution tables — 선택한 경우에 표시됩니다.
- Chi-Square Test — Pearson 및 우도비 검정의 Chi-Square, DF, P-Value이며, 기대 도수가 5 미만이면 주석이 표시됩니다.
- Other Statistics — Cramer's V-square와 Fisher의 정확 검정 P-Value.
- Download를 통한 PDF 내보내기.
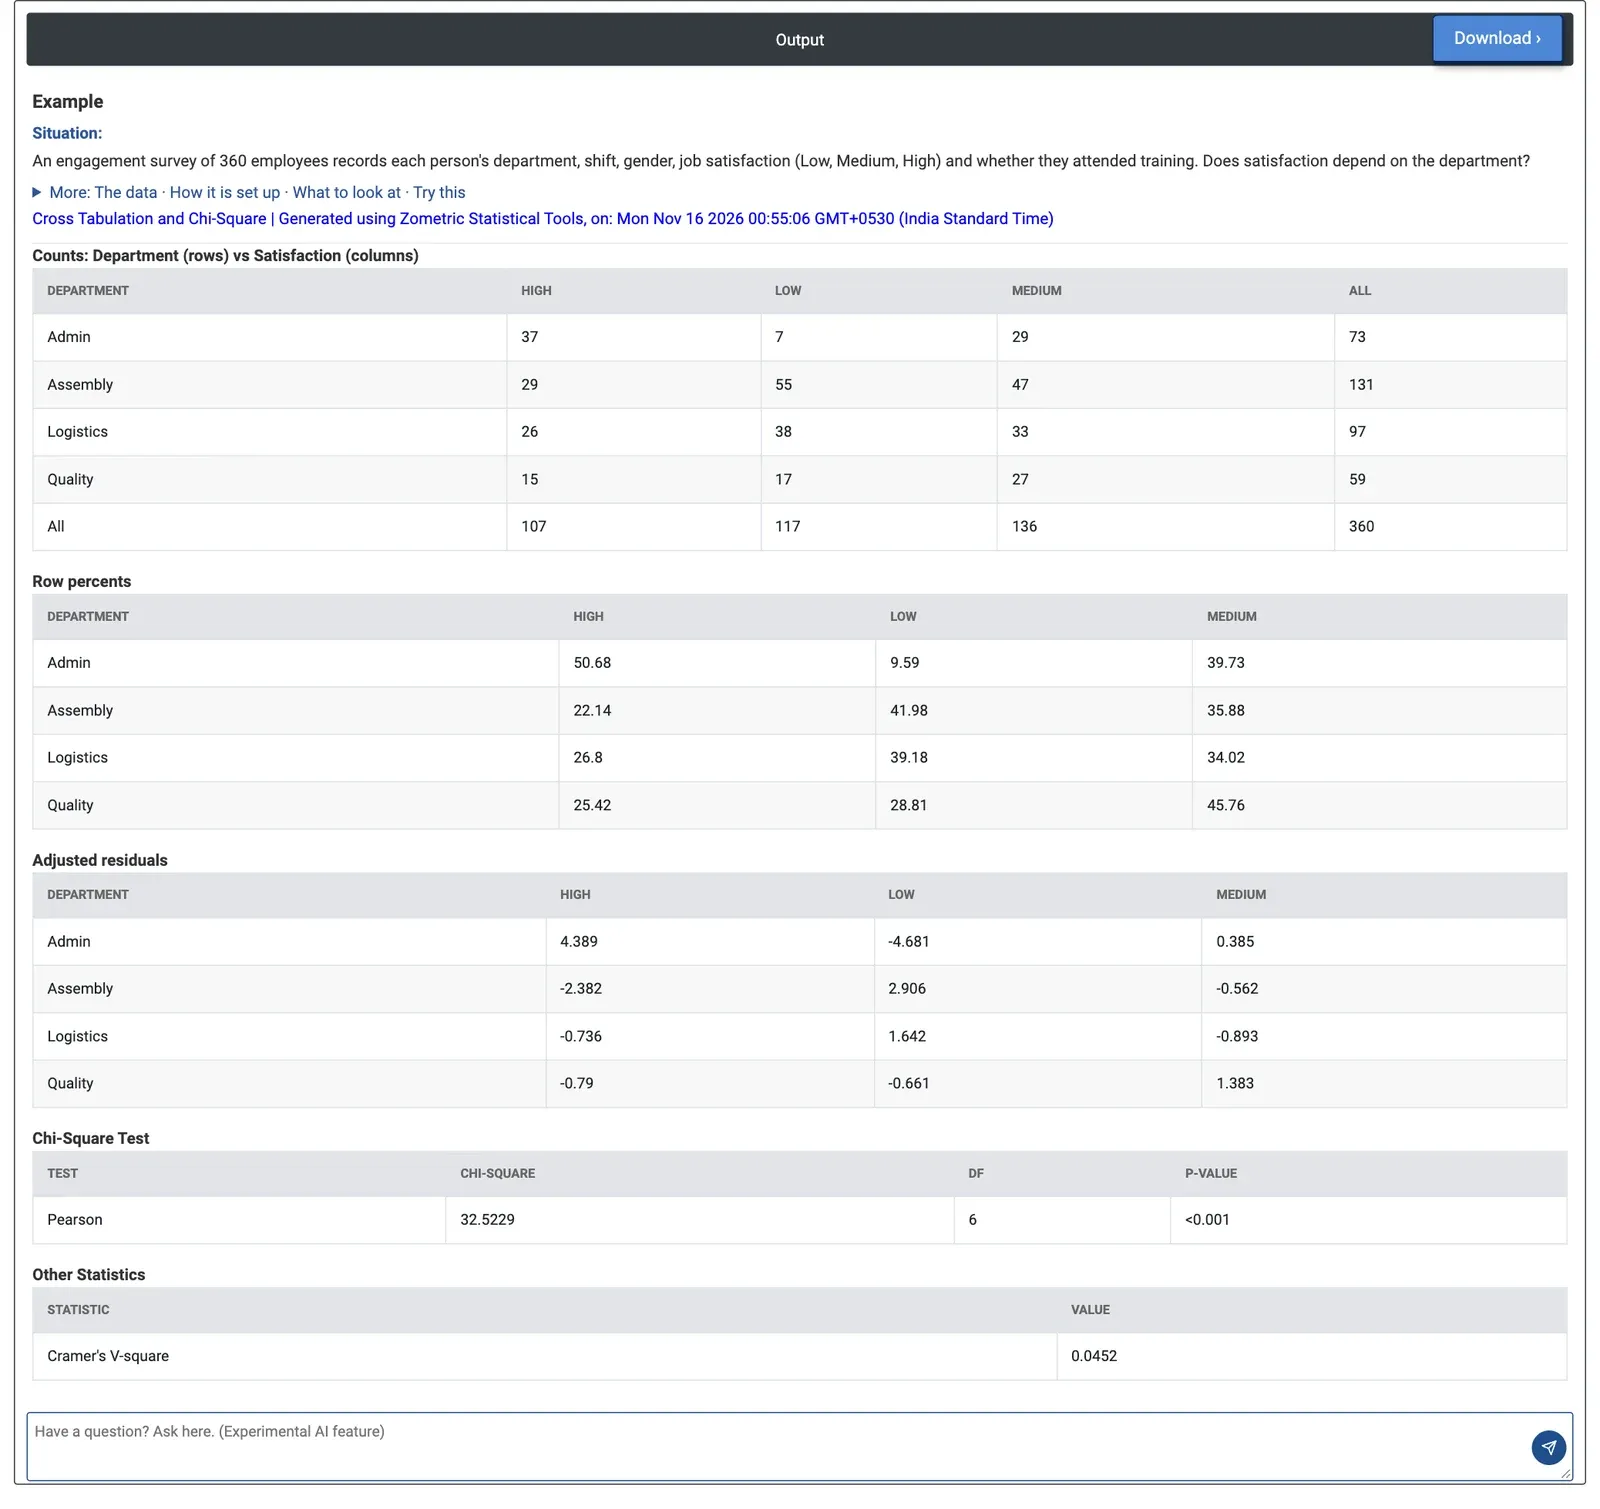
그림 2 — 부서별 만족도: Pearson 카이제곱 32.52, 자유도(DF) 6, p < 0.001. Admin은 High 평가가 가장 많고 Assembly는 Low 평가가 가장 많습니다.
계산 예제
직원 360명을 대상으로 한 참여도 설문조사는 각 직원의 부서, 교대조, 성별, 만족도(Low, Medium, High), 교육 참석 여부를 기록합니다. 인사팀은 만족도가 부서에 따라 달라지는지 알고자 합니다. Department를 행으로, Satisfaction을 열로 선택하고 row percents, adjusted residuals, Cramer's V-square를 선택합니다.
만족도는 부서에 따라 달라집니다. Pearson 카이제곱은 32.52, 자유도 6, p < 0.001입니다. Admin이 가장 만족도가 높아 High가 50.68%, Low는 9.59%에 불과하고, Assembly가 가장 낮아 Low가 41.98%, High가 22.14%입니다. ±2를 넘는 수정 잔차는 결과의 배경이 되는 셀을 보여 줍니다. Admin의 High(+4.389)와 Low(−4.681), Assembly의 Low(+2.906)와 High(−2.382)입니다. Cramér의 V-제곱은 0.0452로, 실재하지만 미미한 연관성입니다.
For layers를 Shift로 설정하면 교대조마다 표가 하나씩 생성됩니다. 야간 교대조에서 Logistics는 High가 4.88%, Low가 53.66%에 불과합니다(High의 수정 잔차 −2.475). 주간 교대조는 High가 42.86%이므로 야간 교대조의 Logistics 팀부터 살펴보아야 하며, 야간 표에는 셀 1개의 기대 도수가 5 미만이라는 주석이 있습니다. 성별 대 교육 참석 여부는 2×2 표이며, Fisher의 정확 검정은 p = 0.5888을 제공하므로 교육 참석 여부가 성별에 따라 다르다는 징후는 없습니다.
자주 묻는 질문
교차 분류와 카이제곱 검정의 차이는 무엇입니까?
교차 분류는 두 범주형 변수의 각 조합이 나타나는 횟수를 세어 행 합계와 열 합계, 선택적 백분율이 있는 이원표를 제공합니다. 이어서 카이제곱 검정이 두 변수가 서로 관련되어 있는지 확인하며, p-값이 작으면 행에 따라 열의 구성이 다르다는 뜻입니다. 세 번째 변수로 분석을 층으로 나눌 수 있습니다.
Cramér의 V-제곱은 무엇을 측정합니까?
Cramér의 V-제곱 = χ² / (N·(min(r, c) − 1))은 연관성의 강도를 0(없음)에서 1(완전)까지로 측정합니다. 표본이 크면 약한 연관성도 통계적으로 유의할 수 있으며, 설문조사 예제에서는 p가 0.001 미만이었는데도 V-제곱이 0.0452로 실재하지만 미미한 연관성이었습니다.
Fisher의 정확 검정은 언제 사용해야 합니까?
카이제곱 근사에는 기대 도수가 어느 정도 커야 하며, 출력은 기대 도수가 5 미만인 셀이 몇 개인지 보고합니다. 2x2 표에서는 Fisher의 정확 검정이 이 근사에 의존하지 않는 정확한 p-값을 제공합니다. 이 검정은 2x2 표에 대해서만 보고됩니다.
어느 셀이 연관성을 이끄는지 어떻게 찾습니까?
각 셀의 카이제곱 기여도 (O − E)² / E와 잔차를 살펴보십시오. 수정 잔차는 근사적으로 표준정규분포를 따르므로, 약 ±2를 넘는 값은 독립성과 뚜렷하게 다른 셀을 나타냅니다. 예제에서는 Admin의 High(+4.389)와 Assembly의 Low(+2.906)가 결과의 배경이 된 셀에 포함되었습니다.