
시계열 분해(Decomposition)
고전적 분해는 중심 이동평균으로 시계열을 평활하고, 기간별 중앙값에서 계절 지수를 구하며, 계절 조정된 데이터에 최소제곱 추세선을 적합한 다음 추세에 지수를 곱하거나 더하여 예측합니다. 승법 또는 가법 모형을 선택합니다. 완전한 계절 두 개 이상과 결측 없는 데이터가 필요합니다. 출력에는 추세식, 계절 지수, MAPE, MAD, MSD, 예측값이 포함됩니다.
최종 검토
핵심 요점
분해는 계절성 시계열을 직선 추세, 반복되는 계절 패턴, 나머지로 나누며, 추세를 연장하고 계절 패턴을 반복하여 예측합니다.
목적
분해는 계절성 시계열을 직선 추세, 반복되는 계절 패턴, 나머지로 나눕니다. “매달 수요가 얼마나 증가하는가?”, “매년 12월은 추세보다 얼마나 높거나 낮은가?”와 같은 질문에 답하며, 추세를 연장하고 계절 패턴을 반복하여 예측합니다. 계절이 안정적인 월별, 분기별 또는 교대 근무 패턴 데이터에 사용하며, 예를 들어 성수기 월에 대비한 생산 능력이나 재고를 계획할 때 유용합니다.
주요 기능
- 승법 모형(각 계절이 추세보다 몇 퍼센트 높거나 낮음) 또는 가법 모형(각 계절이 추세보다 고정된 양만큼 높거나 낮음).
- 계절의 각 기간에 대한 계절 지수와 적합된 추세식.
- 시계열의 끝에서, 또는 알려진 데이터로 방법을 검증하기 위해 이전 행에서 시작하는 임의 기간 수의 예측.
- MAPE, MAD, MSD 정확도 측도.
- 분해 그림(관측값, 추세, 계절, 잔차), Component Analysis 및 Seasonal Analysis 그래프, 선택적 4-in-1 잔차 그림.
- 각 행의 추세, 계절, 추세 제거, 계절 조정, 적합, 오차 값을 담은 전체 결과 표.
통계적 방법
이 도구는 고전적 분해를 사용합니다. 먼저 길이 L(계절 길이)의 중심 이동평균으로 데이터를 평활하며, L이 짝수이면 2×L 평균을 사용하므로 각 값이 시점에 놓입니다. 원시 계절 값은 데이터를 이 평균으로 나눈 값(승법) 또는 뺀 값(가법)입니다. 계절의 각 기간에 대해 원시 값의 중앙값을 구하고, 이 중앙값을 평균이 1(승법) 또는 0(가법)이 되도록 조정한 것이 계절 지수입니다.
이어서 데이터를 계절 조정(지수로 나누거나 뺌)하고, 조정된 데이터에 최소제곱 직선 Yt = b₀ + b₁·t를 적합합니다. 각 행의 적합값은 추세 × 지수(승법) 또는 추세 + 지수(가법)이며, 오차는 두 모형 모두 데이터 − 적합값입니다. 예측은 추세선을 연장하고 해당 기간의 지수를 적용하며, 예측구간은 제공되지 않습니다. 예측 기준점을 지정하면 그 행까지의 데이터로 지수와 추세를 다시 계산합니다. 정확도: MAPE = |오차 / 데이터| × 100의 평균, MAD = |오차|의 평균, MSD = 오차²의 평균.
시계열에는 완전한 계절 두 개 이상과 결측이 없어야 하며, 승법 모형은 모든 값이 0보다 커야 합니다. 계절 변동 폭이 시계열의 수준에 따라 커지면 승법을, 같은 크기로 유지되면 가법을 선택합니다.
입력 항목 및 옵션
항목 | 설명 |
Variable (Y) | 필수 항목입니다. 시간 순서대로 정렬된 수치형 시계열. |
Seasonal length | 필수 항목이며 2 이상이어야 합니다. 한 계절의 기간 수로, 연간 패턴이 있는 월별 데이터는 12, 분기별 데이터는 4입니다. |
Model | Additive(기본값) 또는 Multiplicative. |
First observation is in seasonal period | 기본값은 1입니다. 계절 안에서 첫 행의 위치로, 계절이 1월에 시작하고 데이터가 6월에 시작하는 경우에는 6입니다. |
Number of forecasts | 기본값은 0(없음)이며 최대 1000까지 입력할 수 있습니다. |
Forecast origin (row) | 선택 사항이며 예측을 요청하면 활성화됩니다. 예측은 이 행 다음부터 시작하며 이 행까지의 데이터를 사용합니다. 비워 두면 시계열의 끝입니다. |
Results to display | Summary table(기본값) 또는 Summary table and results table. |
Residual plots (four in one) | 기본값은 선택 해제입니다. 정규 확률도, 적합값 대 잔차, 히스토그램, 순서 대 잔차. |
Component analysis graph / Seasonal analysis graph | 기본적으로 둘 다 선택되어 있습니다. 4분할 그래프 두 개를 추가합니다. |
Title | 출력의 제목입니다. 기본값은 Decomposition입니다. |
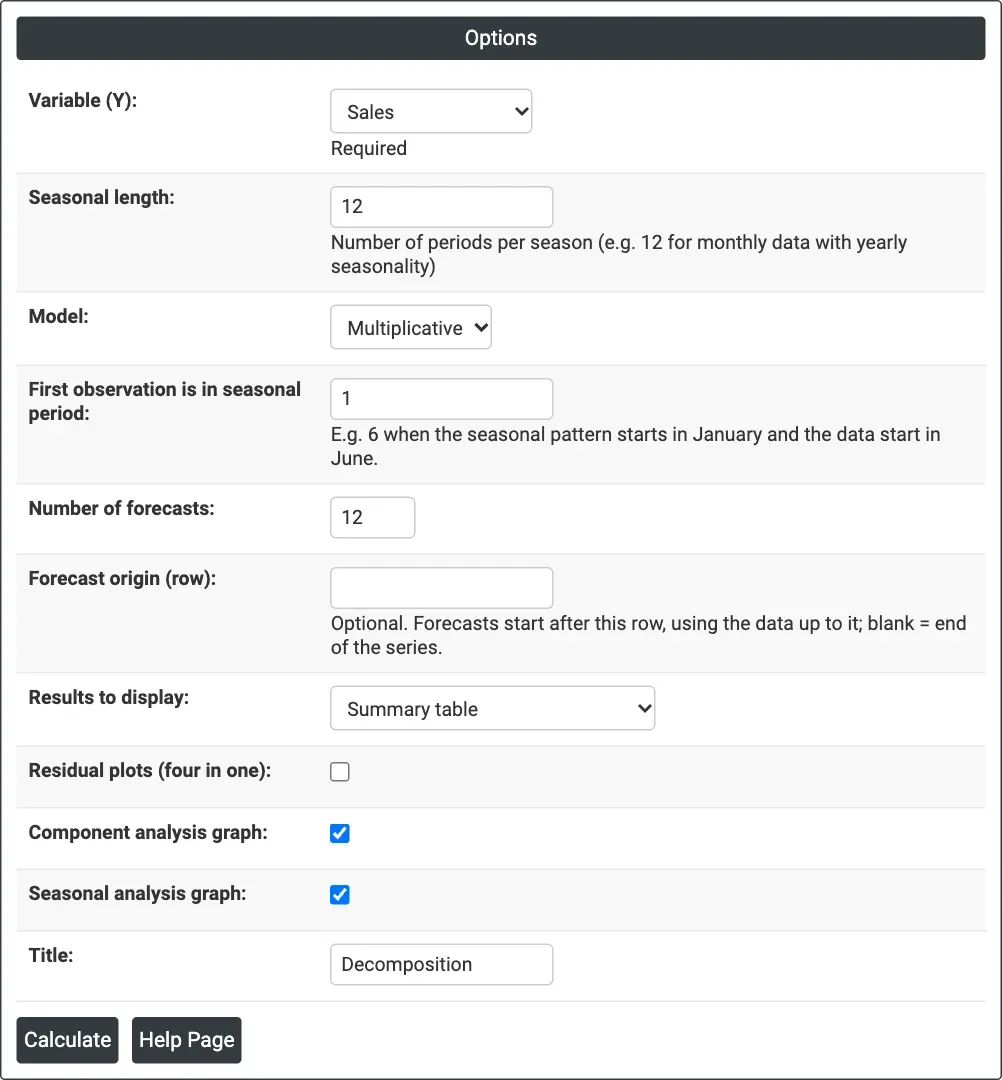
그림 1 — 계절 길이 12와 예측 12개를 사용한 월별 Sales의 승법 분해.
출력 설명
- <Model> Decomposition of <variable> — 네 개의 패널(Observed, Trend, Seasonal, Residual)이며 제목에 MAPE, MAD, MSD가 표시됩니다.
- Component Analysis for <variable> — 네 개의 패널로, Original Data, Detrended Data, Seasonally Adjusted Data, Seasonally Adj. and Detrended Data를 보여 줍니다.
- Seasonal Analysis for <variable> — Seasonal Indices, Detrended Data by Season(상자 그림), Percent Variation by Season, Residuals by Season.
- Residual Plots for <variable> — 선택한 경우.
- Method — 모형 유형, 데이터 열, 길이, 계절 길이(설정한 경우 첫 기간과 예측 기준점 포함).
- Fitted Trend Equation, Seasonal Indices(기간당 하나), Accuracy Measures(MAPE, MAD, MSD), Forecasts(기간과 예측값).
- Results — 선택한 경우 각 행의 Period, data, Trend, Seasonal, Detrend, Deseason, Predict, Error.
- Download를 통한 PDF 내보내기.
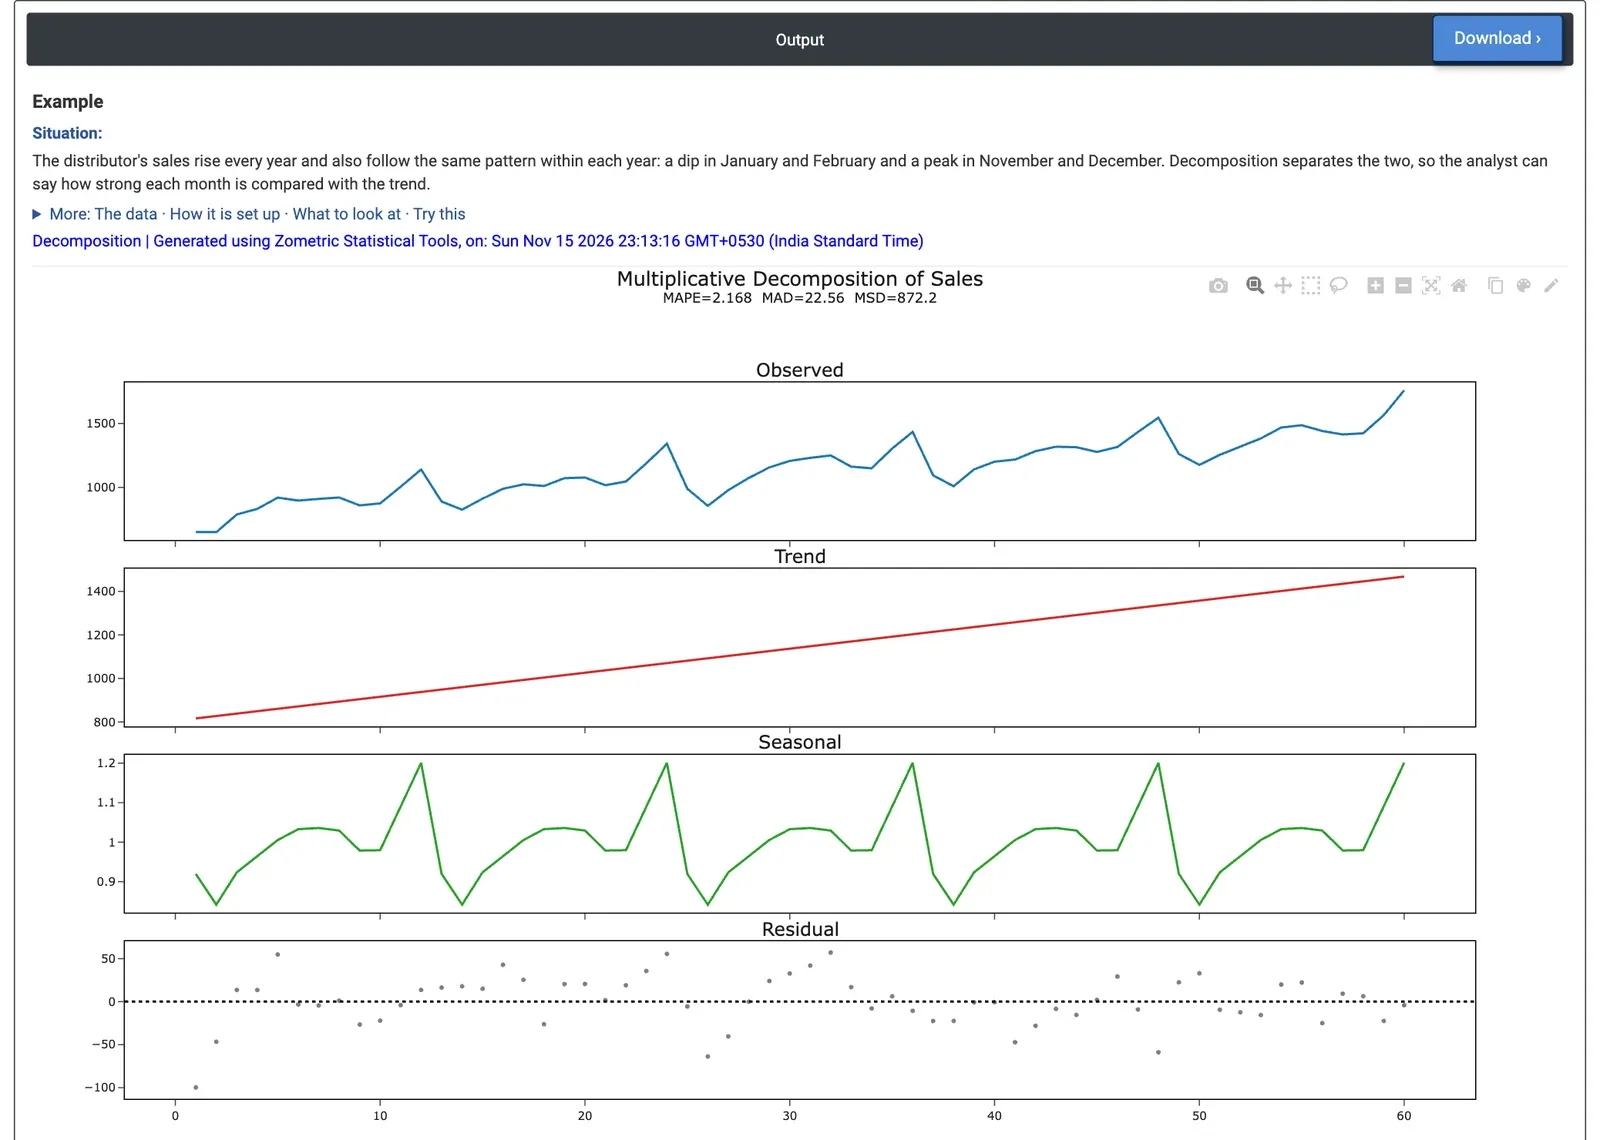
그림 2 — 60개월 판매량의 승법 분해: 상승하는 추세, 매년 반복되는 계절 패턴, 작은 잔차.
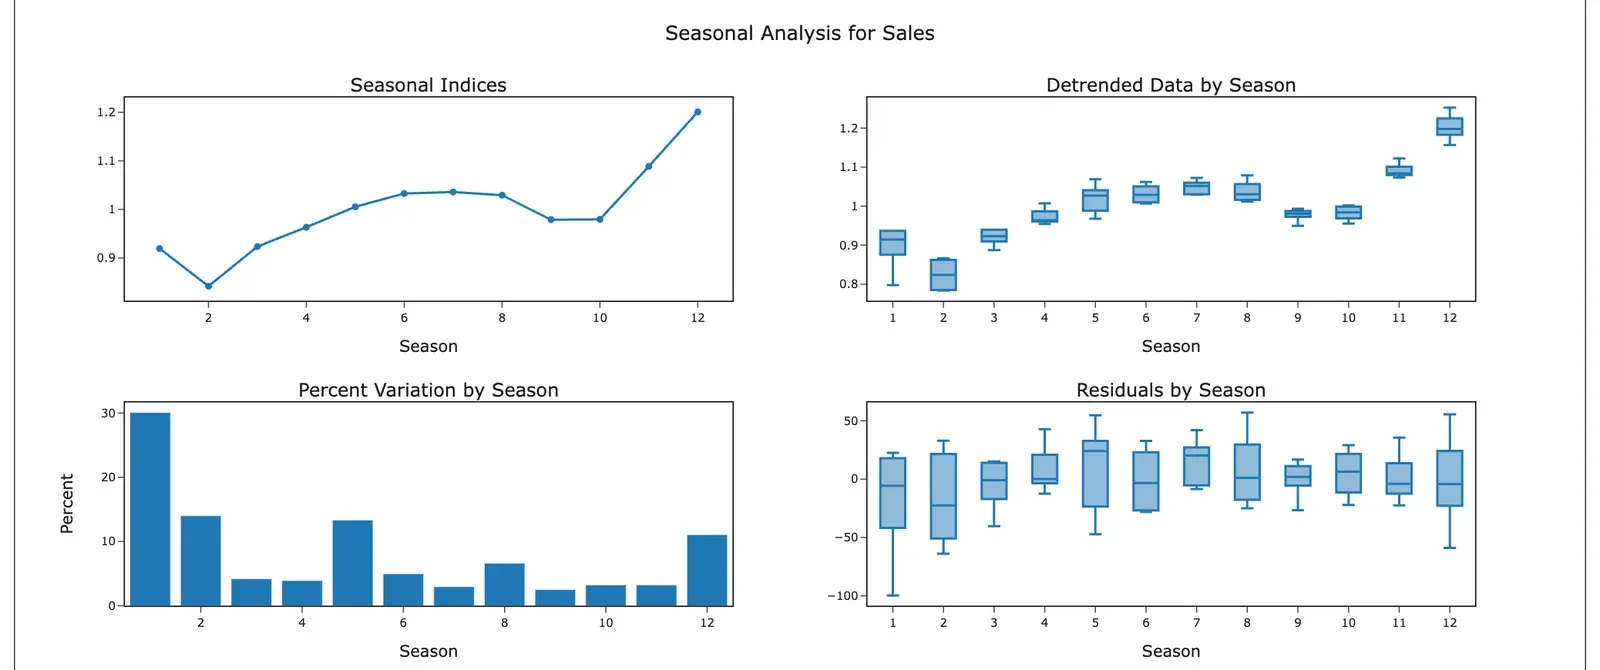
그림 3 — 예제의 Seasonal Analysis: 2월이 가장 낮은 달(지수 0.84)이고 12월이 가장 높은 달(지수 1.20)입니다.
계산 예제
한 가전제품 유통업체의 판매량은 매년 증가하며 연중에도 같은 패턴을 따릅니다. 연초에 하락하고 11월과 12월에 정점을 찍습니다. 판매 분석가는 60개월(2020년 1월~2024년 12월)의 판매 수량 데이터를 가지고 있으며, 각 달이 추세에 비해 얼마나 강한지와 2025년 예측을 알아야 합니다. 분석가는 Variable (Y) = Sales, Seasonal length = 12, Model = Multiplicative, Number of forecasts = 12를 선택합니다.
추세는 Yt = 805.33 + 11.049×t로, 매달 약 11개씩 증가합니다. 계절 지수를 보면 12월은 1.20(추세보다 20% 높음), 11월은 1.09이고, 2월은 0.84(추세보다 16% 낮음), 1월과 3월은 0.92입니다. MAPE는 2.2%(MAD 22.6개)로, Trend Analysis 페이지에서 직선 추세선만 사용했을 때의 7.4%와 비교됩니다. 계절이 직선이 놓친 부분의 대부분을 설명합니다. 2025년 예측값도 같은 모양을 따르며 2월의 1,255개에서 12월의 1,922개까지입니다.
계획 측면에서 이는 12월의 재고와 인력이 추세 수준보다 약 5분의 1 높아야 하고, 2월은 그보다 훨씬 낮게 운영해도 된다는 뜻입니다. Percent Variation by Season 그래프를 보면 1월이 해마다 변동이 가장 크므로 1월 예측이 가장 불확실합니다. Model = Additive에서는 MAPE가 2.21%로 2.17%와 비슷하므로 어느 형태든 이 계절을 설명할 수 있으며, 가법 버전은 각 달에 비율 대신 고정된 수량(12월 +224, 2월 −193)을 부여합니다.
자주 묻는 질문
가법 분해와 승법 분해 중 어느 것을 사용해야 합니까?
계절 변동 폭이 시계열의 수준에 따라 커져서 각 계절이 추세보다 몇 퍼센트 높거나 낮다면 승법을 선택합니다. 변동 폭이 같은 크기로 유지되어 각 계절이 추세보다 고정된 양만큼 높거나 낮다면 가법을 선택합니다. 승법 모형은 모든 값이 0보다 커야 합니다.
계절 지수란 무엇입니까?
계절 지수는 계절의 각 기간이 추세보다 얼마나 높거나 낮은지를 나타냅니다. 승법 모형에서는 지수의 평균이 1이므로, 계산 예제에서 12월의 1.20은 추세보다 20% 높다는 뜻이고 2월의 0.84는 16% 낮다는 뜻입니다. 가법 모형에서는 지수의 평균이 0이며 고정된 양을 나타냅니다.
분해에는 얼마나 많은 데이터가 필요합니까?
시계열에는 완전한 계절 두 개 이상과 결측이 없어야 합니다. 예측은 적합된 추세선을 연장하고 해당 기간의 계절 지수를 적용하며, 예측구간은 제공되지 않습니다. 예측 기준점을 설정하면 그 행까지의 데이터로 지수와 추세를 다시 계산하므로 알려진 데이터로 방법을 검증할 수 있습니다.
분해의 예측 정확도는 어떻게 측정합니까?
Zometric Statistical Software는 평균 절대 백분율 오차인 MAPE, 평균 절대 오차인 MAD, 평균 제곱 오차인 MSD를 보고합니다. 예제에서 MAPE는 2.2%로, 직선 추세선만 사용했을 때의 7.4%와 비교되며, 계절 패턴이 추세선이 놓친 부분의 대부분을 설명했음을 보여 줍니다.