
기술 통계량(Descriptive Statistics)
기술 통계량은 데이터의 핵심 특성을 설명하는 포괄적인 수치 요약 집합을 계산하여 제시하는 기초 분석 도구입니다. 중심 경향(데이터가 어디에 모여 있는지), 산포(데이터가 얼마나 변하는지), 형상(데이터가 어떻게 분포하는지)이라는 세 가지 주요 차원을 다룹니다.
최종 검토
핵심 요점
기술 통계량은 데이터의 핵심 특성인 중심 경향, 산포, 형상을 설명하는 일련의 수치 요약을 계산하여 제시하는 기초 분석 도구입니다.
이 페이지 내용
기술 통계량이란?
기술 통계량은 데이터의 핵심 특성을 설명하는 포괄적인 수치 요약 집합을 계산하여 제시하는 기초 분석 도구입니다. 중심 경향(데이터가 어디에 모여 있는지), 산포(데이터가 얼마나 변하는지), 형상(데이터가 어떻게 분포하는지)이라는 세 가지 주요 차원을 다룹니다.
기술 통계량은 추론이나 예측을 하는 대신 데이터에 이미 있는 내용을 단순히 설명합니다. 일반적으로 모든 통계적 조사의 첫 단계이며, 더 고급 기법을 적용하기 전에 데이터 집합에 대한 명확하고 객관적인 이해를 제공합니다.
기술 통계량은 언제 사용합니까?
- 다른 도구를 적용하기 전에 데이터 집합의 기본 구조와 거동을 파악하기 위해 모든 데이터 분석의 첫 단계 로 사용합니다.
- 간결한 수치 개요가 필요한 팀, 관리자, 이해관계자에게 데이터를 요약하여 명확하게 전달 해야 할 때 사용합니다.
- 여러 집단이나 데이터 집합을 비교 할 때 사용합니다. 각 집단의 기술 통계량은 중심과 산포의 차이를 한눈에 보여 줍니다.
- 공식적인 통계 분석을 진행하기 전에 특이치, 왜도 또는 비정상적인 패턴을 확인 하는 데 사용합니다.
주요 통계량 설명
통계량
알 수 있는 내용
Mean
산술 평균 — 모든 측정값의 균형점
Median
가운데 값 — 평균보다 특이치의 영향을 덜 받음
Standard Deviation
측정값이 평균 주위에 일반적으로 얼마나 퍼져 있는지
Variance
제곱된 산포 — 추가 통계 계산에 사용됨
Minimum / Maximum
데이터 집합에서 관측된 가장 작은 값과 가장 큰 값
Range
최솟값에서 최댓값까지의 전체 산포
Skewness
데이터가 중심의 왼쪽(음수)으로 치우쳤는지 오른쪽(양수)으로 치우쳤는지
Kurtosis
분포의 꼬리가 정규분포보다 두꺼운지 얇은지
N (Sample Size)
분석에 포함된 관측값의 총 개수
기술 통계량의 올바른 사용 지침
- 항상 중심 척도와 산포 척도 를 함께 보고하십시오. 표준편차 없이 평균만 보고하면 불완전한 그림을 줍니다.
- 데이터가 치우쳐 있거나 특이치를 포함하는 경우에는 더 대표성이 있으므로 평균 대신 중앙값을 주된 중심 척도로 사용하십시오.
- 모수적 통계 방법을 적용하기 전에 왜도와 첨도 값을 확인하여 정규성을 가정할 수 있는지 평가 하십시오.
- 표준편차와 왜도 같은 통계량이 안정적이고 의미 있으려면 관측값을 최소 20~30개 수집하십시오.
대안: 기술 통계량을 사용하지 않아야 할 때
상황
대신 사용할 도구
수치와 함께 시각적인 분포 형상이 필요한 경우
그래픽 요약(Graphical Summary)
집단 간 유의한 차이를 검정해야 하는 경우
가설검정(t 검정, ANOVA)
변수 간 관계를 파악해야 하는 경우
상관 또는 회귀분석
데이터가 범주형(레이블, 집단)인 경우
막대 그래프
시간에 따른 추세나 이동을 탐지해야 하는 경우
런 차트 또는 관리도
기술 통계량 예제
한 품질관리 엔지니어가 샴푸 병의 뚜껑이 올바르게 체결되었는지 확인해야 합니다. 뚜껑이 너무 느슨하게 체결되면 운송 중에 빠질 수 있고, 너무 꽉 체결되면 열기 어려울 수 있습니다. 뚜껑 체결의 목표 토크 값은 18입니다. 엔지니어는 병 68개를 무작위로 표본 추출하여 뚜껑을 여는 데 필요한 토크를 시험합니다. 단계는 다음과 같습니다.
- 필요한 데이터를 수집했습니다.
- 이제 Zometric Statistical Software에서 데이터를 분석합니다: https://statsai.zometric.com/.
- Descriptive Statistics를 찾으려면 Statistical module> Graphical analysis > Descriptive Statistics를 선택합니다.
- 도구 안에서 다음과 같이 데이터와 다른 입력값을 입력합니다.
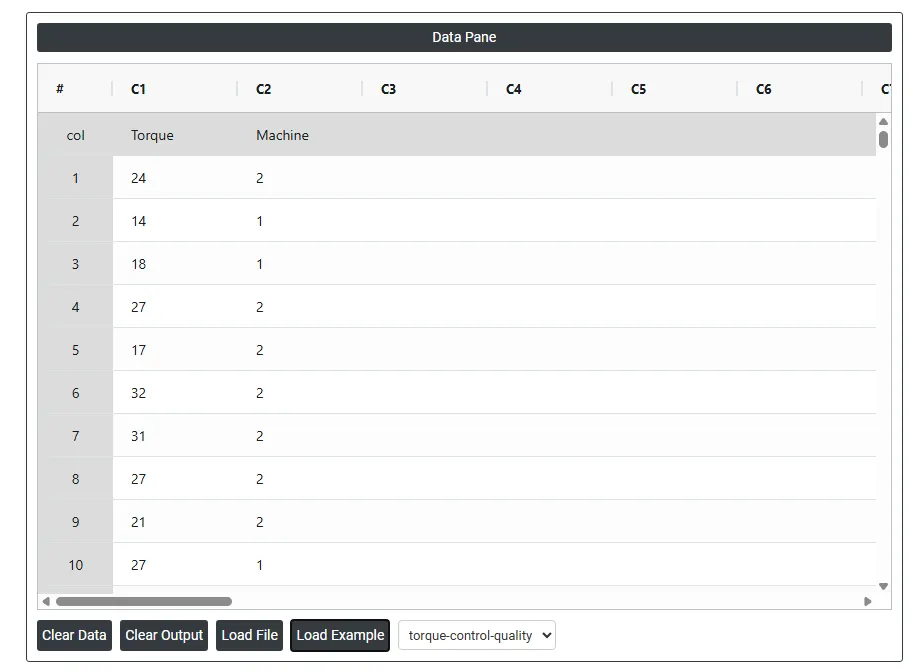
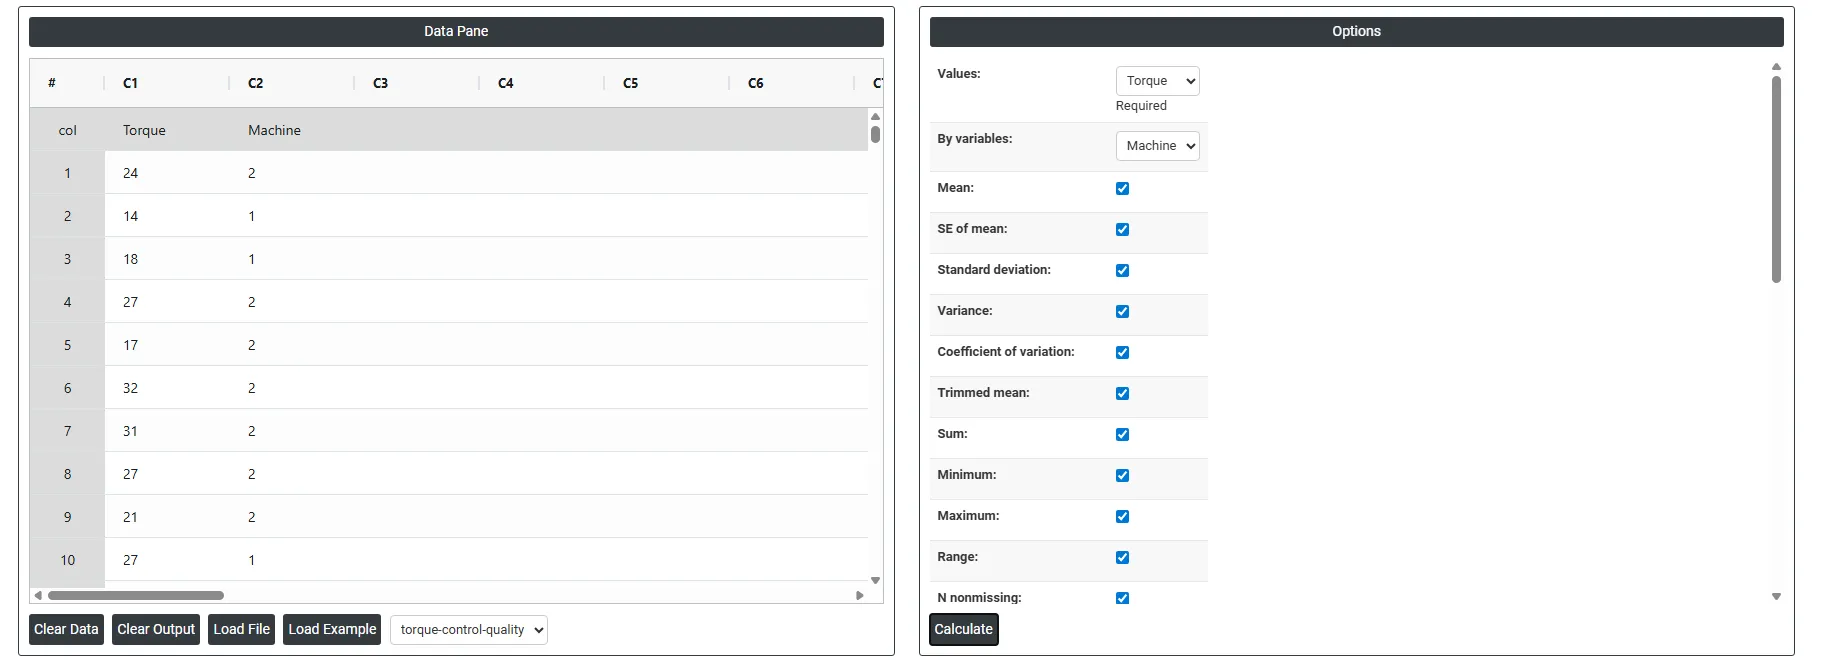
6. 위의 도구를 사용하면 다음과 같은 출력을 얻습니다.
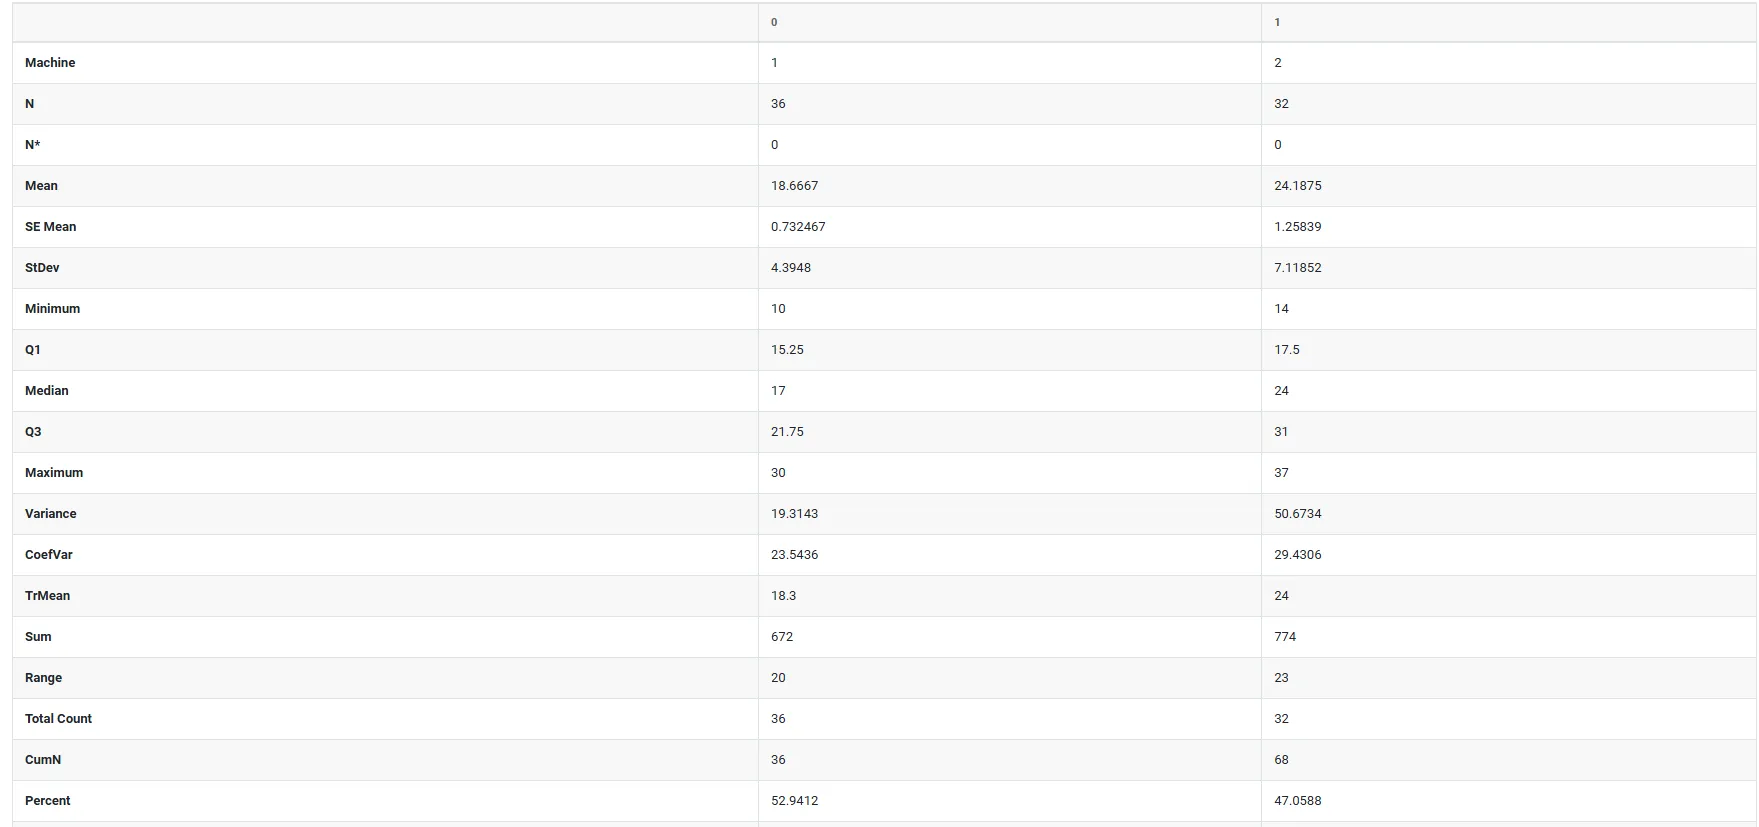
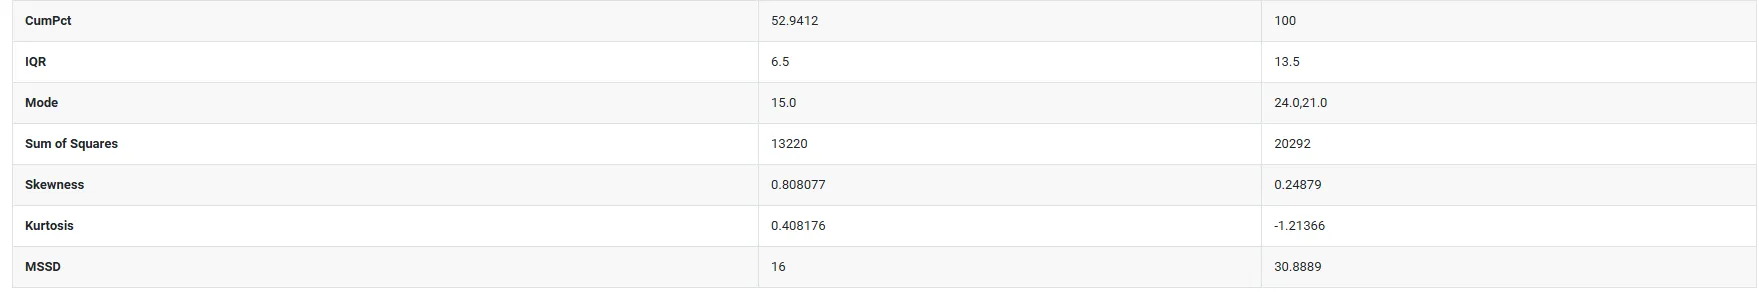
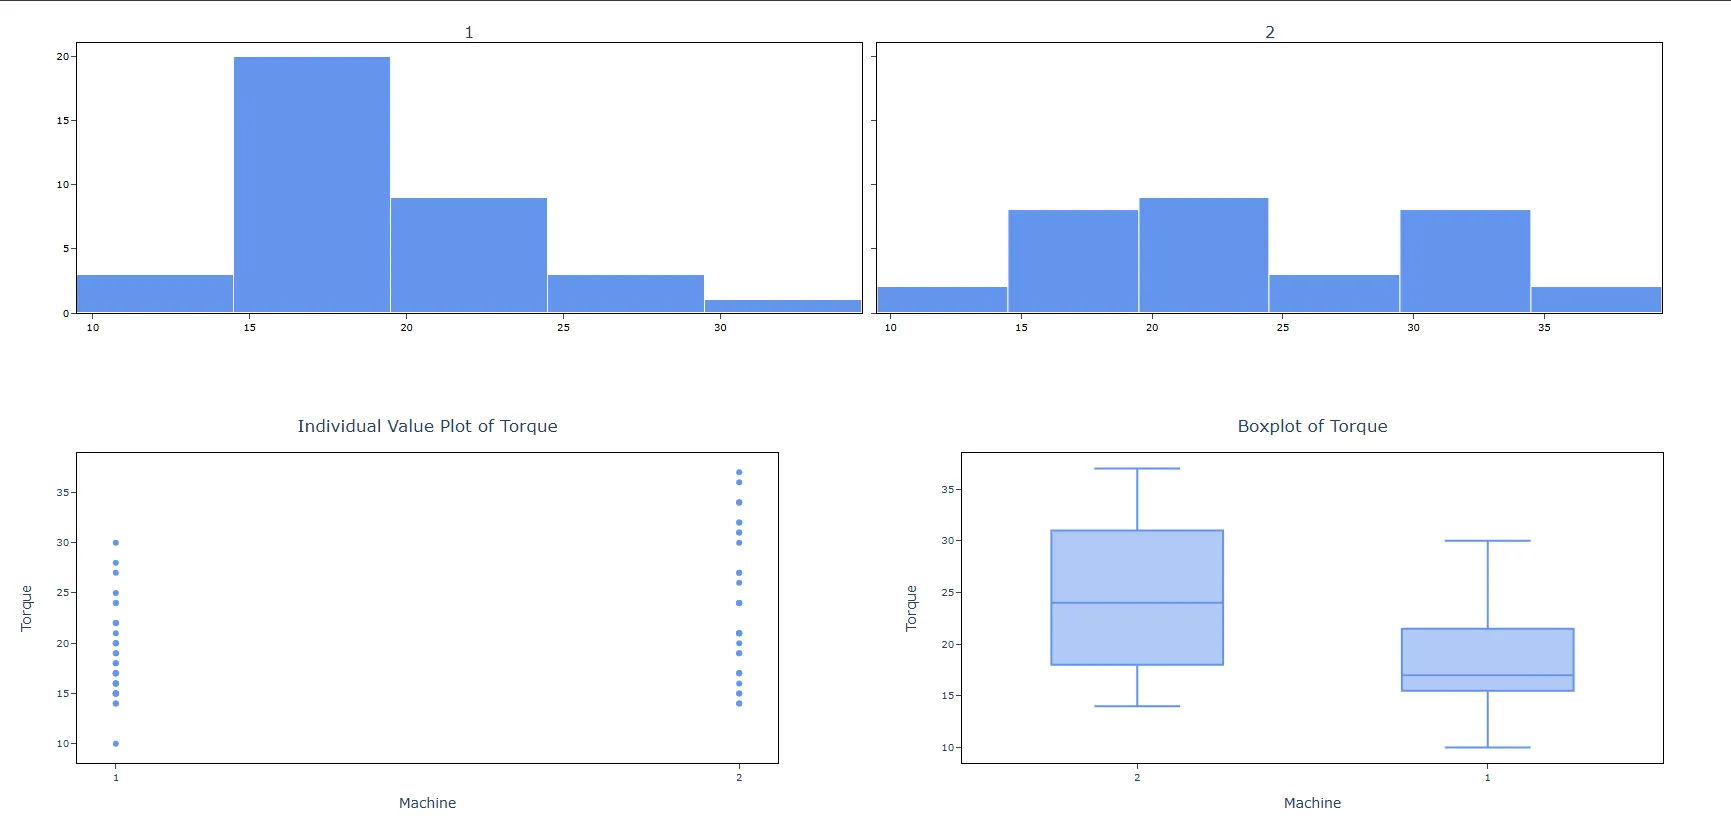
기술 통계량 방법
절차는 다음과 같습니다.
- Zometric Statistical Software에 로그인합니다: https://statsai.zometric.com/
- 홈 페이지에서 Statistical Tool> Graphical analysis > Descriptive Statistics를 선택합니다.
- 다음으로, 데이터를 직접 업데이트하거나 Excel 시트에서 데이터를 복사(Ctrl+C)하여 붙여넣거나(Ctrl+V), 예제 데이터를 로드하는 Load Example 옵션을 사용합니다.
- 다음으로, 필요한 옵션을 입력합니다.
- 마지막으로, 페이지 하단의 calculate를 클릭하면 원하는 결과를 얻을 수 있습니다.
Descriptive Statistics의 도구 화면은 두 부분으로 나뉩니다.
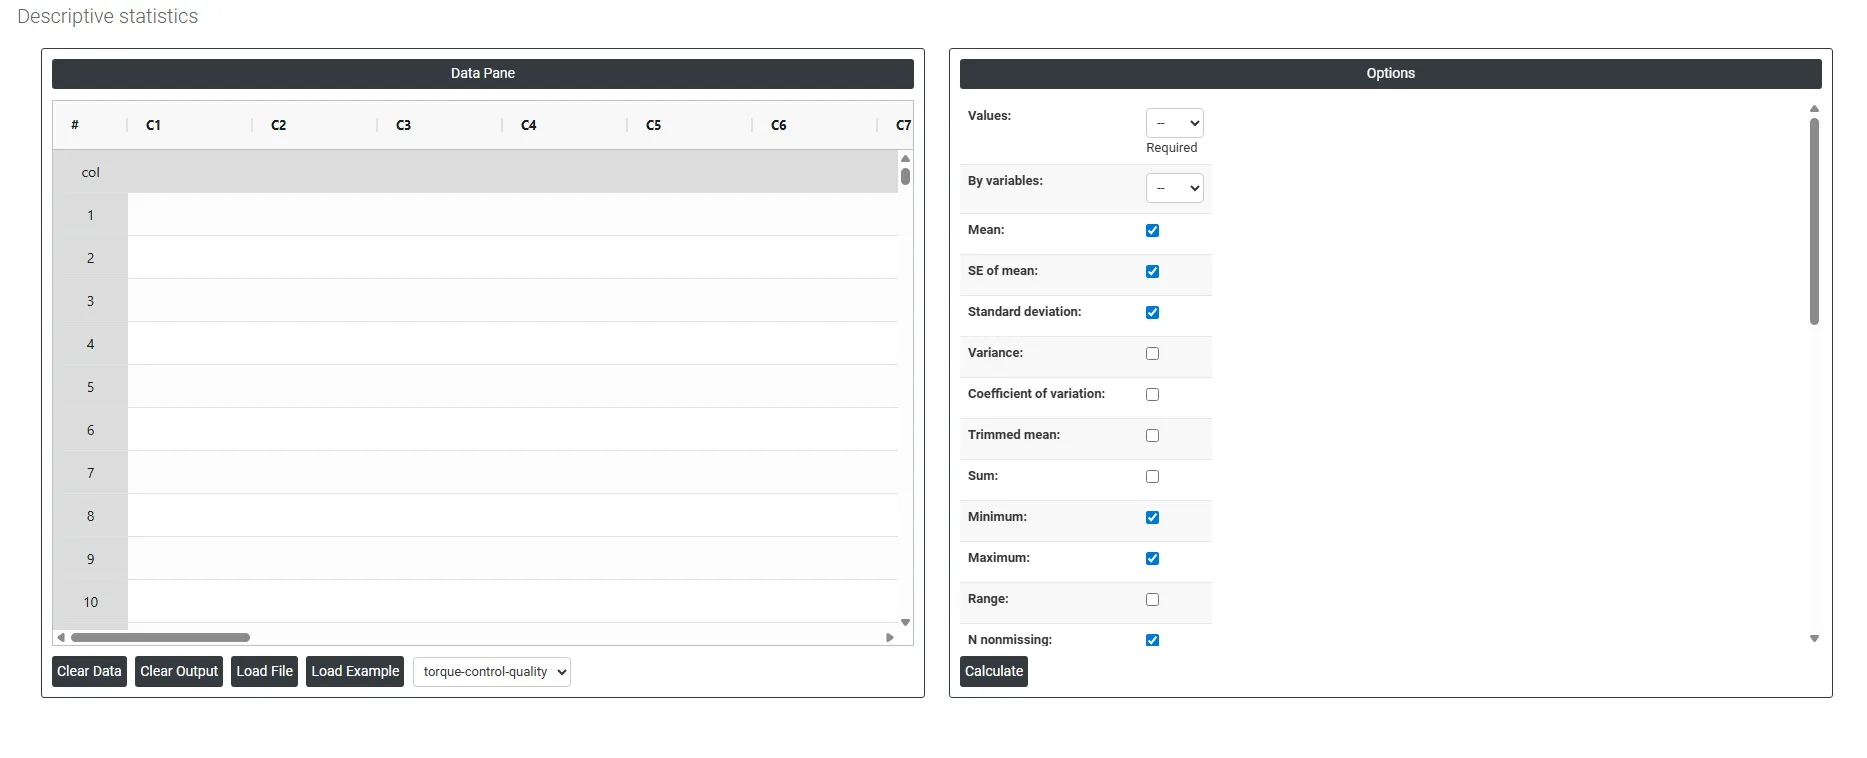
왼쪽 부분에는 데이터 창(Data Pane)이 있습니다. Data Pane에서는 각 행이 하나의 부분군을 이룹니다. 데이터를 직접 입력하거나 Excel 시트에서 복사(Ctrl+C)하여 여기에 붙여넣을(Ctrl+V) 수 있습니다.
Load example: 예제 데이터가 로드됩니다.
Load File: Excel 데이터를 직접 로드하는 데 사용합니다.
오른쪽 부분에서는 다음 항목만 지정하면 됩니다.
Values: 분석하려는 실제 데이터가 들어 있는 변수입니다. 예를 들어 토크 측정값 또는 기계이며, 해당 열을 선택합니다.
By Variables: 선택적인 그룹화 변수입니다. 선택하면 통계량이 그룹별로 따로 계산되므로(예: 기계 유형별) 그룹을 나란히 비교할 수 있습니다.
Mean: 산술 평균입니다. 모든 값을 더한 뒤 개수로 나눕니다. 데이터가 어디에 위치하는지 요약하는 가장 일반적인 방법입니다.
SE of mean (Standard Error of the Mean): 표본 평균이 실제 모집단 평균과 얼마나 다를 수 있는지를 추정합니다. SE가 작으면 평균 추정값이 신뢰할 만하고, 크면 불확실성이 더 크다는 뜻입니다.
Trimmed mean: 가장 낮은 값과 가장 높은 값의 작은 비율을 제거한 뒤 계산한 평균입니다. 극단적인 특이치의 영향을 줄여 더 안정적인 중심 추정값을 제공합니다.
Median: 모든 데이터 점을 순서대로 정렬했을 때의 가운데 값입니다. 값의 절반은 이보다 위에, 절반은 아래에 있습니다. 데이터가 치우쳐 있거나 특이치를 포함할 때 평균보다 더 신뢰할 수 있습니다.
Mode: 데이터 집합에서 가장 자주 나타나는 값입니다. 가장 흔한 측정값이나 범주를 식별하는 데 유용합니다.
Sum: 모든 값을 더한 총합입니다. 평균뿐 아니라 누적량이 중요할 때 유용합니다.
Standard deviation: 각 데이터 점이 평균에서 떨어진 평균 거리를 측정합니다. 값이 작으면 데이터가 촘촘히 모여 있고, 크면 넓게 퍼져 있다는 뜻입니다.
Variance: 표준편차의 제곱입니다. 직접 해석하기는 덜 직관적이지만 내부적으로 많은 통계 계산과 검정에 사용됩니다.
Coefficient of variation (CV): 표준편차를 평균에 대한 백분율로 나타냅니다(SD ÷ Mean × 100). 단위가 다르거나 평균 크기가 크게 다른 데이터 집합 사이의 변동성을 비교할 수 있게 해 줍니다.
Range: 가장 단순한 산포 측도로, 최댓값에서 최솟값을 뺀 값입니다. 이해하기 쉽지만 하나의 극단값에 매우 민감합니다.
Interquartile range (IQR): 데이터의 가운데 50%의 산포입니다(Q3 빼기 Q1). 상위 25%와 하위 25%를 무시하므로 특이치에 강하며 일반적인 산포의 신뢰할 수 있는 척도입니다.
MSSD (Mean of Successive Squared Differences): 데이터를 수집한 순서에서 연속된 데이터 점 사이의 변동성을 측정합니다. 공정 모니터링과 시계열 데이터에서 공정이 불안정한지, 시간이 지남에 따라 드리프트하는지 탐지하는 데 특히 유용합니다.
Sum of squares: 각 값을 제곱하여 더한 합입니다. 그 자체로는 직접 해석할 수 없지만, 분산, 회귀분석, ANOVA 계산에서 내부적으로 사용되는 핵심 구성 요소입니다.
Minimum: 전체 데이터 집합에서 가장 작은 값입니다.
Maximum: 전체 데이터 집합에서 가장 큰 값입니다.
First quartile (Q1): 25번째 백분위수입니다. 전체 값의 4분의 1이 이 점 이하에 있습니다.
Third quartile (Q3): 75번째 백분위수입니다. 전체 값의 4분의 3이 이 점 이하에 있습니다.
N nonmissing: 유효한 기록 값이 있어 분석에 포함된 데이터 점의 개수입니다.
N missing: 값이 없는(공백 또는 null) 데이터 점의 개수입니다. 결측 개수가 많으면 데이터 수집에 문제가 있을 수 있습니다.
N total: 전체 행 수이며 N nonmissing + N missing과 같습니다.
Cumulative N: 행 또는 그룹을 따라 내려가면서 관측값을 누적한 값입니다.
Percent: 각 그룹의 개수를 전체 관측값 수에 대한 백분율로 나타낸 값입니다.
Cumulative Percent: 백분율의 누적 합계입니다. 마지막 행은 항상 100%에 도달합니다.
Skewness: 분포가 평균을 중심으로 얼마나 비대칭인지를 측정합니다.
- 0 = 완전히 대칭
- 양수 = 꼬리가 오른쪽으로 뻗음(매우 높은 소수의 값이 평균을 끌어올림)
- 음수 = 꼬리가 왼쪽으로 뻗음(매우 낮은 소수의 값이 평균을 끌어내림)
Kurtosis: 분포의 꼬리가 정규(종 모양) 분포에 비해 얼마나 두껍거나 얇은지를 측정합니다.
- 높은 첨도 = 예상보다 극단적인 특이치가 많음
- 낮은 첨도 = 극단값이 적고 분포가 더 평평함
Histogram of data: 값이 정해진 구간(bin) 안에 얼마나 자주 속하는지 보여 주는 막대 그래프입니다. 데이터가 정규인지, 치우쳐 있는지, 쌍봉인지 등 전체 형상을 보는 데 가장 적합합니다.
Individual value plot: 모든 데이터 점을 수직선 위의 개별 점으로 그립니다. 숨겨지거나 평균으로 처리되는 것이 없습니다. 특이치를 찾고 데이터의 실제 원시 산포를 보는 데 가장 적합합니다.
Boxplot of data: 중앙값, Q1, Q3, 특이치를 하나의 간결한 그림으로 요약하는 상자-수염 그림입니다. 여러 집단의 산포와 중심을 나란히 비교하는 데 매우 좋습니다.
Show variables as columns: 결과 표를 전치하여 각 변수가 행이 아니라 열이 되도록 합니다. 많은 변수를 비교하면서 나란히 배치하여 쉽게 비교하려 할 때 특히 유용합니다.
Download as Excel: 결과를 Excel 형식으로 표시하며, 이를 쉽게 편집한 뒤 load file 옵션으로 다시 불러와 계산할 수 있습니다.
자주 묻는 질문
기술 통계량이란 무엇입니까?
기술 통계량은 데이터 집합의 핵심 특성을 중심 경향(데이터가 어디에 모여 있는지), 산포(얼마나 변하는지), 형상(어떻게 분포하는지)이라는 세 가지 차원에서 나타내는 수치 요약입니다. 추론을 하는 대신 데이터에 이미 있는 내용을 설명하며, 일반적으로 모든 통계적 조사의 첫 단계입니다.
평균과 중앙값 중 무엇을 사용해야 합니까?
데이터가 치우쳐 있거나 특이치를 포함할 때는 중앙값이 극단값의 영향을 평균보다 덜 받으므로 중앙값을 주된 중심 척도로 사용하십시오. 항상 중심 척도를 산포 척도와 함께 보고하십시오. 표준편차 없이 평균만 보고하면 불완전한 그림을 줍니다.
왜도와 첨도는 무엇을 알려 줍니까?
왜도는 비대칭성을 측정하며, 0이면 대칭이고 양수이면 꼬리가 오른쪽으로, 음수이면 왼쪽으로 뻗는다는 뜻입니다. 첨도는 꼬리의 두께를 정규분포와 비교하며, 첨도가 높으면 예상보다 극단적인 특이치가 많고 낮으면 적습니다. 모수적 방법을 사용하기 전에 두 값을 모두 확인하여 정규성을 가정할 수 있는지 평가하십시오.
기술 통계량에는 관측값이 몇 개나 필요합니까?
표준편차와 왜도 같은 통계량이 안정적이고 의미 있으려면 관측값을 최소 20~30개 수집하십시오. Zometric Statistical Software에서는 Values 열을 선택하고, 필요하면 집단을 나란히 비교하는 By 변수를 선택한 뒤, 히스토그램, 개별 값 그림, 상자 그림 같은 필요한 통계량과 그래프를 선택합니다.