
기술 통계량(표)(Descriptive Statistics Tables)
수치 변수와 선택적인 행 및 열 그룹화 변수를 고른 다음, N, 평균, 평균의 표준오차, 표준편차, 최솟값, 제1사분위수, 중앙값, 제3사분위수, 최댓값의 아홉 가지 통계량 중에서 선택합니다. 결측값은 제외됩니다. 충전기와 교대별 충전 중량과 같은 부분군을 비교할 때 사용합니다. 데이터를 기술할 뿐, 차이가 실제인지 검정하지는 않습니다.
최종 검토
핵심 요점
기술 통계량(표)은 하나 이상의 수치 열을 최대 두 개의 그룹화 열로 나눈 하나의 표로 요약하므로, 더 자세히 살펴보기 전에 여러 부분군을 나란히 비교할 수 있습니다.
목적
기술 통계량(표)은 하나 이상의 수치 열을 하나의 표로 요약하며, 표의 옆면을 따라 하나, 위쪽을 가로질러 하나의 최대 두 개의 그룹화 열로 나눕니다. 각 변수마다 개수, 평균, 평균의 표준오차, 표준편차, 최솟값, 사분위수, 중앙값, 최댓값 중 표시할 통계량을 선택합니다. 더 자세히 살펴볼 곳을 정하기 전에 여러 부분군을 나란히 놓고 볼 때 사용합니다. 예를 들어 충전기와 교대별 충전 중량, 라인과 제품별 사이클 타임, 공급업체와 로트별 시험 결과가 있습니다. 데이터를 기술할 뿐, 차이가 실제인지 검정하지는 않습니다.
주요 기능
- 하나의 표에 여러 수치 변수를 넣고, 각 변수마다 별도의 통계량 블록을 제공합니다.
- 행 변수, 열 변수 또는 둘 다에 의한 분할: Minitab과 같이 행 변수의 그룹은 표의 아래쪽으로, 열 변수의 그룹은 가로로 배열됩니다.
- 선택할 수 있는 아홉 가지 통계량: N, Mean, Standard deviation, Minimum, Median, Maximum은 기본적으로 선택되어 있습니다.
- 변수의 결측값은 해당 변수의 통계량에서 제외됩니다.
- Download를 통한 PDF 내보내기.
통계적 방법
결측값과 숫자가 아닌 값을 제거한 후, 데이터를 행 변수와 열 변수(지정한 경우)의 수준별로 나누어 각 그룹 안에서 변수별로 통계량을 따로 계산합니다. 그룹은 그룹화 값의 정렬 순서로 나타납니다. 그룹화 변수가 없으면 표에는 열 전체에 대한 하나의 행만 있습니다.
N은 결측이 아닌 값의 개수입니다. 평균 x̄ = Σx / N입니다. 표준편차 s는 N − 1을 나누는 값을 사용합니다: s = √(Σ(x − x̄)² / (N − 1)). SE of mean = s / √N로, 그룹 평균의 불확실성입니다. Minimum, Median, Maximum은 각각 가장 작은 값, 가운데 값, 가장 큰 값입니다. 제1사분위수와 제3사분위수는 정렬된 값 사이에서 위치 1 + (N − 1)·p에서 선형 보간하여 구한 25번째와 75번째 백분위수이므로, (N + 1)·p 규칙을 사용하는 소프트웨어와 약간 다를 수 있습니다. 그룹이 작으면(값이 약 10개 미만) 표준편차와 사분위수는 대략적인 값이므로 주의하여 해석하십시오.
입력 항목 및 옵션
항목 | 설명 |
Variables | 필수 항목입니다. 요약할 하나 이상의 수치 열입니다(여러 개를 선택하려면 Ctrl 또는 Cmd를 누르십시오). |
For rows (optional) | 그룹화 열입니다. 각 수준마다 표에 별도의 행이 생성됩니다. |
For columns (optional) | 두 번째 그룹화 열입니다. 이 열의 수준이 수준마다 하나씩 표의 열이 되며, 각 행에는 한 변수의 통계량 하나(행 변수가 설정된 경우 행 변수의 각 수준별)가 들어갑니다. |
N / Mean / SE of mean / Standard deviation / Minimum / First quartile / Median / Third quartile / Maximum | 각 변수에 대해 표시할 통계량입니다. 기본적으로 N, Mean, Standard deviation, Minimum, Median, Maximum이 선택되어 있습니다. 하나 이상은 반드시 선택해야 합니다. |
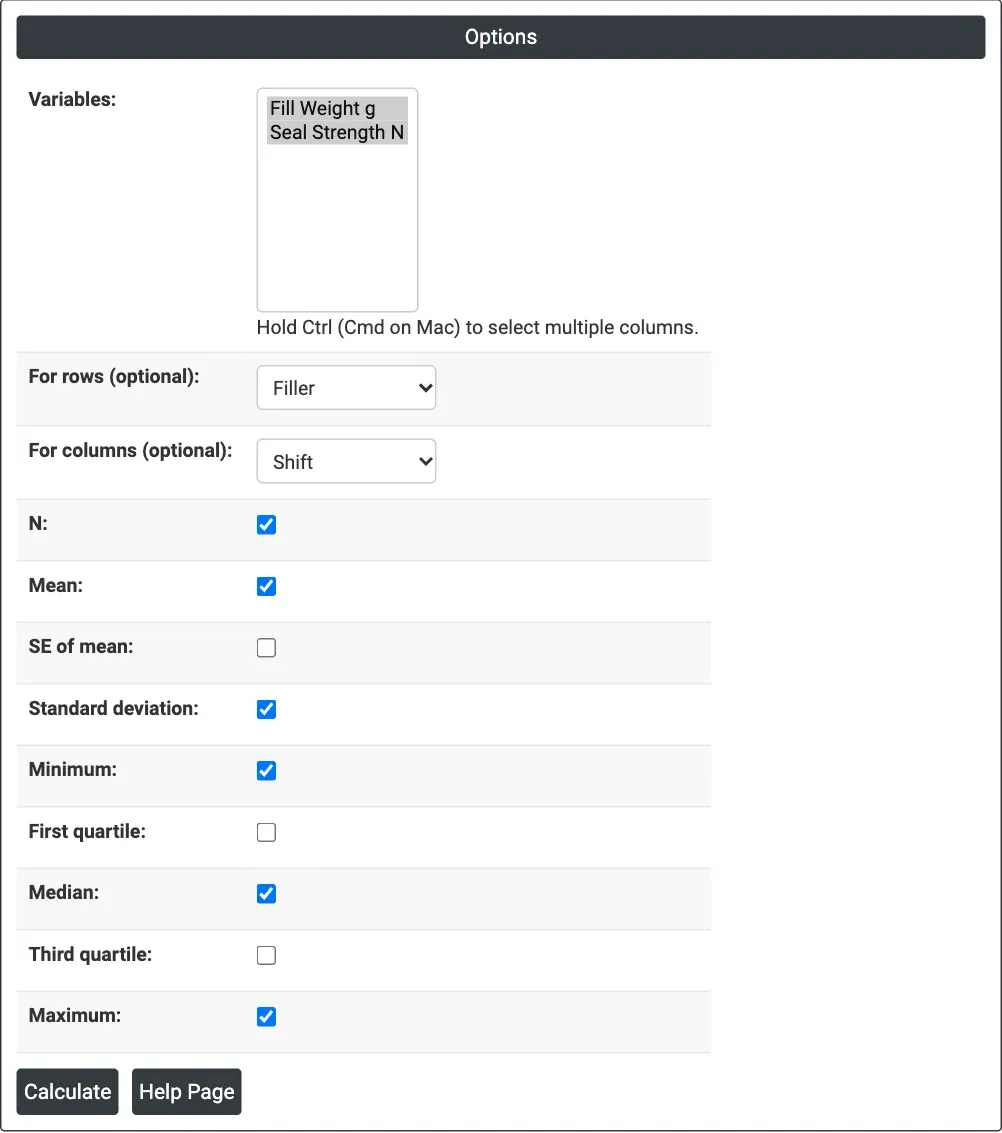
그림 1 — 기본 통계량으로 Filler(행)와 Shift(열)별로 요약한 Fill Weight g과 Seal Strength N.
출력 설명
- Statistics table — 열 변수가 있는 경우(머리글이 “Rows: <row variable>; Columns: <column variable>”): 먼저 행 변수의 수준, Variable, Statistic이 나오고, 그 뒤에 열 변수의 수준마다 하나씩 열이 나옵니다. 열 변수가 없는 경우: 행 변수의 그룹마다 한 행(전체가 하나이면 한 행), 그다음 변수와 통계량마다 하나씩 열이 나오며 Variable_Statistic으로 이름이 붙습니다. 예: Fill Weight g_Mean, Seal Strength N_StDev(선택 통계량은 Q1, Q3, SE Mean).
- Download를 통한 PDF 내보내기.
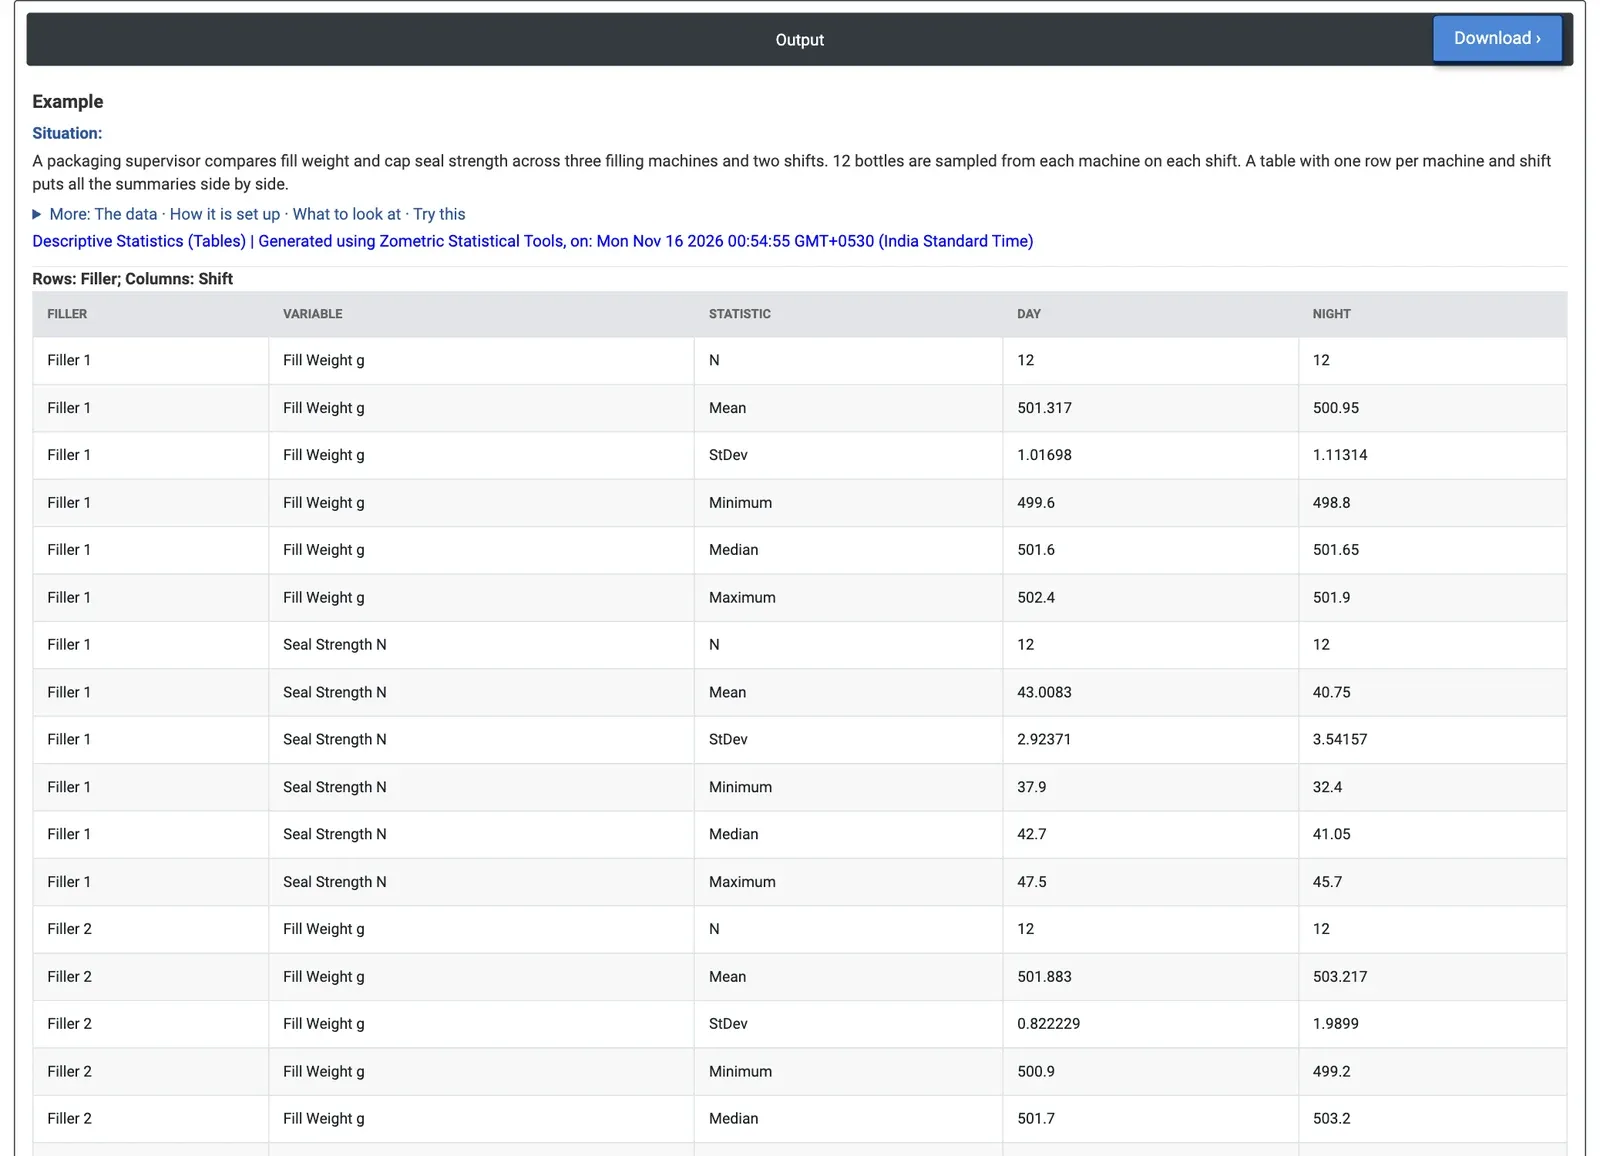
그림 2 — 충전기가 아래쪽, 교대가 위쪽에 배치됨: 세 충전기 모두 야간 교대에서 밀봉 강도가 더 낮으며, 야간 교대의 Filler 2는 가장 무겁고 변동이 가장 크게 충전합니다.
계산 예제
한 포장 현장 감독자가 두 교대에 걸쳐 충전기 세 대를 비교합니다. 교대마다 충전기별로 병 12개를 표본 추출하여(총 72개) 각 병의 충전 중량(g)과 캡 밀봉 강도(N)를 측정합니다. 감독자는 Variables = Fill Weight g과 Seal Strength N, For rows = Filler, For columns = Shift를 선택하고 기본 통계량을 유지합니다.
밀봉 강도는 모든 충전기에서 야간 교대에 더 낮습니다. 평균은 야간에 40.75, 38.93, 38.66 N이고 주간에는 43.01, 43.38, 43.23 N입니다. 세 기계 모두 같은 양상이므로, 한 기계가 아니라 교대와 관련된 무언가(작업조, 캡 배치, 토크 설정)가 원인일 가능성이 있습니다. 충전 중량은 다른 이야기를 합니다. 야간 교대의 Filler 2가 가장 무겁게 충전되며(평균 503.22 g) 변동도 가장 큽니다(표준편차 1.99 g, 범위 499.2~506.2 g). 반면 Filler 3은 두 교대 모두에서 가장 가볍게 충전합니다(499.67 g과 499.61 g).
교대 수준의 관점에서는 열 변수 없이 For rows = Shift로 설정하고 First quartile과 Third quartile을 선택하면, 밀봉 강도 평균은 주간 43.21 N, 야간 39.44 N이며 야간 병의 가운데 절반은 37.15~41.18 N 사이에 있습니다. 표는 어디를 살펴볼지 알려 줍니다. 교대와 충전기 간의 차이가 우연보다 큰지 확인하기 위해 감독자는 Filler와 Shift를 요인으로 하여 Seal Strength N에 이원배치 분산분석을 수행합니다.
자주 묻는 질문
기술 통계량 표는 언제 사용해야 합니까?
더 자세히 살펴볼 곳을 정하기 전에 여러 부분군을 나란히 놓고 볼 때 사용합니다. 예를 들어 충전기와 교대별 충전 중량, 라인과 제품별 사이클 타임, 공급업체와 로트별 시험 결과가 있습니다. 하나의 그룹화 변수는 표의 아래쪽으로, 두 번째 그룹화 변수는 위쪽을 가로질러 배열할 수 있습니다.
사분위수는 어떻게 계산합니까?
제1사분위수와 제3사분위수는 정렬된 값 사이에서 위치 1 + (N − 1)·p에서 선형 보간하여 구한 25번째와 75번째 백분위수이므로, (N + 1)·p 규칙을 사용하는 소프트웨어와 약간 다를 수 있습니다. 값이 약 10개 미만인 작은 그룹에서는 표준편차와 사분위수가 대략적인 값이므로 주의하여 해석하십시오.
기술 통계량 표는 그룹 간 차이가 있는지 검정합니까?
아니요. 데이터를 기술할 뿐, 차이가 실제인지 검정하지는 않습니다. 계산 예제에서 표는 세 충전기 모두 야간 교대에 밀봉 강도가 더 낮다는 것을 보여 주었으며, 교대와 충전기 간의 차이가 우연보다 큰지 확인하기 위해 감독자는 이원배치 분산분석을 수행했습니다.
Zometric Statistical Software에서 표는 어떻게 설정합니까?
하나 이상의 수치 Variables를 선택하고, 필요하면 For rows 열과 For columns 열을 선택한 다음, 표시할 통계량을 선택합니다. N, Mean, Standard deviation, Minimum, Median, Maximum은 기본적으로 선택되어 있으며 하나 이상은 반드시 선택해야 합니다. 표준편차는 N − 1을 나누는 값을 사용하며 결측값은 제외됩니다.