
판별 분석(Discriminant Analysis)
집단이 알려진 항목과 숫자 예측변수를 입력합니다. 선형 판별 분석은 예측변수가 공통 공분산 행렬을 가진 다변량 정규분포를 따른다고 가정하며, 2차 판별 분석은 집단마다 별도의 공분산 행렬을 허용합니다. 사전확률은 동일하게, 비례하게 또는 사용자가 지정할 수 있습니다. 출력에는 혼동 행렬, 전체 정확도와 하나 제외 교차 검증 정확도, 새 항목을 채점하는 선형 분류 함수가 포함됩니다. 검사 데이터로 등급을 구분할 수 있는지 확인할 때 사용합니다.
최종 검토
핵심 요점
판별 분석은 측정값으로 항목을 알려진 집단에 할당하는 규칙을 만들며, 집단을 가장 잘 구분하는 측정값의 조합을 찾고 올바르게 분류되는 항목의 수를 보고합니다.
목적
판별 분석은 측정값으로 항목을 알려진 집단에 할당하는 규칙을 만듭니다. 집단이 알려진 항목(예: Standard와 Premium 배치, 양품과 불량 부품, 공급업체)과 그 항목에서 측정한 값을 입력하면, 집단을 가장 잘 구분하는 측정값의 조합을 찾고 규칙이 올바르게 분류하는 항목의 수를 보여 줍니다. 검사 데이터로 등급이나 유형을 구분할 수 있는지 확인하거나, 새 항목을 분류하는 규칙을 만들 때 사용합니다.
주요 기능
- 둘 이상의 집단에 대한 선형 또는 2차 판별 함수.
- 모든 집단에 동일하거나, 집단 크기에 비례하거나, 사용자가 지정한 사전확률.
- 실제 집단과 예측 집단의 혼동 행렬 및 올바르게 분류된 전체 비율.
- 규칙이 새 항목에서 어떻게 작동할지를 더 공정하게 추정하는 하나 제외 교차 검증.
- 새 항목을 채점하는 선형 분류 함수(각 집단의 상수와 예측변수별 계수 하나).
통계적 방법
집단이 없거나 예측변수가 없거나 숫자가 아닌 행은 제외됩니다. 반응은 텍스트 레이블로 취급되며, 집단은 알파벳순 또는 숫자순으로 나열됩니다. 집단은 최소 2개여야 하고, 행의 수는 예측변수의 수와 집단의 수를 더한 값보다 많아야 합니다.
선형 판별 분석은 예측변수가 각 집단에서 동일한 공분산 행렬을 가진 다변량 정규분포를 따른다고 가정합니다. 각 집단의 평균 x̄g와 합동 집단 내 공분산 행렬 S를 추정하고, 각 집단에 점수 Lg(x) = x̄gᵀ S⁻¹ x − ½ x̄gᵀ S⁻¹ x̄g + ln(pg)를 부여합니다. 여기서 pg는 해당 집단의 사전확률입니다. 항목은 점수가 가장 높은 집단에 할당됩니다. Linear Discriminant (Classification) Functions 표는 각 집단의 상수(−½ x̄gᵀ S⁻¹ x̄g + ln pg)와 계수 S⁻¹ x̄g를 나열합니다. 2차 판별 분석은 공분산이 같다는 가정을 버리고 집단마다 별도의 공분산 행렬을 추정하여 곡선 경계를 만듭니다. 집단당 더 많은 데이터가 필요하며 단순한 분류 함수는 없습니다.
사전확률은 기본적으로 k개 집단에 대해 1/k입니다. 비례 사전확률은 데이터에서 각 집단이 차지하는 비중을 사용하므로 큰 집단에 유리합니다. 재대입 정확도는 규칙을 만드는 데 사용한 항목을 그대로 분류하므로 낙관적입니다. 하나 제외 교차 검증은 각 항목을 차례로 제외하고 나머지로 규칙을 만든 뒤 제외한 항목을 분류하므로, 새 항목에 대한 정확도를 더 잘 가늠하게 해 줍니다.
입력 항목 및 옵션
항목 | 설명 |
Response (grouping variable) | 필수. 각 항목의 알려진 집단이 들어 있는 범주형 열입니다. |
Predictors | 집단을 구분하는 데 사용하는 숫자 열 하나 이상입니다. |
Discriminant function | Linear(기본값, 공통 공분산 행렬) 또는 Quadratic(집단마다 공분산 행렬 하나) 중에서 선택합니다. |
Prior probabilities | All groups equal(기본값), 데이터의 집단 크기에 비례하는 Proportional, 또는 User-specified 중에서 선택합니다. |
Custom priors | Prior probabilities가 User-specified일 때만 사용합니다. 집단마다 값 하나씩을 알파벳순 또는 숫자순 집단 순서로 쉼표나 공백으로 구분하여 입력하며, 모두 양수이고 합이 1이어야 합니다(예: 0.2, 0.5, 0.3). |
Cross-validate (leave-one-out) | 기본적으로 선택되어 있습니다. 교차 검증 정확도와 혼동 행렬을 추가합니다. |
Title | 분석의 제목입니다. 기본값은 Discriminant Analysis입니다. |
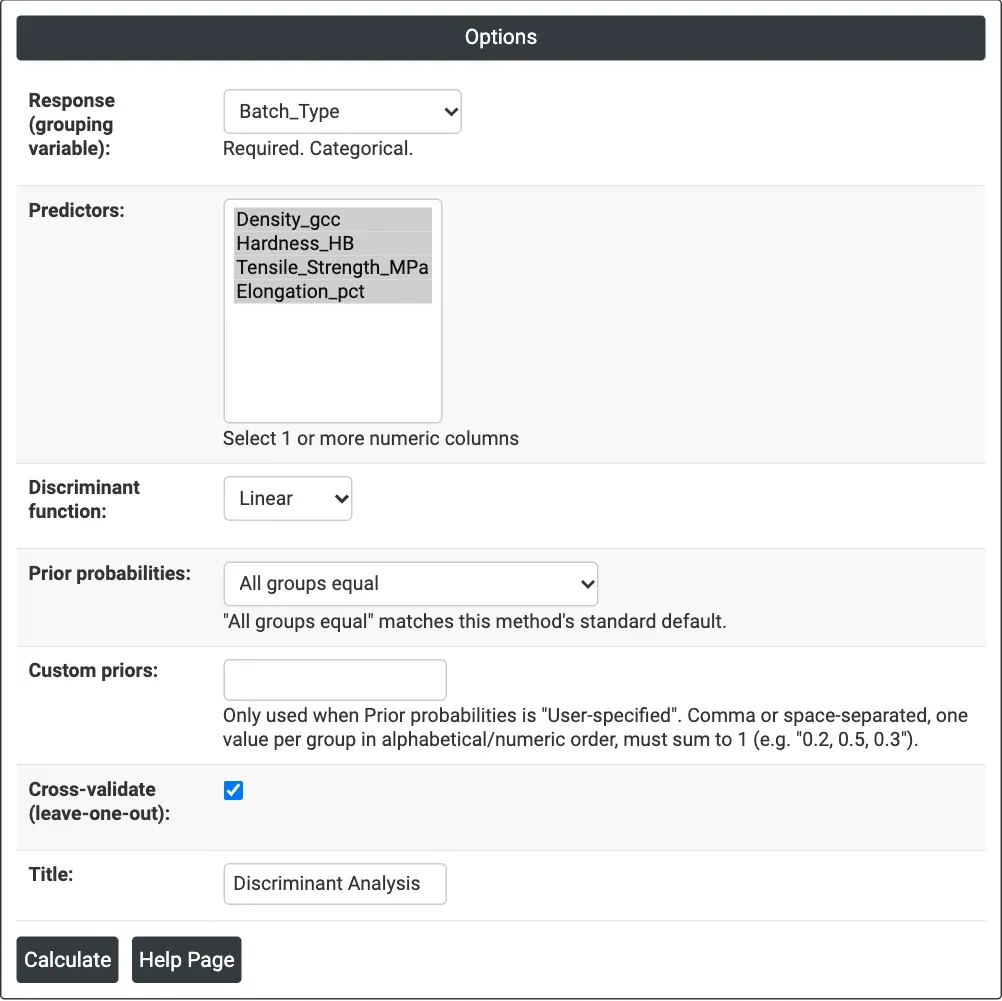
그림 1 — 예제의 옵션: 반응으로 Batch_Type, 예측변수로 네 개의 특성 열, 선형 함수, 동일한 사전확률, 하나 제외 교차 검증.
출력 설명
- Summary line — 사용된 N, 재대입 정확도, 그리고 선택한 경우 교차 검증(하나 제외) 정확도입니다.
- Prior Probabilities — 각 집단에 사용된 사전확률입니다.
- Confusion Matrix (Resubstitution) — 행은 실제 집단, 열은 예측 집단입니다.
- Confusion Matrix (Cross-Validated) — 하나 제외 예측을 사용한 동일한 표입니다.
- Linear Discriminant (Classification) Functions — 선형 함수에서만 제공되며, 각 집단의 상수와 예측변수별 계수입니다. 새 항목은 함수 값이 가장 높은 집단에 할당됩니다.
- Download를 통한 PDF 내보내기.
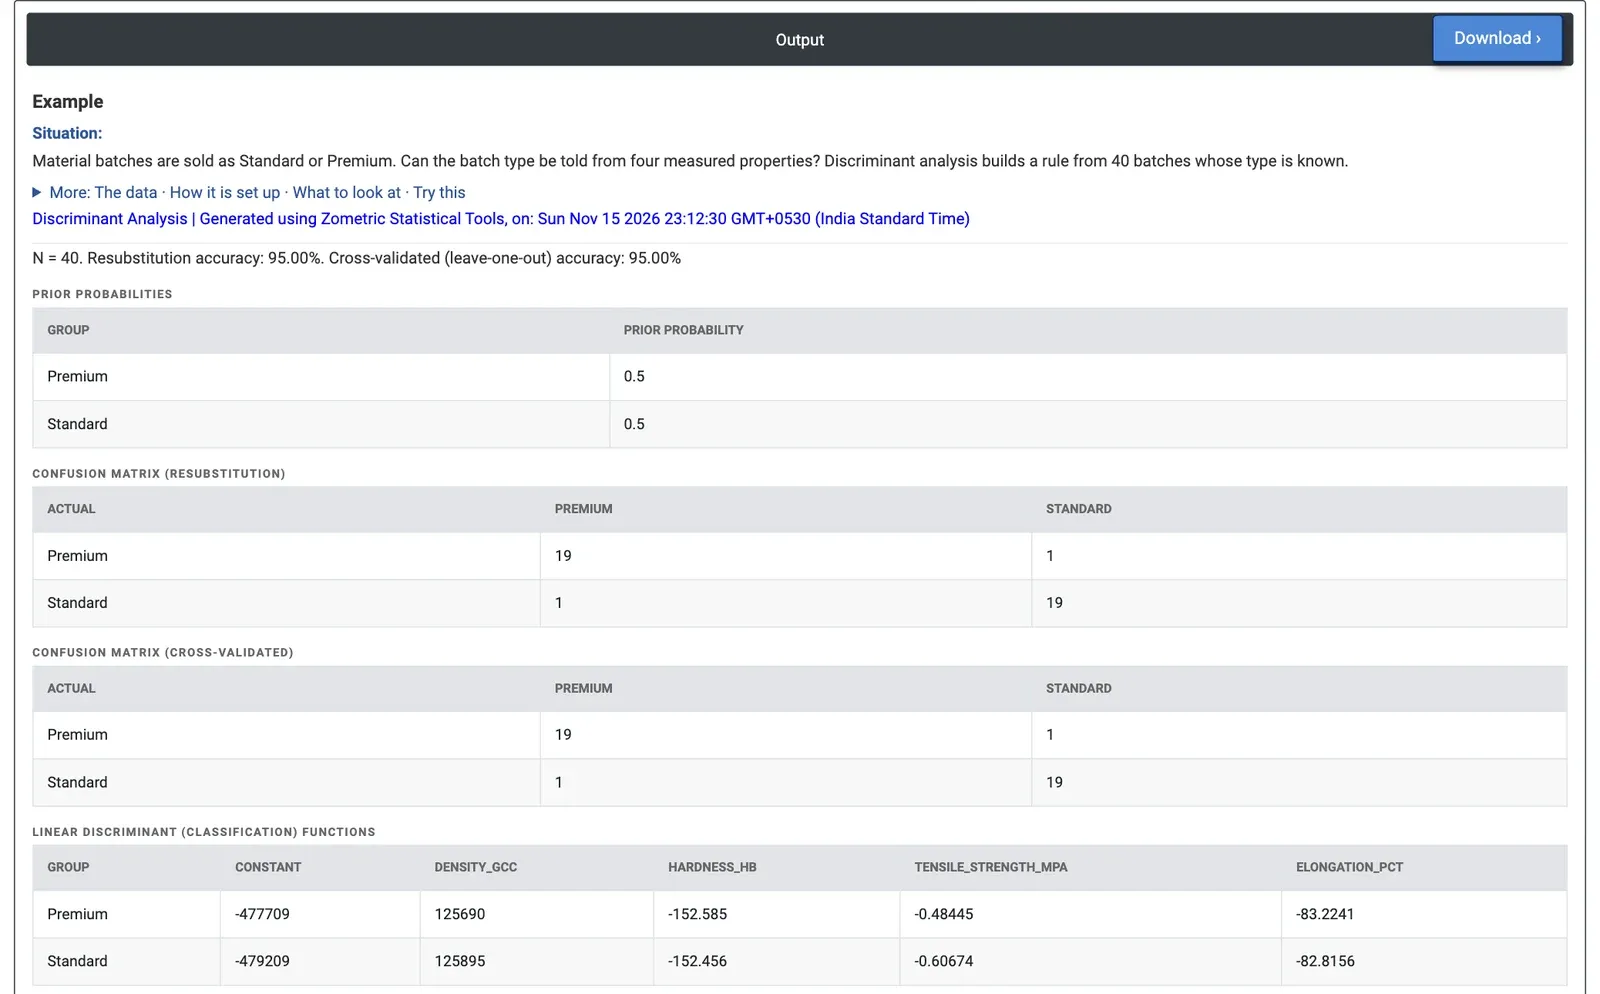
그림 2 — 배치 40개의 결과: 데이터에서나 하나 제외 교차 검증에서나 95%가 올바르게 분류되었으며, 각 유형에서 배치 하나씩이 잘못 분류되었습니다.
계산 예제
한 재료 공장에서 배치를 Standard 또는 Premium으로 판매합니다. 품질 엔지니어는 밀도(g/cc), 경도(HB), 인장 강도(MPa), 신율(%)의 네 가지 일상 측정값으로 배치 유형을 구분할 수 있는지 알고자 합니다. 엔지니어는 유형이 알려진 배치 40개(각각 20개)를 사용하며, Response (grouping variable) = Batch_Type, 네 가지 특성을 Predictors, Discriminant function = Linear, Prior probabilities = All groups equal로 설정하고 Cross-validate를 선택합니다.
이 규칙은 40개 배치 중 38개를 올바르게 분류합니다. 데이터에서 95.00%, 하나 제외 교차 검증에서도 95.00%이므로, 규칙을 만든 40개 배치에만 맞춘 것이 아닙니다. 각 유형에서 20개 중 19개가 올바릅니다. 잘못 분류된 두 배치는 3번 행(Standard, 197.4 HB, 1,210.8 MPa)과 27번 행(Premium, 202.3 HB, 1,209.7 MPa)으로, 두 집단 평균(Premium 212.9 HB와 1,253.6 MPa, Standard 180.1 HB와 1,126.2 MPa) 사이에 위치하므로 확인해 볼 만합니다. 분류 함수는 새 배치의 네 가지 측정값으로 Premium 점수와 Standard 점수를 각각 부여하며, 배치는 점수가 더 높은 유형에 할당됩니다.
밀도는 작은 산포가 시사하는 것보다 더 중요합니다. Premium 평균은 7.878 g/cc이고 Standard는 7.850이며, 예측변수에서 밀도를 제외하면 정확도가 82.5%(교차 검증 75.0%)로 떨어집니다. 이 데이터에서는 2차 함수가 더 나쁜 결과를 보이는데, 데이터에서 92.5%, 교차 검증에서 85.0%입니다. 집단당 배치 20개만으로 더 많은 모수를 추정하기 때문입니다. 엔지니어에게는 네 가지 특성을 모두 사용한 선형 규칙이면 레이블이 측정값과 맞지 않는 배치를 찾아내기에 충분합니다. 같은 데이터를 레이블 없이 군집화한 결과(K-평균 군집화에서 40개 중 28개가 유형과 일치)와 비교하면, 집단을 알고 있을 때 훨씬 더 뚜렷하게 구분됩니다.
자주 묻는 질문
선형 판별 분석과 2차 판별 분석의 차이는 무엇입니까?
선형 판별 분석은 예측변수가 각 집단에서 동일한 공분산 행렬을 가진 다변량 정규분포를 따른다고 가정하며, 선형 분류 함수를 제공합니다. 2차 판별 분석은 집단마다 별도의 공분산 행렬을 추정하여 곡선 경계를 만들지만, 집단당 더 많은 데이터가 필요하고 단순한 분류 함수는 없습니다. 예제에서는 집단당 배치가 20개뿐이어서 2차 판별 분석의 결과가 더 나빴습니다.
하나 제외 교차 검증을 사용하는 이유는 무엇입니까?
재대입 정확도는 규칙을 만드는 데 사용한 항목을 그대로 분류하므로 낙관적입니다. 하나 제외 교차 검증은 각 항목을 차례로 제외하고 나머지로 규칙을 만든 뒤 제외한 항목을 분류하므로, 새 항목에 대한 정확도를 더 잘 가늠하게 해 줍니다. 예제에서는 둘 다 95%였으므로 규칙이 자신의 데이터에만 맞춘 것이 아니었습니다.
사전확률은 판별 분석에 어떤 영향을 줍니까?
기본적으로 k개 집단 각각의 사전확률은 1/k입니다. 비례 사전확률은 데이터에서 각 집단이 차지하는 비중을 사용하므로 큰 집단에 유리합니다. 사용자 지정 사전확률은 양수여야 하고, 알파벳순 또는 숫자순 집단 순서로 집단마다 하나씩 지정하며, 합이 1이어야 합니다. 사전확률은 그 자연로그를 통해 각 집단의 점수에 반영됩니다.
판별 분석으로 새 항목은 어떻게 분류합니까?
선형 판별 함수의 경우 Zometric Statistical Software는 Linear Discriminant (Classification) Functions 표에 각 집단의 상수와 예측변수별 계수 하나를 나열합니다. 새 항목을 각 집단의 함수로 채점하고, 함수 값이 가장 높은 집단에 할당합니다.