
분포 ID 그림(임의 중도절단)(Distribution ID Plot, Arbitrary Censoring)
Start 열과 End 열을 입력합니다. 빈 셀과 채워진 셀의 조합으로 각 행이 정확한 값, 우측, 좌측 또는 구간 중도절단인지 표시됩니다. 도구는 Weibull, 로그 정규, 지수, 정규, 로지스틱, 로그 로지스틱 분포를 최대 가능도법으로 적합시키고, 각 확률도에 신뢰 한계와 함께 Turnbull 추정값을 그리며, 상관계수로 분포의 순위를 매깁니다. 다음 점검 때 고장이 발견되는 검사 데이터에 사용합니다.
최종 검토
핵심 요점
분포 ID 그림(임의 중도절단)은 정확한 고장 시간을 항상 알지는 못할 때 수명 분포를 고르는 데 도움이 되며, 정확한 데이터와 중도절단 데이터가 섞인 자료에 여섯 가지 분포를 적합시키고 확률도의 순위를 매깁니다.
목적
분포 ID 그림(임의 중도절단)은 정확한 고장 시간을 항상 알지는 못할 때 수명 분포를 고르는 데 도움이 됩니다. 정확한 고장, 우측 중도절단 개체(마지막으로 확인했을 때 아직 작동 중), 좌측 중도절단 개체(첫 점검 때 이미 고장), 구간 중도절단 개체(두 점검 사이 어느 시점에 고장)가 어떻게 섞여 있어도 받아들입니다. 여섯 가지 분포를 적합시키고 각각의 확률도를 그리며, 그림이 얼마나 직선에 가까운지에 따라 순위를 매깁니다. 다음 점검 때에야 고장이 발견되는 검사 또는 감사 데이터에 사용합니다.
주요 기능
- Start 열과 End 열로 입력하는 데이터이며, 빈 셀과 채워진 셀의 조합이 각 행의 중도절단 유형을 결정합니다.
- 하나의 데이터 집합에 정확한 행, 우측, 좌측, 구간 중도절단 행을 함께 사용할 수 있습니다.
- 한 번의 실행으로 Weibull, 로그 정규, 지수, 정규, 로지스틱, 로그 로지스틱 분포를 적합시킵니다.
- 확률도의 상관계수로 분포의 순위를 매깁니다.
- 분포마다 하나의 확률도 패널이 있으며, 적합선과 그 신뢰 한계를 보여 줍니다.
통계적 방법
각 행은 Start와 End 값으로 해석합니다. Start = End는 그 시간의 정확한 고장입니다. Start < End는 두 시점 사이 어느 때든의 구간 중도절단 고장입니다. End가 비어 있으면 Start에서 우측 중도절단입니다(그 시점에 개체가 아직 작동 중이었음). Start가 비어 있으면 End에서 좌측 중도절단입니다(그 시점까지 개체가 이미 고장 났음). 모든 행에는 값이 하나 이상 있어야 하며, Start는 End보다 클 수 없습니다.
각 분포는 최대 가능도법으로 적합시킵니다. 정확한 고장은 밀도 함수 f(t)를, 우측 중도절단 개체는 생존 확률 1 − F(Start)를, 좌측 중도절단 개체는 F(End)를, 구간 중도절단 개체는 구간 안에서 고장 날 확률인 F(End) − F(Start)를 기여합니다. 그림의 점에 쓰이는 누적 고장 확률의 비모수 추정값은 Turnbull 추정값으로, 각 구간 중도절단 고장을 그 고장이 일어났을 수 있는 시간에 걸쳐 분산시키는 반복적인 방법입니다.
우측 중도절단 도구와 마찬가지로, 각 패널은 해당 분포가 직선으로 그려지도록 축을 변환하며(Weibull, 로그 정규, 로그 로지스틱은 로그 시간), 상관계수는 그려진 x 값과 변환된 확률 사이의 Pearson 상관입니다. 1에 가까운 값은 그림이 더 직선에 가깝다는 뜻입니다. 그룹화된 검사 데이터에서는 개체 수보다 서로 다른 그림 점의 수가 적으므로, 상관은 더 적은 수의 점에 근거합니다. 순위뿐 아니라 패널도 살펴보고 고장 메커니즘에 대한 공학적 지식을 활용하십시오. 각 패널에는 Minitab이 그리는 것과 같이 Confidence level에서의 양측 신뢰 한계(점선)도 표시됩니다. 각 백분율 p에 대해 적합된 분포의 백분위수 t_p와 그 분산을 로그 가능도의 역 헤시안으로부터 델타 방법으로 구하고, Weibull, 로그 정규, 지수, 로그 로지스틱에서는 ln(t_p)에서, 정규와 로지스틱에서는 t_p에서 구간을 형성합니다. 한계에서 크게 벗어난 점은 적합이 좋지 않음을 나타냅니다.
입력 항목 및 옵션
항목 | 설명 |
Start column | 필수 항목입니다. 마지막으로 정상임을 확인한 시간 또는 정확한 고장 시간입니다. 행의 Start를 비워 두면 좌측 중도절단으로 표시됩니다. |
End column | 필수 항목입니다. 처음으로 고장 난 것으로 확인된 시간 또는 정확한 고장 시간입니다. 행의 End를 비워 두면 우측 중도절단으로 표시됩니다. Start = End는 정확한 고장을, Start < End는 구간 중도절단을 의미합니다. Start와 다른 열이어야 합니다. |
Confidence level (%) | 기본값은 95이며 50~99.99입니다. 각 적합선 주위에 그려지는 신뢰 한계를 설정합니다. |
그림 1 — 예제의 옵션: Start 열과 End 열에 입력한 검사 데이터.
출력 설명
- Correlation ranking — 각 분포와 그 상관계수를 좋은 순서부터 나열합니다.
- Messages — 적합시키지 못한 분포가 있으면 그 이유와 함께 표시합니다.
- Distribution ID Plot for Start-End — 순위 순서대로 분포마다 하나의 확률도 패널이며, 제목에 상관계수(r)가 표시되고 그림 점, 적합선, 신뢰 한계를 보여 줍니다.
- Download를 통한 PDF 내보내기.
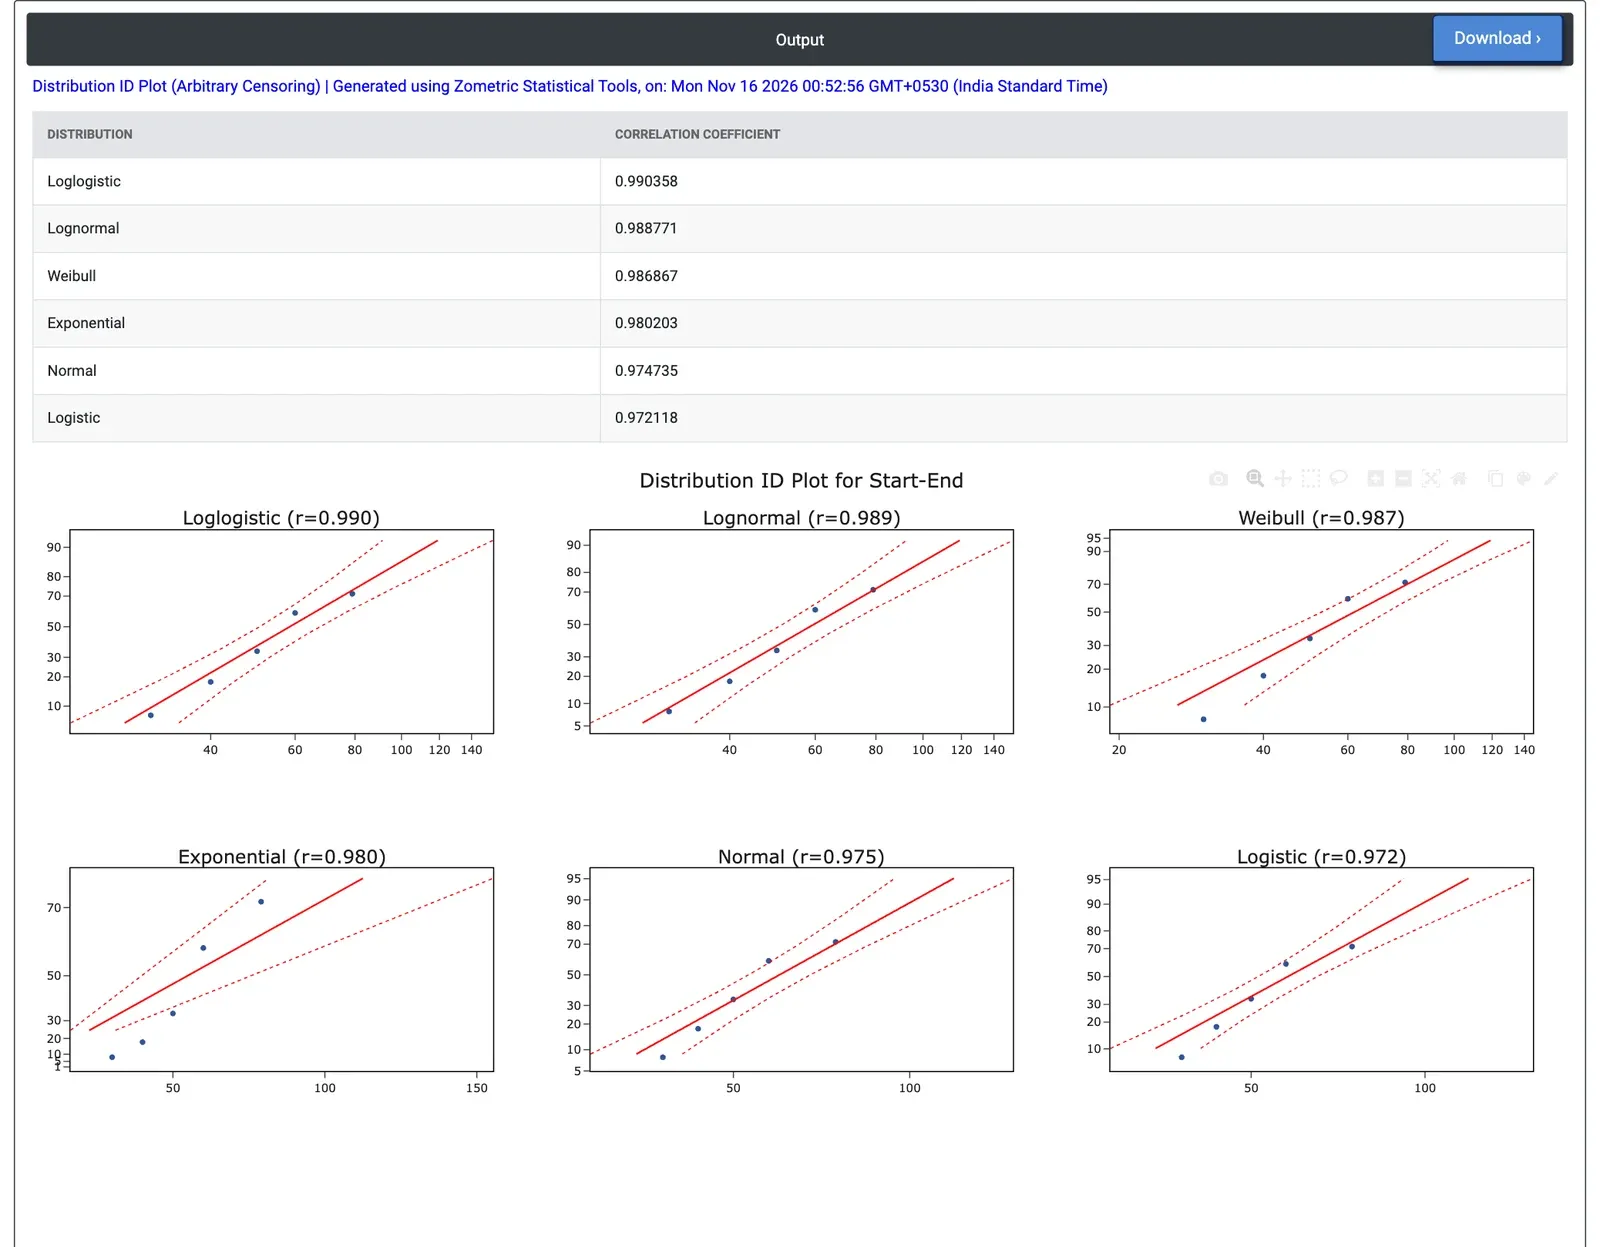
그림 2 — 10시간마다 점검한 권선 50개의 상관 순위와 확률도: 로그 로지스틱 0.990, 로그 정규 0.989, Weibull 0.987은 사실상 동률입니다.
계산 예제
이 예제는 분포 ID 그림(우측 중도절단) 페이지에서 80 °C로 시험한 터빈 엔진 권선 50개를 사용하며, 권선이 30시간부터 10시간마다 점검만 이루어졌다고 가정하여 기록한 것입니다. 첫 점검에서 고장 난 것으로 발견된 권선 4개는 좌측 중도절단입니다(Start는 비어 있고 End = 30). 이후 점검에서 고장 난 것으로 발견된 33개는 구간 중도절단입니다. 예를 들어 50시간에는 작동 중이었고 60시간에 고장 난 권선은 Start = 50, End = 60입니다. 고장 전에 제거된 13개는 제거 시간에서 우측 중도절단입니다(End는 비어 있음). 엔지니어는 Start 열로 Start를, End 열로 End를 선택합니다.
순위는 로그 로지스틱 0.990, 로그 정규 0.989, Weibull 0.987, 지수 0.980, 정규 0.975, 로지스틱 0.972입니다. 각 패널에는 30, 40, 50, 60, 79시간의 점이 다섯 개뿐입니다. Turnbull 추정값이 고장을 배치하는 시간으로, 70~80시간 사이에서 발견된 고장 하나는 그 구간 안의 마지막 우측 중도절단 권선 뒤인 79시간에 배치됩니다. 점이 이렇게 적으면 상관계수가 모두 높고 서로 가까워서, 데이터만으로는 상위 세 분포를 구분할 수 없습니다. 적합된 Weibull의 척도는 73.3시간, 형상은 2.17로, 정확한 시간으로 구한 73.3시간과 2.32에 가까우므로, 고장을 점검 구간으로 묶은 것이 적합 모형을 거의 바꾸지 않았습니다.
엔지니어에게는 로그 로지스틱, 로그 정규, Weibull이 모두 데이터를 어느 정도 잘 설명합니다. Weibull은 형상이 고장률의 추세를 보여 주므로 마모 고장에는 여전히 합리적인 선택입니다. 다음 단계는 선택한 분포로 분포 개관 그림(임의 중도절단)을 작성하여 적합된 생존 곡선과 위험률 곡선을 확인하는 것입니다.
자주 묻는 질문
구간 중도절단 데이터는 어떻게 입력합니까?
Start 열과 End 열을 사용합니다. Start가 End와 같으면 정확한 고장이고, Start가 End보다 작으면 두 시점 사이의 구간 중도절단 고장이며, End가 비어 있으면 Start에서 우측 중도절단(그 시점에 아직 작동 중), Start가 비어 있으면 End에서 좌측 중도절단(그 시점까지 이미 고장 남)입니다. Start는 End보다 클 수 없습니다.
그림에서 가장 적합한 분포는 어떻게 고릅니까?
분포는 확률도의 상관계수로 순위가 매겨지며, 1에 가까운 값은 그림이 더 직선에 가깝다는 뜻입니다. 그룹화된 검사 데이터에서는 개체 수보다 서로 다른 그림 점의 수가 적으므로, 순위뿐 아니라 패널도 살펴보고, 점을 신뢰 한계와 대조하며, 고장 메커니즘에 대한 공학적 지식을 활용하십시오.
Turnbull 추정값이란 무엇입니까?
그림의 점에 쓰이는 누적 고장 확률의 비모수 추정값입니다. 각 구간 중도절단 고장을 그 고장이 일어났을 수 있는 시간에 걸쳐 분산시키는 반복적인 방법입니다. 권선 예제에서는 고장이 다섯 시점에만 배치되었으므로 상관계수가 모두 높고 서로 가까웠습니다.
분포 ID 그림 다음에는 무엇을 해야 합니까?
선택한 분포로 분포 개관 그림(임의 중도절단)을 실행하여 적합된 생존 곡선과 위험률 곡선을 확인합니다. 예제에서는 로그 로지스틱, 로그 정규, Weibull이 사실상 동률이었고, Weibull은 형상이 고장률의 추세를 보여 주므로 마모 고장에는 여전히 합리적인 선택이었습니다.