
점도표(Dotplot)
점도표는 데이터 범위를 같은 폭의 구간으로 나누고 값 하나당 점 하나를 쌓으므로, 쌓인 높이가 곧 개수입니다. 값을 요약하거나 정규성을 가정하는 검정을 실행하기 전에 최대 수백 개 값의 표본에 사용합니다. 옵션으로 그룹화 열 또는 여러 열, 구간 수, 로그 척도, 1.5xIQR 규칙에 따른 특이치 제외가 있습니다.
최종 검토
핵심 요점
점도표는 소규모 또는 중간 규모 데이터 집합의 모든 값을 수직선 위의 점으로 나타내고 비슷한 값은 쌓아서, 데이터의 봉우리, 공백, 별개의 집단, 떨어진 점 등 데이터의 형태를 볼 수 있게 합니다.
목적
점도표는 소규모 또는 중간 규모 데이터 집합의 모든 값을 수직선 위의 점으로 나타내며, 값이 비슷한 점은 서로 위에 쌓습니다. 평균과 표준편차와 달리 값이 몰려 있는 곳, 공백, 별개의 집단, 떨어진 점 등 데이터의 형태를 보여 줍니다. 충전량, 초품 검사의 치수, 시험 결과처럼 최대 수백 개 값의 표본에 대해, 값을 요약하거나 정규분포를 가정하는 검정을 실행하기 전에 사용합니다.
주요 기능
- 하나의 데이터 열 또는 여러 열(Multiple Ys 모드)을 사용하며, 각 열은 고유한 행과 색상으로 표시됩니다.
- 선택 사항인 그룹화 열: Minitab의 With Groups 점도표처럼 그룹마다 쌓인 점의 행이 하나씩 표시됩니다.
- 구간 수를 직접 지정하거나 표본 크기로부터 계산합니다.
- 치우친 양수 데이터를 위한 로그 척도 X축.
- 1.5×IQR 규칙에 따라 특이치를 선택적으로 제외하며, 제거된 개수를 메모로 표시합니다.
- 행 번호 또는 조건으로 행을 제외하거나 해당 행만 유지하는 Data Options.
통계적 방법
값을 숫자로 변환하며 결측 또는 숫자가 아닌 항목은 제외합니다. 최솟값부터 최댓값까지의 범위를 같은 폭의 구간으로 나눕니다. Number of bins를 비워 두면 구간 수는 2 × √n을 올림한 값이며 10~60 사이로 유지됩니다(값 25개이면 구간 10개). 각 값은 해당 구간의 중앙에 놓이고 같은 구간의 값은 위아래로 쌓이므로, 쌓인 높이는 그 구간의 개수입니다. 따라서 점은 값을 정확하게가 아니라 가장 가까운 구간으로 보여 주며, 최댓값은 마지막 구간에 들어갑니다. 그룹화 열이나 여러 데이터 열이 있으면 각 그룹 또는 열이 고유한 행(첫 번째가 맨 위)을 가지며, 모든 행이 같은 구간을 공유하므로 행끼리 직접 비교할 수 있습니다. Log scale X-axis를 사용하면 구간은 로그 척도에서 같은 폭이 되며, 이때 모든 값은 0보다 커야 합니다.
Exclude outliers를 선택하면 Q1 − 1.5×IQR보다 작거나 Q3 + 1.5×IQR보다 큰 값(IQR = Q3 − Q1이며, 그룹화 열이 설정되면 그룹별로 계산)이 그래프를 그리기 전에 제거되고, 그래프 아래의 메모에 제거된 개수가 표시됩니다. 그림 읽는 법: 양쪽으로 고르게 줄어드는 하나의 중심 봉우리는 정규분포와 일치하며, 사이에 공백이 있는 둘 이상의 봉우리는 이후 분석 전에 나누어 볼 가치가 있는 여러 출처(노즐 두 개, 교대조 두 개, 공급업체 두 곳)의 혼합을 시사합니다.
입력 항목 및 옵션
항목 | 설명 |
Data column(s) | 필수 항목입니다. 수치형 열 하나 또는 Multiple Ys 모드를 위한 여러 열입니다. Ctrl 또는 Command를 누른 채 여러 열을 선택합니다. |
Grouping column | 선택 항목입니다. 그룹마다 쌓인 점의 행이 하나씩 표시되며, 각 행은 고유한 색상을 갖고 세로축에 이름이 표시됩니다("With Groups"). |
Number of bins | 선택 항목이며 5~200입니다. 비워 두면 값의 개수로부터 계산합니다. |
Log scale X-axis | 기본값은 선택 해제입니다. 로그 X축과 그 척도에서 같은 폭의 구간을 사용합니다. |
Title | 그래프에 표시되는 제목입니다. 기본값은 Dotplot입니다. |
Discrete color sequence | 그룹 또는 열에 사용하는 색상 팔레트이며 기본값은 D3입니다. 그룹이 없는 단일 열은 남색으로 그려집니다. |
Exclude outliers (1.5×IQR rule) | 기본값은 선택 해제입니다. 그래프를 그리기 전에 Q1 − 1.5×IQR과 Q3 + 1.5×IQR을 벗어난 점을 제거합니다(그룹화 열이 설정된 경우 그룹별로 적용). |
Data Options: Subset (optional) | Exclude matching rows(기본값) 또는 Include only matching rows 중에서 선택하며, Row numbers(예: 3,7,12-15, 원본 그리드의 행 번호 사용) 및/또는 Condition(예: Fill_Volume_mL > 249)으로 일치하는 행을 정합니다. Row numbers 또는 Condition을 입력하지 않으면 아무 효과가 없습니다. |
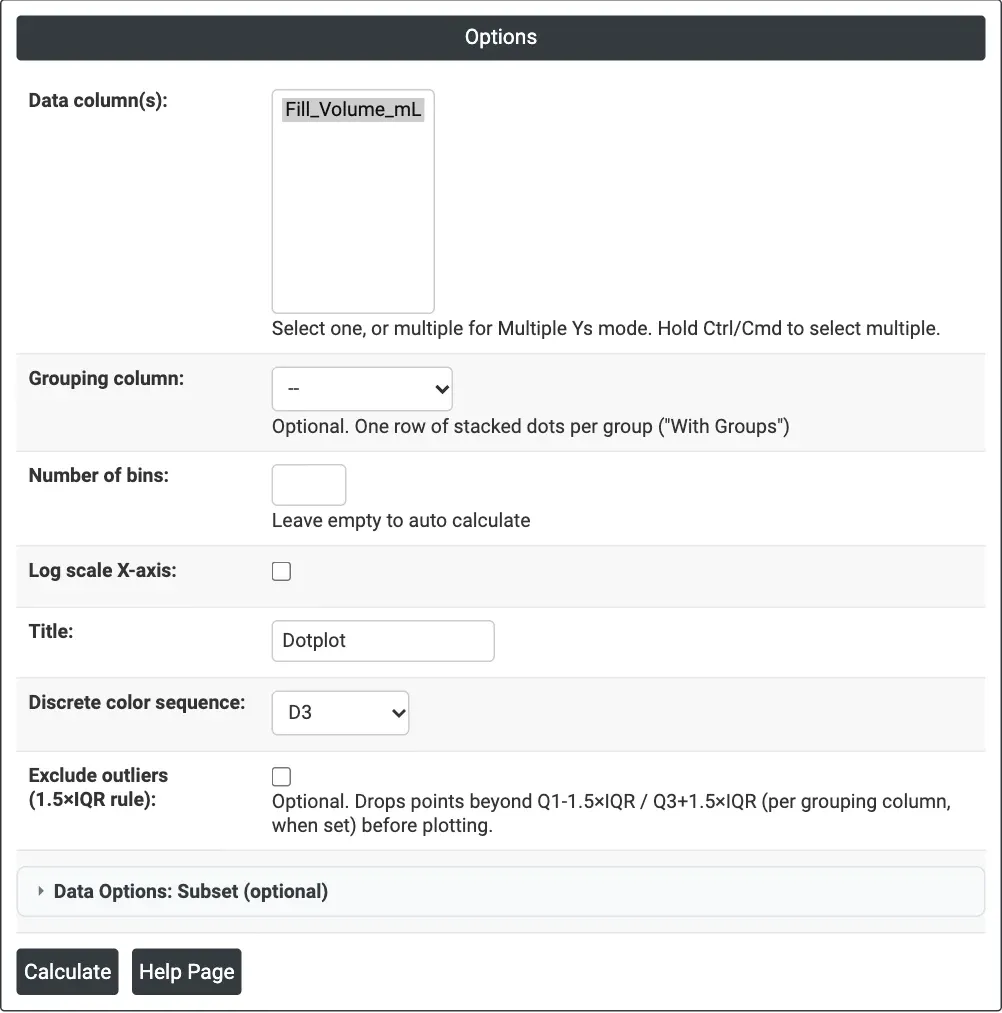
그림 1 — 병 25개의 충전량 점도표이며, 구간 수는 자동으로 계산되었습니다.
출력 설명
- Dotplot — X축을 따라 쌓인 점으로, 값 하나당 점 하나입니다. 그룹 또는 여러 열이 있으면 각각 한 행이며 세로축에 이름이 표시됩니다.
- Outlier note — Exclude outliers가 점을 제거한 경우: 제외된 개수입니다.
- Download를 통한 PDF 내보내기.
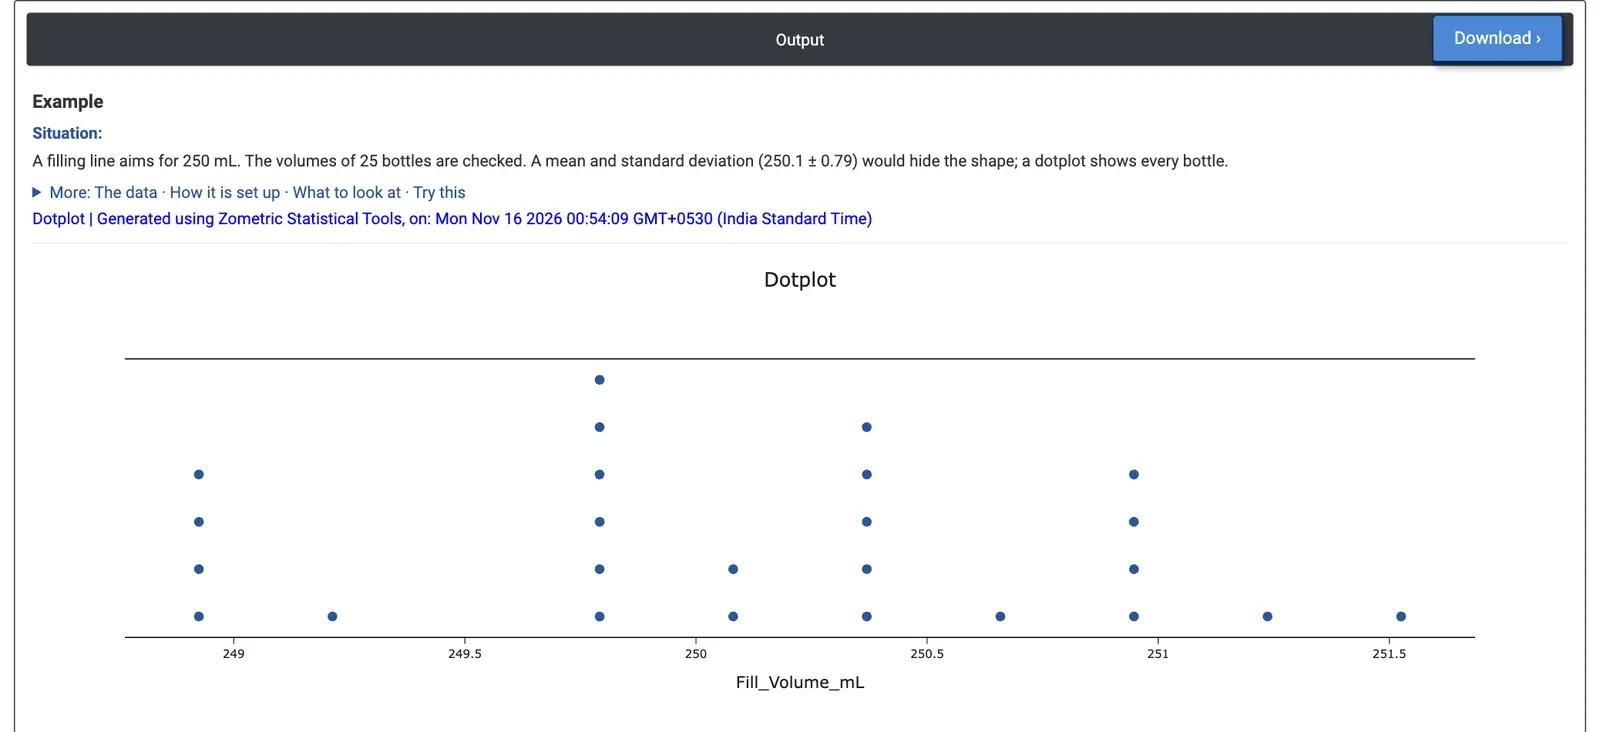
그림 2 — 병 25개의 충전량: 249.8, 250.4, 251.0 mL 근처의 봉우리와 248.9 mL 근처의 별개 집단 4개.
계산 예제
한 충전 라인은 병당 250 mL를 목표로 합니다. 라인 감독자가 병 25개의 충전량을 확인합니다. 평균은 250.10 mL이고 표준편차는 0.79 mL로 괜찮아 보이지만, 이런 숫자는 데이터의 형태를 가립니다. 감독자는 Data column(s) = Fill_Volume_mL을 선택하고 Number of bins를 비워 두며, 도구는 폭이 약 0.29 mL인 구간 10개를 사용합니다.
충전량은 248.78~251.67 mL입니다. 점들은 깔끔한 하나의 종 모양을 이루지 않습니다. 249.8 mL 근처에 병 6개, 250.4 mL 근처에 5개, 251.0 mL 근처에 4개의 봉우리가 있고, 248.9 mL 근처(248.78~249.05 mL)에는 낮은 병 4개로 이루어진 별개의 집단이 있으며, 249.21과 249.68 mL 사이에 병이 없는 공백으로 분리되어 있습니다. Number of bins = 30이면 쌓인 높이는 최대 점 3개이지만, 낮은 병 4개는 여전히 나머지와 떨어져 있습니다. Exclude outliers는 이 병들을 하나도 제거하지 않는데, 사분위수의 1.5×IQR 안에 있기 때문입니다. 이들은 떨어진 점이 아니라 하나의 집단입니다.
의사결정 측면에서는, 라인 설정 전체를 조정하기 전에 무엇이 병들을 나누는지, 예를 들어 충전 노즐 하나가 낮게 작동하는지 확인해야 한다는 뜻입니다. 병마다 노즐 번호가 기록되어 있으면 이를 Grouping column으로 사용하여 낮은 병들이 한 노즐에서 나왔는지 직접 확인할 수 있습니다.
자주 묻는 질문
점도표는 어떻게 읽습니까?
양쪽으로 고르게 줄어드는 하나의 중심 봉우리는 정규분포와 일치합니다. 사이에 공백이 있는 둘 이상의 봉우리는 노즐 두 개, 교대조 두 개, 공급업체 두 곳과 같은 여러 출처의 혼합을 시사하며, 이후 분석 전에 나누어 볼 가치가 있습니다. 각 쌓인 높이는 그 구간에 있는 값의 개수입니다.
평균과 표준편차 대신 점도표는 언제 사용해야 합니까?
최대 수백 개 값의 표본에서 데이터의 형태가 중요할 때마다 점도표를 사용하십시오. 계산 예제에서 충전량 25개는 평균 250.10 mL, 표준편차 0.79 mL로 괜찮아 보였지만, 점도표는 248.9 mL 근처에 낮은 병 4개로 이루어진 별개의 집단이 있음을 드러냈습니다.
점도표는 구간을 몇 개 사용합니까?
Number of bins를 비워 두면 구간 수는 2 x √n을 올림한 값이며 10~60 사이로 유지되어, 값 25개이면 구간 10개가 됩니다. 각 값은 해당 구간의 중앙에 놓이므로 점은 값을 정확하게가 아니라 가장 가까운 구간으로 보여 줍니다. 구간을 5~200개 사이에서 직접 지정할 수도 있습니다.
점도표에서 집단을 어떻게 비교합니까?
Zometric Statistical Software에서 그룹화 열을 선택하면 그룹마다 쌓인 점의 행이 하나씩 표시되며, 여러 데이터 열을 선택할 수도 있습니다. 모든 행이 같은 구간을 공유하므로 직접 비교할 수 있습니다. 충전량 예제에서 노즐 번호로 그룹화하면 낮은 병들이 한 노즐에서 나왔는지 직접 확인할 수 있습니다.