
경험적 CDF(Empirical CDF)
경험적 CDF는 값을 정렬하여 각각을 백분율로 (i − 0.5) / n 위치에 그리고 계단 모양으로 연결합니다. 평균 이상으로 집단을 비교하거나, 한계 이하인 부품의 비율을 읽거나, Normal이나 Weibull 같은 적합된 분포와 데이터를 대조할 때 사용합니다. By 열을 지정하면 집단마다 곡선이 하나씩 그려지며, 여러 변수를 겹쳐 그릴 수도 있습니다.
최종 검토
핵심 요점
경험적 CDF는 측정값마다 그 값 이하인 관측값의 백분율을 계단 곡선으로 그려, 전체 분포의 중앙값, 산포, 꼬리, 간격을 한 번에 보여 줍니다.
목적
경험적 CDF는 측정값마다 그 값 이하인 관측값의 백분율을 그립니다. 결과는 전체 분포, 즉 중앙값, 산포, 꼬리, 간격을 한 번에 보여 주는 계단 곡선입니다. 평균 이상으로 둘 이상의 집단(기계, 공급업체, 구성)을 비교하거나, 한계 이하인 부품의 비율을 읽거나, 적합된 분포와 데이터를 대조하는 데 사용합니다.
주요 기능
- 변수마다, 또는 By 열을 선택한 경우 한 변수의 집단마다 계단 곡선 하나.
- 직접 비교할 수 있도록 하나의 그림에 겹쳐 그린 여러 변수.
- 점선으로 겹쳐 그리는 선택적 적합 분포: Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest 또는 Largest Extreme Value, Logistic, Loglogistic.
- 세로축의 0에서 100까지 백분율 척도로, 곡선에서 바로 백분위수를 읽을 수 있습니다.
- 그리기 전에 행 번호 또는 조건으로 행을 제외하거나 유지할 수 있습니다.
통계적 방법
각 곡선에 대해 비어 있지 않은 수치 값을 x₁ ≤ x₂ ≤ … ≤ xₙ 로 정렬하고, i번째 값을 도표화 위치 pᵢ = (i − 0.5) / n 에 백분율로 그립니다. 점들은 계단 모양(수평 후 수직)으로 연결되므로 곡선은 관측값마다 100/n 퍼센트씩 상승합니다. 곡선이 50%와 만나는 값은 해당 집단의 중앙값이고, 90%와 만나는 값은 90번째 백분위수입니다.
By 열과 변수가 하나일 때는 행을 By 열의 수준별로 나누어 각 수준마다 곡선을 하나씩 그립니다. 변수가 여러 개이면 변수마다 곡선을 그리며 By 열은 무시됩니다.
적합 분포를 선택하면 Minitab과 마찬가지로 각 곡선(각 집단 또는 각 변수)마다 별도로 모수를 추정하며, 적합된 CDF는 각자 데이터의 범위에 걸쳐 그려집니다. Normal은 표본 평균과 표준편차를 사용하고, 나머지 분포는 최대우도법을 사용합니다(Lognormal, Weibull, Exponential, Loglogistic은 임계값을 0으로 고정하므로 양수 값이 필요합니다). 범례에는 각 곡선의 적합된 모수가 표시되므로 각 집단을 해당 모형과 대조할 수 있습니다.
입력 항목 및 옵션
항목 | 설명 |
Variables | 수치 열 하나 이상입니다. 변수 하나를 선택하거나, 여러 개를 선택하여 곡선을 겹쳐 그립니다. |
By (grouping) column | 선택 사항입니다. 이 열의 수준마다 곡선 하나가 그려집니다. 변수를 하나만 선택했을 때만 사용됩니다. |
Overlay fitted distribution | 기본값은 “--- (empirical only)”로 적합선이 없습니다. 또는 Normal, Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic, Loglogistic 중 하나. |
Title | 그림의 제목입니다. 기본값은 “Empirical CDF”입니다. |
Data Options: Subset (optional) | Exclude matching rows(기본값) 또는 Include only matching rows. Row numbers(예: 3,7,12-15)와 Condition(예: Weight_kg > 100) 중 하나 또는 둘 다로 행을 선택합니다. 둘 다 비어 있으면 아무 효과가 없습니다. |
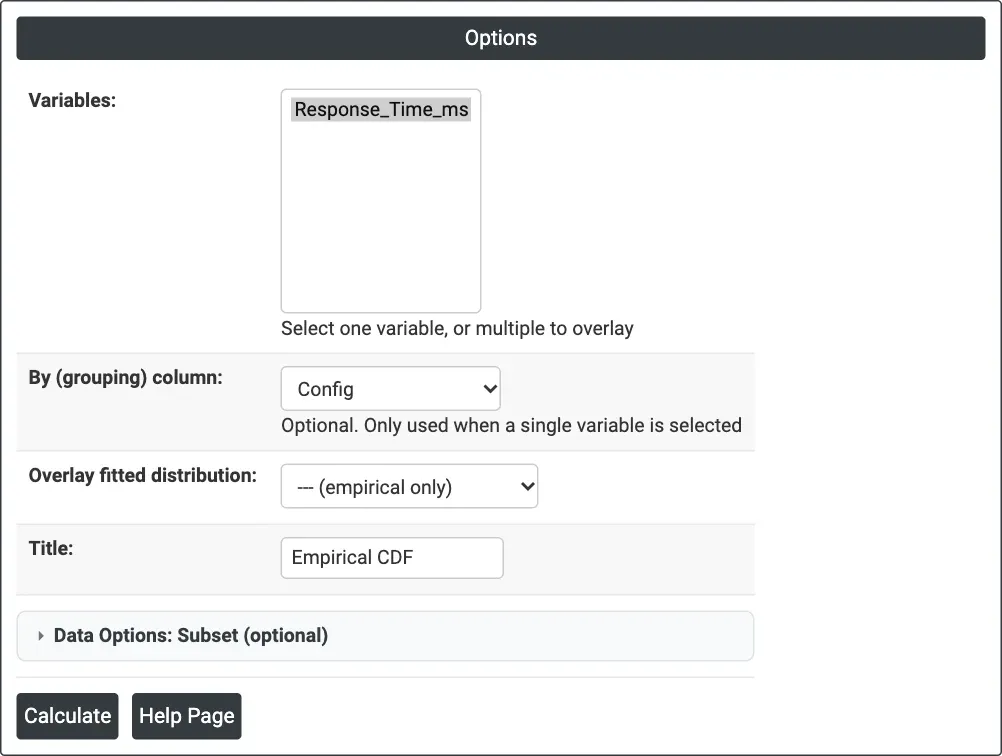
그림 1 — 예제의 옵션: Variables = Response_Time_ms, By (grouping) column = Config, 적합 분포 없음.
출력 설명
- Empirical CDF — 각 집단 또는 변수에 대해 변수에 대한 백분율의 계단 곡선이며, 각 관측값에 표식이 있고 곡선 이름이 표시된 범례가 있습니다. 적합 분포를 선택한 경우 각 곡선마다 곡선의 색(곡선이 하나뿐이면 검정)의 점선으로 표시되고 모수가 레이블로 붙습니다.
- Download를 통한 PDF 내보내기.
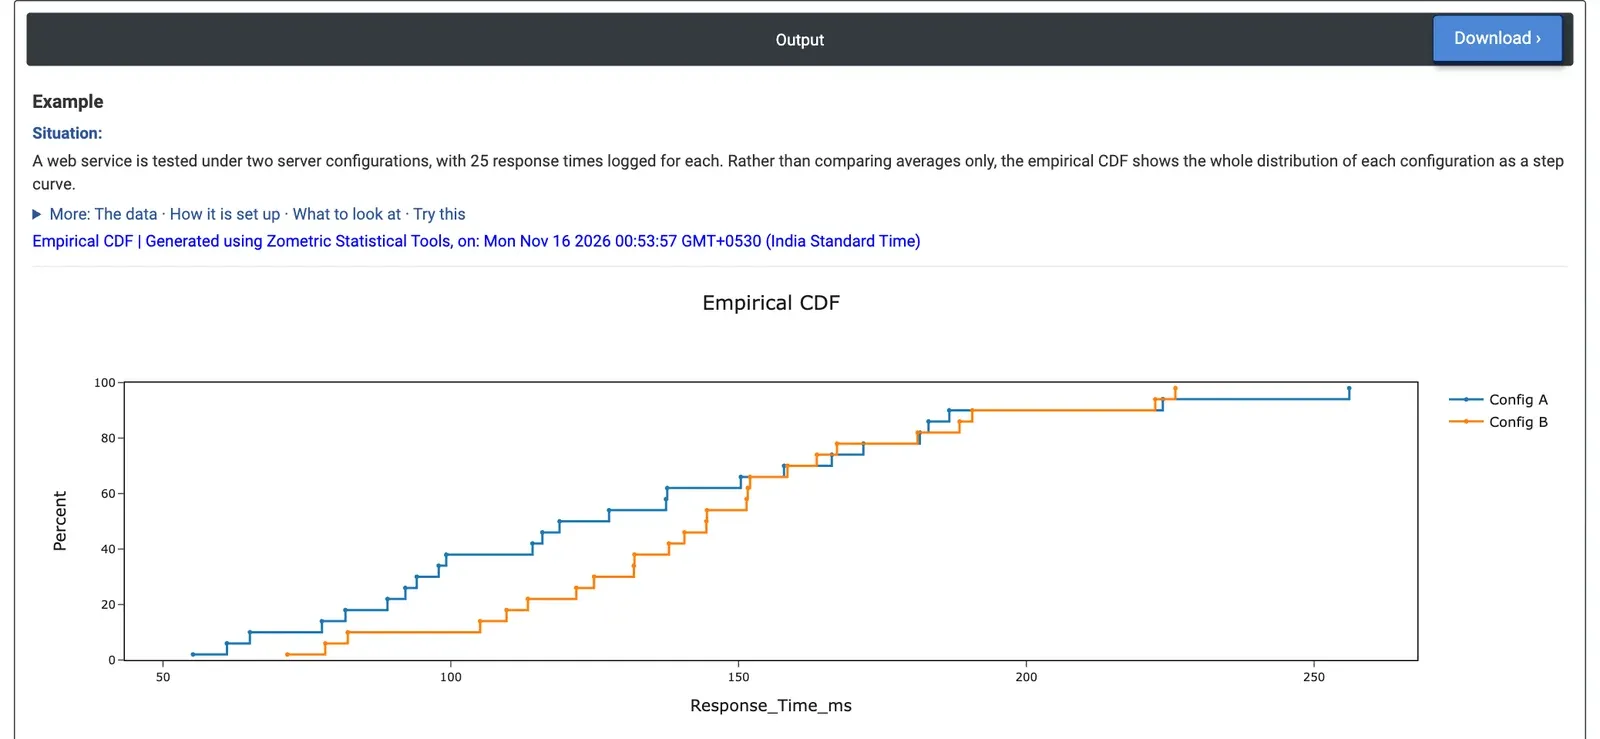
그림 2 — Config A(파랑)와 Config B(주황)의 응답 시간에 대한 경험적 CDF, 각각 요청 25건.
계산 예제
한 IT 팀이 두 가지 서버 구성에서 웹 서비스를 시험하고 각각의 응답 시간(ms) 25개를 기록합니다. 평균만 보면(A는 129.7 ms, B는 143.6 ms) A가 더 빠른 것으로 보이지만, 팀은 전체 분포가 어떻게 비교되는지, 특히 사용자가 체감하는 느린 요청이 어떤지 알고자 합니다. 이들은 변수로 Response_Time_ms를, By 열로 Config를 선택하고 적합 분포는 지정하지 않습니다.
50%에서 가로로 읽으면 중앙값은 Config A가 118.9 ms, Config B가 144.4 ms입니다. 대부분의 범위에서 B의 곡선이 오른쪽에 있으므로 B의 일반적인 요청이 더 느립니다. 150 ms에서는 A의 요청 64%가 완료된 반면 B는 56%입니다. 상단에서는 곡선이 교차합니다. A의 가장 느린 요청은 256.1 ms인 반면 B의 가장 느린 요청은 225.9 ms이며, A의 산포가 더 큽니다(표준편차 51.8 대 39.7 ms). 두 구성 모두 요청의 92%가 200 ms 이내입니다. 따라서 B는 일반적인 요청이 더 느리고 A는 꼬리가 더 깁니다. 어느 쪽을 택할지는 서비스에 중앙값과 최악의 경우 중 무엇이 더 중요한지에 달려 있습니다.
겹쳐 그릴 분포로 Normal을 선택하면 각 구성의 25개 값에 적합된 점선 정규 곡선이 구성마다 추가됩니다. A는 평균 129.7 ms, 표준편차 51.8 ms이고, B는 평균 143.6 ms, 표준편차 39.7 ms입니다. 계단 곡선이 점선 곡선에서 벗어나는 곳은 해당 구성의 응답 시간이 정규분포를 따르지 않는 부분입니다.
자주 묻는 질문
경험적 CDF는 어떻게 읽습니까?
곡선은 관측값마다 100/n 퍼센트씩 상승합니다. 50%에서 가로로 읽으면 각 집단의 중앙값을, 90%에서는 90번째 백분위수를 알 수 있으며, 한계에서 위로 읽으면 그 값 미만인 값의 비율을 볼 수 있습니다. 계산 예제에서 응답 시간의 중앙값은 Config A가 118.9 ms, Config B가 144.4 ms였습니다.
평균 대신 경험적 CDF로 집단을 비교하는 이유는 무엇입니까?
평균은 산포와 꼬리의 차이를 가립니다. 계산 예제에서 Config A는 평균과 중앙값 응답 시간이 더 낮았지만 곡선은 상단에서 교차했습니다. A의 가장 느린 요청은 256.1 ms인 반면 B의 가장 느린 요청은 225.9 ms였습니다. CDF는 일반적인 경우가 다른지, 최악의 경우가 다른지 보여 줍니다.
적합된 분포와 데이터를 어떻게 대조합니까?
겹쳐 그릴 분포를 Normal, Lognormal, Weibull, Exponential, Logistic 또는 극값 분포 중에서 선택합니다. 모수는 곡선마다 별도로 추정되어 점선으로 그려집니다. 계단 곡선이 점선 곡선에서 벗어나는 곳은 데이터가 해당 분포를 따르지 않는 부분입니다. Lognormal, Weibull, Exponential, Loglogistic은 양수 값이 필요합니다.
Zometric Statistical Software에서 집단은 어떻게 비교합니까?
변수 하나와 By (grouping) column을 선택하면 수준마다 계단 곡선이 하나씩 그려지며, 여러 변수를 선택하면 곡선을 겹쳐 그리고 이 경우 By 열은 무시됩니다. Data Options를 사용하여 그리기 전에 행 번호 또는 조건으로 행을 제외하거나 유지할 수 있습니다.