
요인 분석(Factor Analysis)
요인 분석은 상관된 세 개 이상의 수치 변수를 더 적은 수의 잠재 요인으로 요약합니다. 시험 결과, 공정 측정값, 설문 항목의 배후에 있는 특성을 찾는 데 사용합니다. 요인 수는 변수 수보다 적어야 하고 행 수는 변수 수보다 많아야 하며, 최대 가능도 방법은 대략적인 다변량 정규성을 가정합니다. 출력에는 요인 적재량, 공통성, 고유성, 설명된 분산, 적재량 그림이 포함됩니다.
최종 검토
핵심 요점
요인 분석은 측정된 많은 변수 사이의 상관을 소수의 잠재 요인으로 설명하므로, 많은 측정값이나 설문 항목을 이름 붙이기 쉬운 몇 개의 요인으로 요약할 수 있습니다.
목적
요인 분석은 측정된 많은 변수 사이의 상관을 소수의 잠재 요인으로 설명합니다. 함께 움직이는 변수는 같은 요인에 적재되므로, 긴 측정값 목록이나 설문 항목을 이름 붙이고 추적하기 쉬운 몇 개의 요인으로 요약할 수 있습니다. 일련의 시험 결과, 공정 측정값, 설문 항목의 배후에 있는 소수의 잠재 특성을 찾고, 어떤 변수가 대체로 독자적인 양상을 보이는지 확인하는 데 사용합니다.
주요 기능
- 세 개 이상의 수치 변수에서 사용자가 선택한 수만큼의 요인을 추출합니다.
- 두 가지 추출 방법: Principal Components와 Maximum Likelihood.
- 각 요인이 더 적은 수의 변수에 강하게 적재되도록 하여 이름을 붙이기 쉽게 만드는 베리맥스 회전.
- 각 변수의 공통성과 고유성이 포함된 Factor Loadings 표.
- 각 요인이 설명하는 분산의 백분율과, 처음 두 요인의 적재량 그림.
통계적 방법
선택한 변수 중 하나라도 값이 없거나 숫자가 아닌 행은 제외되며, 각 변수는 평균 0, 표준편차 1로 표준화되므로 분석은 상관 행렬을 대상으로 이루어집니다. 요인 수는 변수 수보다 적어야 하고, 행 수는 변수 수보다 많아야 합니다.
Principal Components 추출에서는 상관 행렬을 고유값과 고유벡터로 분해하며, 요인 j의 적재량은 가장 큰 고유값들에 대해 j번째 고유벡터에 해당 고유값의 제곱근을 곱한 값입니다. Maximum Likelihood 추출에서는 공통 요인 모형(표준화된 각 변수 = 적재량 × 요인 + 고유 오차)을 반복 알고리즘으로 최대 가능도 적합하며, Maximum iterations(기본값 1000)에서 멈추거나 변화량이 Convergence tolerance(기본값 0.01) 아래로 내려가면 멈춥니다. 최대 가능도 방법은 변수들이 대략 다변량 정규분포를 따른다고 가정합니다.
베리맥스 회전(Kaiser 방법)은 각 요인 내 제곱 적재량의 분산이 가능한 한 커지도록 요인을 회전시켜, 각 변수가 한 요인에는 높게 적재되고 나머지 요인에는 0에 가깝게 적재되게 합니다. 회전은 각 변수가 설명되는 정도를 바꾸지 않습니다. 회전 후 요인은 설명하는 분산의 순서로 정렬됩니다. 변수의 공통성은 제곱 적재량의 합으로, 요인이 설명하는 해당 변수 분산의 비율이며, 고유성은 1 − 공통성입니다. 요인이 설명하는 분산은 제곱 적재량의 합이며 변수 수에 대한 백분율로 보고됩니다. 요인의 부호는 임의적이므로, 모든 부호가 반대인 요인도 같은 의미입니다.
입력 항목 및 옵션
항목 | 설명 |
Variables | 세 개 이상의 수치 열입니다. Ctrl 또는 Command를 누른 채 클릭하여 여러 개를 선택합니다. |
Number of factors to extract | 기본값 2. 변수 수보다 작아야 합니다. |
Method of extraction | Principal Components(기본값) 또는 Maximum Likelihood. |
Type of rotation | Varimax(기본값) 또는 None. 회전은 요인이 2개 이상일 때만 적용됩니다. |
Maximum iterations | 선택 사항이며 Maximum Likelihood 추출에서만 사용됩니다. 기본값(1000)을 사용하려면 비워 두십시오. |
Convergence tolerance | 선택 사항이며 Maximum Likelihood 추출에서만 사용됩니다. 기본값(0.01)을 사용하려면 비워 두십시오. |
Title | 적재량 그림에 표시되는 제목입니다. 기본값은 Factor Analysis입니다. |
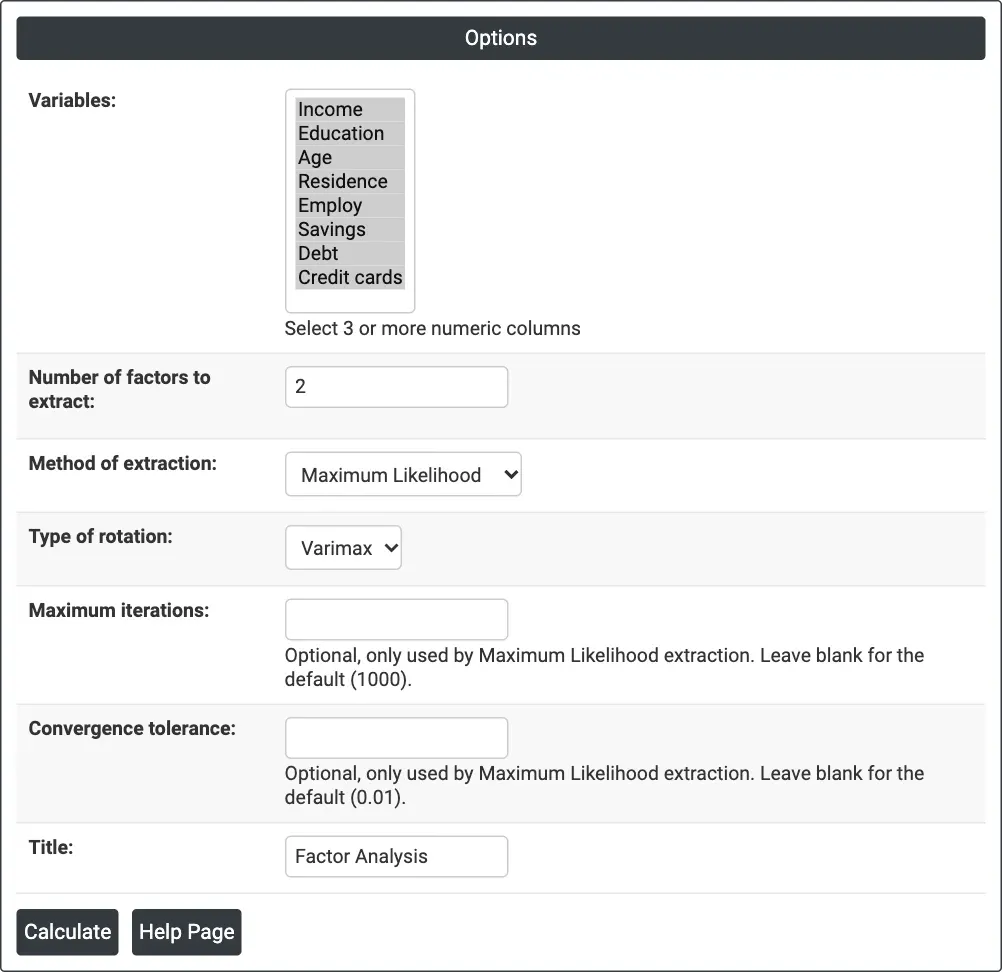
그림 1 — 예제의 옵션: 대출 신청자 변수 8개, 요인 2개, Maximum Likelihood 추출, Varimax 회전.
출력 설명
- Factor Loading Plot — 각 변수를 원점에서 Factor1(x)과 Factor2(y)에 대한 적재량까지의 선으로 그립니다. 같은 방향을 가리키는 변수는 같은 요인에 적재됩니다.
- Method, rotation and variance explained — 방법과 회전의 이름(예: Maximum Likelihood, Varimax), 각 요인이 설명하는 전체 분산의 백분율과 누적 백분율.
- Factor Loadings — 각 변수에 대해 각 요인에 대한 적재량, Communality, Uniqueness.
- Download를 통한 PDF 내보내기.
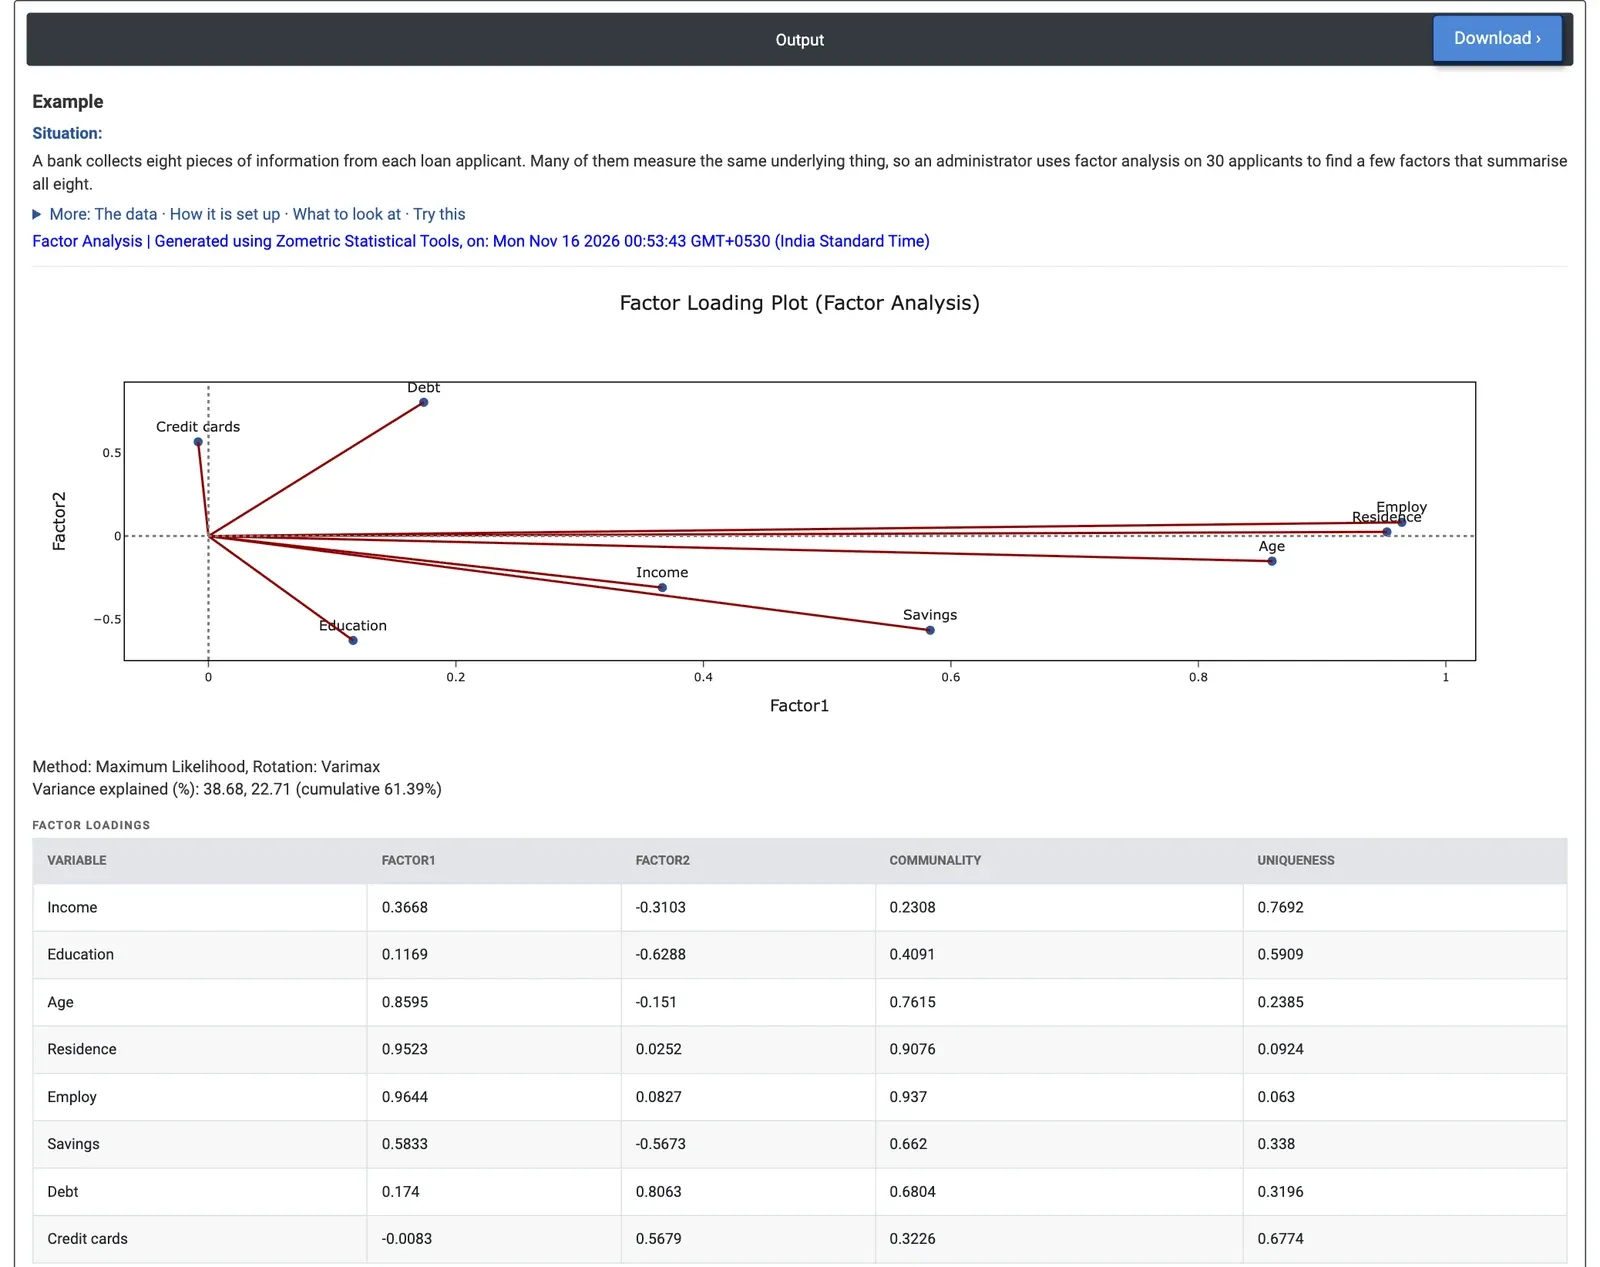
그림 2 — 대출 신청자 변수 8개에 대한 회전된 두 요인: 안정성 요인(Employ, Residence, Age)과 차입 요인(Debt, Credit cards 대 Education)이며, 분산의 61.39%를 설명합니다.
계산 예제
한 은행이 대출 신청자마다 여덟 가지 정보를 수집합니다. 소득, 교육 연수, 나이, 현 주소 거주 연수(Residence), 현 직장 근속 연수(Employ), 저축, 부채, 신용카드 수입니다. 이 가운데 많은 항목이 같은 것을 측정하는 것처럼 보입니다. 여신 담당자는 여덟 가지를 모두 요약하는 몇 개의 요인을 원합니다. 엔지니어는 신청자 30명의 데이터를 사용하여 여덟 개 열을 모두 선택하고 Number of factors to extract = 2, Method of extraction = Maximum Likelihood, Type of rotation = Varimax로 설정합니다.
두 요인은 분산의 38.68%와 22.71%, 합쳐서 61.39%를 설명합니다. 요인 1은 Employ(0.9644), Residence(0.9523), Age(0.8595)에 크게, Savings(0.5833)에 중간 정도로 적재되어 안정성과 경력 요인입니다. 요인 2는 Debt(0.8063)와 Credit cards(0.5679)에 적재되고 Education(−0.6288), Savings(−0.5673)과는 반대로 나타나 차입 요인입니다. 공통성은 두 요인이 각 변수를 얼마나 잘 설명하는지를 보여 주며, Employ(0.937)와 Residence(0.9076)는 높고 Income(0.2308)과 Credit cards(0.3226)는 낮습니다.
은행 입장에서 두 요인은 신청자의 안정성과 차입을 잘 설명하지만, 소득은 대체로 독자적인 양상을 보입니다. 요인을 3개로 하면 설명된 분산이 72.93%(36.67%, 20.63%, 15.63%)로 올라가고, 세 번째 요인은 주로 Income(−0.8835)과 Education(−0.5491)이며 Income의 공통성은 0.8545로 올라갑니다. 이는 같은 데이터에 대한 Cluster Variables 결과와 일치하며, 여기서는 Income이 Education과, 안정성 변수들이 함께, Debt가 Credit cards와 묶입니다. 회전하지 않아도 적재량은 여기서 약간만 변하는데(요인 1: Employ 0.9666, Residence 0.9526), 회전하지 않은 해가 이미 상당히 단순하기 때문입니다.
자주 묻는 질문
요인 분석은 무엇에 사용합니까?
요인 분석은 측정된 많은 변수 사이의 상관을 소수의 잠재 요인으로 설명합니다. 함께 움직이는 변수는 같은 요인에 적재되므로, 긴 시험 결과, 공정 측정값, 설문 항목 목록을 몇 개의 요인으로 요약할 수 있고, 어떤 변수가 대체로 독자적인 양상을 보이는지도 알 수 있습니다.
Principal Components 추출과 Maximum Likelihood 추출의 차이는 무엇입니까?
Principal Components 추출에서는 상관 행렬을 고유값과 고유벡터로 분해하며, 각 요인의 적재량은 고유벡터에 해당 고유값의 제곱근을 곱한 값입니다. Maximum Likelihood 추출은 반복 알고리즘으로 공통 요인 모형을 적합하며 변수들이 대략 다변량 정규분포를 따른다고 가정합니다.
요인 분석에서 베리맥스 회전은 무엇을 합니까?
베리맥스 회전은 각 변수가 한 요인에는 높게 적재되고 나머지 요인에는 0에 가깝게 적재되도록 요인을 회전시켜, 요인에 이름을 붙이기 쉽게 만듭니다. 회전은 각 변수가 설명되는 정도를 바꾸지 않습니다. 회전 후 요인은 설명하는 분산의 순서로 정렬됩니다. 회전은 요인이 둘 이상일 때만 적용됩니다.
요인 분석에서 공통성과 고유성은 어떻게 해석합니까?
변수의 공통성은 제곱 적재량의 합으로, 요인이 설명하는 해당 변수 분산의 비율입니다. 고유성은 1에서 공통성을 뺀 값입니다. 대출 신청자 예제에서 Employ의 공통성은 0.937이었으나 Income은 0.2308에 불과하여, 요인이 2개일 때 소득은 대체로 독자적인 양상을 보임을 알 수 있습니다.