
혼합 효과 모형 적합(Fit Mixed Effects Model)
혼합 효과 모형 적합은 고정 범주형 요인과 공변량을 검정하면서, 배치, 작업자, 일자와 같은 랜덤 요인의 분산 성분을 추정합니다. 랜덤 요인을 무시하면 고정 요인 검정이 지나치게 낙관적이 될 때 사용합니다. 모든 랜덤 요인은 수준이 최소 3개 필요합니다. 출력에는 분산 성분, Satterthwaite 자유도를 사용한 F 검정, 계수, AICc와 BIC가 포함된 모형 요약이 포함됩니다.
최종 검토
핵심 요점
혼합 효과 모형은 수준을 비교하는 고정 요인과 모집단에서 추출된 랜덤 요인에 따라 달라지는 반응을 분석하여, 고정 요인을 검정하고 랜덤 요인의 분산을 추정합니다.
목적
혼합 효과 모형 적합은 두 종류의 요인에 따라 달라지는 반응을 분석합니다. 하나는 특정 수준을 비교하려는 고정 요인(기계 두 대, 공급업체 세 곳, 새 방법과 기존 방법)이고, 다른 하나는 수준이 더 큰 모집단에서 추출된 표본인 랜덤 요인(배치, 표본, 작업자, 일자)입니다. 고정 요인을 검정하고 각 랜덤 요인이 더하는 분산이 얼마인지 추정합니다. 랜덤 요인을 무시하면 고정 요인 검정이 지나치게 낙관적이 될 때, 예를 들어 같은 배치나 부품을 모든 조건에서 측정하는 경우에 사용합니다.
주요 기능
- 하나 이상의 고정 범주형 요인과 연속형 공변량, 그리고 하나 이상의 랜덤 요인을 사용합니다.
- 각 랜덤 요인과 오차의 분산 성분을 전체 대비 %, 표준오차, Z 검정, 신뢰구간과 함께 제공합니다.
- Satterthwaite 분모 자유도를 사용한 고정 효과의 F 검정.
- Satterthwaite 자유도를 사용한 계수, t 검정, 신뢰구간.
- S, R-sq, R-sq(adj), AICc, BIC, −2 log likelihood가 포함된 모형 요약.
- 제한 최대우도(REML) 또는 최대우도(ML) 추정.
- Data Options: 분석 전에 행의 부분집합을 선택합니다.
통계적 방법
모형은 y = Xβ + Σ Zᵢuᵢ + ε이며, 여기서 Xβ는 고정 요인(합이 0이 되는 −1/0/+1 코딩)과 공변량을 포함하고, 각 랜덤 요인 i는 분산이 σᵢ²인 독립적인 효과 uᵢ를 더하며, 오차 ε의 분산은 σ²입니다. 랜덤 요인은 독립적인 분산 성분입니다(교호작용은 적합하지 않음). 분산은 고정 효과가 사용하는 자유도를 반영하여 거의 불편인 분산 성분을 제공하는 REML(기본값)로 추정하거나, 서로 다른 고정 효과를 가진 모형을 AICc 또는 BIC로 비교할 때 필요한 ML로 추정합니다. 결측값이 있는 행은 제외하며, 모든 랜덤 요인은 수준이 최소 3개 필요합니다.
분산 추정값이 주어지면 고정 계수는 일반화 최소제곱 추정값입니다. 각 고정 항은 분모 자유도를 Satterthwaite 근사로 구하는 F 통계량으로 검정하고, 각 계수는 Satterthwaite 자유도를 사용한 t 검정으로 검정합니다. 분산 성분의 표준오차는 Fisher 정보로 구하고, 성분이 0이라는 단측 Z = Var / SE Var 검정을 수행하며, 신뢰구간은 로그 척도에서 계산하므로 결코 음수가 되지 않습니다. 랜덤 요인의 수준이 적으면 이 Z 검정은 검정력이 낮고 구간이 넓습니다.
R-sq는 조건부 적합(고정 효과와 예측된 랜덤 효과)을 전체 변동과 비교합니다. S는 오차 분산의 제곱근입니다. AICc와 BIC는 모형이 좋을수록 작으며, REML에서는 고정 효과가 같은 모형끼리만 비교합니다.
입력 항목 및 옵션
항목 | 설명 |
Response (Y) | 수치형 반응 열입니다. 필수 항목입니다. |
Fixed factors (categorical) | 특정 수준이 직접적인 관심 대상인 하나 이상의 열입니다. 필수 항목입니다. |
Random factors (categorical) | 수준이 더 큰 모집단의 랜덤 표본인 하나 이상의 열(예: Field, Batch, Operator)이며, 독립적인 분산 성분으로 모형화됩니다. 필수 항목입니다. |
Covariates (continuous) | 선택 항목인 수치형 열이며, 고정 주효과로만 입력됩니다. |
Confidence level | 기본값은 95입니다. |
Estimation method | Restricted maximum likelihood (REML), 기본값, 또는 Maximum likelihood (ML). |
Data Options: Subset (optional) | Exclude matching rows(기본값) 또는 Include only matching rows 중에서 선택하며, 행 번호 및/또는 조건으로 일치하는 행을 정합니다. |
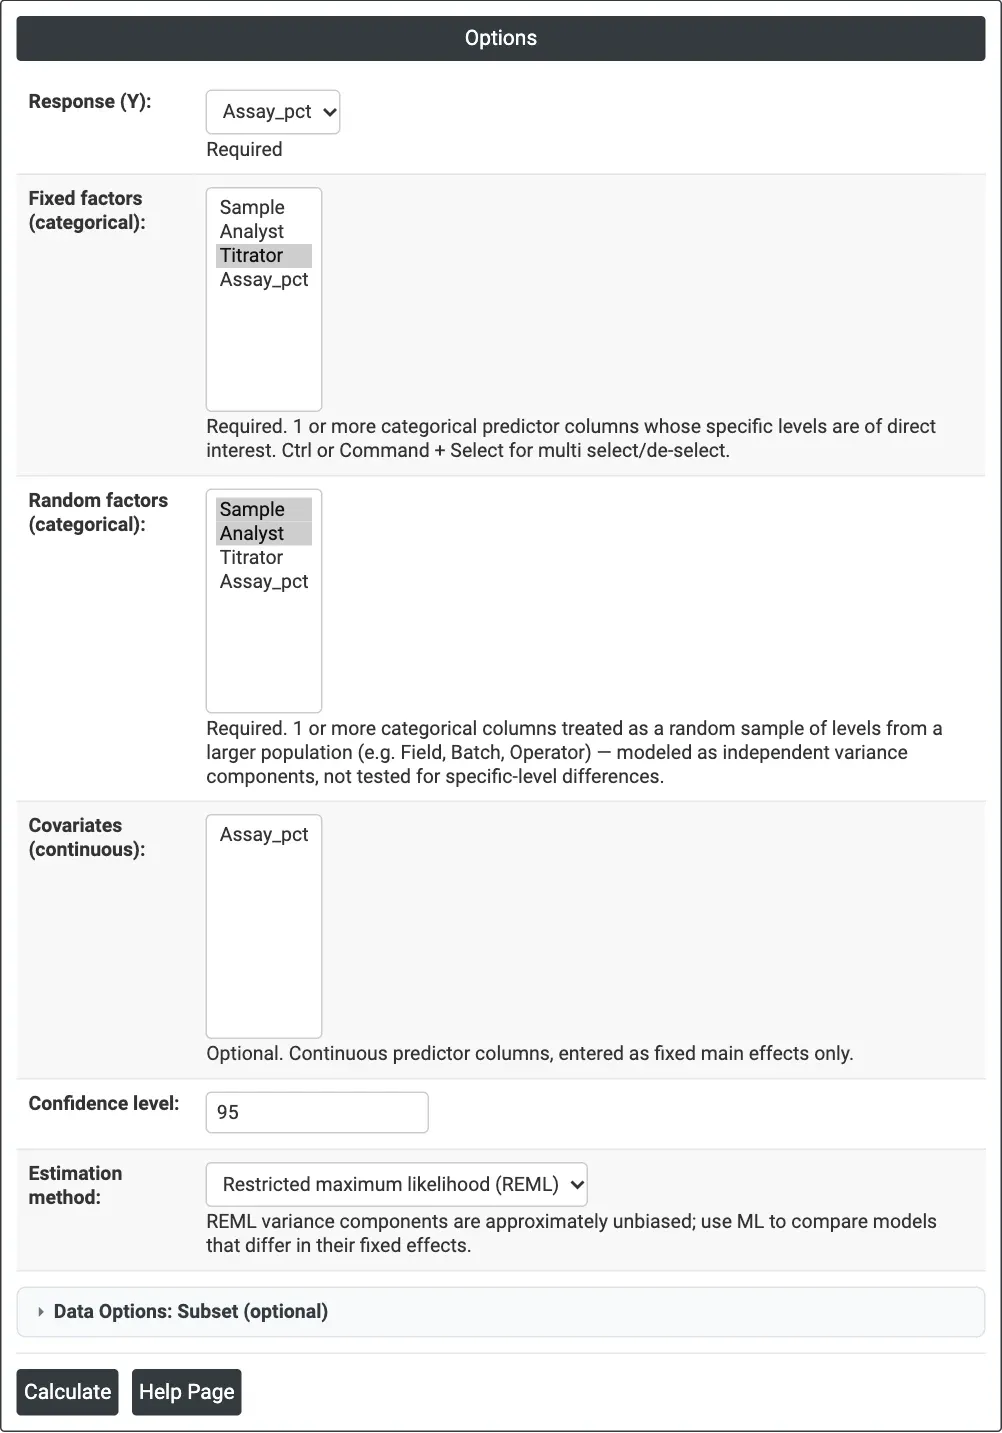
그림 1 — 적정기 예제의 옵션: Assay_pct를 반응, Titrator를 고정 요인, Sample과 Analyst를 랜덤 요인으로 하고 REML을 사용합니다.
출력 설명
- Method — 분산 추정 방법과 고정 효과의 자유도 방법입니다.
- Variance Components — 각 랜덤 요인, 오차, 합계의 Var, % of Total, SE Var, Z-Value, P-Value, 신뢰구간입니다.
- Tests of Fixed Effects — 각 고정 요인과 공변량의 DF Num, DF Den, F-Value, P-Value입니다.
- Model Summary — S, R-sq, R-sq(adj), AICc, BIC, −2 log likelihood입니다.
- Coefficients — Coef, SE Coef, DF, T-Value, P-Value, 신뢰구간입니다.
- 최적화 알고리즘이 완전히 수렴하지 않으면 경고가 표시됩니다.
- Download를 통한 PDF 내보내기.
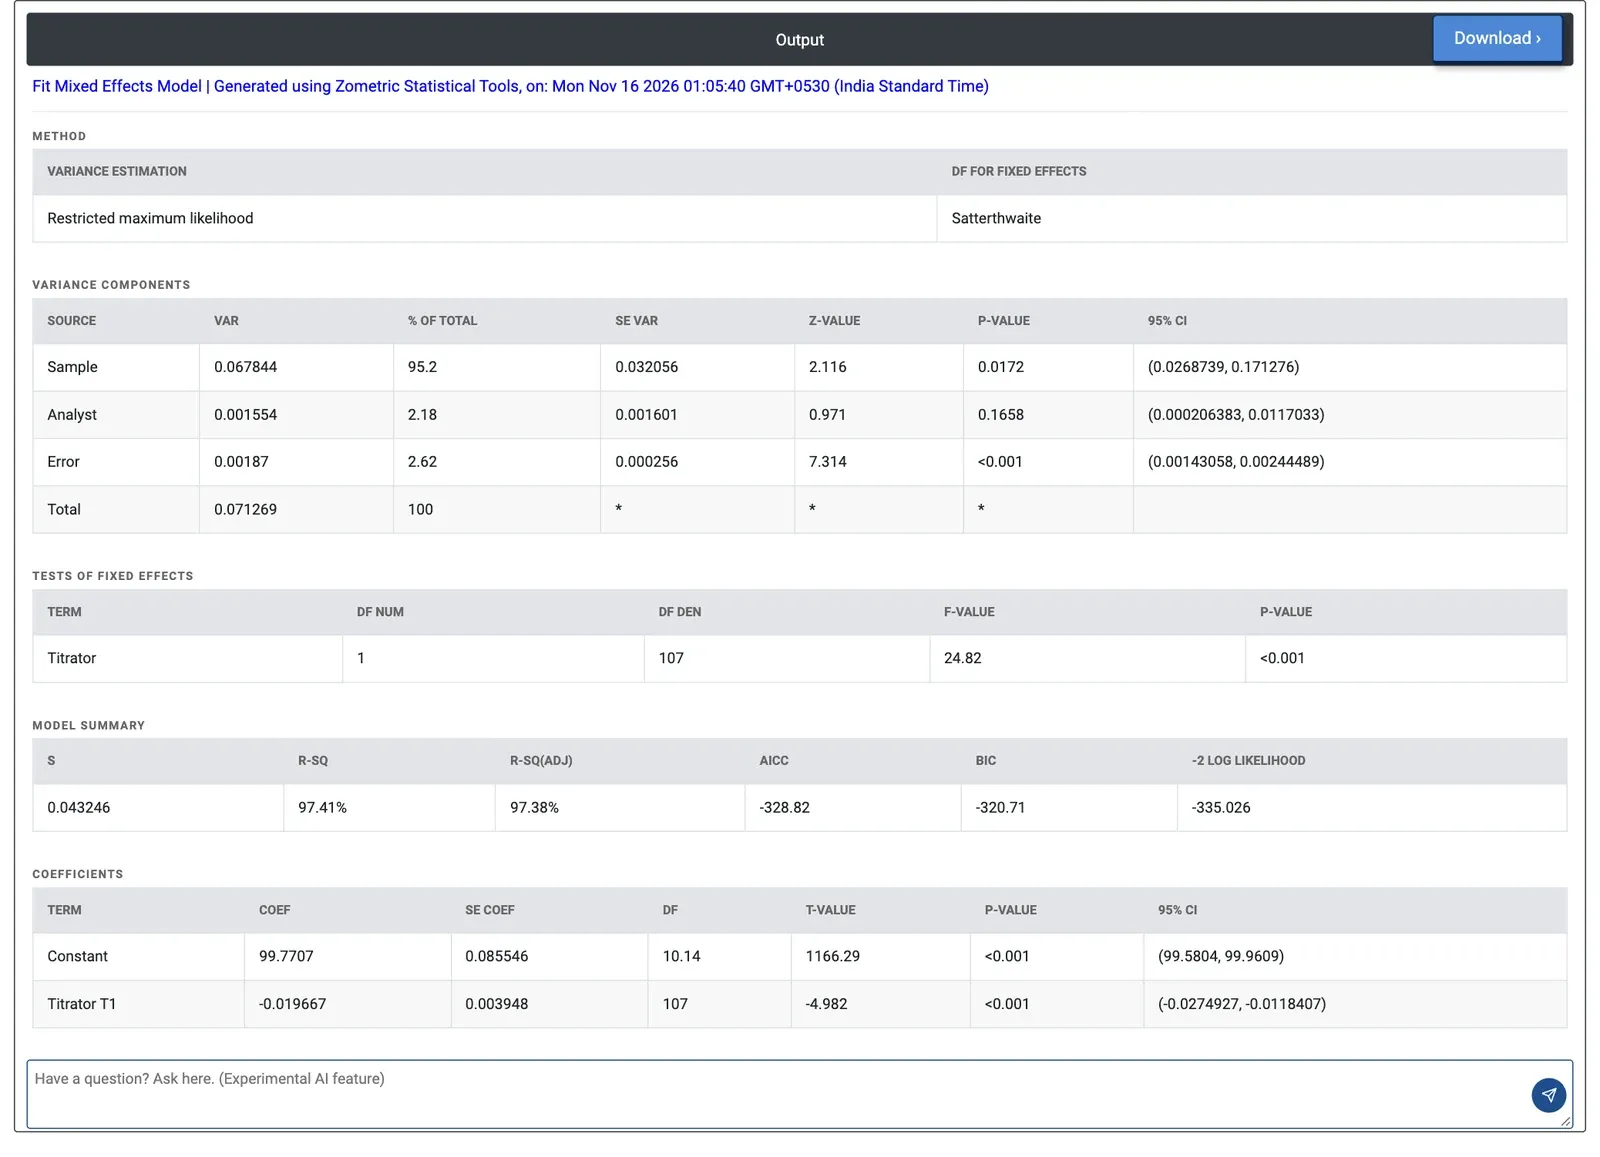
그림 2 — 분석값에 대한 혼합 모형: 표본이 분산의 95.2%를 차지하며, 두 적정기는 서로 다릅니다(F = 24.82, p < 0.001).
계산 예제
한 소다회 시험소가 두 대의 자동 적정기 T1과 T2로 제품 순도(Assay_pct)를 측정합니다. 표본 10개를 분석자 3명이 두 적정기에서 각각 두 번씩 측정하여 결과는 120개입니다. 두 적정기가 같은 결과를 주는지가 문제입니다. 적정기는 시험소가 보유한 두 대의 장비이므로 Titrator는 고정 요인이고, 표본과 분석자는 가능한 많은 표본과 분석자를 대표하므로 랜덤 요인입니다. 시험소는 Assay_pct를 반응으로, Titrator를 고정 요인으로, Sample과 Analyst를 랜덤 요인으로 입력하고 REML을 사용합니다. Load Example은 이 데이터(soda-ash-assay-expanded-grr, Gage R&R 연구(확장) 예제와 같은 연구)와 이 설정을 채워 줍니다.
분산 성분을 보면 표본 자체가 가장 크게 다릅니다: 0.0678(전체의 95.2%, 표준편차 약 0.26 퍼센트포인트). 분석자 성분은 0.00155(2.18%)로 작고 0과 유의하게 다르지 않습니다(p = 0.1658). 단일 결과의 반복성인 오차는 0.00187(표준편차 0.043)입니다.
Titrator는 유의합니다: 자유도 1과 107에서 F = 24.82, p < 0.001. 합이 0이 되는 코딩에서 T1의 계수는 −0.0197이므로 T2는 T1보다 약 0.039 퍼센트포인트 높게 읽히며, 이는 반복성 표준편차 하나에 가깝습니다. 각 표본을 두 적정기에서 모두 측정했으므로 표본 간 산포가 이 차이를 가리지 않습니다. 시험소는 두 적정기의 교정을 기준 표준물질로 확인하기로 합니다.
자주 묻는 질문
고정 요인과 랜덤 요인의 차이는 무엇입니까?
고정 요인은 기계 두 대, 공급업체 세 곳, 새 방법과 기존 방법처럼 비교하려는 특정 수준을 갖습니다. 랜덤 요인은 배치, 표본, 작업자, 일자처럼 수준이 더 큰 모집단에서 추출된 표본입니다. 혼합 효과 모형은 고정 요인을 검정하고 각 랜덤 요인이 더하는 분산이 얼마인지 추정합니다.
혼합 효과 모형은 언제 사용해야 합니까?
랜덤 요인을 무시하면 고정 요인 검정이 지나치게 낙관적이 될 때, 예를 들어 같은 배치나 부품을 모든 조건에서 측정하는 경우에 혼합 효과 모형을 사용합니다. 적정기 예제에서는 표본 10개를 두 적정기에서 모두 측정했으므로 표본 간 산포가 적정기 간 차이를 가리지 않았습니다.
혼합 모형에는 REML과 ML 중 어느 추정을 사용해야 합니까?
기본값인 REML은 고정 효과가 사용하는 자유도를 반영하여 거의 불편인 분산 성분을 제공합니다. 서로 다른 고정 효과를 가진 모형을 AICc 또는 BIC로 비교하려면 ML이 필요합니다. REML에서는 AICc와 BIC로 고정 효과가 같은 모형끼리만 비교합니다.
분산 성분 표는 어떻게 해석합니까?
각 랜덤 요인과 오차에는 분산, 전체에 대한 비율, 표준오차, 성분이 0이라는 단측 Z 검정, 그리고 결코 음수가 되지 않도록 로그 척도에서 계산한 신뢰구간이 있습니다. 랜덤 요인의 수준이 적으면 Z 검정은 검정력이 낮고 구간이 넓습니다.